
2026-11-03/04、AIHubMix経由でDeepSeek V4.1 Flash 1017を5つのプロバイダーでテストしました。使用したのはAPB Fullスイートで、毎回同じ質問、パラメーター、リクエストスクリプトを使っています。このAPB Profileでは、ByteDanceでの実行結果のみをセクションごとに取り上げます。
以下の数値はスコアであり、ランキングやプロバイダーの推奨ではありません。まずQ、F、P、K、Rを示し、総合値は認証ではなく要約指数で、信頼区間はありません。スコアリング規則はAIHubMix Provider Benchmark Standard v2.0で定義されています。
5つのプロバイダーのスコア
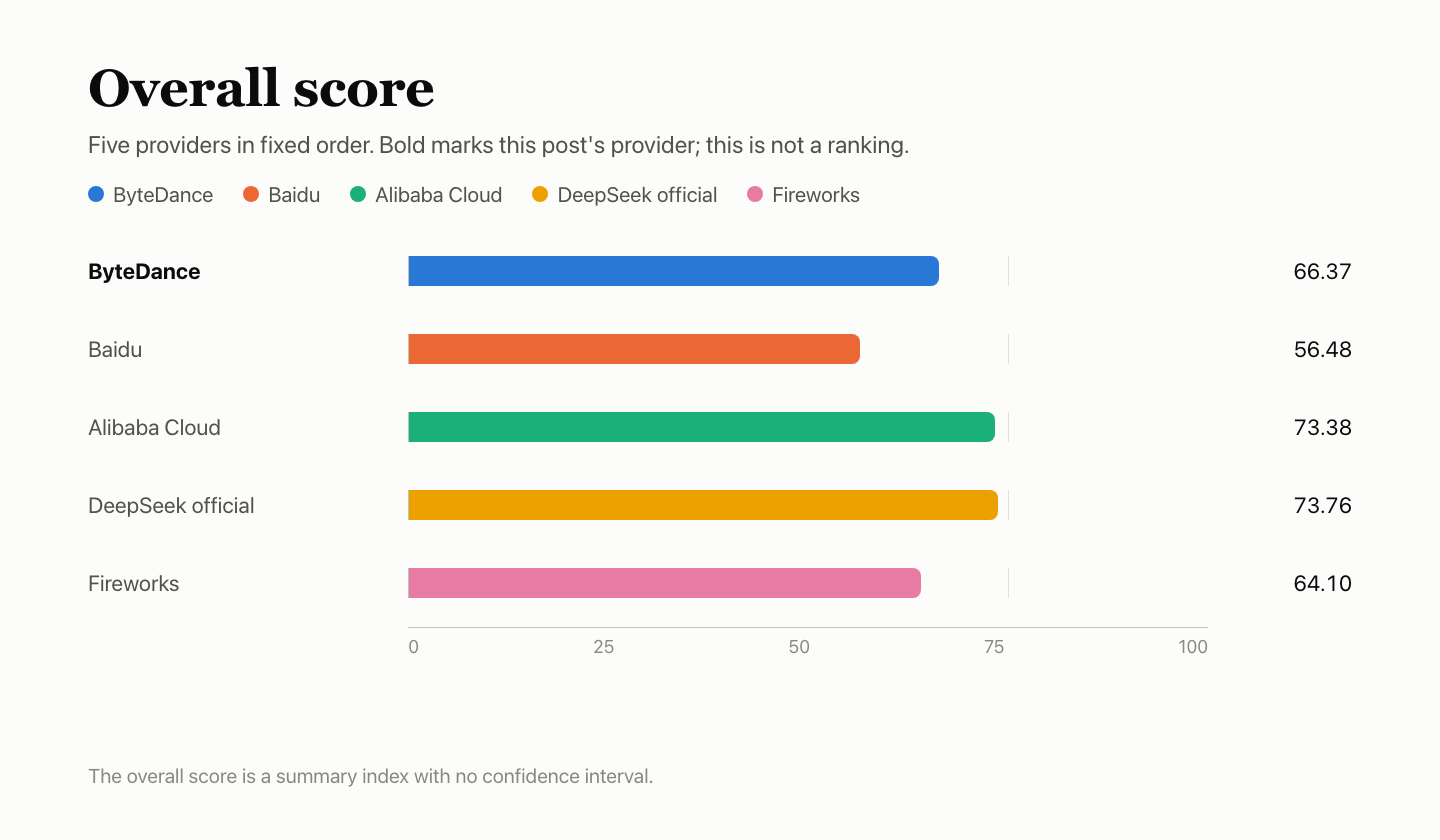
太字はこの記事の対象プロバイダーを示します。プロバイダーの順番は固定で、ランキングではありません。KはPのサブスコアで、Pの20%を占めます。総合値は信頼区間のない要約指数です。DeepSeek公式チャネルとAlibaba Cloudの差は0.37で、両者を区別できません。
概要
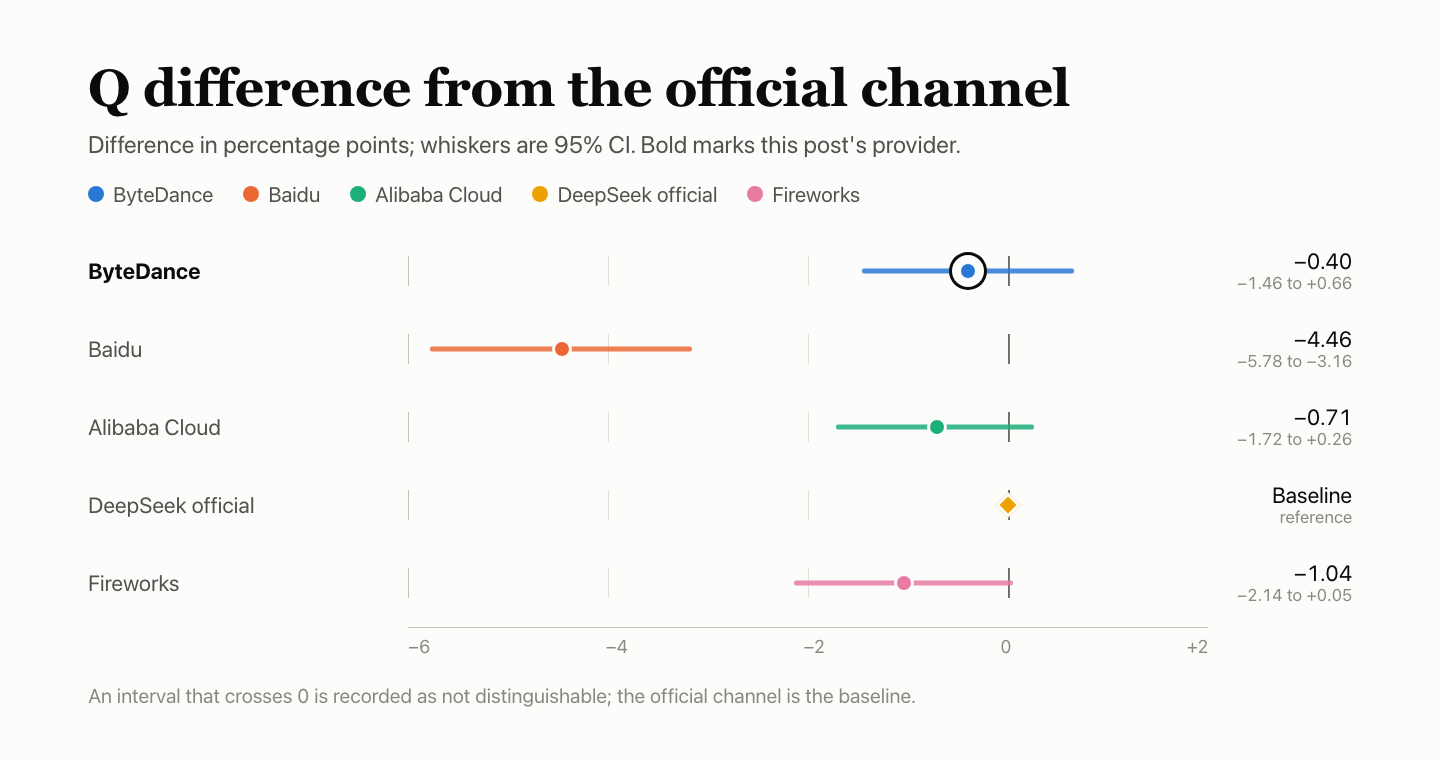
- Q 42.05。BFCL 85.20%、HLE 15.34%、AA-LCR 49.20%。公式チャネルとの差は−0.40パーセンテージポイントで、95%区間は−1.46~+0.66。区別できません。AA-LCRではリクエスト失敗が28件あり、すべてウィンドウ1で発生し、不正解として計上しました。
- F 74.98。集計対象の174項目中124項目に合格しました。
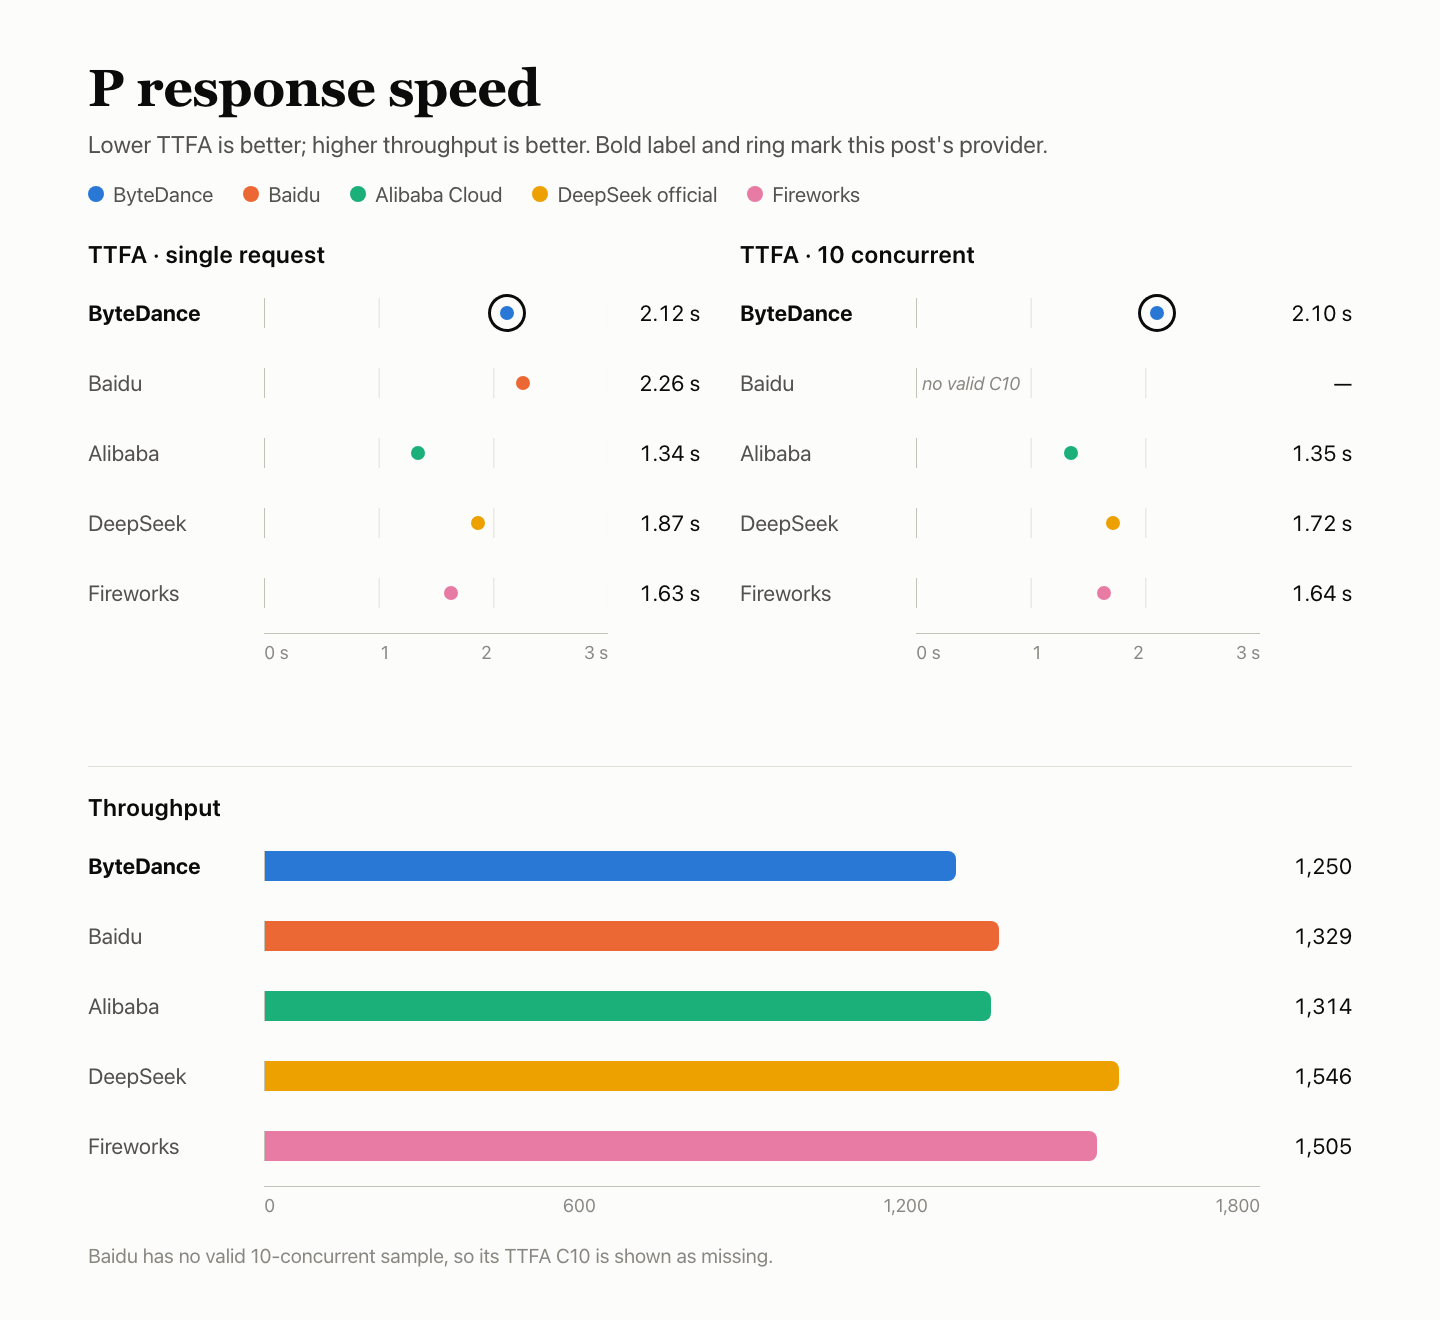
reasoning_effort=noneにしても思考モードはオフになりませんでした。10kトークンの入力は10,026トークンと報告されました(ネイティブのカウントは10,000)。8トークンの入力は34と報告されました。 - P 84.37。本文の最初のトークンまでの時間は、同時実行数1で中央値2.12 s、同時実行数10で2.10 s。TPOTは3.43 ms/トークン。速度テストのリクエスト180件はすべて有効でした。
- K 93.83。8kのホットリクエストは9/9でキャッシュヒット。32kでは8回ヒットし、1件は300 sの期限までに完了しませんでした。
- R 100。専用リクエスト300件はすべて初回で成功しました。
テスト設定
| 項目 | 詳細 |
|---|---|
| モデル | DeepSeek V4.1 Flash 1017 |
| リクエストしたモデル ID | doubao-deepseek-v4.1-flash-1017 |
| 返されたモデル名 | deepseek-v4-1-flash-261017 |
| アクセス経路 | プロバイダー固有のモデル IDを使ってAIHubMix経由でアクセス。プロバイダーアカウントへの直接接続ではありません |
| パラメーター | 非思考モード、temperature 1.0、max_tokens 16,384、タイムアウト300 s、自動再試行なし |
| 思考モードをオフ | 回答品質、速度、キャッシュ、安定性のリクエストでは、ネイティブのthinking.type=disabledを使用(このプロバイダーではreasoning_effort=noneにしても思考モードはオフにならない)。functionのケースでは、このパラメーターが反映されるか確認するためreasoning_effort=noneを維持 |
| 実施日時 | 2026-11-03 18:07 – 11-04 16:33 UTC+8。5つのプロバイダーでMac mini 1台、ネットワーク1つ、アカウント1つを共有 |
| サンプル数 | 回答品質:質問インスタンス4,250件(BFCL 500 × 3、HLE 250 × 10、AA-LCR 25 × 10)。function:60ケース × 3ウィンドウ。速度:同時実行数1で90件、同時実行数10で90件。安定性:300件。キャッシュ:30件(8kと32kのプレフィックスで各3グループ) |
リクエストには、プロバイダー固有のIDを使ったAIHubMixのクイックスタート経路を使用し、パラメーターはDeepSeekのAPIドキュメントに準拠しています。他のプロバイダーIDはモデル一覧ページに記載されています。
Q — 回答品質:42.05
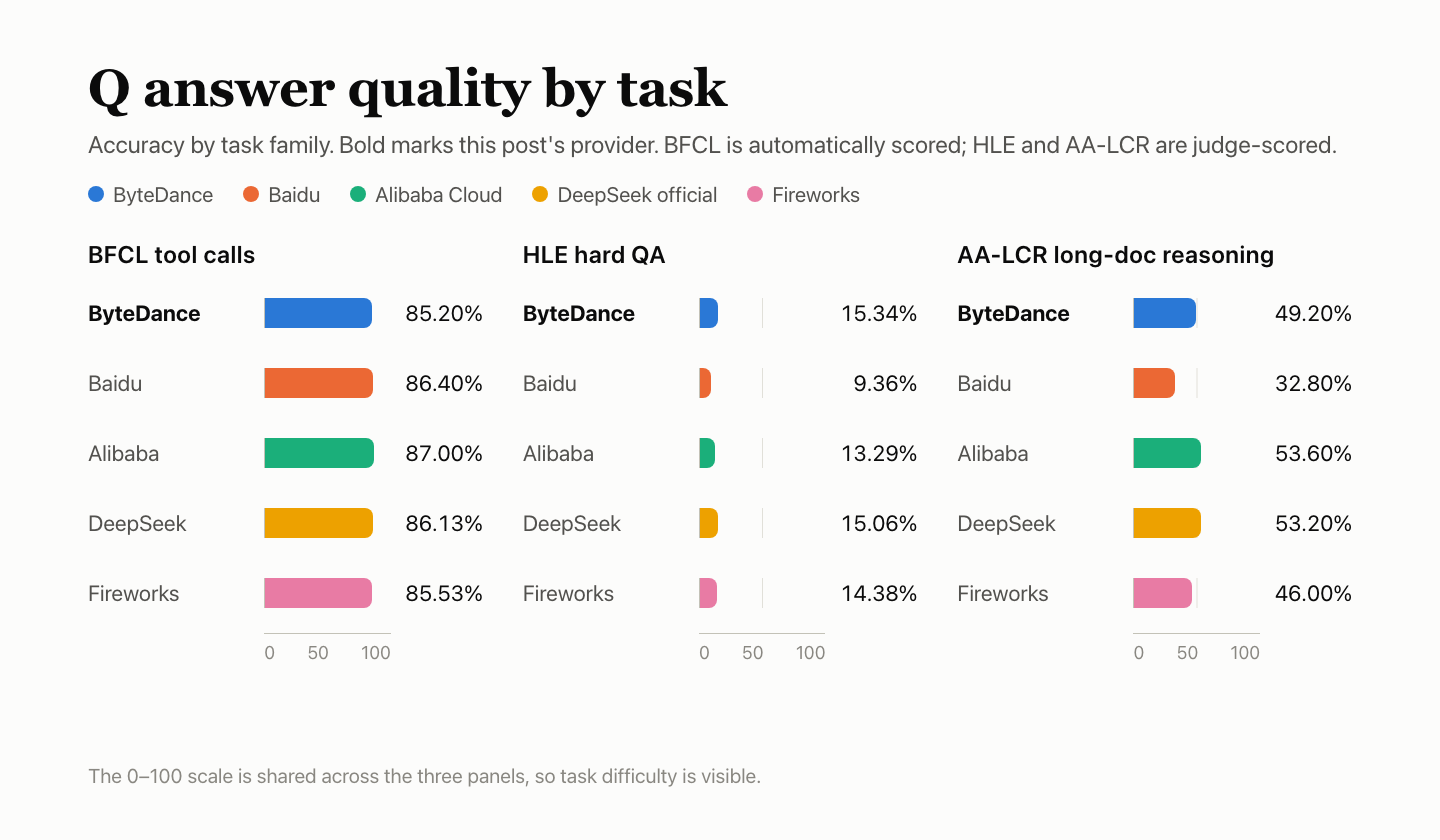
回答品質は3つのスイートに基づいて評価します。BFCLは500問を各3ラウンド、HLEは250問を各10ラウンド、AA-LCRは25問を各10ラウンド実施しました。BFCLは自動ルールで採点し、HLEとAA-LCRはモデルdeepseek-flashが判定します。5つのプロバイダーにはすべて同じ質問を出し、3つのスイートを統合して1つの正答率を算出しました。質問を採点できなかった回答10件を除外し、採点対象は質問インスタンス4,240件となりました。
| スイート | 質問数 | 正解数 | 正答率 | 失敗数 |
|---|---|---|---|---|
| BFCLツール呼び出し | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| HLE難問QA | 250 × 10 | 382/2,490 | 15.34% | 7 |
| AA-LCR長文書推論 | 25 × 10 | 123/250 | 49.20% | 28 |
| 合計 · 95%区間 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
サービス障害(リクエスト失敗または出力の途切れ)は分母に含め、不正解として数えます。HLEでは出力がmax_tokensの上限に7回達しました。AA-LCRではリクエスト失敗が28件あり、すべてウィンドウ1で発生しました。BFCLは自動採点、HLEとAA-LCRは判定モデルによる採点です。
各BFCLの質問には3回回答しました。表には3ラウンドの合計を示しています。
| BFCLのカテゴリ | 合格数 | 合格率 |
|---|---|---|
| simple_python — 関数は1つ。正しい呼び出しと引数 | 329/360 | 91.39% |
| multiple — 複数の関数から1つを選択 | 268/300 | 89.33% |
| parallel — 同じ関数を複数回呼び出す | 271/300 | 90.33% |
| parallel_multiple — 異なる複数の関数を呼び出す | 207/240 | 86.25% |
| irrelevance — 関連する関数がないため、呼び出してはいけない | 102/150 | 68.00% |
| ahm_multi_turn — 3段階のツールチェーン | 101/150 | 67.33% |
他の4つとの比較
公式チャネルとの差をパーセンテージポイントで示し、95%区間をひげで表示しています。区間が0をまたぐ場合は「区別できない」と記録します。判定モデルdeepseek-flashは、テスト対象モデルと同じDeepSeekファミリーに属し、キャリブレーションも行われていないため、判定が甘くなる可能性があります。
F — function対応:74.98
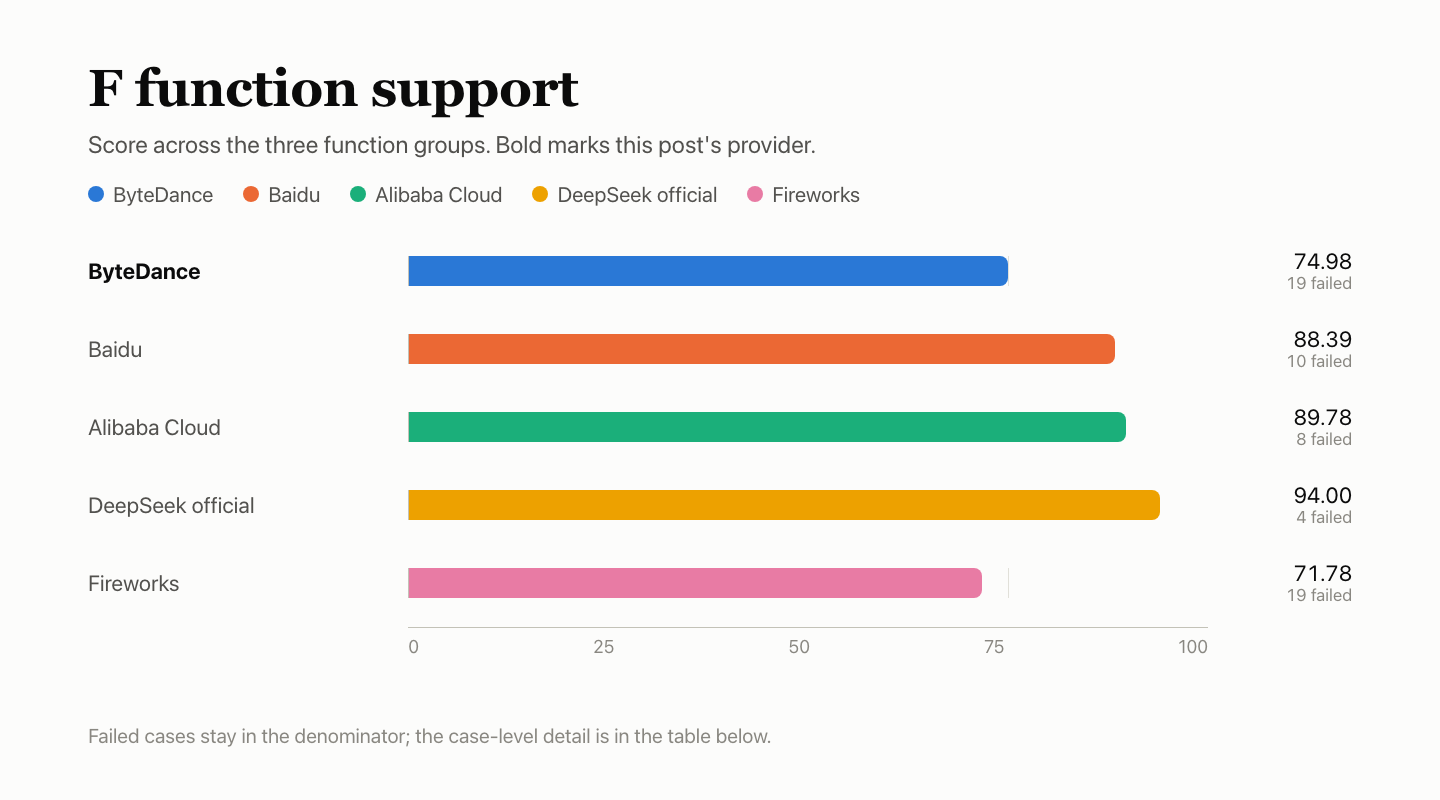
functionスイートでは、モデルの回答品質ではなく、インターフェースの動作がプロトコルに適合しているかだけを調べます。6グループの60ケースをウィンドウごとに1回、計3回実施し、合計180項目を各プロバイダーの文書に記載された形式に照らして判定しました。該当なし、無効、または観測されなかった項目は分母から除外します。ByteDanceは集計対象の174項目中124項目に合格し、グループごとの重み付けで74.98を獲得しました。
加重スコアはグループごとの重みを適用した値であり、合格項目数を174で割った値ではありません。
| グループ | 重み | 合格数 | 除外数 | グループスコア |
|---|---|---|---|---|
| ストリーミングとメッセージプロトコル | 20% | 23/27 | 3 | 85.19 |
| ツールインターフェース | 20% | 30/30 | — | 100.00 |
| 出力制約とパラメーター | 20% | 24/30 | — | 80.00 |
| コンテキストと状態 | 15% | 14/30 | — | 46.67 |
| エラーと復旧 | 15% | 21/30 | — | 70.00 |
| 課金計測とキャッシュプロトコル | 10% | 12/27 | 3 | 44.44 |
| 合計 · 加重スコア | — | 124/174 | 6 | 74.98 |
「失敗したウィンドウ数」は、3つのウィンドウのうちチェックに失敗した数です。
| 失敗したケース | 失敗したウィンドウ数 | 理由 |
|---|---|---|
| コンテンツへの推論漏れ — ストリーミングとメッセージプロトコル | 3/3 | reasoning_effort=noneでも、思考コンテンツが返された |
| 思考モードの設定が反映される — 出力制約とパラメーター | 3/3 | reasoning_effort=noneでも、思考コンテンツが返された |
| サンプリングの多様性 — 出力制約とパラメーター | 3/3 | temperature 0と1で出力に十分な差がなく、事前登録したしきい値を下回った |
| 10k長文入力 — コンテキストと状態 | 3/3 | 入力は10,026トークンと報告。ネイティブのカウントは10,000であるべき |
| コンテキスト上限内 — コンテキストと状態 | 3/3 | 入力は10,026トークンと報告。ネイティブのカウントは10,000であるべき |
| 32k長文入力 — コンテキストと状態 | 3/3 | 入力は10,026トークンと報告。ネイティブのカウントは10,000であるべき |
| 100k長文入力 — コンテキストと状態 | 3/3 | 入力は10,026トークンと報告。ネイティブのカウントは10,000であるべき |
| コンテキスト上限超過 — コンテキストと状態 | 3/3 | 上流接続エラーまたはタイムアウト(1)。パラメーターエラーを返すべきところ、200を返した(2) |
| 12ターンの履歴 — コンテキストと状態 | 1/3 | 上流接続エラーまたはタイムアウト |
| messages形式エラー — エラーと復旧 | 3/3 | 400と空の本文が返され、構造化されたエラー説明がなかった |
| 対応する呼び出しのないツール結果 — エラーと復旧 | 3/3 | パラメーターエラーを返すべきところ、200を返した |
| stream_options形式エラー — エラーと復旧 | 3/3 | 400と空の本文が返され、構造化されたエラー説明がなかった |
| 思考トークンの計上 — 課金計測とキャッシュプロトコル | 3/3 | 思考モードを無効にした後も、思考トークンが報告された |
| ネイティブ入力カウント — 課金計測とキャッシュプロトコル | 3/3 | 34トークンと報告。ネイティブのカウントは8であるべき |
| ツール定義の入力カウント — 課金計測とキャッシュプロトコル | 3/3 | ツールなしの対照リクエストでも、ネイティブの入力カウントとすでに一致していなかった |
| キャッシュ前後で入力カウントが一致 — 課金計測とキャッシュプロトコル | 3/3 | 同じプレフィックスを繰り返した際、報告された入力トークン数がネイティブのカウントと一致しなかった |
| ストリーミングと非ストリーミングで入力が一致 — 課金計測とキャッシュプロトコル | 3/3 | どちらも34トークンと報告。ネイティブのカウントは8であるべき |
| テキスト出力の完全一致 — ストリーミングとメッセージプロトコル | 1/3 | 本文の末尾に余分なピリオドが1つあり、指定されたテキストと完全には一致しなかった |
これらのチェックは分母から除外され、合格にも失敗にも数えません。
| ステータス | ケース | 件数 | 理由 |
|---|---|---|---|
| 未観測 | ストリーミングの停止シーケンス | 3 | 前のステップの後、このリクエストは送信されなかったため判定できません |
| 該当なし | 明示的なcache_control | 3 | このインターフェースでは非対応として事前登録 |
messages形式エラーとstream_options形式エラーのケースは、5つのプロバイダーすべてで失敗しました。どちらも400と空の本文が返され、クライアントは構造化されたエラー説明を受け取れません。5社共通の失敗であることから、AIHubMixのゲートウェイ層に原因がある可能性が高く、別途調査が必要です。思考トークンの計上も5社すべてで失敗しましたが、理由は異なります。ByteDanceとFireworksは思考モードを無効にした後も思考トークンを報告し、他の3社は思考トークン数を返しませんでした。
他の4つとの比較
P — 応答速度:84.37
各リクエストには約10,000入力トークンを含め、本文テキストとして約1,100出力トークンを求めました。3つのウィンドウそれぞれで、同時実行数1のリクエストを30件、同時実行数10のリクエストを30件実行し、合計180件でした。
| 指標 | 結果 |
|---|---|
| 本文の最初のトークンまでの待ち時間(TTFA) | 同時実行数1で中央値2.12 s、同時実行数10で中央値2.10 s |
| 生成速度(TPOT) | 同時実行数1で3.43 ms/トークン、同時実行数10で3.41 ms/トークン |
| 実効スループット | 同時実行数10で1,250.0 token/s |
| 有効なリクエスト | 同時実行数1で90/90、同時実行数10で90/90 |
| 構成スコア | TTFA 48.59、TPOT 100.00、スループット100.00。TTFAとTPOTは2つの階層の低い方を採用。重みは35% / 35% / 30%。応答スコアは82.00 |
| Pスコア | 応答スコア82.00が80%、キャッシュK 93.83が20%。合計84.37 |
TPOTはストリーミングのチャンクから推定した値であり、ハードウェア上でトークンごとに測定したものではありません。スループットは、同時実行数10での有効な出力トークン数をバッチの経過時間で割って算出します。
他の4つとの比較
5社すべてで同じマシン、ネットワーク、アカウントを共有しました。3つのウィンドウはプロバイダーごとに順番に実施したため、収集期間は完全には重なっていません。小さな差を過大に解釈しないでください。
K — キャッシュ:93.83
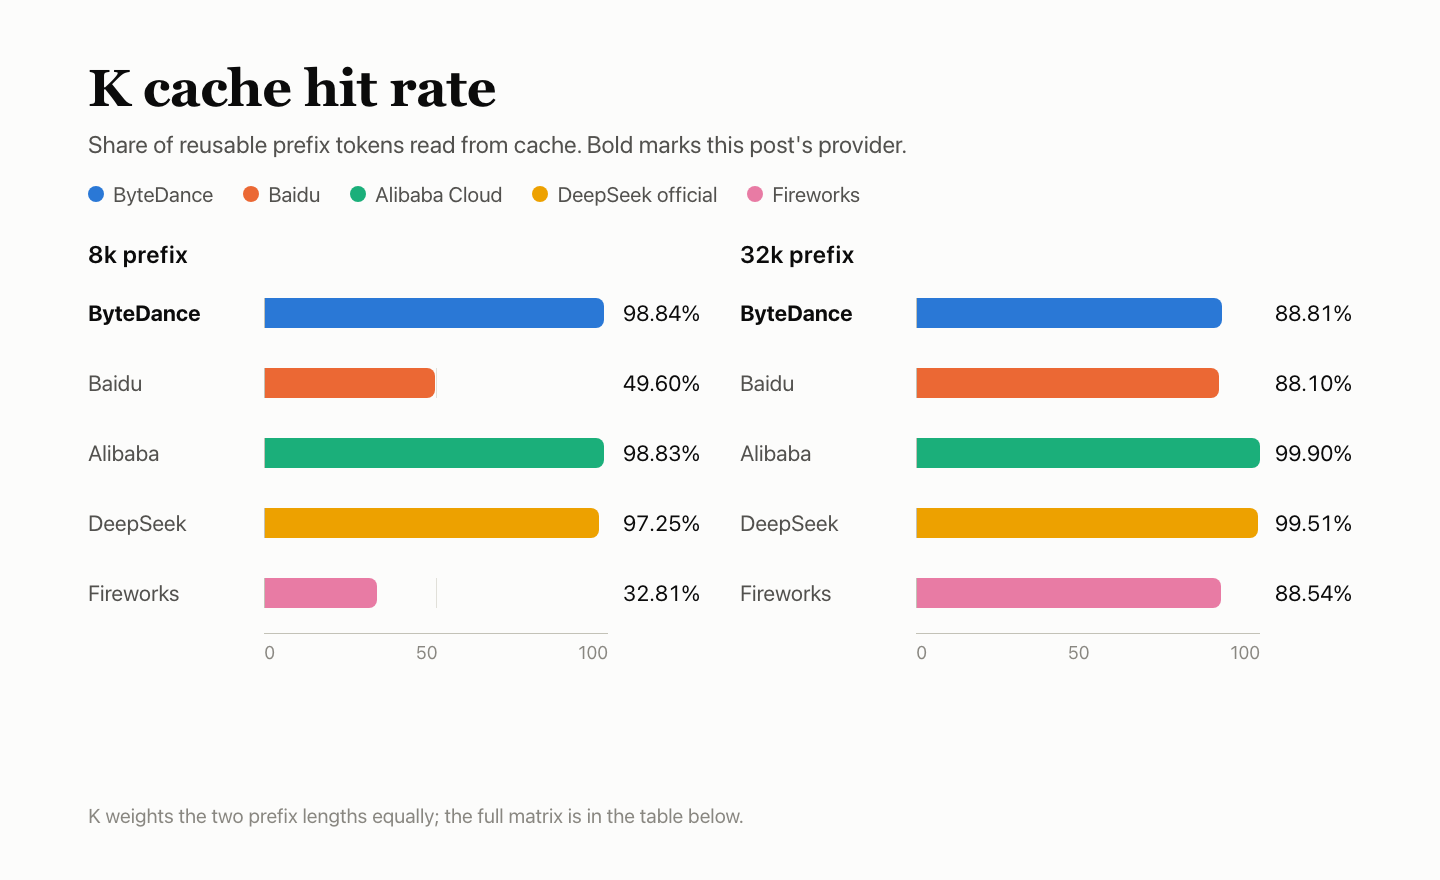
各グループでは5件のリクエストを送信します。最初のリクエストには約8kまたは32kトークンの固定プレフィックスを含め、キャッシュのシードにします。2~4件目ではプレフィックスを維持し、最後の質問だけを5 s、30 s、120 sの間隔で変更します。5件目は新しいプレフィックスを使い、コールド対照とします。3つのウィンドウと2種類の長さで、各グループ5件、合計30件です。Kは、ホットリクエストでのキャッシュ読み取りトークン数を、ルール上再利用されるべきトークン数で割った値です。2種類の長さは等しい重みで計算し、KはPの20%を占めます。
| プレフィックス | ウィンドウ | シード | +5 s | +30 s | +120 s | コールド対照 |
|---|---|---|---|---|---|---|
| 8k | ウィンドウ1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | ウィンドウ2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | ウィンドウ 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | ウィンドウ 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | ウィンドウ 2 | 0 | 32,000 | 32,000 | 失敗 | 0 |
| 32k | ウィンドウ 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
値は、サーバーから報告されたキャッシュ読み取りトークン数です。
8kのホットリクエストは9件すべてがヒットし、それぞれ7,936トークンを読み取りました。32kのホットリクエストは9件中8件がヒットし、それぞれ32,000トークンを読み取りました。1件は失敗しました。2つの入力長を同じ重みで計算したKは93.83です。コールドリクエストはキャッシュを読み取らないため、ホットとコールドを明確に区別できます。失敗したリクエストは、ウィンドウ2の32kグループの4件目で、完了しないまま300 sの期限に達しました。
他の4つと比較
R — サービス安定性:100
300件のリクエストは、短文、長い入力、ツール呼び出し、複数ターンの履歴という4種類に分かれ、3つのウィンドウで同時実行数1で実行されました。初回の試行で有効かつ完全な応答が返った場合にのみ成功とし、回答の正確性は確認せず、再試行も行いません。回答品質と速度のセクションでの失敗はQとPに計上し、Rでは重複して計上しません。
| リクエストの種類 | 初回試行の成功率 |
|---|---|
| 短文 | 120/120 |
| 10kの長い入力 | 90/90 |
| ツール呼び出し | 60/60 |
| 複数ターンの履歴 | 30/30 |
| 合計 · 95%信頼区間 98.78%–100% | 300/300 |
300件すべてのリクエストで、初回の試行に有効かつ完全な応答が返りました。R = 100が示すのは、この300件の専用リクエストに限られ、チェーン全体で失敗がなかったという意味ではありません。95%信頼区間の下限は98.78%です。300件すべてが成功したことから言えるのは、失敗率が1.22%未満である可能性が高いということだけです。
他の4つと比較
Rの対象はこの300件の専用リクエストのみです。回答品質と速度のセクションでの失敗はQとPに記録され、Rでは重複して計上されません。
| プロバイダー | 初回試行の成功率 | 95%信頼区間 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek公式 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
よくある質問
reasoning_effort=noneは実際には思考をオフにできなかったのでしょうか?
はい。3つのウィンドウすべてで、reasoning_effort=noneを指定したリクエストから思考内容が返されたため、チェックは3/3で失敗しました。回答品質、速度、キャッシュ、安定性のリクエストでは、代わりにネイティブのthinking.type=disabledスイッチを使いました。関数テストでは、このパラメーターが有効になるかを確認するため、意図的にreasoning_effort=noneを使用しました。
BFCLの精度は85.20%なのに、Qが42.05なのはなぜですか?
Qは難易度が大きく異なる3つのテストをまとめて集計します。BFCLでは1,500問中1,278問、HLEでは2,490問中382問、AA-LCRでは250問中123問が正解でした。合計すると、採点対象の4,240問のうち1,783問が正解で、42.05%となります。HLEの15.34%が全体の数値を押し下げています。
サービスの35件のリクエスト失敗はスコアに含まれますか?
はい。リクエストの失敗と出力の途中切れは分母に含まれ、不正解としてカウントされます。HLEの回答7件はmax_tokensで途中切れとなり、AA-LCRのリクエスト28件はすべてウィンドウ1で失敗しました。
入力トークンの計上が重要なのはなぜですか?
計上値はモデルのネイティブなカウントと一致すべきだからです。10kトークンの入力は10,026トークン(ネイティブ値は10,000)として報告され、8トークンの入力は34として報告されました。ツールを使わない対照リクエストでもすでに不一致があり、ストリーミングと非ストリーミングのどちらでも34と報告されました。トークン計上のチェックは5件中3件で失敗しました。
32kのキャッシュ結果はミスですか、それとも失敗ですか?
失敗です。32kのホットリクエストは9件中8件がヒットし、32,000トークンを読み取りました。唯一のミスは、ウィンドウ2の4件目のリクエストで、完了しないまま300 sの期限に達しました。8kグループは9/9でヒットし、7,936トークンを読み取りました。
ByteDanceの回答品質は公式チャネルと区別できますか?
いいえ。統合精度は公式チャネルより0.40ポイント低く、95%信頼区間は−1.46~+0.66です。この区間には0が含まれるため、両者を区別できません。これは今回のバッチについての結果であり、順位付けではありません。
続けて読む:DeepSeek V4.1 Flashシリーズ
- この記事のQの基準値は公式チャネルのものです。無効な単一同時実行プローブ15件を含む公式チャネル自体の実行結果は、DeepSeek V4.1 Flash公式チャネル版:Fは94.00、無効なプローブは15件で取り上げています。
- Qの信頼区間が公式チャネルを下回るプロバイダーはBaiduだけです。この結果につながったチャネルの失敗については、DeepSeek V4.1 FlashのBaidu版:利用可能なチャネルがなく、QとPに到達せずをご覧ください。
- Alibaba Cloudのキャッシュ値は、ここで報告した93.83と並べて比較できます。DeepSeek V4.1 FlashのAlibaba Cloud版:初回トークン1.34s、キャッシュ99.37。
- Fireworksでは、ここで確認された思考とトークン計上の失敗に加えて、空のstop応答も発生しています。DeepSeek V4.1 FlashのFireworks版:空のstop応答、キャッシュヒット3/9。


