LLMを接続すれば、アプリケーションはテキストを生成できるようになります。しかし、それだけでAIエージェントが現実世界のタスクを完了できるわけではありません。
モデルのコンテキストにすでにある文書を要約するだけなら、モデル層だけで十分です。一方で、今日の競合他社の価格を比較する、企業レコードを補強する、ソーシャルアカウントを確認する、あるいは未知の作業に最適なAPIを選ぶといった場合には、欠けている半分が明らかになります。エージェントには外部システムに確実にアクセスする手段が必要なのです。
そのため、本番環境のエージェントは2つの別々の判断を行います。
- この工程はどのモデルが担当すべきか?
- データや操作を提供すべきツールやAPIはどれか?
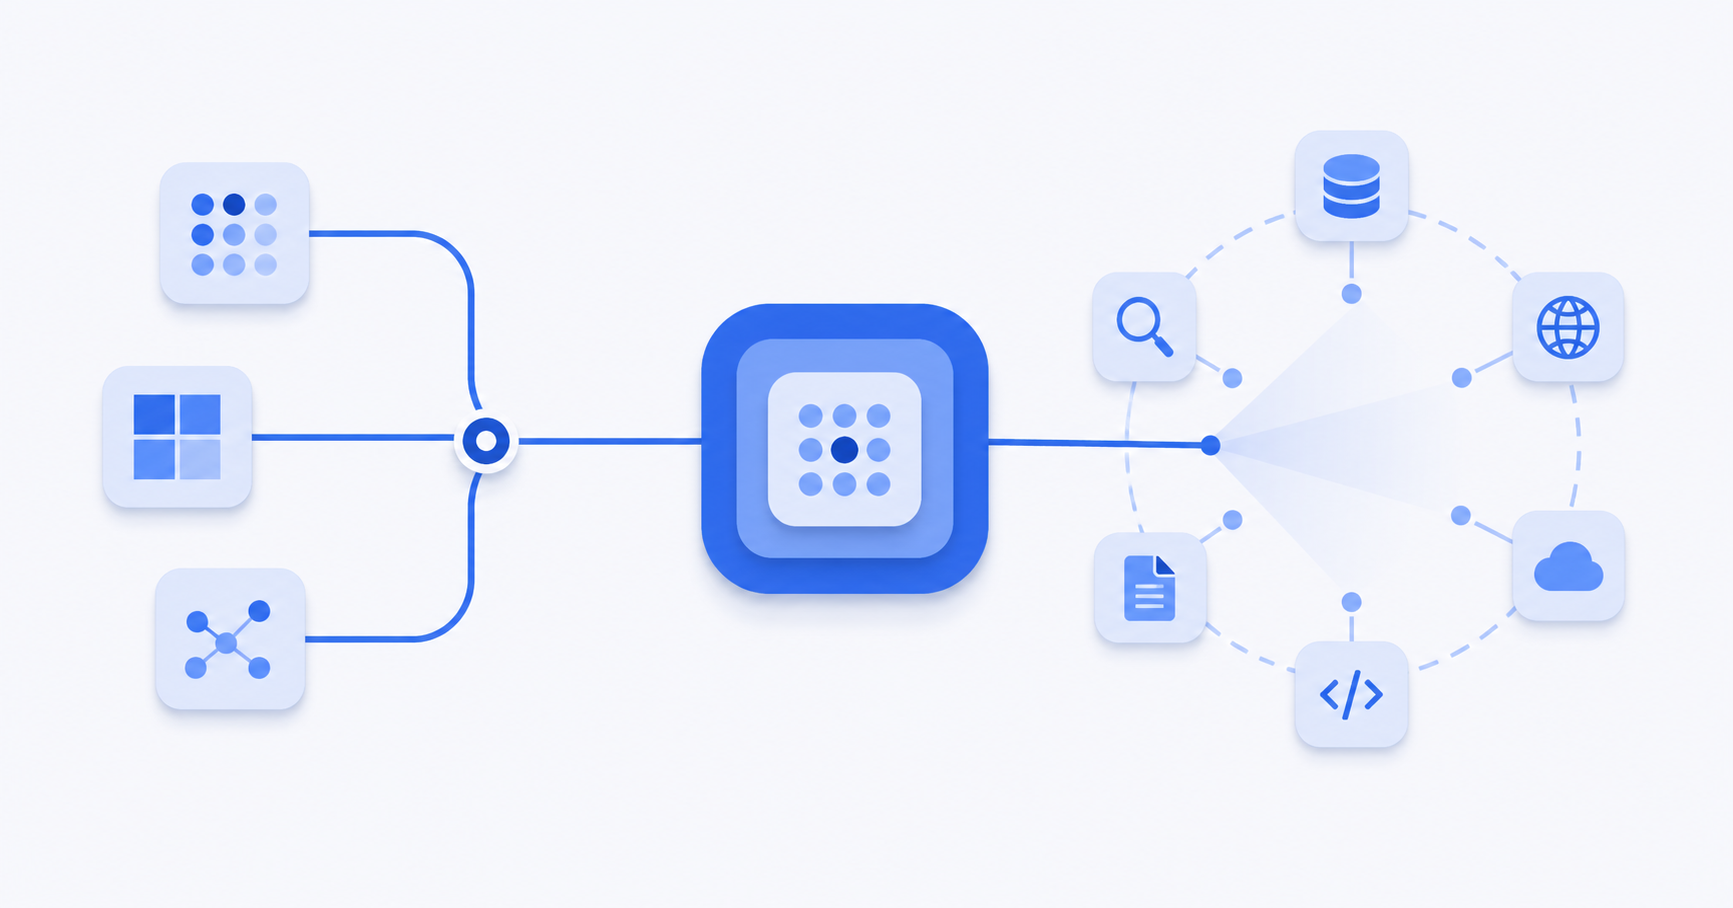
AIHubMixは統一されたモデルアクセスとリクエスト時のモデルルーティングによって、1つ目の判断に対応します。Monidは実行時のツール発見、スキーマの確認、呼び出しごとの課金による実行によって、2つ目の判断に対応します。両製品は同じアーキテクチャの異なる層に位置しています。
開示事項:本記事はMonidとのコンテンツ協業の一環として作成されました。以下で取り上げるモデルプラットフォームはAIHubMix、ツールプラットフォームはMonidです。それぞれ単独でも利用できます。
AIエージェント内部にある2つのルーティング問題
エージェントの実行は、同質なモデル呼び出しが1回だけであることはほとんどありません。リサーチエージェントは、リクエストの分類、最新情報の検索、構造化された事実の抽出、結果の比較、最終回答の作成を行うかもしれません。これらの工程にはそれぞれ異なる能力が必要です。
モデルの外側でも同じことが言えます。企業リサーチのタスクでは、今日は検索API、明日は企業情報の補強エンドポイント、来週はブラウザ自動化ツールが必要になるかもしれません。すべてのモデルとツールをビルド時に固定してしまうと、新しいタスクのたびに統合作業が発生してしまいます。
2つの層は並行して存在します。
| モデル層 | ツール層 | |
|---|---|---|
| 中核となる判断 | どのモデルが回答すべきか? | どのAPIを呼び出すべきか? |
| 選択のタイミング | リクエストごと | タスクごと、実行時 |
| 入力 | プロンプト、モダリティ、品質とレイテンシの要件 | 目標、必要なデータや操作、スキーマと価格 |
| 出力 | モデルの生成結果 | 外部データor実行された操作の結果 |
| 例 | AIHubMix | Monid |
この分離は重要です。優れたモデルがあっても、ライブデータへのアクセスは生まれませんし、ツールカタログが大きくなっても、返されたデータを推論できるわけではありません。エージェントには両方の能力が必要であり、それらの間には明確な契約が必要です。
MonidはAIエージェントに2つの統合が必要な理由で、補完的なツール側の視点を示しています。モデル側から見ても、アーキテクチャ上の教訓は同じです。モデルの選択とツールの選択を互いに独立させ、それぞれの層を固有の役割に最適化してください。
エージェントのループで固定の1モデルがコスト高になる理由
どの工程にも同じモデルを使うのは単純に見えます。しかし実際には、すべての工程が能力、レイテンシ、価格の同じトレードオフを受け入れることになります。
市場調査エージェントを例に考えてみましょう。
- インテントの分類は短く、機械的な作業です。
- ツールの選択には、指示への確実な追従が必要です。
- 返されたJSONからフィールドを抽出するのは、主に変換作業です。
- 最終レポートには、より強力な推論と優れた文章力が必要になる場合があります。
4つの工程すべてを最も高性能なモデルに送ると、定型作業にお金を浪費します。一方、すべてを最も安価なモデルに送ると、ユーザーが実際に読む唯一の成果物の品質が下がるおそれがあります。エージェントのループが大きくなるほど、その妥協はすべての呼び出しで繰り返されます。
AIHubMixは、幅広いモデルカタログにまたがるOpenAI互換のエンドポイントを提供します。既存のOpenAI SDKの統合は、APIキーとbase_urlを変更するだけでAIHubMixに向けることができます。
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
modelにautoを設定すると、モデル選択がリクエストの処理経路に組み込まれます。ルーターはタスクを分析し、適切なモデルを決定します。ポリシーのサフィックスによって、最適化の目標を明示できます。
| ルーターの値 | 優先事項 | 典型的なエージェントの工程 |
|---|---|---|
auto |
コスト優先 | バッチ処理や定型的な変換作業 |
auto:balanced |
能力、コスト、レイテンシ | 汎用的なエージェント作業 |
auto:quality_first |
能力優先 | 複雑な推論と最終成果物 |
auto:latency_critical |
速度優先 | 対話型のループと軽量な計画立案 |
ルーティングに別途料金はかかりません。リクエストは、実際に処理したモデルの定価で課金されます。解決されたモデルとルーティングの詳細は、X-Aihubmix-Router-Resolved-Modelヘッダーを含めてレスポンスに表示されるため、その判断はブラックボックスにならず、観測可能な状態に保たれます。
動作の詳細、対応エンドポイント、ポリシー、現在の制限事項は、AIHubMix LLM Routerガイドに記載されています。
モデルルーティングではエージェントにライブデータは与えられない
モデルルーティングを設定すると、エージェントは各工程で、より適したモデルを選べるようになります。しかし、ツールがその能力を提供しない限り、モデルの学習データ以降に何が変わったかを知ったり、社内の非公開システムにアクセスしたり、別のアプリケーションで操作を実行したりすることはできません。
ここで、多くのエージェントプロジェクトは脆いコードを蓄積していきます。チームはまず1つの検索APIを接続し、次にスクレイピングAPI、さらに企業情報補強APIを接続します。統合のたびに、アカウント、認証情報、リクエスト形式、エラーモデル、請求関係が増えていきます。ツールの説明はシステムプロンプトにコピーされることが多く、やがて古くなっていきます。
この失敗モードは、成功しているように見えるため危険です。モデルは古いスキーマに対してもっともらしい呼び出しを生成し、不完全なレスポンスを受け取った後も、タスクが成功したかのように処理を続けるかもしれません。学習データや古いプロンプトから得たAPIの契約をモデルに覚えさせるより、実行時にスキーマを確認するほうが安全です。
したがって、ツール層は実行前に次の3つの質問に答えるべきです。
- この目標を満たせるツールはどれか?
- 現時点で適用されるスキーマと価格は何か?
- 実際の呼び出しで何が返されたか?
ツール発見は2つ目のルーティング層
Monidは、ツールへのアクセスを「発見・確認・実行」のワークフローに変えます。開発者がエージェントに必要になりうるすべてのAPIを事前に予測する必要はありません。エージェントは自然言語でカタログを検索し、候補の契約内容を確認し、選ばれたエンドポイントを実行できます。
基本的な流れは次のとおりです。
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
発見と確認により、エージェントは何かに費用をかける前に選択肢を比較できます。実行は、選ばれたエンドポイントの料金モデルに従って課金されます。開発者は統合を1つに保ちながら、エージェントは複数のプロバイダーにまたがるツールにアクセスできるようになります。
セットアップ手順を読み取れるエージェントランタイム向けに、Monidは機械可読なスキルも公開しています。
Set up https://monid.ai/SKILL.md
Monidのワークフロー文書では、カタログ、確認、実行の各段階をより詳しく説明しています。
2つの層の連携
モデルゲートウェイとツール層は、小さく明示的な受け渡しを伴う別々のコンポーネントとして保つべきです。
- エージェントがユーザーの目標を受け取ります。
- AIHubMixが計画用の呼び出しを適切なモデルにルーティングします。
- 計画によって、不足している情報や必要な外部操作が特定されます。
- Monidが候補ツールを発見し、そのスキーマと価格を提示します。
- エージェントは権限と予算の範囲内でツールを選択して実行します。
- ツールが事実またはアクションの結果を返します。
- AIHubMixが、必要な品質、コスト、レイテンシに応じて統合の呼び出しをルーティングします。
- エージェントは、ツールの結果に基づいた回答を返します。
簡略化したPythonでは、ツールの結果をコンテキストとして挿入しても、モデル側の呼び出しはそのまま残せます。
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
重要なのは行数ではありません。どちらの選択も、アプリケーションのロジックに永続的に組み込む必要がないという点が重要です。プロンプトが変わればモデルを変えられますし、タスクが変われば ツールを変えられます。
コスト管理は両方の層で必要
モデルのコストとツールのコストでは単位が異なるため、別々に計測すべきです。
モデル層では、解決されたモデルによってトークン単価が決まります。AIHubMixはその判断を追跡可能にし、開発者がルーティングポリシーを選んだり、APIキーが使えるモデルを制限したりできるようにします。定型的な工程ではコストやレイテンシを優先し、ユーザー向けの出力では品質を優先できます。
ツール層では、エンドポイントが呼び出しごと、または結果ごとに課金することがあります。Monidは実行前の確認段階で価格を表示します。エージェントは、予算を超えるエンドポイントを拒否したり、検証済みの選択肢を優先したり、異常に高額な操作の前に承認を求めたりできます。
本番環境で役立つ制御には次のものがあります。
- APIキーごとのモデル許可リストまたは価格上限。
- タスクごとのツール呼び出しの最大予算。
- 規制対象データに対するプロバイダーまたはエンドポイントの許可リスト。
- モデルのルーティング判断、ツール呼び出し、最終回答を結び付けるログ。
- 取り消しできない操作や機密性の高い操作の前の明示的な確認。
- ツールのデータを命令ではなく信頼できない入力として扱うための出力検証。
この分離は、コストのデバッグも容易にします。実行のコストが高くなった場合、トークンのログからエージェントが推論しすぎたかどうかが分かり、ツールのログからデータを取得しすぎたかどうかが分かります。対処法は異なるため、アーキテクチャはその区別を保持すべきです。
信頼性には最新の契約と可視化された判断が必要
動的な選択は、予測できない動作を意味すべきではありません。
モデル側では、AIHubMixがリクエストごとに、解決されたモデルとルーティングポリシーを報告します。セッションの固定によって、複数ターンにわたる作業でもモデルの一貫性やプロンプトキャッシュの効果を保てます。また、必要に応じて、フォールバックの動作によって不健全なモデルから離れることもできます。
ツール側では、エージェントは有料の呼び出しを行う前に、現在のエンドポイントのスキーマを確認します。発見の結果には候補を比較するために必要な情報が含まれ、実際の呼び出しの結果が、最終的な生成に渡される唯一の外部の根拠になります。
これらの制御を組み合わせると、次のような有用な監査証跡が得られます。
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
この証跡は、多数のモデルや多数のAPIに単にアクセスできることよりも価値があります。エージェントが各選択をなぜ行ったのか、そして回答を裏付けた根拠が何だったのかを説明できるからです。
両方の層が必要ない場合
すべてのワークフローが、実行時の選択から恩恵を受けるわけではありません。
アプリケーションが1つの安定したプロンプトを、ベンチマーク済みの1つのモデルに送るだけなら、そのモデルを直接指定する方が、ルーティングよりも単純で決定的です。定期実行されるパイプラインが、常に1つの既知のAPIを呼び出すのであれば、そのAPIを直接統合する方が、発見の層を追加するよりも分かりやすいでしょう。
2層のアーキテクチャは、ワークロードに多様性が含まれる場合に価値を発揮します。
- プロンプトの内容が工程ごとに大きく異なり、最適なモデルが工程によって変わる場合。
- エージェントは複数回のモデル呼び出しを行うため、累積コストやレイテンシを制御する必要があります。
- 必要なツールは、ビルド時に完全に予測できるとは限りません。
- 外部データは最新である必要があり、そのソースが明示されている必要があります。
- チームは、機能を追加するたびに新しいベンダー連携を追加することなく、機能を拡張したいと考えています。
アプリケーションが実際に行う必要のある判断に応じて、モデル層、ツール層、またはその両方を使用してください。
依存関係ではなく、判断を中心にエージェントを構築する
本番環境のAIエージェントは、接続できるモデルやAPIの数によって定義されるものではありません。現在のステップに適した機能を選択でき、予算の範囲内で動作でき、何が起きたかを説明できるかどうかによって定義されます。
AIHubMixは、エージェントに統一されたモデルエンドポイントと、コスト、品質、レイテンシの優先度に基づくリクエスト時のルーティングを提供します。Monidは、エージェントに実行時のツール検出、最新のスキーマ、明示された価格、そして外部プロバイダー間での実行機能を提供します。
一方の層はエージェントの思考方法を決定し、もう一方は情報の取得方法と行動方法を決定します。これらの判断を分離しておくことで、拡張、観測、制御がしやすいエージェントになります。
まずAIHubMixのクイックスタートを始めてから、Monidを通じてツール側を接続してください。
FAQ
AIエージェントにとってのモデルルーティングとは何ですか?
モデルルーティングは、タスクの種類、機能、コスト、レイテンシなどの要素に基づいて、リクエストごとにモデルを選択する仕組みです。AIHubMixでは、modelをautoに設定するか、auto:quality_firstのようなポリシーを指定することで、OpenAI互換APIを維持したまま、リクエスト時の選択が有効になります。
LLMがすでに知識を持っているのに、AIエージェントにツールが必要なのはなぜですか?
LLMは、受け取ったコンテキストと学習時に得た知識に基づいて回答を生成します。接続されたツールがなければ、現在の価格を確実に知ることや、非公開のデータベースに問い合わせること、外部でのアクションを実行することはできません。ツールはライブデータと実行機能を提供し、モデルは計画を立てて結果を解釈します。
モデルゲートウェイは、MCPサーバーやツールプラットフォームと同じものですか?
いいえ。モデルゲートウェイは推論リクエストをモデルにルーティングします。MCPサーバーやツールプラットフォームは、外部の機能をエージェントに公開します。両者は相補的な連携の課題を解決するものであり、併用することができます。
AIHubMixとMonidは、それぞれ単独で使用できますか?
はい。動的なツール要件がないアプリケーションでは、AIHubMixだけでモデル呼び出しをルーティングできます。別のモデルプロバイダーやゲートウェイを使用しているエージェントに対しては、Monidがツール検出を提供できます。エージェントが両方の層で実行時の選択を必要とする場合は、両方を併用すると効果的です。
自動ルーティングの監査可能性を保つにはどうすればよいですか?
タスクごとに、解決されたモデル、ルーティングポリシー、ツールの候補、確認した価格、選択されたエンドポイント、返された結果をログに記録してください。AIHubMixはレスポンスにモデルルーティングの詳細を含めます。Monidは検出と確認を実行から分離しているため、有料の呼び出しの前にツールの判断を記録できます。