2026年8月4日、DeepSeekの公式ステータスページでは、APIの性能低下に関するインシデントが2件記録されました。
1件目のインシデントは1時間18分続き、UTC 02:02から03:20まで発生し、DeepSeek V4 Flash、V4 Pro、Expert Modeに影響しました。2件目のインシデントは36分続き、UTC 03:43から04:20まで発生し、DeepSeek V4 Flash APIに影響しました。
いずれのインシデントもその後解決されています。また、OpenCodeは、前例のない需要によりDeepSeek Flashでキャパシティの問題が発生していると報告しました。ただし、DeepSeekの公式ステータスページは性能低下を確認しただけで、根本原因は公開していません。
TL;DR
- DeepSeekの公式ステータスページには、2026年8月4日にV4 Flashに影響する性能低下インシデントが2件記録されました。
- プロバイダーに直接接続する構成では、同じモデルが他でも利用可能であっても単一障害点が生まれます。
- 上流のルートが再試行可能なエラーを返した場合、AIHubMixは複数のプロバイダーチャネルをまたいで同じモデルを再試行できます。
- 主要モデルのすべてのプロバイダーチャネルが失敗した場合、キー単位のモデルフォールバックにより、設定済みのバックアップモデルへリクエストを切り替えられます。
- マルチプロバイダーのルーティングは1つのエンドポイントへの依存を減らしますが、相関的な障害やゲートウェイレベルのリスクを排除することはできません。
今回のようなインシデントは、インフラに関する重要な原則を浮き彫りにします。
信頼性の高いモデルであっても、単一のプロバイダーエンドポイント経由でアクセスするだけでは十分ではありません。
1つのモデルが1つのプロバイダーを意味するとは限らない
アプリケーションが1つのプロバイダーに直接接続している場合、そのエンドポイントが単一障害点になります。
プロバイダーで障害が発生したり、レート制限に達したり、レイテンシが急増したりすると、アプリケーションはリクエストを送る別の先がありません。同じモデルが他のインフラプロバイダー経由で利用可能なままであっても、ユーザーにはタイムアウトやエラーが表示されてしまいます。
AIHubMixは、モデルとそれを提供するプロバイダーを分離します。
たとえば、DeepSeek V4 Flashは、AIHubMix上でDeepSeek、Baidu、DeepInfra、Alibaba Cloudを含む複数のプロバイダーから利用できます。アプリケーションは、AIHubMixが利用可能な上流ルートを管理する間も、1つのOpenAI互換APIエンドポイントを使い続けられます。
これにより、2つの異なる信頼性のレイヤーが生まれます。
レイヤー1:プロバイダーフェイルオーバー
プロバイダーフェイルオーバーは、要求されたモデルを変更せず、その背後にあるインフラプロバイダーを切り替えます。
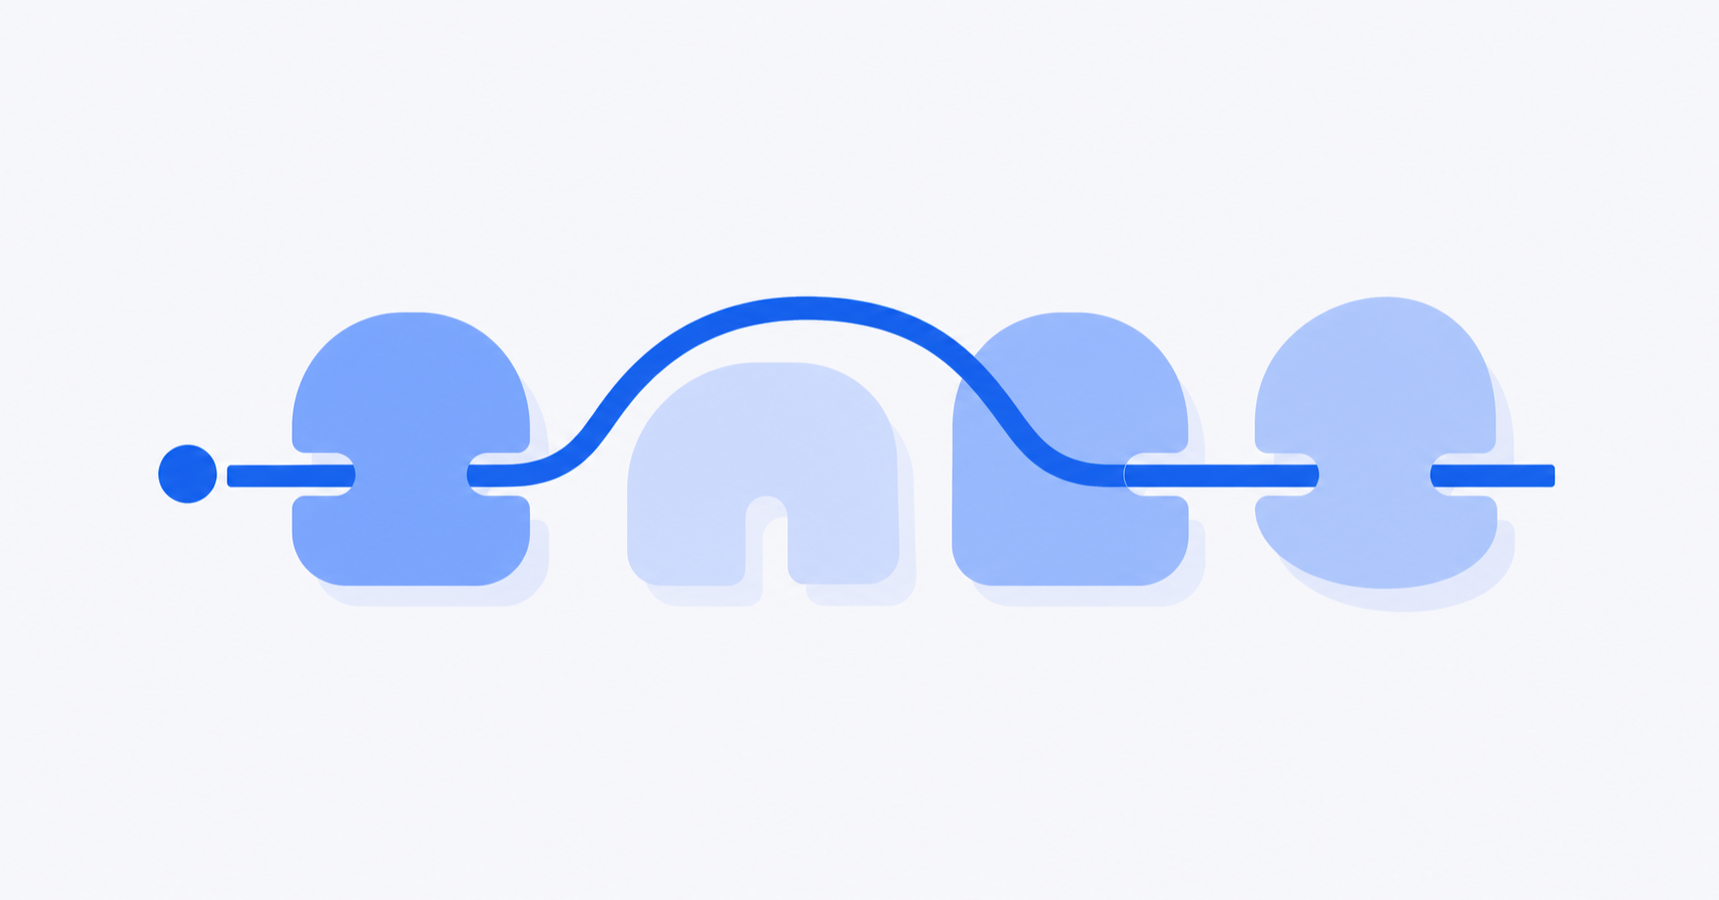
DeepSeek V4 FlashへのリクエストがAIHubMixに届くと、ゲートウェイは利用可能なプロバイダーチャネルを選択します。そのチャネルがレスポンス開始前に再試行可能なエラーを返した場合、AIHubMixは同じモデルで利用可能な別のチャネルを試行できます。
リクエストの経路は次のようになります。
- Provider Aを経由してDeepSeek V4 Flashを試行します。
- Provider Aがタイムアウト、5xxエラー、または再試行可能なキャパシティエラーを返します。
- 同じDeepSeek V4 FlashモデルをProvider Bを経由して試行します。
- リクエストが成功するか、利用可能な対象チャネルがすべて尽きるまで続けます。
クライアント側で複数のプロバイダーSDKを組み込んだり、個別のAPIキーを管理したり、独自の再試行ロジックを実装したりする必要はありません。
これはプロバイダーレベルのフェイルオーバーであり、プロバイダーは変わりますが、要求されたモデルは変わりません。
レイヤー2:モデルフォールバック
主要モデルについて利用可能なプロバイダーがすべて利用不可である場合、プロバイダーフェイルオーバーでは対処できません。
そのため、AIHubMixでは2つ目の信頼性のレイヤーとして、モデルフォールバックをサポートしています。
ユーザーは、APIキーごとにバックアップモデルの順序付きリストを設定できます。主要モデルの対象チャネルがすべて再試行可能な失敗を返した後、AIHubMixはフォールバックリストの次のモデルに移行します。
たとえば、次のようになります。
- 主要モデル:
deepseek-v4-flash - 1番目のフォールバック:
gpt-5.4 - 2番目のフォールバック:
gemini-3.1-pro-preview
フォールバックはAIHubMixゲートウェイ内で実行されます。既存のアプリケーションは、追加のルーティングパラメータを送ったりクライアントのコードを変更したりする必要はありません。
課金は、最終的に成功レスポンスを返したモデルに基づいて行われます。開発者は、レスポンスヘッダーを通じてフォールバックの動作を確認できます。
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
完全な設定と発動条件はAIHubMixのモデルマッピングとフォールバックに記載されています。
自動フェイルオーバーで対処できること
プロバイダーフェイルオーバーは、次のような上流のインフラの問題から回復するように設計されています。
- プロバイダーのタイムアウト
- 接続の失敗
- 再試行可能な5xxレスポンス
- プロバイダーのレート制限とキャパシティエラー
- 上流チャネルの一時的な利用不可
これらの障害がレスポンス開始前に発生した場合、AIHubMixは透過的に別の経路を試行できます。
フェイルオーバーで解決できないこと
マルチプロバイダーのルーティングは可用性を向上させますが、ゲートウェイを絶対に故障しないものにするわけではありません。
次の場合、フォールバックは発動しません。
- ユーザーのAIHubMix APIキーが無効、期限切れ、またはクォータ超過である
- リクエスト自体が不正である
- クライアントが切断された、またはクライアント側のタイムアウトに達した
- ストリーミングレスポンスがすでに開始されている
- 特定のプロバイダーチャネルが明示的に選択されている
- 障害がすべてのプロバイダーまたはゲートウェイ自体に影響している
プロバイダーの障害は相関している場合もあります。複数のプロバイダーが同じ基盤インフラ、モデルのリリース、または地域のネットワークに依存していることがあります。そのため、マルチプロバイダーの可用性は、プロバイダーの数だけから想定するのではなく、実際のトラフィックで測定すべきです。
アグリゲーターが直接エンドポイントより信頼性が高くなる理由
公式APIに直接呼び出すと、アプリケーションはモデルへの経路を1つだけ持つことになります。
マルチプロバイダーのゲートウェイでは、複数の経路を持つことになります。
これらのプロバイダー経路が独立して障害を起こす場合、ゲートウェイは劣化したエンドポイントを迂回でき、障害をアプリケーションに見せずに済みます。これにより、いずれか1つのプロバイダーへの依存が減り、単一プロバイダーへの直接接続よりも高い可用性を実現できます。
違いはアーキテクチャにあります。
- 直接API:1つのモデル、1つのプロバイダー、1つの障害ドメイン
- AIHubMix:1つのモデル、複数のプロバイダー、自動フェイルオーバー
- モデルフォールバック付きのAIHubMix:複数のプロバイダーとバックアップモデル
目標は、次にどのプロバイダーが障害を起こすかを予測することではありません。上流のインシデントを、顧客に影響するアウテージではなく、内部のルーティングイベントにすることです。
次のプロバイダーインシデントに備える
DeepSeek V4 Flashは回復しましたが、一時的なキャパシティの制約、レート制限、上流の障害は、本番環境のAIインフラにおいて通常起こることです。
プロバイダーが不安定になるたびにアプリケーションのコードを変更しなければならないのは避けるべきです。
AIHubMixを使えば、開発者は1つのAPIで複数のプロバイダーにアクセスし、利用可能なチャネル間で同じモデルを自動的に再試行でき、さらなる保護のためにバックアップモデルを設定できます。
利用可能なモデルとプロバイダーはaihubmix.com/modelsでご確認いただけます。
FAQ
マルチプロバイダーフェイルオーバーとは何ですか?
現在の経路が再試行可能な失敗を返した場合に、同じモデルを対象となる別のプロバイダー経由で自動的に再試行する仕組みです。
モデルフォールバックとはどう違うのですか?
プロバイダーフェイルオーバーではモデルは変わりません。モデルフォールバックは、主要モデルの対象チャネルがすべて失敗した後にのみ、設定済みのバックアップモデルへ切り替えます。
どのような障害でフェイルオーバーが発動しますか?
代表的な発動条件は、レスポンス開始前のタイムアウト、接続の失敗、再試行可能な5xxレスポンス、レート制限、一時的なキャパシティエラーです。
フェイルオーバーでダウンタイムがゼロになることは保証されますか?
いいえ。相関するプロバイダーの障害、ゲートウェイレベルのインシデント、再試行不可能なエラー、ストリーミング開始後の障害は、依然としてクライアントに届く可能性があります。
アプリケーションのコードを変更する必要はありますか?
追加のルーティングロジックは不要です。アプリケーションはAIHubMixのOpenAI互換エンドポイントを引き続き使用でき、バックアップモデルはAPIキー単位で設定できます。