

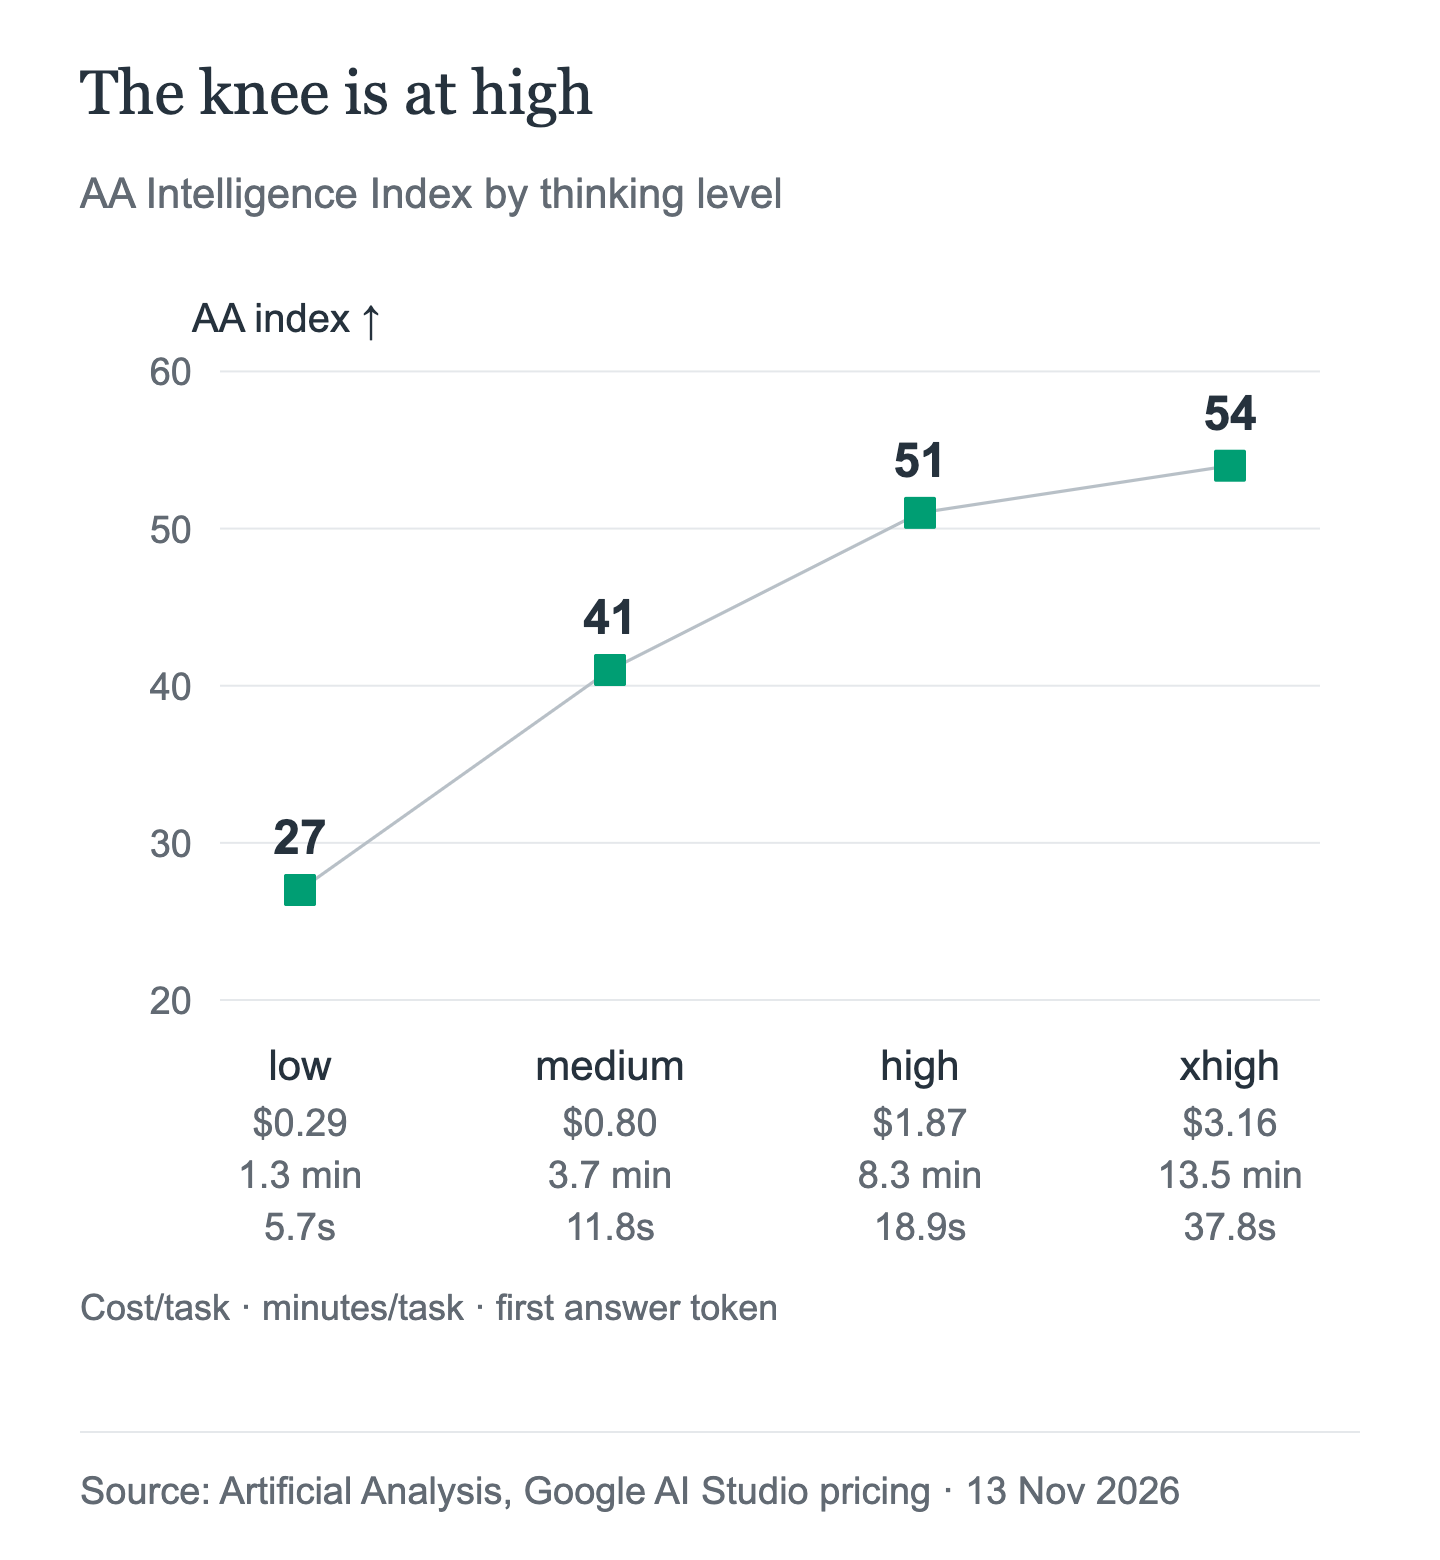
Gemini 4 Hydrogen ha quattro livelli di ragionamento, che si comportano come quattro modelli diversi. Nelle misurazioni in tempo reale di Artificial Analysis, lo stesso modello ottiene un punteggio di 27 con low, 41 con medium, 51 con high e 54 con xhigh. Il livello predefinito è high, mentre xhigh è una novità della famiglia Gemini 4: Carbon e Argon si fermano a high.
La differenza è ampia: lo stesso modello copre 27 punti indice tra low e xhigh. Passare da medium a high fa guadagnare 10 punti indice per circa $1.07 in più per attività. Passare da high a xhigh fa guadagnare 3 punti per $1.29 e quasi raddoppia l’attesa prima del primo token di risposta. In pratica, conviene partire da high, riservare xhigh alle attività complesse con più passaggi e considerare low e medium come impostazioni di latenza, verificandone la qualità separatamente.
Di seguito: a cosa serve ogni livello, quanto costa, cosa cambia nell’API e cosa AIHubMix documenta e cosa no.
I quattro livelli e le novità
Gemini 4 Hydrogen supporta low, medium, high e xhigh. Le note di rilascio di Google sono esplicite: «Il modello usa high come valore predefinito e introduce xhigh». Sono due cambiamenti rispetto a Gemini 3.8 Flash, che usa medium come valore predefinito e si ferma a high.
Il resto della famiglia non è cambiato. Carbon e Argon supportano low, medium e high, con medium come valore predefinito. Hydrogen è l’unico modello Gemini 4 con un’impostazione superiore a high.
| Modello | Livelli | Predefinito |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL non fa parte dell’insieme. La documentazione sul ragionamento di Gemini 4 afferma che MINIMAL «non è supportato sui modelli Gemini 4» e le note di rilascio di Hydrogen dicono che il modello «rifiuta minimal con un errore». Per questo modello non è documentato alcun interruttore per disattivare il ragionamento.
Cosa consiglia Google
Le indicazioni di Google sono un ragionevole punto di partenza, ma sono state formulate prima delle misurazioni riportate sotto. In particolare, il consiglio di usare medium per la programmazione interattiva presuppone una qualità che Artificial Analysis non rileva con medium.
| Livello | Descrizione e usi consigliati da Google |
|---|---|
| low | «Meno token, latenza più bassa» — chat rapida, volumi elevati |
| medium | «Meno token, risposte più rapide» — programmazione interattiva, prototipi UI |
| high | «Equilibrio tra intelligenza e velocità» — predefinito per la maggior parte delle attività |
| xhigh | «Più token, ragionamento più approfondito» — programmazione complessa con più passaggi |
La tabella è accompagnata da due avvertenze. «Usare xhigh aumenta la latenza e il consumo di token e può portare a ragionare troppo su prompt più semplici», afferma Google. Inoltre, le indicazioni per la valutazione sono esplicite: «Eseguite le vostre valutazioni con tutti e quattro i livelli e un valore elevato di max_output_tokens».
La scala misurata
Artificial Analysis ha misurato tutti e quattro i livelli. La rilevazione usa Intelligence Index v5.0.1, con 78 modelli classificati, consultata il 2026-11-13T02:40Z, ai prezzi standard di listino. Si tratta dei costi per attività di AA, non delle fatture di AIHubMix.
| Livello | Posizione AA | Indice AA | $/attività | Min/attività | Primo token di risposta |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
La parte più utile sono le differenze tra un livello e l’altro:
low→medium: +14 punti indice, +$0.51 per attività, +2.4 minuti, +6.1 secondi prima del primo token.medium→high: +10 punti indice, +$1.07 per attività, +4.6 minuti, +7.1 secondi prima del primo token.high→xhigh: +3 punti indice, +$1.29 per attività, +5.2 minuti, +18.9 secondi prima del primo token.
high è il punto di svolta. È l’ultimo passaggio in cui il guadagno in qualità è consistente rispetto all’aumento del costo; con xhigh, invece, l’attesa del primo token quasi raddoppia a fronte di un guadagno di pochi punti indice. Questo non rende xhigh una cattiva impostazione: è adatta alle attività in cui high non basta, proprio come la descrive Google.
Per confronto, nella stessa rilevazione Carbon high ottiene 60 con un costo di $5.48 per attività e una durata di 28.1 minuti; Carbon medium ottiene 58 con un costo di $4.68; Carbon low ottiene 54 con un costo di $5.22; Argon high ottiene 50 con un costo di $4.97 e una durata di 30.6 minuti. Hydrogen xhigh raggiunge il punteggio di 54 di Carbon low con un costo per attività inferiore del 39.5% ($3.16 contro $5.22), ma il primo token arriva dopo 37.77 secondi invece di 13.61. Hydrogen high supera Argon high di un punto indice, con un costo per attività inferiore del 62.4%.
Dove la scala mostra i suoi limiti
low non è un piccolo compromesso. Con 27 punti, è 24 punti indice sotto high. Passare da high a low per risparmiare $1.58 per attività non significa acquistare lo stesso prodotto con meno ragionamento: significa scegliere un modello molto meno potente. Può andare bene per classificazione, instradamento o estrazione di informazioni brevi. Non è adatto alla programmazione o alle attività basate su agenti senza una valutazione specifica per l’attività.
medium è un’impostazione di latenza, non di qualità. Ottiene 41 punti, 10 in meno di high, e costa $0.80 contro $1.87. Il risparmio è reale — 57% per attività — ma il divario qualitativo è maggiore di quanto suggerisca la differenza di prezzo. Google consiglia medium per la programmazione interattiva; prima di adottarlo, i dati AA suggeriscono di verificare questa indicazione con le proprie attività.
xhigh può ragionare troppo. Google lo avverte chiaramente. I dati di AA su costi e tempi mostrano l’effetto: $3.16 per attività, 13.5 minuti e 37.77 secondi di attesa prima del primo token. Per un prompt semplice, è molta latenza per un guadagno ridotto. Per un’attività di programmazione complessa con più passaggi in cui high non basta, è l’unico livello che permette di spingersi oltre.
Anche la verbosità incide sul costo. Artificial Analysis descrive Hydrogen come «molto verboso»: l’esecuzione con xhigh ha generato 304 milioni di token di output per completare l’indice, piazzandosi al #76 su 77, contro una mediana di 72.8 milioni. I token di output includono quelli di ragionamento e l’output costa $7.50 per milione. Un livello più alto non si limita a ragionare più a lungo: produce più token fatturabili.
I costi: come il ragionamento si traduce in token
Il tariffario è semplice. Hydrogen costa $1.50 per milione di token di input, $7.50 per milione di token di output e $0.075 per milione di token di input memorizzati nella cache. L’output include i token di ragionamento. Ecco perché il livello conta più della tariffa: si paga per il ragionamento prodotto dal modello, non per il nome del livello.
Ci sono tre regole di fatturazione facili da non notare.
Il valore predefinito è cambiato. Gemini 3.8 Flash usava medium come valore predefinito; Hydrogen usa high. Dopo la migrazione, un flusso di lavoro che non specificava mai un livello consumerà più token di output per turno, anche se il prezzo per token resta invariato. È una modifica al budget mascherata da cambio di modello.
La cache è disponibile solo in modalità implicita. Hydrogen supporta la cache implicita, con un minimo di 4,096 token e uno sconto del 95% sui cache hit; la cache esplicita non è supportata. La pagina aziendale di Google afferma inoltre che «le scritture in cache sono fatturate per impostazione predefinita a 1.25x il prezzo standard dei token di input». Questa è la formulazione usata da Google per la fatturazione; la fatturazione della cache di AIHubMix per questo modello non è documentata.
L’output lungo ha un limite per ogni chiamata. Una richiesta sincrona genera fino a 65,536 token per chiamata, sia in streaming sia senza streaming. Per un output più lungo servono l’esecuzione in background o i token di continuazione, e max_output_tokens limita la somma dei token di ragionamento e di output. Se imposti background=true senza max_output_tokens, il server si ferma dopo 65,536 token. I budget suggeriti da Google per le decodifiche lunghe sono 131,072 o 262,144, fino a un massimo di 1,048,576 meno i token di input.
Cosa accetta l’API e cosa rifiuta
Il parametro è thinking_level (snake_case). Nell’esempio Python di Google, è impostato dentro thinking_config; nell’esempio Node è annidato sotto thinkingConfig (camelCase). La pagina del modello elenca i valori LOW, MEDIUM, HIGH e XHIGH; nelle note di rilascio sono scritti in minuscolo. Usa l’enum del tuo SDK o la stringa documentata, invece di digitare manualmente una variante con maiuscole e minuscole diverse.
Tre tipi di richiesta non vanno a buon fine:
thinking_budgetsu qualsiasi modello Gemini 4 restituisce400: INVALID_ARGUMENT. Anche specificare siathinking_levelsiathinking_budgetrestituisce un errore.thinking_level="MINIMAL"non è supportato; Hydrogen lo rifiuta.- I valori personalizzati di
temperature,top_petop_kvengono ignorati. I valori fissi predefiniti sono temperature 1.0, topP 0.95 e topK 64.
Sulla piattaforma Google, Hydrogen supporta anche le chiamate a funzioni, l’esecuzione di codice, il contesto URL e l’uso del computer. Nell’API Interactions, usa previous_interaction_id per le sessioni multi-turno e con chiamate agli strumenti.
Cosa documenta AIHubMix e cosa no
La route documentata da AIHubMix per Hydrogen è POST https://aihubmix.com/v1/chat/completions con model="gemini-4-hydrogen". La pagina del modello indica input di testo, immagini, audio, video e PDF, con output testuale; llms.txt riporta ancora una vecchia indicazione che menziona solo il testo, quindi considera la pagina la fonte più aggiornata. Le funzionalità relative all’uso degli strumenti, all’output strutturato e al ragionamento sono indicate come «non pubblicate». Il modello non compare nell’indice dei modelli generato il 2026-11-11 e non è pubblicato alcuno schema di protocollo.
Questo è importante per l’articolo perché AIHubMix non documenta come impostare un livello di ragionamento per nessun modello Gemini 4. La sua guida a Gemini illustra reasoning_effort per i modelli dell’era Gemini 2.5, non thinking_level o xhigh per Gemini 4. Non dare per scontato che uno dei due parametri venga inoltrato dal gateway, né che su AIHubMix si applichi il valore predefinito osservato nell’API di Google.
La struttura di richiesta sicura è quella documentata da AIHubMix:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Se poter controllare il livello è un requisito imprescindibile, chiama direttamente l’API di Google oppure verifica il comportamento del gateway con una piccola richiesta prima di instradare il traffico di produzione. La pagina di confronto di AIHubMix è utile per valutare i costi mentre decidi. Per questo articolo non è stato eseguito alcun test in tempo reale.
Da dove partire in base al carico di lavoro
| Carico di lavoro | Livello consigliato e motivo |
|---|---|
| Chat rapida, instradamento, classificazione | medium, provare low; low ottiene 27 |
| Programmazione interattiva, prototipazione UI | high; medium di AA è a 41 |
| Esecuzione di agenti, cicli di chiamate agli strumenti | high; xhigh solo se ci si blocca |
| Debug complesso, architettura, pianificazione | xhigh o Carbon; 3 punti in più per il 69% in più |
| Elaborazione batch ad alto volume dopo la valutazione | low o medium; i più economici, ma indice di 27/41 |
| Limite di latenza rigoroso, inferiore a 15 secondi | medium o low; high attende 18.89 s |
Questi sono punti di partenza, non regole di instradamento. Il livello giusto è quello più basso che supera la tua valutazione; il consiglio di Google è di eseguire tale valutazione a tutti e quattro i livelli.
Domande frequenti
Quali livelli di ragionamento offre Gemini 4 Hydrogen?
Quattro: low, medium, high e xhigh. Il valore predefinito è high.
Cosa è cambiato rispetto a Gemini 3.8 Flash?
Il valore predefinito è passato da medium a high ed è stato aggiunto xhigh sopra high. Carbon e Argon mantengono medium come valore predefinito e si fermano a high.
Vale la pena usare xhigh?
Per le attività complesse e articolate in più passaggi in cui high non basta, sì: aggiunge 3 punti all'indice. Costa anche il 69% in più per attività rispetto a high e quasi raddoppia l'attesa prima del primo token, quindi è una scelta predefinita poco adatta ai prompt semplici.
Perché low è così indietro?
Artificial Analysis gli assegna 27 nell'indice, 24 punti in meno di high. Il prezzo è di $0.29 per attività contro $1.87, ma il divario di qualità è molto più ampio di quello di prezzo. Usalo solo quando una valutazione specifica dell'attività conferma che è sufficiente.
AIHubMix supporta thinking_level o xhigh?
La documentazione non lo indica. AIHubMix non pubblica alcun flag di funzionalità di ragionamento per Hydrogen né una guida ai livelli di ragionamento di Gemini 4. Verifica prima di fare affidamento su uno dei due.
Cosa succede se invio thinking_budget?
Gemini 4 restituisce 400: INVALID_ARGUMENT. Impostare sia thinking_budget sia thinking_level restituisce anch'esso un errore.
Posso disattivare il ragionamento?
Non è documentato alcun interruttore per disattivarlo. MINIMAL non è supportato su Gemini 4 e Hydrogen lo rifiuta con un errore.
Continua a leggere: la serie Gemini 4 Hydrogen
- Se stai ancora decidendo se Hydrogen sia l'aggiornamento giusto rispetto a Gemini 3.8 Flash, il primo articolo tratta il lancio, la variazione di prezzo e i compromessi nei benchmark: Gemini 4 Hydrogen vs Gemini 3.8 Flash: vale la pena aggiornare?.
- Se ti chiedi come si confronti Hydrogen con Carbon e Argon per lo stesso lavoro, il terzo articolo mette a confronto tutti e tre con prezzi, latenza e una tabella dei carichi di lavoro: Gemini 4 Carbon vs Hydrogen vs Argon: quale modello scegliere per ogni attività?.
Fonti
- Google AI Studio, Gemini 4 Hydrogen: tutte le novità
- Google, Gemini 4 thinking
- Google, pagina del modello Gemini 4 Hydrogen
- Google AI Studio, prezzi dell'API Gemini
- Artificial Analysis, Gemini 4 Hydrogen — istantanea aggiornata al 2026-11-13T02:40Z, Intelligence Index v5.0.1


