Gemini 4 Carbon sostituisce Gemini 4 Argon senza modifiche allo schema delle richieste. Lo stesso corpo per le chat completions funziona: cambia l’ID del modello e alcuni valori dei parametri non vengono mantenuti. I problemi più importanti si trovano un livello più in basso: errori dei parametri che restituiscono 400, limiti di output che troncano silenziosamente e un profilo di timeout e fatturazione pensato per sessioni di ragionamento prolungate.
Quattro impostazioni predefinite determinano la prima settimana:
- Su AIHubMix, mantieni
max_tokensa 65,536 o meno; il gateway documenta solo Chat Completions e non pubblica un percorso per output più lunghi. - Per le esecuzioni in background di Google Native Interactions, imposta
store=truee unmax_output_tokensesplicito; questi campi non sono documentati per Carbon su AIHubMix. - Quando usi il percorso nativo del fornitore per la decodifica lunga, imposta i timeout di lettura HTTP su 15–20 minuti per stream.
- Rimuovi
temperature,top_petop_k, che vengono ignorati, e le penalità; valori dicandidate_countsuperiori a 1 restituiscono 400 nella guida Carbon di Google.
Le basi che non cambiano — accesso, rifiuti per motivi di sicurezza, costo per attività — sono trattate nel post sulla migrazione da Argon. Questo post riguarda il comportamento specifico di Carbon.
Cosa genera un errore e cosa fallisce in silenzio
I problemi si dividono nettamente: un 400 te lo segnala subito, un limite silenzioso te lo segnala la fattura.
| Cosa vedi | Categoria | Primo intervento |
|---|---|---|
| HTTP 400 su un parametro | Esplicito | Rimuovi il campo non supportato |
| 400 su una richiesta in background | Esplicito | Aggiungi store=true |
| La risposta si interrompe a 65,536 token | Silenzioso | Aumenta max_tokens, fino a 65,536 |
| Testo vuoto, stato incomplete | Silenzioso | Aumenta il limite e riprova |
| L’esecuzione in background si interrompe vicino a 64K | Silenzioso | Imposta max_output_tokens |
| La risposta sembra meno approfondita | Silenzioso | Imposta esplicitamente il livello di ragionamento |
| Fattura superiore alla stima | Silenzioso | Calcola i token di ragionamento e i passaggi di decodifica |
AIHubMix indica gemini-4-carbon a $2 per i token di input, $10 per quelli di output e $0.10 per i token memorizzati nella cache, per milione di token — le tariffe introduttive di Google — tramite Chat Completions. Sono temporanee; vedi la sezione sulla fatturazione.
Errori espliciti: i 400 documentati
Molti errori 400 documentati riguardano la convalida dei parametri; la cronologia e i turni del modello precompilati causano errori nello stato della richiesta. Salvo diversa indicazione, le regole seguenti provengono dalla guida nativa di Google per Carbon; al momento AIHubMix documenta per Carbon solo Chat Completions. La scheda di Carbon su AIHubMix descrive in una riga questa categoria: "400 — errore del parametro; la maggior parte viene inoltrata dal fornitore upstream." È una descrizione del gateway, non il risultato di un test. I dettagli provengono dalla guida Carbon e dalla pagina delle novità di Google.
| Condizione | Cosa vedi | Correzione |
|---|---|---|
| max_output_tokens > 1M* | 400; oltre il limite | Nativo ≤1M; gateway ≤65K* |
| frequency/presence penalty | 400; non supportato | Rimuovi i campi |
| candidate_count > 1 | 400; più candidati | Ometti il parametro o impostalo su 1 |
| background senza store* | 400; store obbligatorio* | Aggiungi store=true |
| La cronologia termina con un turno del modello | Rifiutato; non supportato | Termina con un turno utente |
| entrambi i controlli | 400; non possono essere combinati | Inviane uno solo |
| thinking_budget o MINIMAL | 400; guida Carbon | Usa low/medium/high |
Google mostra il messaggio esattamente così: "store=true is required for background interactions." * Solo Google Native: max_output_tokens ha un limite di 1M e per le richieste in background è obbligatorio store=true; AIHubMix non ha documentato questo percorso. Su Chat Completions, mantieniti a ≤65K.
La riga minimal ha due significati. Nei campi nativi di Carbon di Google, thinking_budget e thinking_level=MINIMAL restituiscono HTTP 400; usa low, medium o high. Nel livello di compatibilità OpenAI di Google, reasoning_effort=minimal corrisponde a low; AIHubMix non ha specificato se applica questa conversione a Carbon.
La gestione degli strumenti è un problema correlato. La guida Carbon di Google consiglia di preferire turni di esecuzione degli strumenti sequenziali e la guida Gemini di AIHubMix documenta tool_choice="auto"; il supporto specifico per gli strumenti di Carbon sul gateway non è stato confermato.
La richiesta minima sicura su /v1/chat/completions elimina i parametri ignorati da Carbon:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Se restituisce 200, il livello di trasporto è a posto. Il resto riguarda risposte che non generano mai un errore.
Problemi silenziosi: nessun errore, output sbagliato, fattura sbagliata
Il limite standard di output è 65,536; la decodifica lunga del fornitore è un percorso separato
Il limite massimo standard di output di Carbon è 65,536 token. Con Chat Completions, il campo per il limite è max_tokens; le guide native di Google lo chiamano max_output_tokens. Il percorso nativo di Google per la decodifica lunga può arrivare fino a 1,048,576 token meno l'input; 131,072 e 262,144 sono alcuni esempi. La pagina delle novità di Google specifica la regola: "If you set background: true without defining max_output_tokens, the server stops after 64K tokens." AIHubMix non ha documentato la modalità in background né la continuazione per Carbon.
La decodifica lunga nativa del fornitore viene eseguita in segmenti: 64K per passaggio con background o streaming, 32K per passaggio senza streaming; una singola richiesta REST senza streaming si interrompe dopo 32,768. La guida di Google avverte che "Earlier SDK versions and the OpenAI compatibility layer can't retrieve long completions using continuation tokens." Per AIHubMix, mantieni max_tokens a 65,536 o meno come limite prudenziale del gateway, non verificato; non fare affidamento sull'unione di risposte più lunghe finché la pagina del modello non documenta questa possibilità.
Un limite basso tronca il ragionamento e l'output vuoto viene fatturato
Il limite include il ragionamento, non solo il testo. La guida di Google sulla decodifica lunga dice: "A low value, such as 8,192, stops the model before it finishes thinking." Lo stato diventa incomplete e "Text can be empty if the model was still thinking." In entrambi i casi paghi. Calcola il budget per il ragionamento e la risposta e considera una risposta incompleta e vuota un problema di limite: aumentalo, riprova e tieni conto che il primo tentativo comparirà in fattura.
Il livello di ragionamento predefinito è medium
Carbon usa medium per impostazione predefinita, proprio come Argon. I team che passano da Gemini 3.1 Pro Preview, che usa high per impostazione predefinita, vedono il livello abbassarsi senza modifiche al codice e interpretano la risposta meno approfondita come una regressione. Google consiglia medium per la maggior parte delle attività di programmazione e agentiche. Imposta esplicitamente il livello in staging e invia un solo campo di controllo: reasoning_effort e thinking_level non possono essere combinati.
I parametri di campionamento vengono ignorati
temperature, top_p e top_k vengono ignorati: nessun errore e nessuna variazione nel campionamento. Rimuovili. Le penalità e i valori di candidate_count superiori a 1 restituiscono 400.
La cache esplicita non è più disponibile
cachedContents e caches.create non sono supportati. La cache implicita si applica a partire da 4,096 token, con uno sconto del 95%. Elimina il codice per la cache esplicita, metti prima il prefisso stabile del prompt e verifica l'uso dei token memorizzati nella cache prima di calcolare lo sconto nel budget.
Lo stato della conversazione segue una regola
Google consiglia di usare previous_interaction_id per continuare. Chat Completions non dispone di questo campo, quindi mantieni la cronologia ma termina con un turno utente; una cronologia che termina con un turno del modello o un turno del modello precompilato non sono supportati.
Timeout: 15–20 minuti, non 60 secondi
La guida di Google sulla decodifica lunga consiglia timeout di lettura HTTP da 15 a 20 minuti per stream; la checklist di migrazione ribadisce un minimo di 15 minuti. Questa raccomandazione riguarda le richieste di decodifica lunga. Una misurazione separata di AA rileva il tempo di attesa prima del primo token della risposta: Carbon High ha impiegato 67.1 secondi, Medium 23.2, Low 12.9 e Argon High 40.1. Con un limite di 60 secondi, il primo token fa in tempo ad arrivare?
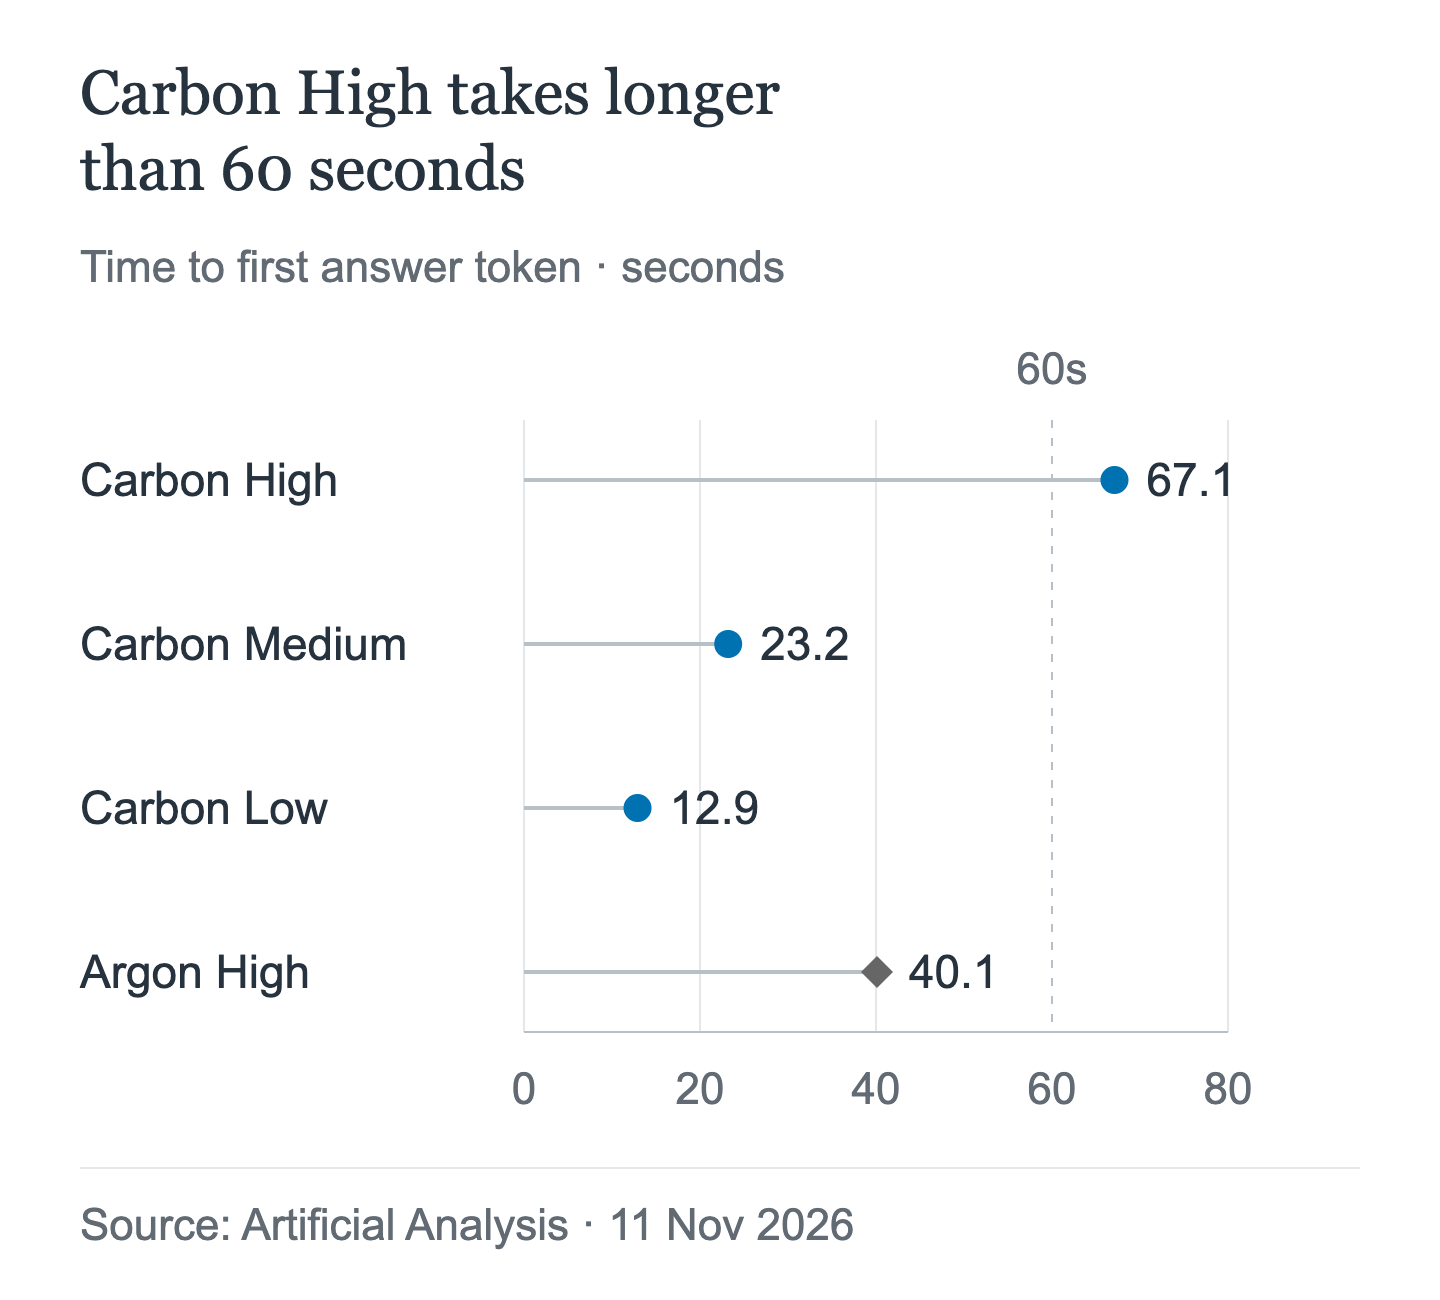
In questa misurazione, Carbon High supera il riferimento di 60 secondi. Il tempo al primo token non permette di stabilire un timeout sicuro per l'intera richiesta: il consiglio di 15–20 minuti qui sopra proviene dalla guida di Google sulla decodifica lunga. Questi risultati rappresentano una singola rilevazione, non garanzie di latenza né un test di AIHubMix.
I limiti temporali dei singoli passaggi dei client nativi di Google sono più stretti di quelli per le richieste in background: 20 minuti per uno stream, 10 per una chiamata senza streaming, rispetto a 24 ore per il background. AIHubMix non documenta questi limiti per le richieste in background.
Versioni minime degli SDK nativi per la decodifica lunga: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. Per Claude Code, API_TIMEOUT_MS è impostato su 10 minuti per impostazione predefinita; se in futuro verrà confermato un percorso Claude Code per Carbon, aumentalo prima della prima esecuzione.
Insidie della fatturazione
Il prezzo per token di Carbon è semplice; la fattura no. Diversi meccanismi fanno lievitare il conto e una modifica programmata raddoppia tutte le tariffe.
Il ragionamento viene fatturato come output
I token di ragionamento vengono fatturati come output. La tariffa di output di Carbon è ora di $10 per milione di token e salirà a $20 dal 1 dicembre.
Ogni passaggio della decodifica lunga viene fatturato
L'esempio di Google: un prompt di 1,000 token che genera 200,000 token di output riporta total_input_tokens pari a 397,216, sommando passaggi di 1,000, 66,536, 132,072 e 197,608 token. "You pay for every token in every hop, including hops that contain only thinking." La cache implicita applica uno sconto del 95% alla maggior parte dei token di input, ma i passaggi restano inclusi nell'utilizzo. Anche il lavoro completato viene fatturato se un'esecuzione non riesce o viene annullata: "Completed segments are billed at the end of each segment even if a later segment fails or is cancelled," e "You pay for all work completed before the interaction ends."
Il grounding ha una tariffazione separata
Sul servizio nativo di Google, il grounding con Google Search include 5,000 richieste gratuite al mese, condivise tra Gemini 3 e le versioni successive; poi costa $14 ogni 1,000 richieste, fino a un massimo di 1,500 al giorno. AIHubMix non ha documentato il grounding per Carbon.
La nota su Vertex vale solo per il fornitore
La pagina dei prezzi di Vertex di Google aggiunge una regola: le completion superiori a 32K token vengono addebitate in base all'uso di token recuperabili anche se la richiesta non riesce a causa di un timeout del client o del server; la regola entra in vigore il 13 novembre 2026. Vale per il fornitore; non è stato reso noto se il provider VertexAI di AIHubMix la applica. Chiedi prima di darlo per scontato.
Dal 1 dicembre tutte le tariffe raddoppiano
| Tariffa | Fino al 30 novembre | Dal 1 dicembre |
|---|---|---|
| Input | $2 per 1M | $4 per 1M |
| Output | $10 per 1M | $20 per 1M |
| Lettura dalla cache | $0.10 per 1M | $0.20 per 1M |
Carbon e Argon condividono le tariffe introduttive; il 1 dicembre ogni tariffa raddoppia. Oggi AIHubMix indica le tariffe introduttive e non ha pubblicato i prezzi applicabili dopo dicembre. Considera certo il raddoppio e sconosciuto il prezzo del gateway, e verifica entrambi prima di impegnare un budget.
Agenti con permessi reali
Per le chiamate native di Google, la guida di Carbon consiglia di preferire turni sequenziali di esecuzione degli strumenti. Con questo percorso, esegui una chiamata alla volta. La guida di Gemini di AIHubMix documenta tool_choice="auto", ma il supporto degli strumenti specifico per Carbon e il comportamento degli strumenti forzati sul gateway non sono confermati.
La cronologia non deve terminare con un turno del modello e i turni del modello precompilati non sono supportati. Se manca il risultato di uno strumento, invia un turno utente chiedendo quale sia il passaggio successivo.
La scheda del modello segnala rallentamenti o timeout occasionali e un maggior numero di token ai livelli più alti; la data di aggiornamento delle conoscenze è marzo 2026. Con accesso in scrittura, il vero rischio è un timeout: un'esecuzione che supera il limite del client può lasciare modifiche parziali e i segmenti completati vengono comunque fatturati.
Strumenti di coding: controlla la pagina del modello prima di configurare qualsiasi cosa
La scheda di Carbon su AIHubMix documenta solo Chat Completions e Carbon non è ancora nell'indice pubblico dei modelli. Claude Code richiede Anthropic Messages; Codex richiede Responses. Nessuno dei due è confermato per Carbon su AIHubMix. Non dare per scontato che funzionino: apri la pagina del modello Carbon collegata sopra e controlla l'elenco dei protocolli. Se compare solo Chat Completions, usa un client compatibile con OpenAI oppure attendi.
La struttura della richiesta è la stessa di Argon, ma la disponibilità dei protocolli è diversa: al momento, AIHubMix documenta Carbon solo per Chat Completions. L'articolo su Claude Code tratta ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN e API_TIMEOUT_MS; l'articolo su Codex tratta il blocco del fornitore, wire_api e model_reasoning_effort. Ciò che cambia è la disponibilità del protocollo.
| Client | Protocollo richiesto | Carbon su AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Non documentato |
| Codex | Responses API | Non documentato |
| OpenAI SDK | Chat Completions | Documentato |
Impostazioni:
- ID del modello:
gemini-4-carbon. - Livello di ragionamento: low, medium, high; valore predefinito: medium.
- Mappatura del livello di ragionamento: campo nativo
thinking_level, campo di compatibilitàreasoning_effort; Google mappa i valori del livello di ragionamento, ma AIHubMix non ha pubblicato la mappatura per Carbon. Inviane uno. - Contesto: 1,048,576 secondo Google; AIHubMix non ha pubblicato un limite per Carbon, quindi non basare la configurazione sul dato del fornitore.
- Problemi noti: primo token lento con il livello high, indicazione del fornitore di preferire turni sequenziali per gli strumenti, limite prudenziale non verificato di AIHubMix di 65,536 token di output e data di aggiornamento delle conoscenze di marzo 2026.
Test preliminare, 10–15 minuti:
- Scegli un piccolo repository con un test unitario che non passa e un comando di test che termini in meno di un minuto.
- Imposta il modello su
gemini-4-carbon,max_tokenssu 65,536 o meno e il timeout HTTP ad almeno 15 minuti. - Chiedi allo strumento di apportare la modifica minima necessaria per far passare il test, poi esegui il comando di test e controlla le differenze.
- Esito positivo: la modifica è minima e il test passa in 10–15 minuti. Esito negativo: annota se la risposta era un errore 400, una risposta incompleta, un timeout o una modifica errata; ciascun caso richiede una correzione diversa, descritta sopra.
- Se lo strumento permette di impostare il livello, prova medium e high e mantieni quello che termina entro il tempo previsto.
Checklist prima della prima richiesta in produzione
- ID del modello impostato su
gemini-4-carbon. - Nessun
temperature,top_potop_k. - Nessun
frequency_penaltyopresence_penalty; impostacandidate_countsu 1 oppure omettilo. max_tokensimpostato su 65,536 o meno.- Le richieste in background native di Google inviano
store=truee un valore esplicito permax_output_tokens; AIHubMix non ha documentato questo percorso. - Timeout HTTP di almeno 15 minuti; streaming consigliato.
- Usa uno solo tra
reasoning_effortethinking_level. - Su Google nativo, preferisci i turni sequenziali per gli strumenti; AIHubMix documenta
tool_choice="auto", ma il supporto per Carbon non è confermato. - Nessuna chiamata esplicita alla cache; il prefisso stabile del prompt viene prima.
- Il budget include i token di ragionamento e ogni passaggio di decodifica lunga.
- Tariffe del 1° dicembre verificate con il responsabile del budget.
- Strumento di coding verificato sulla pagina del modello prima della configurazione.
FAQ
È necessario modificare il corpo della richiesta passando da Argon a Carbon?
No. Lo schema è invariato. Modifica l'ID del modello, verifica i valori e rimuovi i campi che ora restituiscono un errore 400.
Perché max_output_tokens restituisce un errore 400?
L'API nativa di Carbon di Google rifiuta i valori superiori a 1,048,576. Il percorso Chat Completions di AIHubMix prevede una raccomandazione prudenziale distinta: mantieni max_tokens pari o inferiore a 65,536 finché non viene documentato un percorso con un limite maggiore. Un valore basso tronca invece il ragionamento, con un risultato peggiore: la risposta può essere incompleta e viene comunque fatturata.
Perché la risposta è vuota?
Se lo stato è incompleto, il testo può essere vuoto perché il modello stava ancora ragionando. Il lavoro viene comunque addebitato. Aumenta il limite e riprova.
Perché una richiesta in background si ferma a 64K?
Nel percorso nativo in background di Google, se non si specifica max_output_tokens, il server si ferma a 64K. Imposta esplicitamente il limite; la decodifica lunga nativa può arrivare fino a 1,048,576 meno l'input. AIHubMix non ha documentato la modalità in background.
temperature viene rispettato?
No. temperature, top_p e top_k vengono ignorati. I valori di penalties e candidate_count superiori a 1 restituiscono invece un errore 400.
Il 1° dicembre Carbon costerà il doppio?
Le tariffe di Google raddoppiano: input da $2 a $4, output da $10 a $20, letture dalla cache da $0.10 a $0.20. AIHubMix non ha pubblicato il prezzo successivo al 1° dicembre, quindi verificalo prima di definire un budget.
È possibile usare Claude Code o Codex con Carbon?
Non è confermato. AIHubMix documenta Chat Completions per Carbon; Claude Code richiede Anthropic Messages e Codex richiede Responses. Controlla prima la pagina del modello.
Continua a leggere: la serie Gemini 4 Carbon
- Se la migrazione è in corso e la domanda è se Carbon valga davvero il suo prezzo, il confronto mette fianco a fianco le tariffe introduttive condivise.
Gemini 4 Carbon vs Argon: stesso prezzo, quando conviene Carbon? - Se stai scegliendo un agente di coding anziché migrare un endpoint, il confronto diretto analizza l'uso degli strumenti e il costo per attività.
Gemini 4 Carbon vs Fable 5.2: quale scegliere per il coding agentico?