Anthropic ha rilasciato Claude Fable 5.2 il 9 novembre 2026. Google ha reso Gemini 4 Carbon disponibile per tutti il giorno successivo. La tabella dei benchmark di lancio pubblicata da Anthropic include una colonna dedicata a Carbon, offrendo così un utile confronto sullo stesso carico di lavoro di coding a lungo orizzonte.
Entrambi i modelli sono proposti per lo stesso compito: il coding agentico a lungo orizzonte. L’agente legge un repository, modifica diversi file, esegue comandi, legge l’output dei test e prosegue per 15–45 minuti senza interventi umani. È questo il compito valutato qui. Chat, completamento automatico e script brevi sono test diversi.
La risposta breve
Fable 5.2 è in testa nei benchmark di coding impegnativi elencati ed è più veloce a parità di impegno, conquistando i primi tre posti AA davanti a Carbon High, al #4. Carbon ottiene risultati migliori nelle righe elencate di Terminal-Bench 4.0 e AutomationBench-AA e costa meno per attività a impegno High fino alla scadenza del prezzo promozionale di Google, il 30 novembre. A Medium, Fable costa meno ed è molto più veloce, mentre Carbon ottiene un punteggio più alto nell’indice AA.
Scegli Fable per il ragionamento su codice complesso, Carbon per l’esecuzione da terminale e l’automazione; prima di scegliere uno dei due, verifica i limiti di input, conservazione dei dati e output.
Cosa mostra un unico harness
Artificial Analysis testa ogni modello con lo stesso harness e gli stessi task; le pagine di Carbon e Fable riportano i risultati per ciascuna valutazione. I dati provengono dallo snapshot dell’11 novembre 2026; AA usa i prezzi standard di listino, non lo sconto introduttivo di Google.
| Modello | Indice AA | $/attività | Min/attività | Primo token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Nota: indice di intelligenza AA e costo per attività ai prezzi standard, snapshot 2026-11-11T05:23Z. Fable Max, Xhigh e High si classificano dal #1 al #3; Carbon High è #4; Opus 5.5 Max è #5; Carbon Medium è #6. Primo token indica il tempo necessario per ottenere il primo token della risposta.
Con impegno High, Fable è avanti di 1.79 punti, costa il 17.0% in più per attività ($9.08 contro $7.76), termina in 17.3 minuti invece che in 25.6 e restituisce il primo token in 30.4 secondi invece che in 67.1. Max costa $26.54 per attività, 3.4 volte Carbon High, e impiega 233.9 secondi.
A Medium l’ordine si inverte: Fable ottiene 56.41 contro i 58.26 di Carbon, 1.85 punti in meno, ma costa $3.80 contro $6.59 e impiega 7.8 minuti contro 23.3. In questo caso, il prezzo più basso per token di Carbon non lo rende meno costoso per attività: usa più token.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| % senza allucinazioni | 88.58 | 42.02 | 40.73 | 49.66 |
| Accuratezza % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Nota: Artificial Analysis, stesso harness e stesso snapshot. La percentuale senza allucinazioni è la quota di risposte Omniscience prive di affermazioni inventate; l’accuratezza è un punteggio distinto. Valori più alti sono migliori in tutte le righe. Fable Xhigh è omesso per mantenere leggibile la tabella; il suo punteggio FrontierCode 2.0 è 47.58.
Quale modello è in testa in ciascun test con impegno High? Il divario con segno qui sotto sottrae Fable da Carbon: rende visibile la direzione del confronto, mentre la tabella sopra riporta i punteggi assoluti.
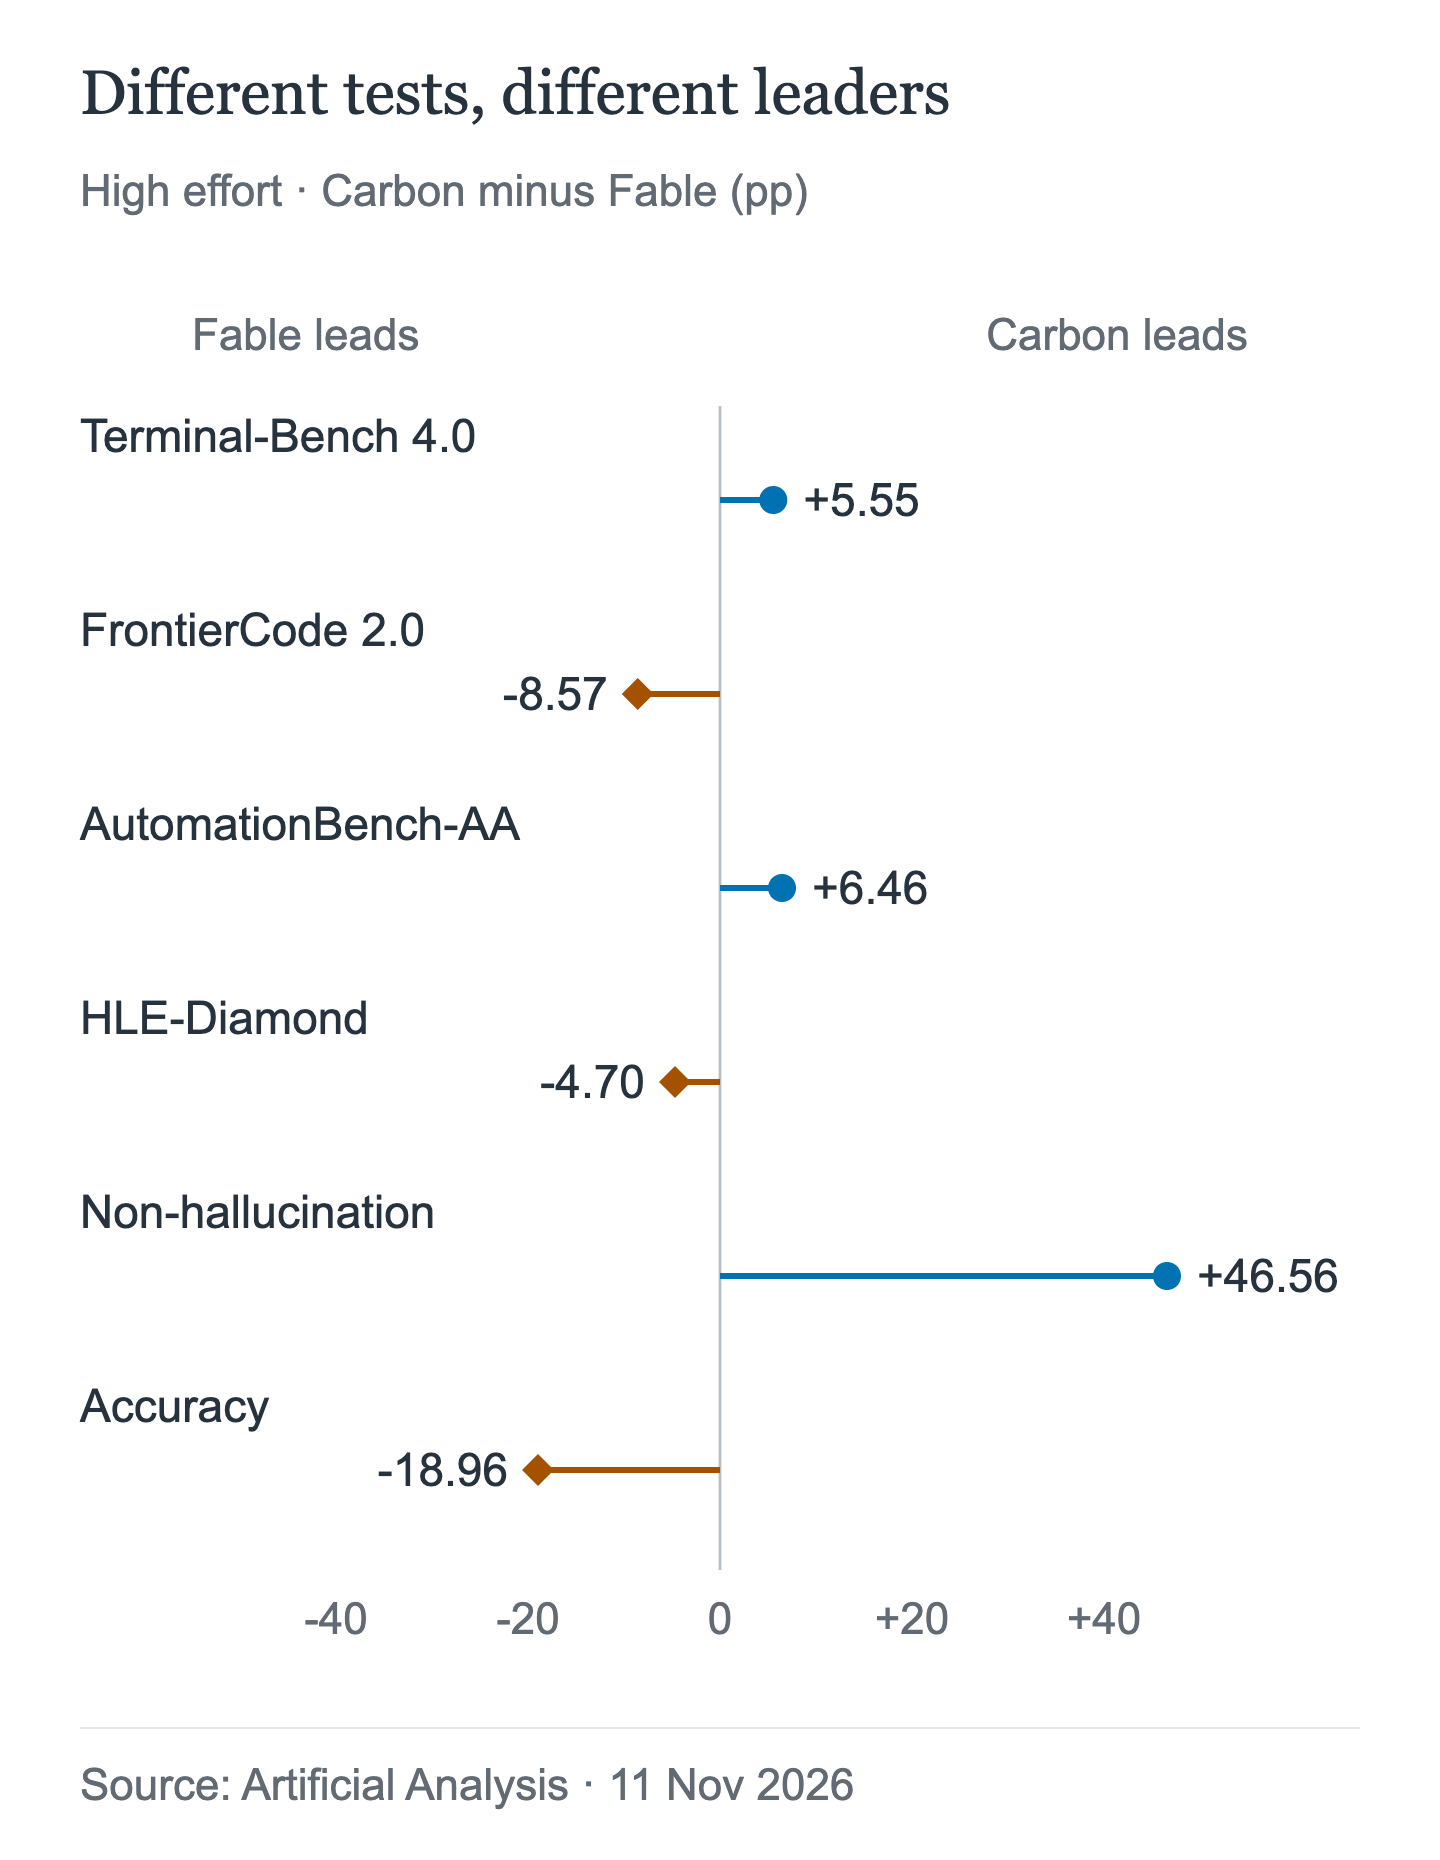
Si tratta di differenze in punti percentuali tra test indipendenti, non di un punteggio complessivo di qualità. Un divario maggiore in un benchmark non implica un miglioramento generale più ampio delle capacità. In particolare, la percentuale senza allucinazioni e l’accuratezza misurano risultati diversi.
Con impegno High, Fable supera Carbon di 8.57 punti in FrontierCode 2.0 e di 4.7 in HLE-Diamond; Briefcase Elo è 1677.4 contro 1610.6. FrontierCode è il benchmark più vicino alle modifiche complesse del codice distribuite su più file. Carbon supera Fable di 5.55 punti in Terminal-Bench 4.0 e di 6.46 in AutomationBench, che premiano l’esecuzione da riga di comando, il recupero dagli errori e l’automazione.
Il divario nella percentuale senza allucinazioni è il più ampio della tabella: 88.58% per Carbon contro 42.02% per Fable con impegno High. L’accuratezza va nella direzione opposta: 58.27% contro 77.23%. Carbon ha meno probabilità di inventare informazioni, ma anche meno probabilità di rispondere correttamente. Per un agente che non deve inventarsi un’API, questo può essere un vantaggio; per uno che deve fornire la risposta corretta, l’accuratezza di Fable è un indicatore migliore.
Un impegno maggiore non è sempre meglio: il punteggio di Fable Max in FrontierCode, 48.76, è leggermente inferiore a quello di High, 49.13, mentre Terminal-Bench resta a 59.6.
La tabella di Anthropic
La pagina di lancio di Anthropic pubblica una tabella comparativa tra fornitori che include Carbon. Le impostazioni differiscono da quelle di AA: Fable è eseguito a Xhigh, il livello di impegno più alto riportato, e Carbon a Medium. Leggi questa tabella solo come confronto al suo interno.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Nota: dati dichiarati da Anthropic. Fable a Xhigh, il massimo livello di impegno disponibile; Carbon a Medium. La scala di AutomationBench di Anthropic differisce da quella di AA (51.4/53.9 contro 71.36/77.82), quindi confronta i valori all’interno di questa tabella. Il 41.1 di Carbon in FrontierCode è ottenuto a Medium; il 40.56 di AA è a High, con un harness diverso.
La tendenza coincide con quella di AA: Fable è in testa in FrontierCode, FrontierSWE, OSWorld e TB-Science; Carbon supera Fable di 2.5 punti in AutomationBench, un margine inferiore ai 6.5 di AA ma nella stessa direzione. La tabella supporta l’affermazione «Carbon è competitivo nell’automazione», non «Carbon è il modello migliore per il coding complesso».
La raccomandazione di Anthropic stessa complica l’affermazione «Fable è l’aggiornamento migliore»: «Per la maggior parte delle attività di coding e di conoscenza, consigliamo agli utenti di iniziare con Claude Opus 5.5». Anthropic afferma che, con impegno High, Fable ottiene risultati pressoché uguali ai migliori di Opus 5.5 (45.3% contro 45.5%) a circa metà del costo per attività.
Quanto costano i token
| Modello | Input | Output | Lettura dalla cache |
|---|---|---|---|
| Carbon, fino al 30 novembre | $2 | $10 | $0.10 |
| Carbon, dal 1° dicembre | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Nota: USD per 1M di token, prezzi ufficiali. Scritture nella cache di Fable: $10 (5 min) o $16 (1 ora); Batch con uno sconto del 50%. Il dato di Carbon per la cache è il prezzo di lettura; il prezzo ufficiale di lettura dalla cache di Opus 5.5 è $0.20.
Il prezzo per token di Fable è il doppio della tariffa standard di Carbon e il quadruplo di quella introduttiva. Il rapporto è semplice, il costo per attività no. AA ha misurato $7.76 per Carbon High a $4/$20, contro $9.08 per Fable High, con una differenza del 17.0%. Alla tariffa di Google di $2/$10, lo stesso utilizzo costa circa $3.88, secondo una stima calcolata. Fino al 30 novembre, Fable High costa circa 2.3 volte tanto per attività; dal 1° dicembre la differenza torna al 17.0%.
Ai prezzi standard, Fable Medium costa $3.80 contro i $6.59 di Carbon, il 42% in meno nonostante un prezzo per token doppio. Carbon impiega 23.3 minuti e usa più token; Fable ne impiega 7.8. Con la tariffa introduttiva, Carbon Medium costa circa $3.30, calcolando la stima allo stesso modo, una cifra vicina a quella di Fable; questo vantaggio scompare il 1° dicembre.
Max costa 3.4 volte tanto per attività rispetto a Carbon High ($26.54) e impiega 45.2 minuti. Spendere di più non significa ottenere un agente di coding uniformemente migliore: il punteggio di Max in FrontierCode è leggermente inferiore a quello di High.
AIHubMix propone Carbon al prezzo introduttivo di Google. I prezzi di Fable riportati qui sono le tariffe ufficiali di Anthropic.
Differenze di comportamento che determinano la scelta in produzione
| Aspetto | Carbon | Fable 5.2 |
|---|---|---|
| Output massimo | 65,536; fino a 1,048,576−input in modalità nativa* | 128,000 |
| Contesto | 1,048,576 (nativo Google) | 1M |
| Ragionamento | low / medium / high; predefinito medium | adattivo; predefinito high |
| Strumenti forzati | auto documentato* | any / lo strumento restituisce 400 |
| Campionamento | ignorato; rimuovere | alcuni valori restituiscono 400 |
| Conservazione dei dati | non indicata come limite | 30 giorni; nessuna ZDR |
| Input | testo su AIHubMix | testo, immagini, PDF† |
| Data limite | marzo 2026 | giugno 2026 |
Nota: *I limiti superiori di Carbon si riferiscono alle funzionalità native di Google per la decodifica prolungata; AIHubMix documenta al momento solo l’input testuale e Chat Completions, quindi il supporto del gateway non è confermato. †Le modalità di input di Fable sono indicate nell’indice dei modelli di AIHubMix. *AIHubMix documenta tool_choice="auto", ma il supporto specifico per Carbon non è confermato. Il limite di output documentato per Fable è 128,000. ZDR significa conservazione zero dei dati.
L’uso forzato degli strumenti è un impedimento insormontabile per Fable: «L’uso forzato degli strumenti (i tipi any e tool di tool_choice) restituisce un errore 400». Un agente che deve chiamare uno strumento specifico a ogni turno non può usare Fable senza modifiche. La guida di Google su Carbon consiglia turni di esecuzione degli strumenti in sequenza; la guida di Gemini di AIHubMix documenta tool_choice="auto", ma il supporto degli strumenti specifico per Carbon sul gateway resta da confermare.
La conservazione dei dati rappresenta un impedimento legato alle policy per Fable: la sua panoramica afferma che «richiede la conservazione dei dati per 30 giorni e non è disponibile con la conservazione zero dei dati, salvo autorizzazione esplicita di Anthropic». Per come viene descritta qui, la documentazione di Carbon non indica un vincolo simile; ciò non costituisce una garanzia. I team soggetti a regolamentazione dovrebbero verificare entrambe le policy prima della messa in produzione.
Il limite standard di 65,536 token di Carbon copre la maggior parte delle modifiche, ma la generazione di file interi può raggiungerlo. La modalità in background nativa di Google può arrivare fino a 1,048,576 meno l’input, fattura i passaggi tra segmenti e può restituire incomplete con testo vuoto, addebitando comunque il costo. AIHubMix non ha documentato questo flusso. I 128,000 token di Fable arrivano in un’unica risposta.
Nessuno dei due modelli consente di disattivare il ragionamento. Carbon offre i livelli low, medium e high, usa medium come predefinito e ignora i parametri di campionamento. Il «ragionamento adattivo è sempre attivo e non può essere disattivato» di Fable è impostato su high per impostazione predefinita; alcuni valori di campionamento restituiscono 400.
Prima della disponibilità generale, Google ha reso Carbon disponibile ai difensori tramite il suo programma Fairwind. I classificatori di Fable bloccano le richieste relative a penetration test e exploit e rimandano ad altri modelli le attività di cybersecurity e biologia. Nei test di sicurezza, il comportamento di rifiuto conta più di una riga di benchmark.
Opus 5.5 come termine di paragone
Opus 5.5 non è un concorrente, ma è il modello di riferimento di Anthropic. A $4/$20 ottiene 59.11 in AA, costa $10.04 per attività, impiega 25.0 minuti e attende 356.4 secondi per il primo token, il tempo più lungo della tabella (la riga AA è a impegno Max; l’impostazione predefinita è medium). È in testa in Briefcase Elo con 1800.6, ma resta indietro rispetto a Fable High in FrontierCode e a Carbon High in Terminal-Bench. Anthropic continua comunque a raccomandare Opus 5.5 come punto di partenza per la maggior parte delle attività di coding.
Chi dovrebbe scegliere quale
Scegli Fable 5.2 quando prevalgono le modifiche complesse al codice e vuoi i migliori risultati misurati in FrontierCode e HLE. A Medium costa meno ed è più veloce: $3.80 e 7.8 minuti contro i $6.59 e 23.3 minuti di Carbon, mentre Carbon ottiene un punteggio più alto nell’indice AA. Sceglilo se ti serve l’input di immagini, una data limite a giugno 2026, oppure se puoi accettare la conservazione dei dati per 30 giorni e l’impossibilità di forzare le chiamate agli strumenti.
Scegli Carbon quando prevalgono le attività da terminale: cicli di test e correzione, automazione shell, operazioni in più passaggi. Ottiene punteggi più alti nelle righe riportate di Terminal-Bench 4.0 e AutomationBench-AA ed è più economico con il livello High fino al 30 novembre. Il contesto nativo di Google e i limiti di output lungo non sono confermati tramite AIHubMix; implementalo solo con testo e tool_choice="auto", dopo aver verificato il supporto di Carbon agli strumenti. Il suo punteggio di non-allucinazione è più alto, mentre la sua accuratezza è inferiore.
Scegli Opus 5.5 se vuoi partire dal modello consigliato da Anthropic e avere un profilo equilibrato; accetta il primo token lento con il livello Max.
Non scegliere nessuno dei due per la latenza nelle interazioni: con il livello High il primo token arriva dopo 30.4 secondi su Fable e 67.1 su Carbon, mentre i 23.2 di Carbon Medium sono comunque lontani dalla velocità di una chat.
Usa entrambi tramite AIHubMix
AIHubMix offre entrambi i modelli con una sola chiave e un endpoint condiviso per il completamento delle chat. L'ID di Carbon è gemini-4-carbon; la pagina del modello documenta il completamento delle chat, l'input di testo e il prezzo introduttivo di Google. L'ID di Fable 5.2 è claude-fable-5-2; AIHubMix elenca Chat Completions, Responses e Anthropic Messages, con una finestra di contesto da 1M e un output massimo di 128K. La superficie documentata di Carbon è più limitata: completamento delle chat, non l'API Gemini nativa. Il gateway riprova anche con il fornitore successivo migliore, quindi il comportamento può differire da un'implementazione con un solo fornitore.
La guida rapida illustra l'autenticazione e l'URL di base. Un test di verifica può controllare se entrambi gli ID vengono risolti con la stessa chiave; per questa bozza non è stato eseguito alcun test dal vivo:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Questo verifica l'instradamento, non le capacità: non ci sono strumenti né output lunghi. Per un confronto reale, esegui la stessa traccia dell'agente con entrambi gli ID e registra la durata delle attività, l'uso dei token e gli errori. La pagina di confronto affianca contesto, protocolli e prezzi.
FAQ
Gemini 4 Carbon è migliore di Fable 5.2 per la programmazione agentica?
Nessuno dei due prevale in ogni aspetto del lavoro. Fable 5.2 è in testa a FrontierCode 2.0 e all'indice complessivo con il livello High; Carbon prevale in Terminal-Bench 4.0 e AutomationBench. Scegli in base ai carichi di lavoro effettivi dell'agente.
Perché Fable 5.2 costa quattro volte più di Carbon?
Alle tariffe ufficiali, Fable costa $8/$40 per milione di token, contro il prezzo introduttivo di Carbon di $2/$10: quattro volte tanto sia per l'input sia per l'output. Rispetto alla tariffa standard di Carbon, $4/$20 dal 1° dicembre, costa il doppio.
Fable 5.2 costa davvero meno per attività con il livello Medium?
Ai prezzi standard, sì: $3.80 contro $6.59 con Carbon Medium, e 7.8 minuti contro 23.3. Il prezzo introduttivo dei token di Carbon riduce il divario; il confronto ai prezzi standard è quello più duraturo.
Fable 5.2 può forzare una chiamata allo strumento?
No. Anthropic documenta che i valori any e tool di tool_choice restituiscono un errore 400. Gli agenti che richiedono una chiamata forzata hanno bisogno di un ciclo diverso o di un altro modello.
È meno probabile che Carbon abbia allucinazioni rispetto a Fable 5.2?
Secondo la misura di non-allucinazione Omniscience di AA, sì: 88.58% contro 42.02% con il livello High. La sua accuratezza è inferiore, 58.27% contro 77.23%, quindi è anche meno probabile che fornisca la risposta giusta.
È possibile usare entrambi i modelli tramite AIHubMix con una sola chiave?
Sì. Usa gemini-4-carbon e claude-fable-5-2 con la stessa chiave e lo stesso URL di base. AIHubMix documenta il completamento delle chat per Carbon e Chat Completions, Responses e Messages per Fable.
Continua a leggere: la serie Gemini 4 Carbon
- Prima di scegliere un concorrente, chiarisci la questione tra modelli affini: Gemini 4 Carbon vs Argon: stesso prezzo, quando conviene Carbon?
- Una volta inserito Carbon nel ciclo, i primi errori 400 e i timeout sono di solito dovuti alla configurazione, non al modello: Migrazione API di Gemini 4 Carbon: errori 400, timeout e limiti di output
Fonti
- Gemini 4 Carbon è ora disponibile — Google, 10 novembre 2026.
- Claude Fable 5.2 — Anthropic, 9 novembre 2026.
- Panoramica di Claude Fable 5.2 — documentazione Anthropic.
- Gemini 4 Carbon e Claude Fable 5.2 — Artificial Analysis, fotografia aggiornata all'11 novembre 2026.
- Gemini 4 Carbon su AIHubMix — pagina del modello e prezzi.