
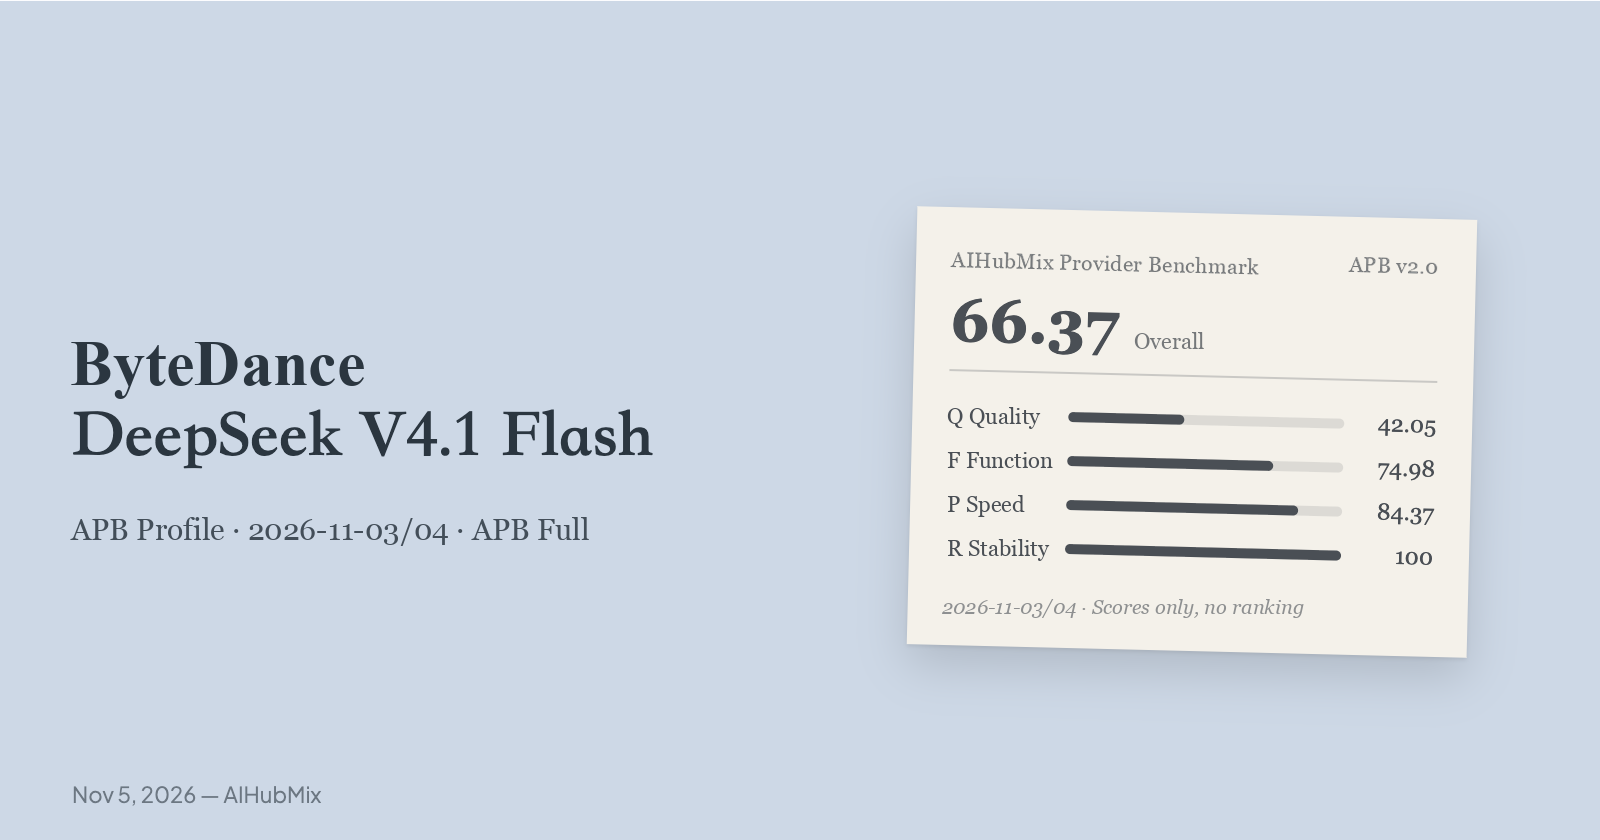
Il 2026-11-03/04, DeepSeek V4.1 Flash 1017 è stato testato su cinque provider tramite AIHubMix con la suite APB Full: ogni volta, le stesse domande, gli stessi parametri e gli stessi script di richiesta. Questo profilo APB riguarda solo l'esecuzione su ByteDance, sezione per sezione.
I numeri riportati sotto sono punteggi, non una classifica né una raccomandazione di provider. Q, F, P, K e R vengono presentati per primi; il punteggio complessivo è un indice riepilogativo, non una certificazione, e non ha un intervallo di confidenza. Le regole di punteggio sono definite in AIHubMix Provider Benchmark Standard v2.0.
Punteggi dei cinque provider
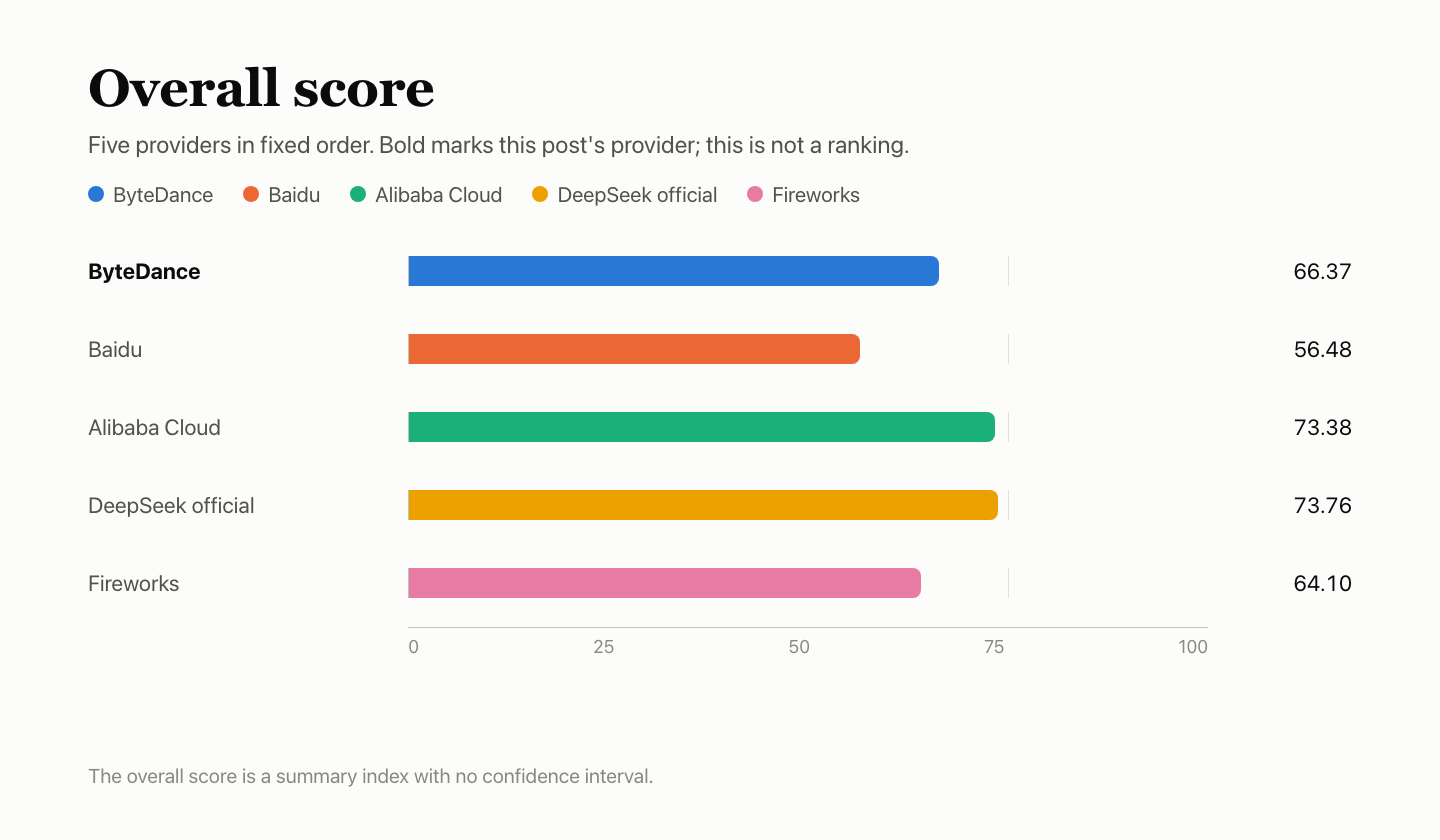
Il grassetto indica il provider di questo articolo. L'ordine dei provider è fisso e non costituisce una classifica. K è un sottopunteggio di P e ne rappresenta il 20%. Il punteggio complessivo è un indice riepilogativo senza intervallo di confidenza. DeepSeek official channel e Alibaba Cloud differiscono di 0.37 e non sono distinguibili.
In breve
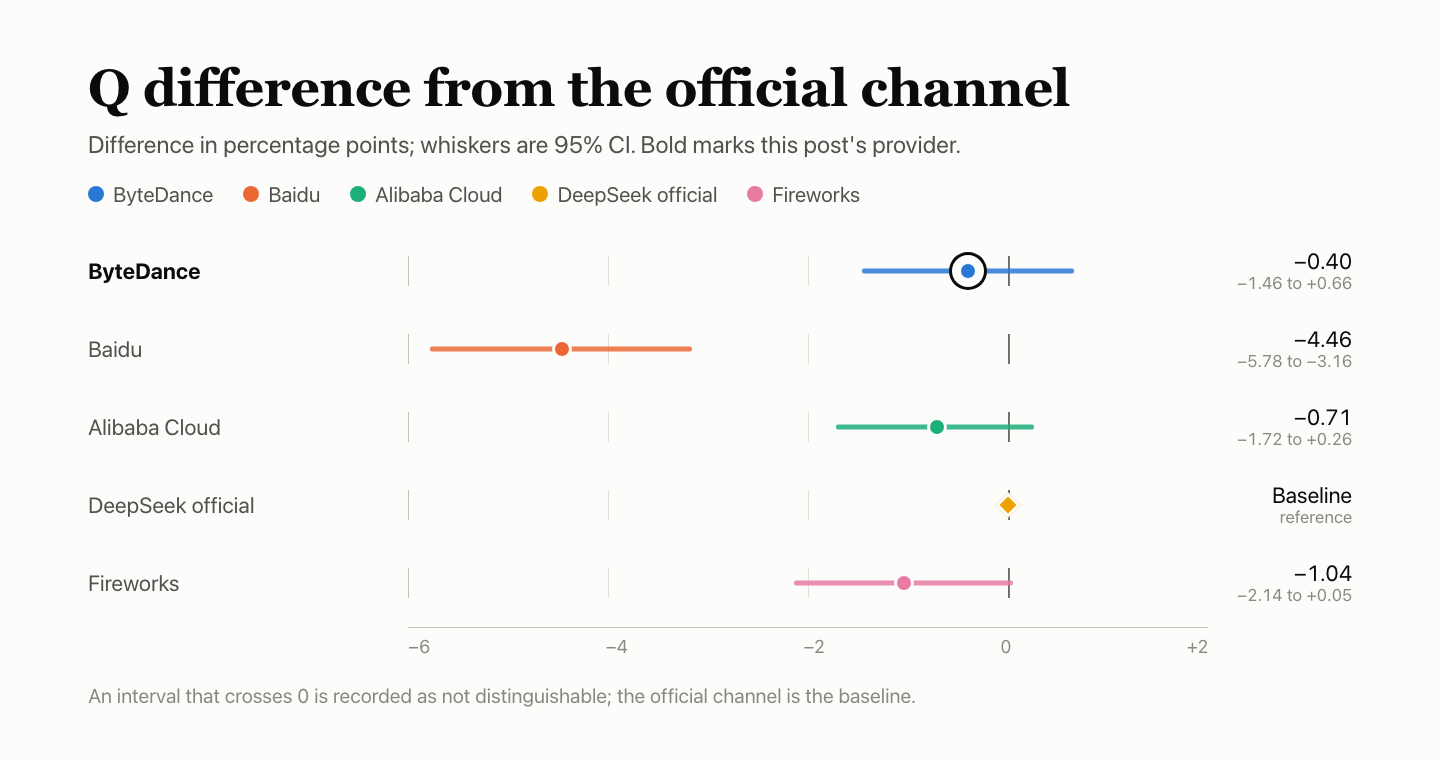
- Q 42.05. BFCL 85.20%, HLE 15.34%, AA-LCR 49.20%. Lo scarto rispetto al canale ufficiale è di −0.40 punti percentuali, con un intervallo al 95% compreso tra −1.46 e +0.66: non sono distinguibili. AA-LCR ha registrato 28 errori di richiesta, tutti nella finestra 1, conteggiati come risposte errate.
- F 74.98. Superati 124 dei 174 controlli conteggiati.
reasoning_effort=nonenon disattiva il ragionamento. Un input di 10k token è stato riportato come 10,026 token (conteggio nativo 10,000); un input di 8 token è stato riportato come 34. - P 84.37. Primo token del corpo: mediana di 2.12 s con concorrenza singola e di 2.10 s con concorrenza 10; TPOT 3.43 ms/token; tutte le 180 richieste di velocità erano valide.
- K 93.83. Le richieste hot da 8k hanno ottenuto un cache hit in 9 casi su 9; quelle da 32k, 8 volte, mentre una richiesta non è terminata entro la scadenza di 300 s.
- R 100. Tutte le 300 richieste dedicate sono riuscite al primo tentativo.
Configurazione del test
| Voce | Dettaglio |
|---|---|
| Modello | DeepSeek V4.1 Flash 1017 |
| ID modello richiesto | doubao-deepseek-v4.1-flash-1017 |
| Nome modello restituito | deepseek-v4-1-flash-261017 |
| Percorso di accesso | Tramite AIHubMix con un ID modello specifico del provider, non una connessione diretta all'account del provider |
| Parametri | Modalità senza ragionamento, temperature 1.0, max_tokens 16,384, timeout 300 s, nessun nuovo tentativo automatico |
| Ragionamento disattivato | Le richieste per qualità delle risposte, velocità, cache e stabilità usavano il valore nativo thinking.type=disabled (per questo provider, reasoning_effort=none non disattivava il ragionamento); i casi sulle funzioni mantenevano reasoning_effort=none per verificare se il parametro avesse effetto |
| Orario | 2026-11-03 18:07 – 11-04 16:33 UTC+8; i cinque provider condividevano un Mac mini, una rete e un account |
| Campioni | Qualità delle risposte: 4,250 istanze di domande (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); funzioni: 60 casi × 3 finestre; velocità: 90 con concorrenza singola e 90 con concorrenza 10; stabilità: 300; cache: 30 (tre gruppi ciascuno con prefissi da 8k e 32k) |
Le richieste hanno usato il percorso guida rapida di AIHubMix con un ID specifico del provider; i parametri seguono la documentazione API di DeepSeek. Gli ID degli altri provider sono elencati nella pagina dei modelli.
Q — qualità delle risposte: 42.05
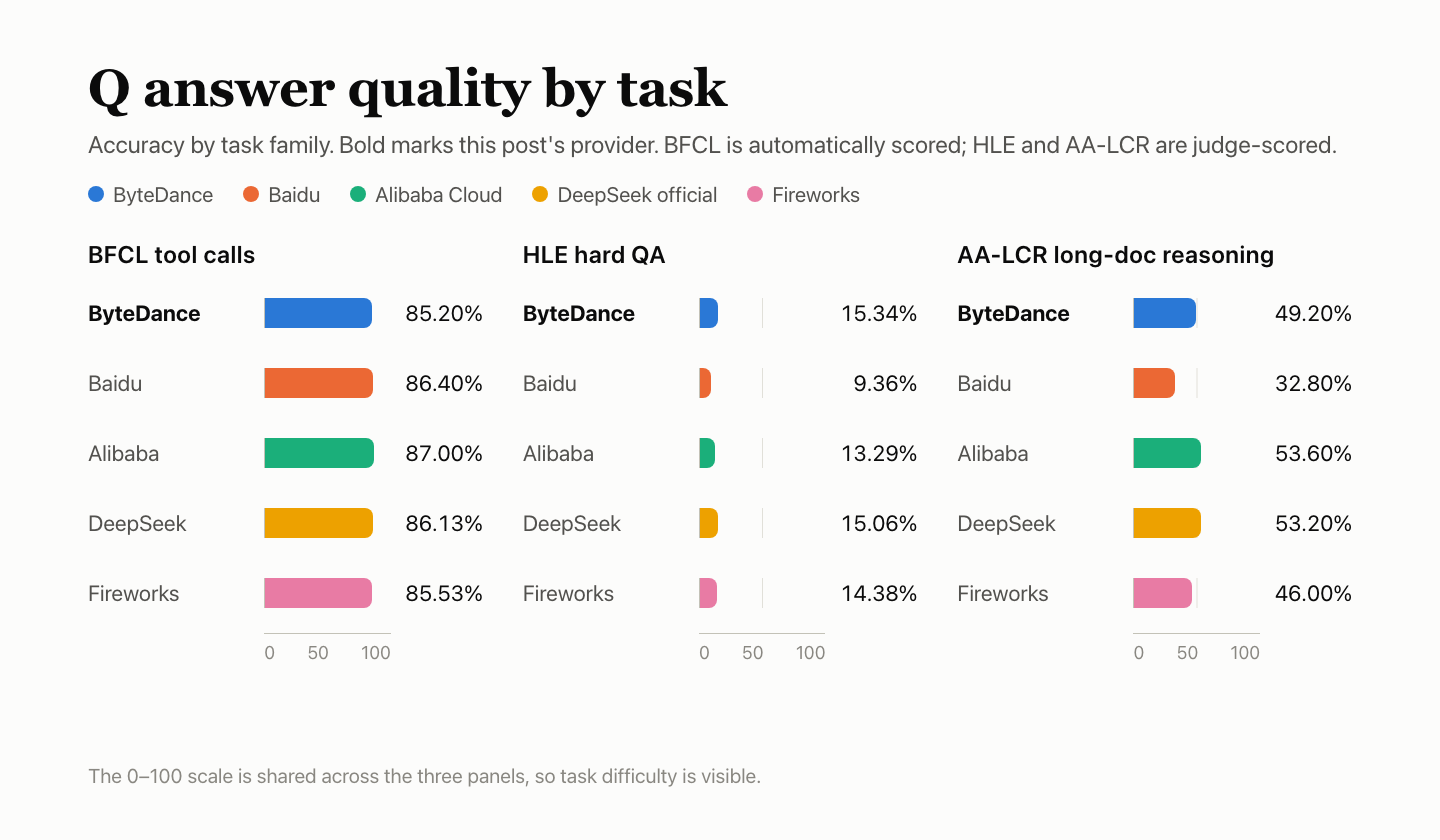
La qualità delle risposte si basa su tre suite: 500 domande BFCL con 3 round ciascuna, 250 domande HLE con 10 round ciascuna e 25 domande AA-LCR con 10 round ciascuna. BFCL è valutato con regole automatiche; HLE e AA-LCR sono valutati dal modello deepseek-flash. Tutti e cinque i provider hanno ricevuto le stesse domande e i risultati delle tre suite sono aggregati in un'unica accuratezza. Dieci risposte sono state rimosse perché non era possibile valutare la domanda, lasciando 4,240 istanze di domande valutate.
| Suite | Domande | Corrette | Accuratezza | Errori |
|---|---|---|---|---|
| Chiamate agli strumenti BFCL | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| Domande e risposte difficili HLE | 250 × 10 | 382/2,490 | 15.34% | 7 |
| Ragionamento su documenti lunghi AA-LCR | 25 × 10 | 123/250 | 49.20% | 28 |
| Complessivo · intervallo al 95% 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Gli errori di servizio — richieste non riuscite o output troncato — restano al denominatore e sono conteggiati come risposte errate. L'output HLE ha raggiunto il limite max_tokens 7 volte; AA-LCR ha registrato 28 errori di richiesta, tutti nella finestra 1. BFCL è valutato automaticamente; HLE e AA-LCR sono valutati da un modello giudice.
Ogni domanda BFCL ha ricevuto 3 risposte; la tabella somma i risultati dei 3 round.
| Categoria BFCL | Superati | Tasso di superamento |
|---|---|---|
| simple_python — una funzione, chiamata e argomenti corretti | 329/360 | 91.39% |
| multiple — scegliere una tra più funzioni | 268/300 | 89.33% |
| parallel — chiamare più volte la stessa funzione | 271/300 | 90.33% |
| parallel_multiple — chiamare più funzioni diverse | 207/240 | 86.25% |
| irrelevance — nessuna funzione è pertinente, non va effettuata alcuna chiamata | 102/150 | 68.00% |
| ahm_multi_turn — catena di strumenti in tre fasi | 101/150 | 67.33% |
Confronto con gli altri quattro
Differenza rispetto al canale ufficiale in punti percentuali, con l'intervallo al 95% indicato dalle barre. Se l'intervallo comprende 0, il risultato è classificato come non distinguibile. Il modello giudice di HLE e AA-LCR, deepseek-flash, appartiene alla stessa famiglia DeepSeek del modello testato e non è stato calibrato, quindi potrebbe esprimere giudizi indulgenti.
F — supporto alle funzioni: 74.98
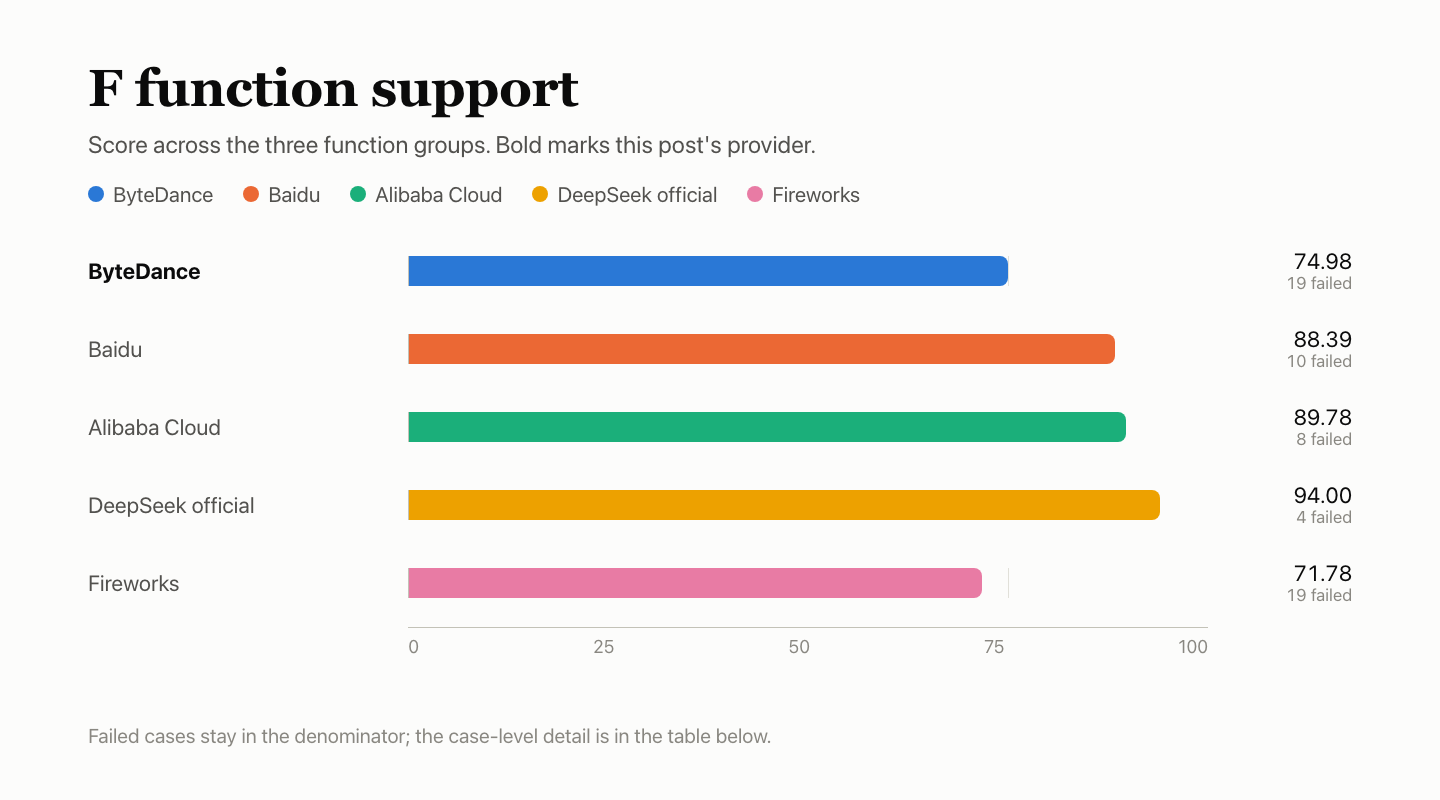
La suite delle funzioni verifica solo se il comportamento dell'interfaccia corrisponde al protocollo, non se il modello risponde bene. Sessanta casi in sei gruppi sono stati eseguiti tre volte, una per ogni finestra: 180 controlli, valutati in base al formato documentato da ciascun provider. I controlli non applicabili, non validi o non osservati sono esclusi dal denominatore. ByteDance ha superato 124 dei 174 controlli conteggiati e ottenuto 74.98 in base ai pesi dei gruppi.
Il punteggio ponderato applica i pesi dei gruppi; non equivale ai controlli superati divisi per 174.
| Gruppo | Peso | Superati | Esclusi | Punteggio del gruppo |
|---|---|---|---|---|
| Protocollo di streaming e messaggi | 20% | 23/27 | 3 | 85.19 |
| Interfaccia degli strumenti | 20% | 30/30 | — | 100.00 |
| Vincoli e parametri di output | 20% | 24/30 | — | 80.00 |
| Contesto e stato | 15% | 14/30 | — | 46.67 |
| Errori e recupero | 15% | 21/30 | — | 70.00 |
| Protocollo di contabilizzazione e cache | 10% | 12/27 | 3 | 44.44 |
| Totale · punteggio ponderato | — | 124/174 | 6 | 74.98 |
«Finestre non superate» indica quante delle 3 finestre non hanno superato il controllo.
| Caso non superato | Finestre non superate | Motivo |
|---|---|---|
| Il ragionamento non trapela nei contenuti — protocollo di streaming e messaggi | 3/3 | Con reasoning_effort=none, il contenuto del ragionamento veniva comunque restituito |
| La configurazione del ragionamento ha effetto — vincoli e parametri di output | 3/3 | Con reasoning_effort=none, il contenuto del ragionamento veniva comunque restituito |
| Diversità di campionamento — vincoli e parametri di output | 3/3 | Gli output con temperature 0 e 1 non erano abbastanza diversi; non raggiungevano la soglia preregistrata |
| Input lungo da 10k — contesto e stato | 3/3 | Input riportato: 10,026 token; il conteggio nativo dovrebbe essere 10,000 |
| Entro il limite di contesto — contesto e stato | 3/3 | Input riportato: 10,026 token; il conteggio nativo dovrebbe essere 10,000 |
| Input lungo da 32k — contesto e stato | 3/3 | Input riportato: 10,026 token; il conteggio nativo dovrebbe essere 10,000 |
| Input lungo da 100k — contesto e stato | 3/3 | Input riportato: 10,026 token; il conteggio nativo dovrebbe essere 10,000 |
| Oltre il limite di contesto — contesto e stato | 3/3 | Errore di connessione upstream o timeout (1); avrebbe dovuto restituire un errore di parametro, ma ha restituito 200 (2) |
| Cronologia di 12 turni — contesto e stato | 1/3 | Errore di connessione upstream o timeout |
| Errore di formato messages — errori e recupero | 3/3 | Restituito 400 con corpo vuoto; nessuna spiegazione strutturata dell'errore |
| Risultato di uno strumento orfano — errori e recupero | 3/3 | Avrebbe dovuto restituire un errore di parametro, ma ha restituito 200 |
| Errore di formato stream_options — errori e recupero | 3/3 | Restituito 400 con corpo vuoto; nessuna spiegazione strutturata dell'errore |
| Contabilizzazione dei token di ragionamento — protocollo di contabilizzazione e cache | 3/3 | Token di ragionamento riportati dopo la disattivazione del ragionamento |
| Conteggio nativo dell'input — protocollo di contabilizzazione e cache | 3/3 | Riportati 34 token; il conteggio nativo dovrebbe essere 8 |
| Definizioni degli strumenti conteggiate nell'input — protocollo di contabilizzazione e cache | 3/3 | La richiesta di controllo senza strumenti era già in disaccordo con il conteggio nativo dell'input |
| Conteggio dell'input coerente prima e dopo la cache — protocollo di contabilizzazione e cache | 3/3 | Ripetendo lo stesso prefisso, i token di input riportati non corrispondevano al conteggio nativo |
| Input coerente in streaming e non in streaming — protocollo di contabilizzazione e cache | 3/3 | Entrambi riportavano 34 token; il conteggio nativo dovrebbe essere 8 |
| Output di testo esatto — protocollo di streaming e messaggi | 1/3 | Un punto aggiuntivo alla fine del corpo; il testo non corrispondeva esattamente a quello richiesto |
Questi controlli sono esclusi dal denominatore; non vengono conteggiati né come superati né come non superati.
| Stato | Caso | Numero | Motivo |
|---|---|---|---|
| Non osservato | Sequenze di arresto dello streaming | 3 | Dopo il passaggio precedente, questa richiesta non è stata inviata; impossibile valutarla |
| Non applicabile | cache_control esplicito | 3 | Registrato in anticipo come non supportato da questa interfaccia |
I casi di errore di formato messages e stream_options non sono stati superati su nessuno dei cinque provider: entrambi hanno restituito 400 con corpo vuoto, quindi i client non ricevono alcuna spiegazione strutturata dell'errore. Un errore comune a tutti e cinque si verifica con maggiore probabilità a livello del gateway AIHubMix e richiede un'indagine separata. Anche la contabilizzazione dei token di ragionamento non è stata superata da nessuno dei cinque, ma per ragioni diverse: ByteDance e Fireworks hanno riportato token di ragionamento dopo averlo disattivato; gli altri tre non hanno restituito un conteggio dei token di ragionamento.
Confronto con gli altri quattro
P — velocità di risposta: 84.37
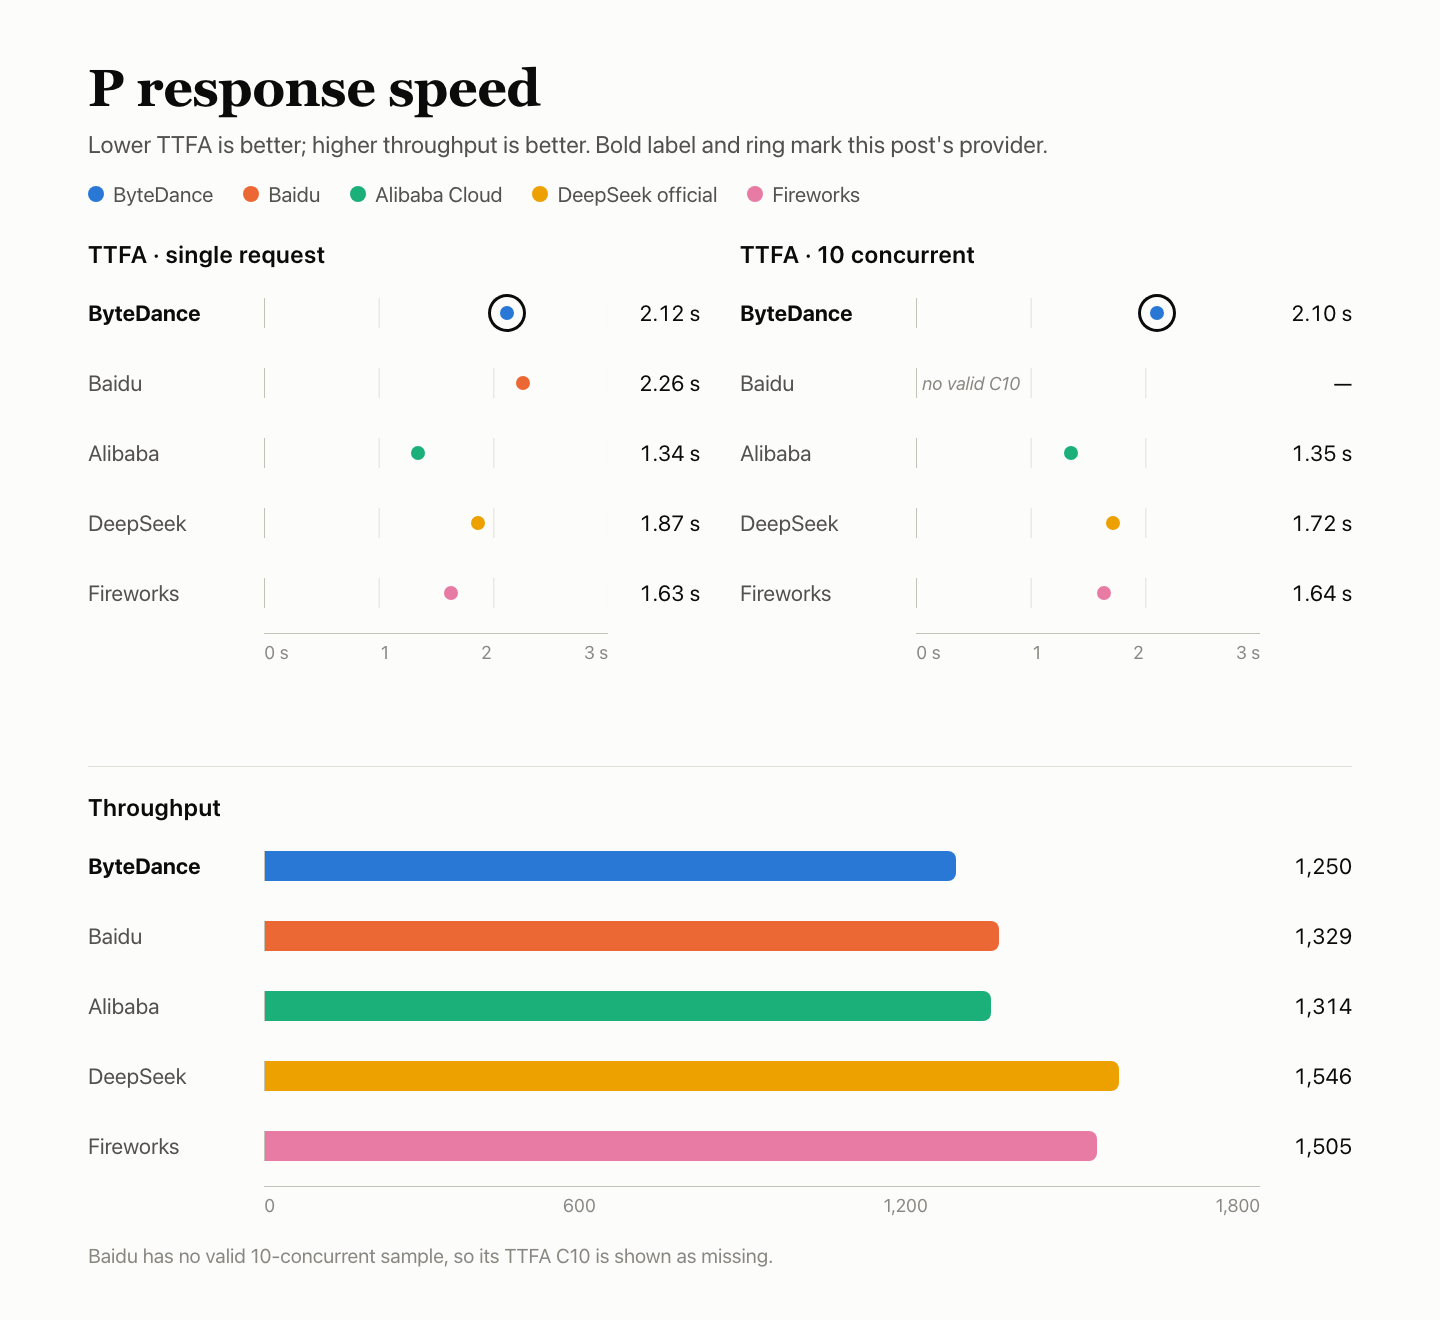
Ogni richiesta conteneva circa 10,000 token di input e chiedeva circa 1,100 token di testo nel corpo dell'output. In ciascuna delle tre finestre sono state eseguite 30 richieste con concorrenza singola e 30 con concorrenza 10: 180 richieste in tutto.
| Metrica | Risultato |
|---|---|
| Attesa per il primo token del corpo (TTFA) | Mediana di 2.12 s con concorrenza singola; mediana di 2.10 s con concorrenza 10 |
| Velocità di generazione (TPOT) | 3.43 ms/token con concorrenza singola; 3.41 ms/token con concorrenza 10 |
| Throughput effettivo | 1,250.0 token/s con concorrenza 10 |
| Richieste valide | 90/90 con concorrenza singola; 90/90 con concorrenza 10 |
| Punteggi delle componenti | TTFA 48.59, TPOT 100.00, throughput 100.00; per TTFA e TPOT si usa il valore più basso tra i due livelli; pesi 35% / 35% / 30%; punteggio di risposta 82.00 |
| Punteggio P | Punteggio di risposta 82.00, ponderato all'80%; cache K 93.83, ponderata al 20%; totale 84.37 |
Il TPOT è stimato dai chunk dello streaming, non misurato per token sull'hardware. Il throughput è calcolato dividendo i token di output validi con concorrenza 10 per il tempo totale della batch.
Confronto con gli altri quattro
Tutti e cinque condividevano una macchina, una rete e un account. Le tre finestre sono state programmate provider per provider, quindi i periodi di raccolta non si sovrappongono del tutto; è meglio non attribuire troppo peso a differenze minime.
K — cache: 93.83
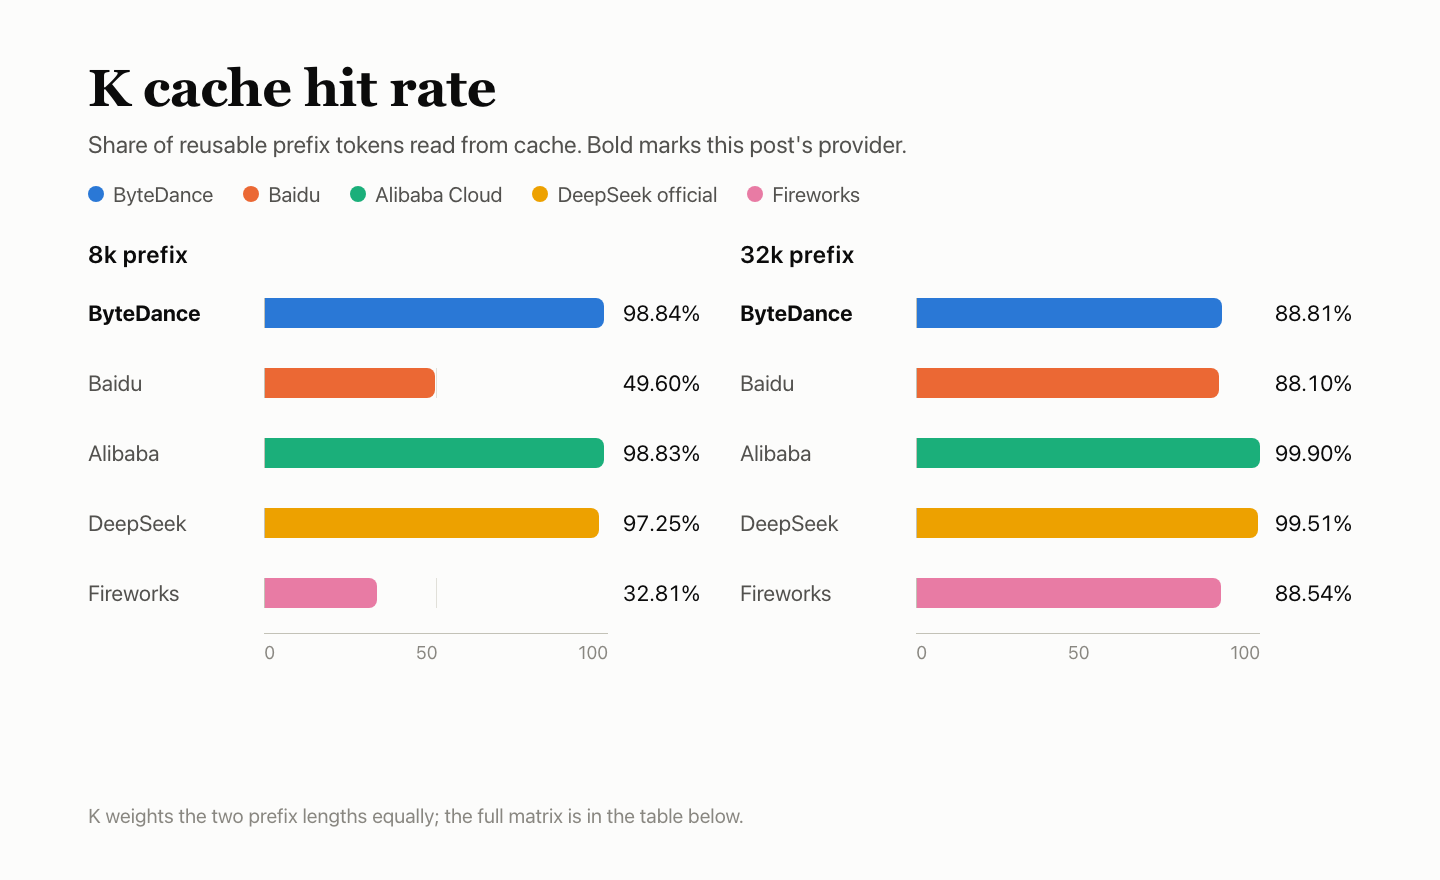
Ogni gruppo invia cinque richieste. La prima include un prefisso fisso di circa 8k o 32k token e inizializza la cache. Le richieste dalla 2 alla 4 mantengono il prefisso e modificano solo la domanda finale, rispettivamente dopo 5 s, 30 s e 120 s. La quinta usa un nuovo prefisso come controllo a freddo. Tre finestre e due lunghezze, con cinque richieste per gruppo, danno 30 richieste. K è il numero di token letti dalla cache nelle richieste hot diviso per i token che dovrebbero essere riutilizzabili secondo le regole, con lo stesso peso per entrambe le lunghezze; K rappresenta il 20% di P.
| Prefisso | Finestra | Inizializzazione | +5 s | +30 s | +120 s | Controllo a freddo |
|---|---|---|---|---|---|---|
| 8k | Finestra 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Finestra 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Finestra 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Finestra 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Finestra 2 | 0 | 32,000 | 32,000 | non riuscita | 0 |
| 32k | Finestra 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
I valori indicano i token letti dalla cache riportati dal server.
Tutte e nove le richieste hot da 8k hanno avuto un cache hit, leggendo ciascuna 7,936 token. Otto delle nove richieste hot da 32k hanno avuto un cache hit, leggendo ciascuna 32,000 token; una richiesta non è riuscita. K è pari a 93.83, con le due lunghezze ponderate in egual misura. Le richieste cold non hanno letto dati dalla cache, quindi quelle hot e cold si separano nettamente. La richiesta non riuscita è la quarta del gruppo da 32k nella finestra 2, che ha raggiunto la scadenza di 300 s senza completarsi.
Confronto con gli altri quattro
R — stabilità del servizio: 100
Le 300 richieste si dividono in quattro tipi — testo breve, input lungo, chiamate allo strumento e cronologia multi-turno — e sono state eseguite con concorrenza singola in tre finestre. Una richiesta viene conteggiata come riuscita solo se il primo tentativo ha restituito una risposta valida e completa; la correttezza della risposta non viene verificata e non sono previsti tentativi aggiuntivi. Gli errori nelle sezioni sulla qualità delle risposte e sulla velocità vengono conteggiati in Q e P, non di nuovo in R.
| Tipo di richiesta | Successo al primo tentativo |
|---|---|
| Testo breve | 120/120 |
| Input lungo da 10k | 90/90 |
| Chiamate allo strumento | 60/60 |
| Cronologia multi-turno | 30/30 |
| Totale · intervallo al 95%: 98.78%–100% | 300/300 |
Tutte le 300 richieste hanno restituito una risposta valida e completa al primo tentativo. R = 100 descrive solo queste 300 richieste dedicate; non significa che l’intera catena non abbia avuto errori. Il limite inferiore dell’intervallo al 95% è 98.78%: 300 successi consentono solo di affermare che il tasso di errore è probabilmente inferiore all’1.22%.
Confronto con gli altri quattro
R riguarda solo queste 300 richieste dedicate; gli errori nelle sezioni sulla qualità delle risposte e sulla velocità sono registrati in Q e P e non vengono conteggiati di nuovo in R.
| Fornitore | Successo al primo tentativo | Intervallo al 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek ufficiale | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
reasoning_effort=none non è riuscito davvero a disattivare il ragionamento?
Sì. In tutte e tre le finestre, le richieste con reasoning_effort=none hanno comunque restituito contenuti di ragionamento, quindi la verifica è fallita in 3 casi su 3. Le richieste per qualità delle risposte, velocità, cache e stabilità hanno invece usato l’interruttore nativo thinking.type=disabled. La suite delle funzioni ha mantenuto intenzionalmente reasoning_effort=none per verificare se il parametro avesse effetto.
La precisione BFCL è dell’85.20%. Perché Q è 42.05?
Q aggrega tre suite con livelli di difficoltà molto diversi. BFCL ha contribuito con 1,278 risposte corrette su 1,500, HLE con 382 su 2,490 e AA-LCR con 123 su 250. In totale, erano corrette 1,783 delle 4,240 istanze valutate: 42.05%. Il 15.34% di HLE abbassa il valore aggregato.
I 35 errori del servizio in Q sono inclusi nel punteggio?
Sì. Gli errori delle richieste e gli output troncati restano nel denominatore e vengono conteggiati come risposte errate. Sette risposte HLE sono state troncate a max_tokens; 28 richieste AA-LCR non sono riuscite, tutte nella finestra 1.
Perché è importante il conteggio dei token di input?
Perché il conteggio usato per la fatturazione dovrebbe corrispondere al conteggio nativo del modello. Un input da 10k token è stato riportato come 10,026 token (conteggio nativo: 10,000), mentre un input da 8 token è stato riportato come 34. Anche la richiesta di controllo senza strumenti presentava già una discrepanza, e sia lo streaming sia la modalità non streaming hanno riportato 34. Tutte e tre le verifiche di conteggio sono fallite, per un totale di cinque controlli di fatturazione.
Il risultato della cache a 32k indica un cache miss o un errore?
Un errore. Otto delle nove richieste hot da 32k hanno avuto un cache hit e hanno letto 32,000 token. L’unica richiesta senza cache hit è la quarta nella finestra 2, che ha raggiunto la scadenza di 300 s senza completarsi. Nel gruppo da 8k, tutte e nove hanno avuto un cache hit e hanno letto 7,936 token.
È possibile distinguere la qualità delle risposte di ByteDance da quella del canale ufficiale?
No. La precisione complessiva è inferiore di 0.40 punti rispetto al canale ufficiale, con un intervallo al 95% da −1.46 a +0.66. L’intervallo include 0, quindi i due risultati non sono distinguibili. Questo descrive solo il lotto di test in questione e non è una classifica.
Continua a leggere: la serie DeepSeek V4.1 Flash
- Il valore di riferimento di Q in questo articolo è il canale ufficiale; il test condotto su quel canale, comprese le 15 verifiche non valide con concorrenza singola, è descritto in DeepSeek V4.1 Flash sul canale ufficiale: F pari a 94.00, 15 verifiche non valide.
- Baidu è l’unico fornitore il cui intervallo di Q è inferiore a quello del canale ufficiale; gli errori del canale alla base di questo risultato sono descritti in DeepSeek V4.1 Flash su Baidu: nessun canale disponibile raggiunge Q e P.
- I dati sulla cache di Alibaba Cloud sono in linea con il 93.83 riportato qui: DeepSeek V4.1 Flash su Alibaba Cloud: 1.34s al primo token, cache al 99.37.
- Fireworks presenta gli stessi errori relativi al ragionamento e al conteggio dei token osservati qui, oltre a risposte vuote dopo lo stop: DeepSeek V4.1 Flash su Fireworks: risposte vuote dopo lo stop, 3/9 cache hit.


