AIHubMix exploite un réseau d'accélération mondial développé en interne pour le trafic des API. Après avoir évalué des fournisseurs d'accélération tiers et constaté que leur latence et leur stabilité étaient insuffisantes pour les charges de travail IA en production, nous avons déployé nos propres nœuds de périphérie, notre système de supervision et notre planification du trafic. Cet article décrit les résultats mesurés et l'architecture qui les permet.
Résultats mesurés
Les chiffres suivants proviennent d'une supervision continue en production, après itération de l'algorithme de planification.
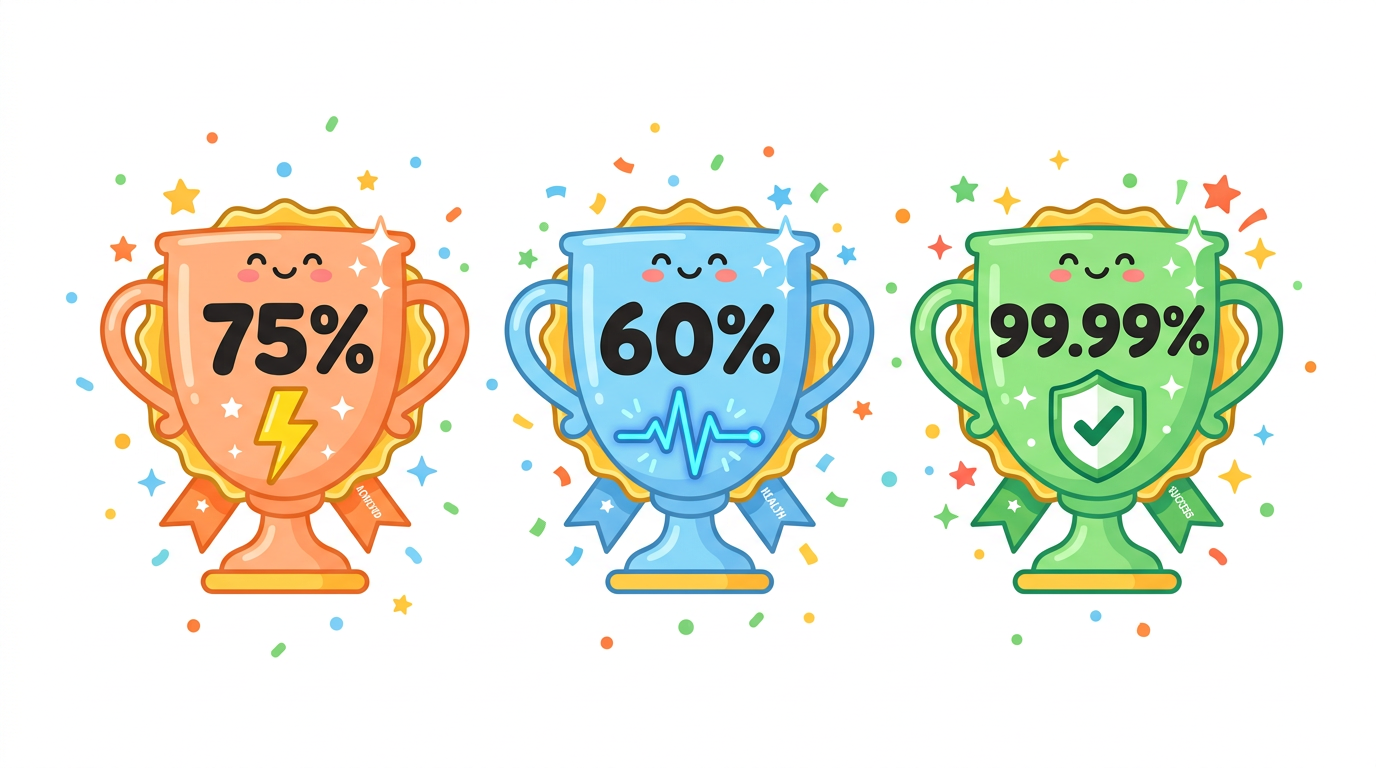
Latence de réponse réduite de 75 %
La latence de bout en bout des API a diminué de 75 % en moyenne. Dans les scénarios de streaming, cela améliore principalement le délai avant le premier jeton (TTFT), c'est-à-dire l'intervalle entre l'envoi d'une requête et la réception du premier jeton de sortie, qui détermine la réactivité perçue d'une application de chat.
Fluctuation de la latence réduite de 60 %
La variance de latence d'une requête à l'autre a diminué de 60 %. Une latence constante est essentielle pour les applications en production : elle rend les temps de réponse perçus par les utilisateurs prévisibles et réduit les expirations de délai dues à la latence de queue.
Disponibilité du service à 99,99 %
La disponibilité mesurée sur le trafic de production atteint 99,99 %. Il s'agit d'une valeur mesurée couvrant toutes les heures, y compris les week-ends et les jours fériés.
Architecture
Nœuds de périphérie développés en interne
Le réseau repose sur des nœuds d'accélération dédiés, déployés dans plusieurs régions et indépendants de toute ligne ou de tout fournisseur cloud unique. Chaque nœud passe des tests de référence sur la latence, la perte de paquets et la charge maximale avant d'entrer en production ; les nœuds qui n'atteignent pas les seuils sont retirés du pool. Le routage sélectionne le chemin disponible le plus rapide pour chaque appel d'API.
Supervision de l'état de santé avec des sondes toutes les minutes
Des sondes distribuées dans plusieurs régions exécutent chaque minute un contrôle de santé de bout en bout sur chaque nœud, selon trois dimensions : latence, taux de réussite et stabilité. L'ensemble du réseau est analysé toutes les 60 secondes, si bien que les anomalies d'un nœud sont détectées en un seul cycle de sonde.
Planification du trafic avec basculement automatique
Le système de planification recalcule chaque minute un score de santé pour chaque nœud, à partir des données de sondes issues de quatre fenêtres glissantes : 1 minute, 5 minutes, 15 minutes et 1 heure. Le trafic est acheminé vers le nœud présentant le meilleur score actuel. Lorsqu'un nœud se dégrade, le basculement vers un nœud sain s'effectue en quelques millisecondes, sans intervention humaine.
Exploitation automatisée
La gestion des nœuds, l'optimisation des routes, le déploiement des configurations, la rotation des certificats et la reprise après panne sont entièrement automatisés. Le traitement des incidents ne dépend pas du délai d'intervention de l'astreinte : dès que les sondes détectent une anomalie, le système de planification retire les nœuds dégradés de la rotation.
Ce que cela change pour votre application
- Un TTFT plus faible et plus constant dans les réponses en streaming.
- Moins d'erreurs de délai d'attente et de pics de latence de queue sous charge.
- Aucune modification d'intégration : l'accélération s'applique automatiquement aux points de terminaison standard de l'API.
FAQ
Faut-il modifier mon intégration pour bénéficier du réseau d'accélération ?
Non. L'accélération s'applique au niveau de la couche d'entrée de la plateforme. Les points de terminaison de l'API, les clés et les formats de requête existants fonctionnent sans changement.
À quelle fréquence l'état de santé des nœuds est-il contrôlé ?
Des sondes distribuées analysent chaque nœud du réseau toutes les 60 secondes, en mesurant la latence, le taux de réussite et la stabilité de bout en bout.
Que se passe-t-il lorsqu'un nœud se dégrade ?
Le système de planification recalcule les scores de santé chaque minute à partir de quatre fenêtres glissantes (1 minute, 5 minutes, 15 minutes, 1 heure) et redirige automatiquement le trafic vers les nœuds sains. Le basculement s'effectue en quelques millisecondes.
Dernière mise à jour : 2026-06-01