Connecter un LLM suffit pour qu'une application génère du texte. Ce n'est pas suffisant pour qu'un agent IA accomplisse une tâche réelle.
Demandez à un modèle de résumer un document déjà présent dans son contexte, et la couche modèle suffit. Demandez-lui de comparer les prix concurrentiels du jour, d'enrichir la fiche d'une entreprise, de vérifier un compte sur un réseau social ou de choisir la meilleure API pour une tâche inconnue, et la moitié manquante devient évidente : l'agent a besoin d'un moyen fiable d'atteindre des systèmes externes.
Un agent en production prend donc deux décisions distinctes :
- Quel modèle doit traiter cette étape ?
- Quel outil ou quelle API doit fournir les données ou l'action ?
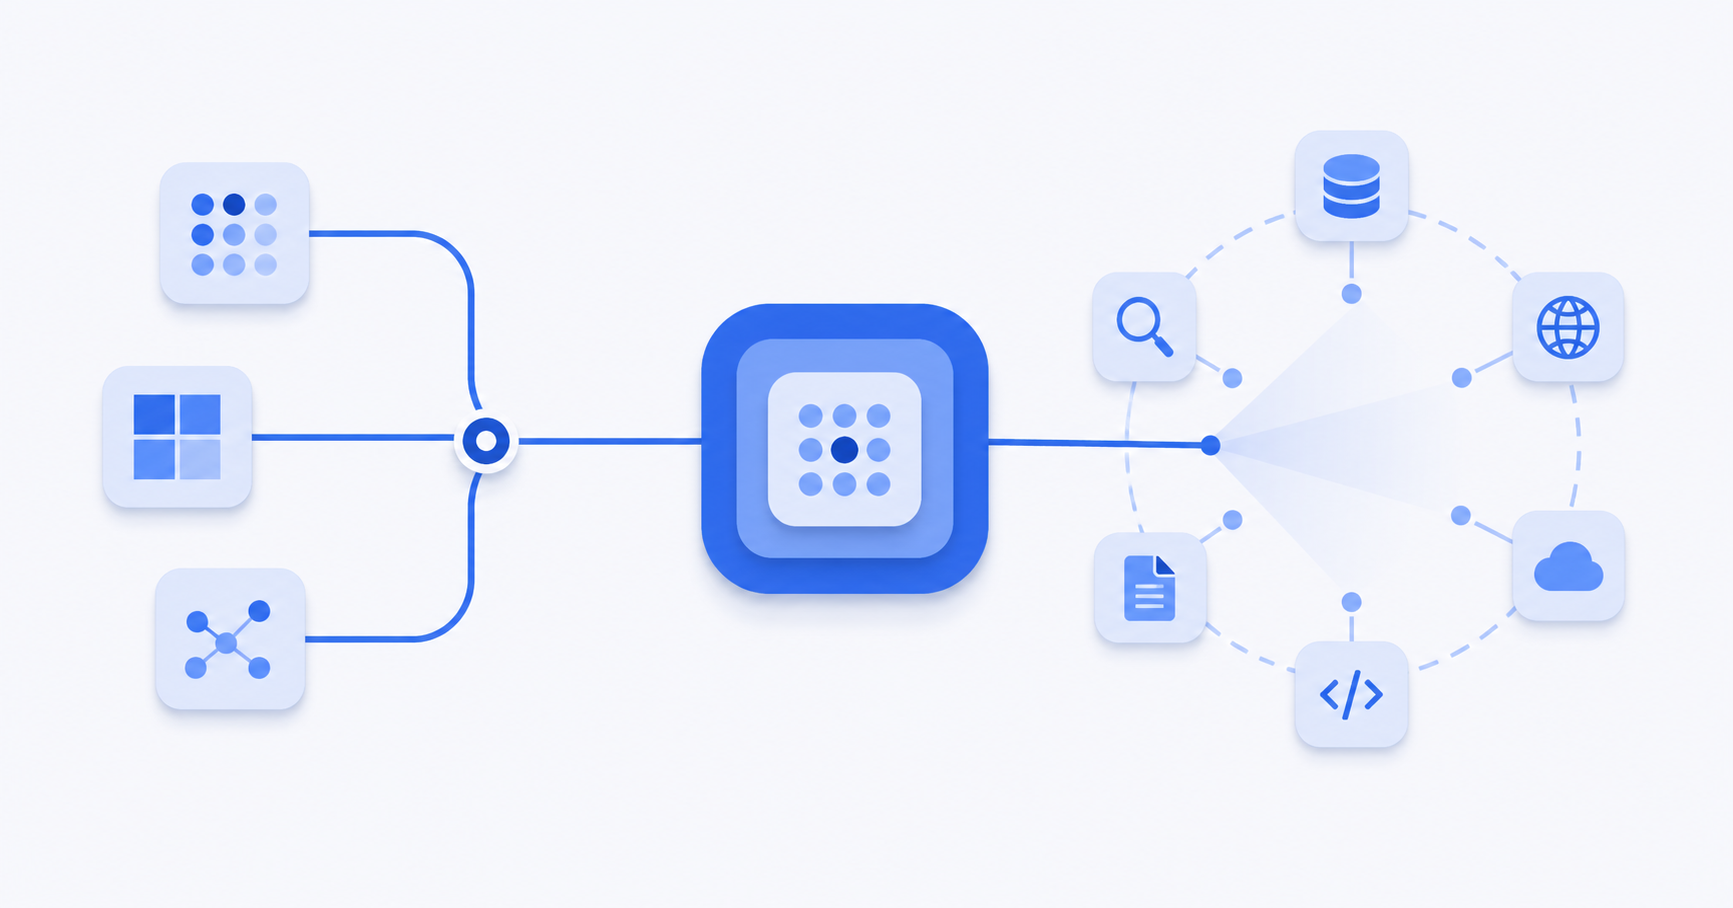
AIHubMix répond à la première décision grâce à un accès unifié aux modèles et à un routage de modèles au moment de la requête. Monid répond à la seconde grâce à la découverte d'outils à l'exécution, à l'inspection des schémas et à une exécution facturée à l'appel. Les produits se situent sur des couches différentes de la même architecture.
Déclaration : cet article a été créé dans le cadre d'une collaboration éditoriale avec Monid. AIHubMix est la plateforme de modèles présentée ci-dessous ; Monid est la plateforme d'outils. Chacune peut être utilisée indépendamment.
Les deux problèmes de routage au sein d'un agent IA
Une exécution d'agent se réduit rarement à un seul appel de modèle homogène. Un agent de recherche peut classer une demande, rechercher des informations actuelles, extraire des faits structurés, comparer les résultats et rédiger une réponse finale. Ces étapes exigent des capacités différentes.
Il en va de même en dehors du modèle. Une tâche de recherche sur une entreprise peut nécessiter une API de recherche aujourd'hui, un point d'accès d'enrichissement de données demain, et un outil d'automatisation de navigateur la semaine suivante. Si chaque modèle et chaque outil sont codés en dur à la compilation, chaque nouvelle tâche devient un projet d'intégration.
Les deux couches sont parallèles :
| Couche modèle | Couche outils | |
|---|---|---|
| Décision centrale | Quel modèle doit répondre ? | Quelle API doit être appelée ? |
| Moment de la sélection | À chaque requête | À chaque tâche, à l'exécution |
| Entrée | Prompt, modalité, besoins en qualité et en latence | Objectif, données ou action requises, schéma et prix |
| Sortie | Une complétion du modèle | Des données externes ou une action exécutée |
| Exemple | AIHubMix | Monid |
Cette séparation est importante. Un meilleur modèle ne peut pas donner accès à des données en direct, et un catalogue d'outils plus vaste ne peut pas raisonner sur les données qu'il renvoie. L'agent a besoin des deux capacités, avec un contrat clair entre elles.
Monid présente la vision complémentaire côté outils dans Pourquoi un agent IA a besoin de deux intégrations. Du point de vue du modèle, la leçon architecturale est la même : garder la sélection du modèle et celle de l'outil indépendantes, puis optimiser chaque couche pour sa propre mission.
Pourquoi un modèle fixe devient coûteux dans une boucle d'agent
Utiliser un seul modèle partout paraît simple. En pratique, cela impose à chaque étape le même compromis entre capacité, latence et prix.
Prenons l'exemple d'un agent d'étude de marché :
- La classification d'intention est courte et mécanique.
- La sélection d'outils exige un suivi fiable des instructions.
- L'extraction de champs à partir d'un JSON renvoyé relève surtout de la transformation.
- Le rapport final peut nécessiter un raisonnement plus solide et une meilleure rédaction.
Envoyer les quatre étapes au modèle le plus performant gaspille de l'argent pour des tâches routinières. Les envoyer toutes au modèle le moins cher peut dégrader la qualité du seul résultat que l'utilisateur lit. Au fil de la croissance de la boucle, ce compromis se répète à chaque appel.
AIHubMix fournit un point d'accès compatible OpenAI donnant accès à un large catalogue de modèles. Une intégration existante du SDK OpenAI peut pointer vers AIHubMix en changeant la clé API et base_url :
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Définir model sur auto déplace la sélection du modèle dans le chemin de la requête. Le routeur analyse la tâche et la résout vers un modèle adapté. Un suffixe de politique rend l'objectif d'optimisation explicite :
| Valeur du routeur | Priorité | Étape typique d'un agent |
|---|---|---|
auto |
Coût d'abord | Traitements par lots et transformations routinières |
auto:balanced |
Capacité, coût et latence | Travail d'agent polyvalent |
auto:quality_first |
Capacité d'abord | Raisonnement complexe et livrables finaux |
auto:latency_critical |
Rapidité d'abord | Boucles interactives et planification légère |
Le routage n'entraîne aucun frais supplémentaire. La requête est facturée au tarif public du modèle qui l'a effectivement traitée. Le modèle résolu et les détails du routage sont exposés dans la réponse, notamment via l'en-tête X-Aihubmix-Router-Resolved-Model, de sorte que la décision reste observable plutôt que de devenir une boîte noire.
Le comportement complet, les points d'accès pris en charge, les politiques et les limites actuelles sont documentés dans le guide du routeur LLM d'AIHubMix.
Le routage de modèles ne donne pas de données en direct à un agent
Une fois le routage de modèles configuré, l'agent peut choisir un meilleur « cerveau » pour chaque étape. Il ne peut toujours pas connaître les changements survenus après les données d'entraînement du modèle, accéder à un système d'entreprise privé ou effectuer une action dans une autre application, sauf si un outil offre cette capacité.
C'est là que de nombreux projets d'agents accumulent un code fragile. Une équipe connecte une API de recherche, puis une API de scraping, puis une API d'enrichissement. Chaque intégration ajoute un compte, des identifiants, un format de requête, un modèle d'erreurs et une relation de facturation supplémentaires. Les descriptions d'outils sont souvent copiées dans un prompt système et deviennent peu à peu obsolètes.
Le mode de défaillance est dangereux parce qu'il peut sembler réussi. Un modèle peut produire un appel plausible sur un schéma obsolète, recevoir une réponse incomplète et poursuivre comme si la tâche avait réussi. L'inspection du schéma à l'exécution est plus sûre que de demander au modèle de se souvenir d'un contrat d'API issu de son entraînement ou d'un ancien prompt.
La couche outils doit donc répondre à trois questions avant l'exécution :
- Quel outil peut atteindre cet objectif ?
- Quel schéma et quel prix s'appliquent actuellement ?
- Quel résultat l'appel a-t-il réellement renvoyé ?
La découverte d'outils constitue la seconde couche de routage
Monid transforme l'accès aux outils en un flux de découverte, d'inspection et d'exécution. Plutôt que d'exiger du développeur qu'il prévoie chaque API dont un agent pourrait avoir besoin, l'agent peut interroger un catalogue en langage naturel, inspecter le contrat d'un candidat et exécuter le point d'accès choisi.
Le flux de base se présente ainsi :
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
La découverte et l'inspection permettent à l'agent de comparer les options avant de dépenser quoi que ce soit. L'exécution est facturée selon le modèle de tarification du point d'accès sélectionné. Le développeur conserve une seule intégration tandis que l'agent accède à des outils proposés par plusieurs fournisseurs.
Pour les environnements d'agents capables de lire des instructions de configuration, Monid publie également un skill lisible par machine :
Set up https://monid.ai/SKILL.md
La documentation du flux de travail Monid détaille davantage les étapes de catalogue, d'inspection et d'exécution.
Comment les deux couches fonctionnent ensemble
La passerelle de modèles et la couche outils doivent rester des composants séparés, avec une transmission petite et explicite :
- L'agent reçoit un objectif de l'utilisateur.
- AIHubMix achemine un appel de planification vers un modèle approprié.
- Le plan identifie les informations manquantes ou une action externe requise.
- Monid découvre les outils candidats et expose leurs schémas et leurs prix.
- L'agent sélectionne et exécute un outil dans le cadre de ses autorisations et de son budget.
- L'outil renvoie des faits ou le résultat d'une action.
- AIHubMix achemine l'appel de synthèse selon la qualité, le coût ou la latence requis.
- L'agent renvoie une réponse fondée sur le résultat de l'outil.
En Python simplifié, les appels côté modèle peuvent rester inchangés, le résultat de l'outil étant inséré comme contexte :
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
Le point important n'est pas le nombre de lignes. Aucun de ces choix n'a besoin d'être figé dans la logique applicative. Le modèle peut changer lorsque le prompt évolue, et l'outil peut changer lorsque la tâche évolue.
Les contrôles de coûts doivent exister aux deux niveaux
Les coûts des modèles et des outils utilisent des unités différentes ; ils doivent donc être mesurés séparément.
Au niveau du modèle, le modèle résolu détermine la tarification au token. AIHubMix rend cette décision traçable et permet aux développeurs de choisir une politique de routage ou de restreindre les modèles qu'une clé API peut utiliser. Les étapes routinières peuvent privilégier le coût ou la latence, tandis que les résultats destinés à l'utilisateur peuvent privilégier la qualité.
Au niveau des outils, un point d'accès peut facturer à l'appel ou au résultat. Monid expose la tarification pendant l'inspection, avant l'exécution. Un agent peut rejeter un point d'accès qui dépasse son budget, privilégier une option vérifiée ou demander une validation avant une opération anormalement coûteuse.
Les contrôles utiles en production comprennent :
- Une liste d'autorisation de modèles ou un plafond de prix pour chaque clé API.
- Un budget maximal d'appels d'outils par tâche.
- Des listes d'autorisation de fournisseurs ou de points d'accès pour les données réglementées.
- Des journaux qui relient la décision de routage du modèle à l'appel d'outil et à la réponse finale.
- Une confirmation explicite avant toute action irréversible ou sensible.
- Une validation des sorties afin que les données d'outils soient traitées comme des entrées non fiables, et non comme des instructions.
Cette séparation facilite aussi le débogage des coûts. Si une exécution devient coûteuse, les journaux de tokens montrent si l'agent a trop raisonné, tandis que les journaux d'outils montrent s'il a trop récupéré de données. Les corrections sont différentes, et l'architecture doit préserver cette distinction.
La fiabilité exige des contrats à jour et des décisions visibles
Une sélection dynamique ne doit pas signifier un comportement imprévisible.
Côté modèle, AIHubMix indique le modèle résolu et la politique de routage pour chaque requête. La persistance de session peut préserver la cohérence du modèle et les bénéfices du cache de prompts sur des travaux en plusieurs tours, tandis que le comportement de repli peut écarter un modèle défaillant lorsque cela est nécessaire.
Côté outils, l'agent inspecte le schéma actuel du point d'accès avant d'effectuer un appel payant. Les résultats de découverte contiennent les informations nécessaires pour comparer les candidats, et le résultat de l'appel effectif devient la seule preuve externe transmise à la complétion finale.
Ensemble, ces contrôles créent une piste d'audit utile :
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Cette piste est plus précieuse que le simple accès à de nombreux modèles ou à de nombreuses API. Elle explique pourquoi l'agent a fait chaque choix et quelles preuves ont étayé sa réponse.
Quand vous n'avez pas besoin des deux couches
Tous les workflows ne bénéficient pas d'un choix à l'exécution.
Si une application envoie un prompt stable à un modèle unique et évalué, spécifier directement ce modèle est plus simple et plus déterministe que le routage. Si un pipeline planifié appelle toujours une même API connue, intégrer directement cette API peut être plus clair que d'ajouter une couche de découverte.
L'architecture à deux couches se justifie lorsque la variété fait partie de la charge de travail :
- Les prompts sont suffisamment différents pour que le meilleur modèle change selon l'étape.
- Les agents effectuent plusieurs appels de modèle et doivent contrôler le coût ou la latence cumulés.
- Les outils nécessaires ne peuvent pas être entièrement prévus au moment de la conception.
- Les données externes doivent être à jour et leur source doit être visible.
- L'équipe souhaite ajouter des capacités sans intégrer un nouveau fournisseur pour chacune d'elles.
Utilisez la couche modèle, la couche outils, ou les deux, selon les décisions que votre application doit réellement prendre.
Construire l'agent autour des décisions, pas des dépendances
Un agent d'IA en production ne se définit pas par le nombre de modèles ou d'API qu'il peut atteindre. Il se définit par sa capacité à choisir la bonne ressource pour l'étape en cours, à fonctionner dans un budget et à expliquer ce qui s'est passé.
AIHubMix offre à l'agent un point de terminaison de modèle unifié et un routage au moment de la requête selon les priorités de coût, de qualité et de latence. Monid lui offre la découverte d'outils à l'exécution, des schémas à jour, une tarification visible et l'exécution auprès de fournisseurs externes.
Une couche décide de la manière dont l'agent raisonne. L'autre décide de la manière dont il découvre et agit. Séparer ces décisions produit un agent plus facile à étendre, à observer et à contrôler.
Commencez par le guide de démarrage rapide d'AIHubMix, puis connectez la partie outils via Monid.
FAQ
Qu'est-ce que le routage de modèles pour les agents d'IA ?
Le routage de modèles sélectionne un modèle pour chaque requête en fonction de facteurs tels que le type de tâche, la capacité, le coût et la latence. Avec AIHubMix, définir model sur auto ou sur une politique telle que auto:quality_first active la sélection au moment de la requête tout en préservant une API compatible OpenAI.
Pourquoi un agent d'IA a-t-il besoin d'outils si le LLM dispose déjà de connaissances ?
Un LLM génère des réponses à partir du contexte qu'il reçoit et de ce qu'il a appris pendant l'entraînement. Il ne peut pas connaître de façon fiable les prix actuels, interroger une base de données privée ou effectuer une action externe sans un outil connecté. Les outils fournissent des données en temps réel et l'exécution ; le modèle planifie et interprète le résultat.
Une passerelle de modèles est-elle la même chose qu'un serveur MCP ou qu'une plateforme d'outils ?
Non. Une passerelle de modèles achemine les requêtes d'inférence vers les modèles. Les serveurs MCP et les plateformes d'outils exposent des capacités externes à un agent. Ils résolvent des problèmes d'intégration complémentaires et peuvent être utilisés ensemble.
AIHubMix et Monid peuvent-ils être utilisés indépendamment ?
Oui. AIHubMix peut router les appels de modèles pour les applications qui n'ont pas de besoins dynamiques en outils. Monid peut fournir la découverte d'outils à des agents utilisant un autre fournisseur de modèles ou une autre passerelle. Utiliser les deux est utile lorsqu'un agent doit faire un choix à l'exécution sur les deux couches.
Comment garder le routage automatique auditable ?
Consignez, pour chaque tâche, le modèle résolu, la politique de routage, le candidat outil, le prix vérifié, le point de terminaison sélectionné et le résultat renvoyé. AIHubMix expose les détails du routage de modèles dans la réponse, tandis que Monid sépare la découverte et l'inspection de l'exécution, de sorte que la décision concernant l'outil puisse être enregistrée avant l'appel payant.