Conectar un LLM basta para que una aplicación genere texto. No basta para que un agente de IA complete una tarea del mundo real.
Pide a un modelo que resuma un documento que ya está en su contexto y la capa del modelo es suficiente. Pídele que compare los precios actuales de la competencia, enriquezca el registro de una empresa, revise una cuenta de redes sociales o elija la mejor API para una tarea desconocida, y la mitad que falta se vuelve evidente: el agente necesita una forma fiable de acceder a sistemas externos.
Por eso, un agente de producción toma dos decisiones independientes:
- ¿Qué modelo debe encargarse de este paso?
- ¿Qué herramienta o API debe proporcionar los datos o la acción?
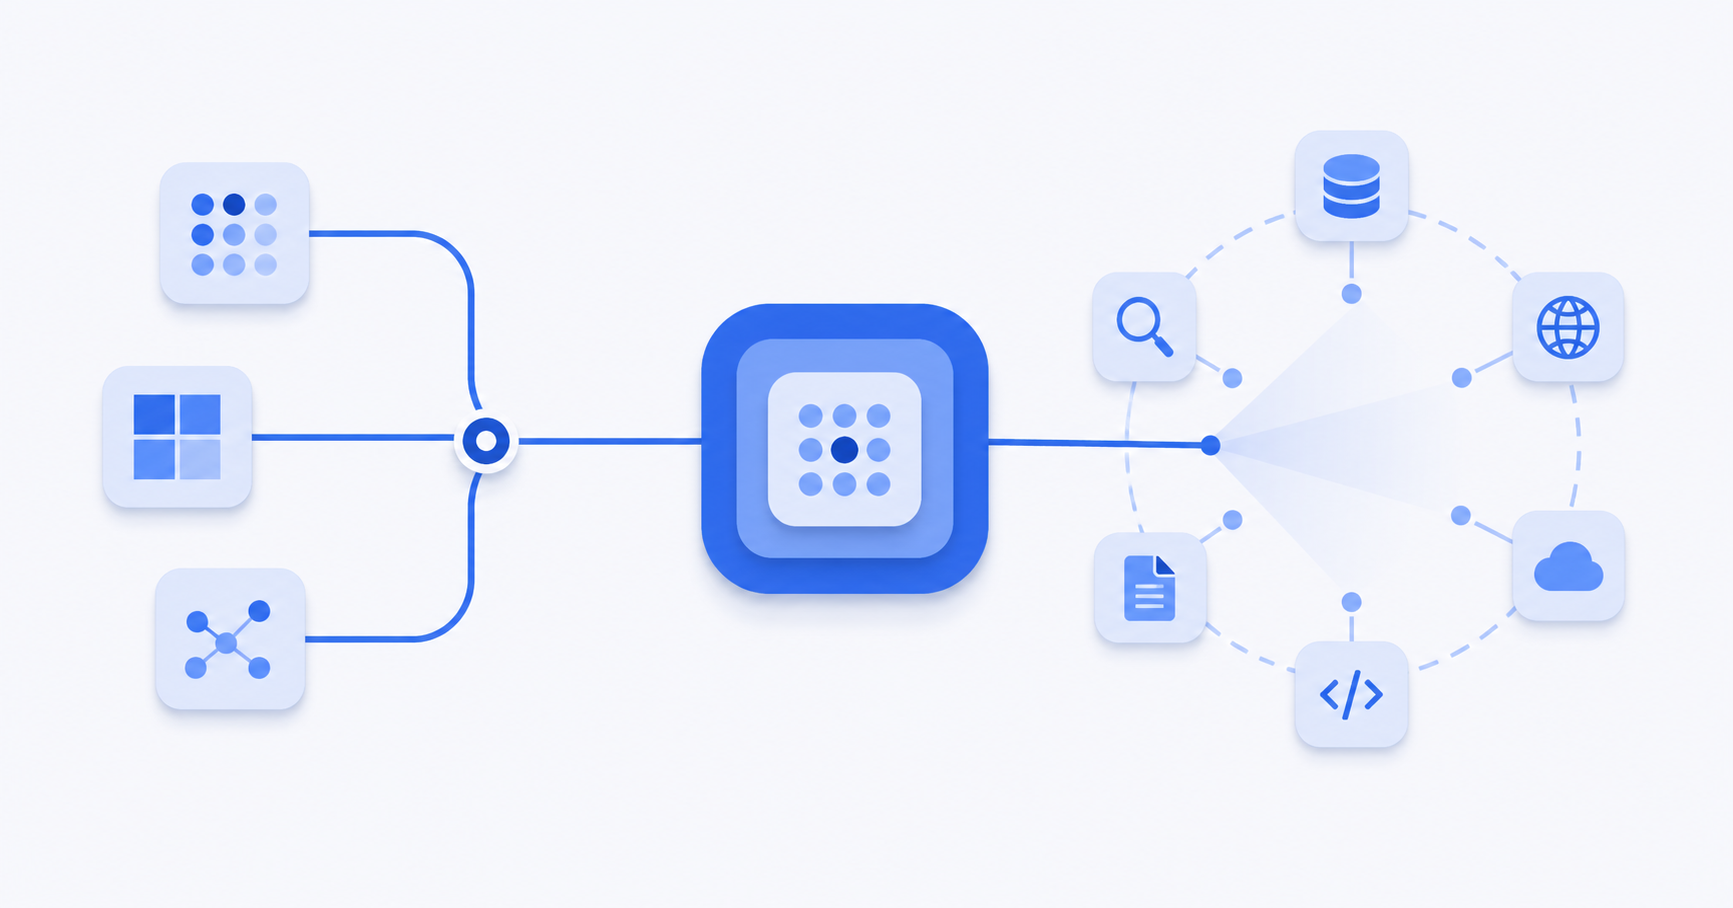
AIHubMix aborda la primera decisión con acceso unificado a modelos y enrutamiento de modelos en el momento de la solicitud. Monid aborda la segunda con descubrimiento de herramientas en tiempo de ejecución, inspección de esquemas y ejecución de pago por llamada. Los productos se sitúan en capas diferentes de la misma arquitectura.
Aviso: Este artículo se creó como parte de una colaboración de contenido con Monid. AIHubMix es la plataforma de modelos que se analiza a continuación; Monid es la plataforma de herramientas. Cada una puede utilizarse de forma independiente.
Los dos problemas de enrutamiento dentro de un agente de IA
Una ejecución de agente rara vez es una única llamada homogénea a un modelo. Un agente de investigación puede clasificar una solicitud, buscar información actual, extraer datos estructurados, comparar resultados y redactar una respuesta final. Esos pasos requieren capacidades distintas.
Lo mismo ocurre fuera del modelo. Una tarea de investigación de empresas puede necesitar hoy una API de búsqueda, mañana un endpoint de enriquecimiento de empresas y la semana siguiente una herramienta de automatización de navegador. Si cada modelo y cada herramienta están codificados de forma fija en el momento de la compilación, cada nueva tarea se convierte en un proyecto de integración.
Las dos capas son paralelas:
| Capa de modelo | Capa de herramientas | |
|---|---|---|
| Decisión principal | ¿Qué modelo debe responder? | ¿Qué API debe llamarse? |
| Momento de selección | Por solicitud | Por tarea, en tiempo de ejecución |
| Entrada | Prompt, modalidad, necesidades de calidad y latencia | Objetivo, datos o acción requeridos, esquema y precio |
| Salida | Una respuesta del modelo | Datos externos o una acción ejecutada |
| Ejemplo | AIHubMix | Monid |
Esta separación es importante. Un mejor modelo no puede crear acceso a datos en vivo, y un catálogo de herramientas más grande no puede razonar sobre los datos que devuelve. El agente necesita ambas capacidades, con un contrato claro entre ellas.
Monid presenta la visión complementaria del lado de las herramientas en Why an AI Agent Needs Two Integrations. Desde el lado del modelo, la lección arquitectónica es la misma: mantener independientes la selección de modelos y la selección de herramientas, y luego optimizar cada capa para su propia función.
Por qué un modelo fijo se vuelve caro en el bucle de un agente
Usar un solo modelo para todo parece sencillo. En la práctica, obliga a cada paso a aceptar el mismo compromiso entre capacidad, latencia y precio.
Considera un agente de investigación de mercado:
- La clasificación de intenciones es breve y mecánica.
- La selección de herramientas necesita un seguimiento fiable de instrucciones.
- Extraer campos de un JSON devuelto es sobre todo transformación.
- El informe final puede requerir un razonamiento más sólido y una mejor redacción.
Enviar los cuatro pasos al modelo más capaz malgasta dinero en tareas rutinarias. Enviar los cuatro al modelo más barato puede reducir la calidad del único resultado que lee el usuario. A medida que crece el bucle del agente, ese compromiso se repite en cada llamada.
AIHubMix proporciona un endpoint compatible con OpenAI para un amplio catálogo de modelos. Una integración existente del SDK de OpenAI puede apuntar a AIHubMix cambiando la clave de API y el base_url:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Al establecer model en auto, la selección del modelo pasa a formar parte de la ruta de la solicitud. El enrutador analiza la tarea y resuelve un modelo adecuado. Un sufijo de política hace explícito el objetivo de optimización:
| Valor del enrutador | Prioridad | Paso típico del agente |
|---|---|---|
auto |
Coste primero | Trabajo por lotes y transformaciones rutinarias |
auto:balanced |
Capacidad, coste y latencia | Trabajo general del agente |
auto:quality_first |
Capacidad primero | Razonamiento complejo y entregables finales |
auto:latency_critical |
Velocidad primero | Bucles interactivos y planificación ligera |
El enrutamiento no añade una tarifa aparte. La solicitud se factura al precio de lista del modelo que realmente la atendió. El modelo resuelto y los detalles del enrutamiento se muestran en la respuesta, incluido el encabezado X-Aihubmix-Router-Resolved-Model, de modo que la decisión sigue siendo observable y no se convierte en una caja negra.
El comportamiento completo, los endpoints compatibles, las políticas y las limitaciones actuales están documentados en la guía del enrutador LLM de AIHubMix.
El enrutamiento de modelos no proporciona datos en vivo al agente
Una vez configurado el enrutamiento de modelos, el agente puede elegir un mejor «cerebro» para cada paso. Aun así, no puede conocer lo que cambió después de los datos de entrenamiento del modelo, acceder a un sistema empresarial privado ni realizar una acción en otra aplicación, a menos que una herramienta le ofrezca esa capacidad.
Aquí es donde muchos proyectos de agentes acumulan código frágil. Un equipo conecta una API de búsqueda, luego una API de scraping y después una API de enriquecimiento. Cada integración introduce otra cuenta, otra credencial, otro formato de solicitud, otro modelo de errores y otra relación de facturación. Las descripciones de herramientas suelen copiarse en un prompt del sistema y, poco a poco, quedan obsoletas.
El modo de fallo es peligroso porque puede parecer un éxito. Un modelo puede generar una llamada plausible contra un esquema desactualizado, recibir una respuesta incompleta y seguir adelante como si la tarea se hubiera completado. La inspección del esquema en tiempo de ejecución es más segura que pedir al modelo que recuerde un contrato de API a partir de su entrenamiento o de un prompt antiguo.
Por tanto, la capa de herramientas debe responder tres preguntas antes de la ejecución:
- ¿Qué herramienta puede cumplir este objetivo?
- ¿Qué esquema y qué precio se aplican ahora mismo?
- ¿Qué resultado devolvió realmente la llamada?
El descubrimiento de herramientas es la segunda capa de enrutamiento
Monid convierte el acceso a herramientas en un flujo de trabajo de descubrir, inspeccionar y ejecutar. En lugar de exigir al desarrollador que prevea cada API que pueda necesitar un agente, el agente puede buscar en un catálogo con lenguaje natural, inspeccionar el contrato de un candidato y ejecutar el endpoint seleccionado.
El flujo básico es el siguiente:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
El descubrimiento y la inspección permiten al agente comparar opciones antes de gastar nada. La ejecución se factura según el modelo de precios del endpoint seleccionado. El desarrollador mantiene una sola integración mientras el agente obtiene acceso a herramientas de varios proveedores.
Para los entornos de ejecución de agentes que pueden leer instrucciones de configuración, Monid también publica una skill legible por máquina:
Set up https://monid.ai/SKILL.md
La documentación del flujo de trabajo de Monid explica con más detalle las etapas de catálogo, inspección y ejecución.
Cómo trabajan juntas las dos capas
La pasarela de modelos y la capa de herramientas deben seguir siendo componentes separados con un traspaso pequeño y explícito:
- El agente recibe un objetivo del usuario.
- AIHubMix enruta una llamada de planificación a un modelo adecuado.
- El plan identifica la información que falta o una acción externa necesaria.
- Monid descubre herramientas candidatas y muestra sus esquemas y precios.
- El agente selecciona y ejecuta una herramienta dentro de sus permisos y su presupuesto.
- La herramienta devuelve datos o el resultado de una acción.
- AIHubMix enruta la llamada de síntesis según la calidad, el coste o la latencia requeridos.
- El agente devuelve una respuesta fundamentada en el resultado de la herramienta.
En Python simplificado, las llamadas al modelo pueden permanecer sin cambios mientras el resultado de la herramienta se inserta como contexto:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
El detalle importante no es el número de líneas. Lo importante es que ninguna de las dos decisiones necesita quedar incrustada de forma permanente en la lógica de la aplicación. El modelo puede cambiar cuando cambie el prompt, y la herramienta puede cambiar cuando cambie la tarea.
Los controles de coste deben existir en ambas capas
Los costes del modelo y de las herramientas usan unidades distintas, así que conviene medirlos por separado.
En la capa del modelo, el modelo resuelto determina el precio por tokens. AIHubMix hace trazable esa decisión y permite a los desarrolladores elegir una política de enrutamiento o restringir los modelos que puede usar una clave de API. Los pasos rutinarios pueden priorizar el coste o la latencia, mientras que los resultados visibles para el usuario pueden priorizar la calidad.
En la capa de herramientas, un endpoint puede cobrar por llamada o por resultado. Monid muestra los precios durante la inspección, antes de la ejecución. Un agente puede rechazar un endpoint que supere su presupuesto, preferir una opción verificada o pedir aprobación antes de una operación especialmente costosa.
Entre los controles útiles para producción se incluyen:
- Una lista de modelos permitidos o un límite de precio para cada clave de API.
- Un presupuesto máximo de llamadas a herramientas por tarea.
- Listas de proveedores o endpoints permitidos para datos regulados.
- Registros que relacionen la decisión de enrutamiento del modelo con la llamada a la herramienta y la respuesta final.
- Confirmación explícita antes de acciones irreversibles o sensibles.
- Validación de la salida para tratar los datos de las herramientas como entrada no confiable, no como instrucciones.
Esta división también facilita la depuración de costes. Si una ejecución se encarece, los registros de tokens muestran si el agente razonó demasiado, mientras que los registros de herramientas muestran si obtuvo demasiados datos. Las soluciones son distintas, y la arquitectura debe conservar esa distinción.
La fiabilidad exige contratos actualizados y decisiones visibles
La selección dinámica no debería significar un comportamiento impredecible.
En el lado del modelo, AIHubMix informa del modelo resuelto y de la política de enrutamiento de cada solicitud. La afinidad de sesión puede preservar la consistencia del modelo y los beneficios de la caché de prompts en trabajos de varios turnos, mientras que el comportamiento de respaldo puede alejarse de un modelo no disponible cuando sea necesario.
En el lado de las herramientas, el agente inspecciona el esquema actual del endpoint antes de realizar una llamada de pago. Los resultados del descubrimiento incluyen la información necesaria para comparar candidatos, y el resultado de la llamada real se convierte en la única evidencia externa que se pasa a la completación final.
En conjunto, estos controles crean un registro de auditoría útil:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Ese registro vale más que simplemente tener acceso a muchos modelos o a muchas APIs. Explica por qué el agente tomó cada decisión y qué evidencia respaldó su respuesta.
Cuándo no necesitas ambas capas
No todos los flujos de trabajo se benefician de la elección en tiempo de ejecución.
Si una aplicación envía un prompt estable a un único modelo evaluado, especificar ese modelo directamente es más sencillo y más determinista que enrutar. Si una canalización programada siempre llama a una misma API conocida, integrar esa API directamente puede ser más claro que añadir una capa de descubrimiento.
La arquitectura de dos capas se justifica cuando la variedad forma parte de la carga de trabajo:
- Los prompts difieren lo suficiente como para que el mejor modelo cambie según el paso.
- Los agentes realizan múltiples llamadas a modelos y necesitan controlar el costo acumulado o la latencia.
- Las herramientas necesarias no pueden predecirse por completo en el momento de la compilación.
- Los datos externos deben estar actualizados y su fuente debe ser visible.
- El equipo quiere añadir capacidades sin agregar una nueva integración con un proveedor por cada una.
Usa la capa de modelos, la capa de herramientas o ambas, según las decisiones que tu aplicación necesite tomar realmente.
Diseña el agente en torno a decisiones, no a dependencias
Un agente de IA en producción no se define por cuántos modelos o APIs puede alcanzar. Se define por si puede elegir la capacidad adecuada para el paso actual, operar dentro de un presupuesto y explicar lo que ocurrió.
AIHubMix le proporciona al agente un endpoint de modelos unificado y enrutamiento de modelos en tiempo de solicitud según las prioridades de costo, calidad y latencia. Monid le ofrece descubrimiento de herramientas en tiempo de ejecución, esquemas actualizados, precios visibles y ejecución a través de proveedores externos.
Una capa decide cómo piensa el agente. La otra decide cómo averigua y actúa. Mantener esas decisiones separadas produce un agente más fácil de ampliar, observar y controlar.
Comienza con el inicio rápido de AIHubMix y luego conecta el lado de las herramientas a través de Monid.
Preguntas frecuentes
¿Qué es el enrutamiento de modelos para agentes de IA?
El enrutamiento de modelos selecciona un modelo para cada solicitud en función de factores como el tipo de tarea, la capacidad, el costo y la latencia. Con AIHubMix, al establecer model en auto o en una política como auto:quality_first, se habilita la selección en tiempo de solicitud manteniendo una API compatible con OpenAI.
¿Por qué un agente de IA necesita herramientas si el LLM ya tiene conocimiento?
Un LLM genera respuestas a partir del contexto que recibe y de lo que aprendió durante el entrenamiento. No puede saber de forma fiable los precios actuales, consultar una base de datos privada ni realizar una acción externa sin una herramienta conectada. Las herramientas aportan datos en vivo y ejecución; el modelo planifica e interpreta el resultado.
¿Es un gateway de modelos lo mismo que un servidor MCP o una plataforma de herramientas?
No. Un gateway de modelos enruta las solicitudes de inferencia hacia los modelos. Los servidores MCP y las plataformas de herramientas exponen capacidades externas a un agente. Resuelven problemas de integración complementarios y pueden usarse juntos.
¿Se pueden usar AIHubMix y Monid de forma independiente?
Sí. AIHubMix puede enrutar las llamadas a modelos para aplicaciones que no tienen requisitos dinámicos de herramientas. Monid puede proporcionar descubrimiento de herramientas a agentes que usan otro proveedor de modelos o gateway. Usar ambos es útil cuando un agente necesita elegir en tiempo de ejecución en ambas capas.
¿Cómo puedo mantener el enrutamiento automático auditable?
Registra el modelo resuelto, la política de enrutamiento, el candidato de herramienta, el precio consultado, el endpoint seleccionado y el resultado devuelto para cada tarea. AIHubMix expone los detalles del enrutamiento de modelos en la respuesta, mientras que Monid separa el descubrimiento y la inspección de la ejecución, de modo que la decisión sobre la herramienta puede registrarse antes de la llamada de pago.