

Gemini 4 Hydrogen kostet pro Token doppelt so viel wie der Einführungspreis von Gemini 3.8 Flash: 1,50 $ pro Million Eingabe-Token und 7,50 $ pro Million Ausgabe-Token gegenüber 0,75 $ und 3,75 $. In den Live-Messungen von Artificial Analysis erledigt Hydrogen eine Index-Aufgabe für 1,87 $; Gemini 3.8 Flash braucht dafür 7,77 $. Der Token-Preis hat sich verdoppelt, doch die Kosten pro erledigter Aufgabe sind um etwa drei Viertel gesunken.
Das ist das Ungewöhnliche an diesem Upgrade. Google empfiehlt Hydrogen als Upgrade von Gemini 3.8 Flash und früheren Gemini-3- und 2.5-Modellen, doch es handelt sich nicht um eine Flash-Aktualisierung. Die Modellkarte sagt es ganz deutlich: „Gemini 4 Hydrogen ist von Gemini 4 Carbon abgeleitet.“ Hydrogen übernimmt das Kontextfenster von Gemini 4, dessen Long-Decode-Pfad und eine neue Denkstufe, xhigh, behält aber eine Flash-typische Aufgabe: schnelle Ausführung in großem Umfang.
Das Ergebnis ist ein Modell, das sich anhand des Budgets pro Aufgabe leichter rechtfertigen lässt als anhand des Budgets pro Token. Im Folgenden: Was sich geändert hat, was die Messwerte aussagen, wo die Grenzen des Upgrades liegen und wie du es über AIHubMix aufrufst.
Was Hydrogen ist
Laut dem Gemini-API-Changelog wurde Hydrogen am 2026-11-12 allgemein verfügbar; die Modellkarte trägt dasselbe Datum. In seinem Launch-Beitrag bezeichnet Google Hydrogen als „unseren täglichen Begleiter für agentische Workflows“ und positioniert Carbon und Argon als Modelle, die „für tiefgehendes, langfristiges Reasoning entwickelt wurden“. Hydrogen ist laut Modellkarte das Modell, das „für die schnelle Ausführung vielfältiger agentischer Workflows entwickelt wurde“, und kann allein oder als Sub-Agent neben den Spitzenmodellen eingesetzt werden.
Drei Fakten zum Launch sind für API-Nutzer relevant. Hydrogen ist das einzige Gemini-4-Modell im kostenlosen Kontingent: Google zufolge ist es „sowohl im kostenlosen als auch im kostenpflichtigen Kontingent in Google AI Studio und der Gemini API verfügbar“. Außerdem ist es das einzige Gemini-4-Modell mit xhigh-Denkmodus. Und laut Changelog ist es das Standardmodell für den Antigravity-Agenten in Gemini Managed Agents.
Ein Vorbehalt gehört gleich an den Anfang. In der Unternehmensdokumentation bezeichnet Google Hydrogen als „eine kurzfristige allgemein verfügbare (GA) Version, für die eine Mindestkündigungsfrist von 45 Tagen gilt“. Auf der Seite zu abgekündigten Modellen ist kein Abschaltdatum aufgeführt. Teams, die eine langfristige Abhängigkeit planen, sollten diesen Satz jedoch als Warnung verstehen und die Modellzeichenfolge konfigurierbar halten.
Was sich gegenüber Gemini 3.8 Flash ändert
Die beiden Modelle haben mehr gemeinsam, als ihre Preisstufe vermuten lässt. Bei Googles API unterstützen beide ein Kontextfenster von 1,048,576 Token, nehmen Text, Bilder, Audio und Video entgegen und sind im kostenlosen Kontingent verfügbar. Auf der AIHubMix-Modellseite sind für Hydrogen Text-, Bild-, Audio-, Video- und PDF-Eingaben sowie Textausgaben aufgeführt; auf Googles Unternehmensseite werden außerdem Office- und OpenDocument-Dateien genannt, die auf der Gateway-Seite fehlen. Die Unterschiede liegen beim Ausgabespielraum, den Denkstandards und dem Aufbau der API-Oberfläche.
| Merkmal | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| Kontextfenster | 1,048,576 Token | 1,048,576 Token |
| Maximale Ausgabe | 1,048,576 Token über Long Decode | 65,536 Token |
| Synchrone Ausgabe | 65,536 Token pro Schritt, mit oder ohne Streaming | 65,536 Token |
| Denkstufen | low, medium, high (Standard), xhigh | low, medium (Standard), high |
| Eingabemodalitäten | Text, Bild, Audio, Video, PDF, Office | Text, Bild, Audio, Video, PDF |
| Kostenloses Kontingent | Ja | Ja |
| Caching | nur implizit, mindestens 4,096 Token | implizit und explizit |
Hydrogen ergänzt eine vierte Stufe, xhigh, und hebt den Standard von medium auf high an. Außerdem erlaubt es synchrone Schritte mit 65,536 Token sowohl im Streaming- als auch im Nicht-Streaming-Modus; Carbon und Argon erlauben 65,536 Token nur beim Streaming und ansonsten 32,768. Für lange Ausgaben verwendet Hydrogen denselben Hintergrund- oder Fortsetzungs-Token-Pfad wie der Rest der Gemini-4-Familie und kann bis zu 1,048,576 Token abzüglich der Eingabe erreichen.
Die Kosten pro Aufruf ergeben sich aus dem Standardwert. Hydrogen verbraucht pro Aufruf mehr Denk-Token als ein Modell mit dem Standardwert medium, und Ausgabe-Token umfassen auch Denk-Token. Wird ein Workload migriert, ohne eine Stufe festzulegen, fallen pro Aufruf in der Regel höhere Kosten an als bei 3.8 Flash – noch bevor der Unterschied beim Token-Preis berücksichtigt wird.
Das gemessene Upgrade: 20 Punkte mehr im Index, geringere Kosten pro Aufgabe
Artificial Analysis maß Hydrogen mit der Einstellung high im Intelligence Index mit 51 Punkten, Rang 21 von 78. Gemini 3.8 Flash erzielte mit high 31 Punkte und Rang 54. Die Kosten pro Aufgabe entwickelten sich in die entgegengesetzte Richtung: 1,87 $ gegenüber 7,77 $.
| Modell / Reasoning effort | AA-Rang | AA-Index | $/Aufgabe | Min./Aufgabe | Erstes Antwort-Token |
|---|---|---|---|---|---|
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Gemini 3.8 Flash high | 54 | 31 | 7.77 | 14.7 | 17.53 s |
Diese Zahlen stammen aus den Live-Messungen von Artificial Analysis, abgerufen am 2026-11-13T02:40Z, mit Intelligence Index v5.0.1 und 78 bewerteten Modellen. Sie basieren auf den Standard-Listenpreisen und sind keine AIHubMix-Abrechnungen. Beide Zeilen zeigen Ergebnisse mit hohem Reasoning effort, der Vergleich ist also bei high abgestimmt. Zu beachten ist, dass high bei Hydrogen der Standardwert ist, bei Flash jedoch nicht. Flash erzielt mit seinem Standardwert medium 30 Punkte bei 6,26 $ pro Aufgabe. Ein Vergleich der Standardwerte verändert also die Zahlen, nicht aber die Tendenz.
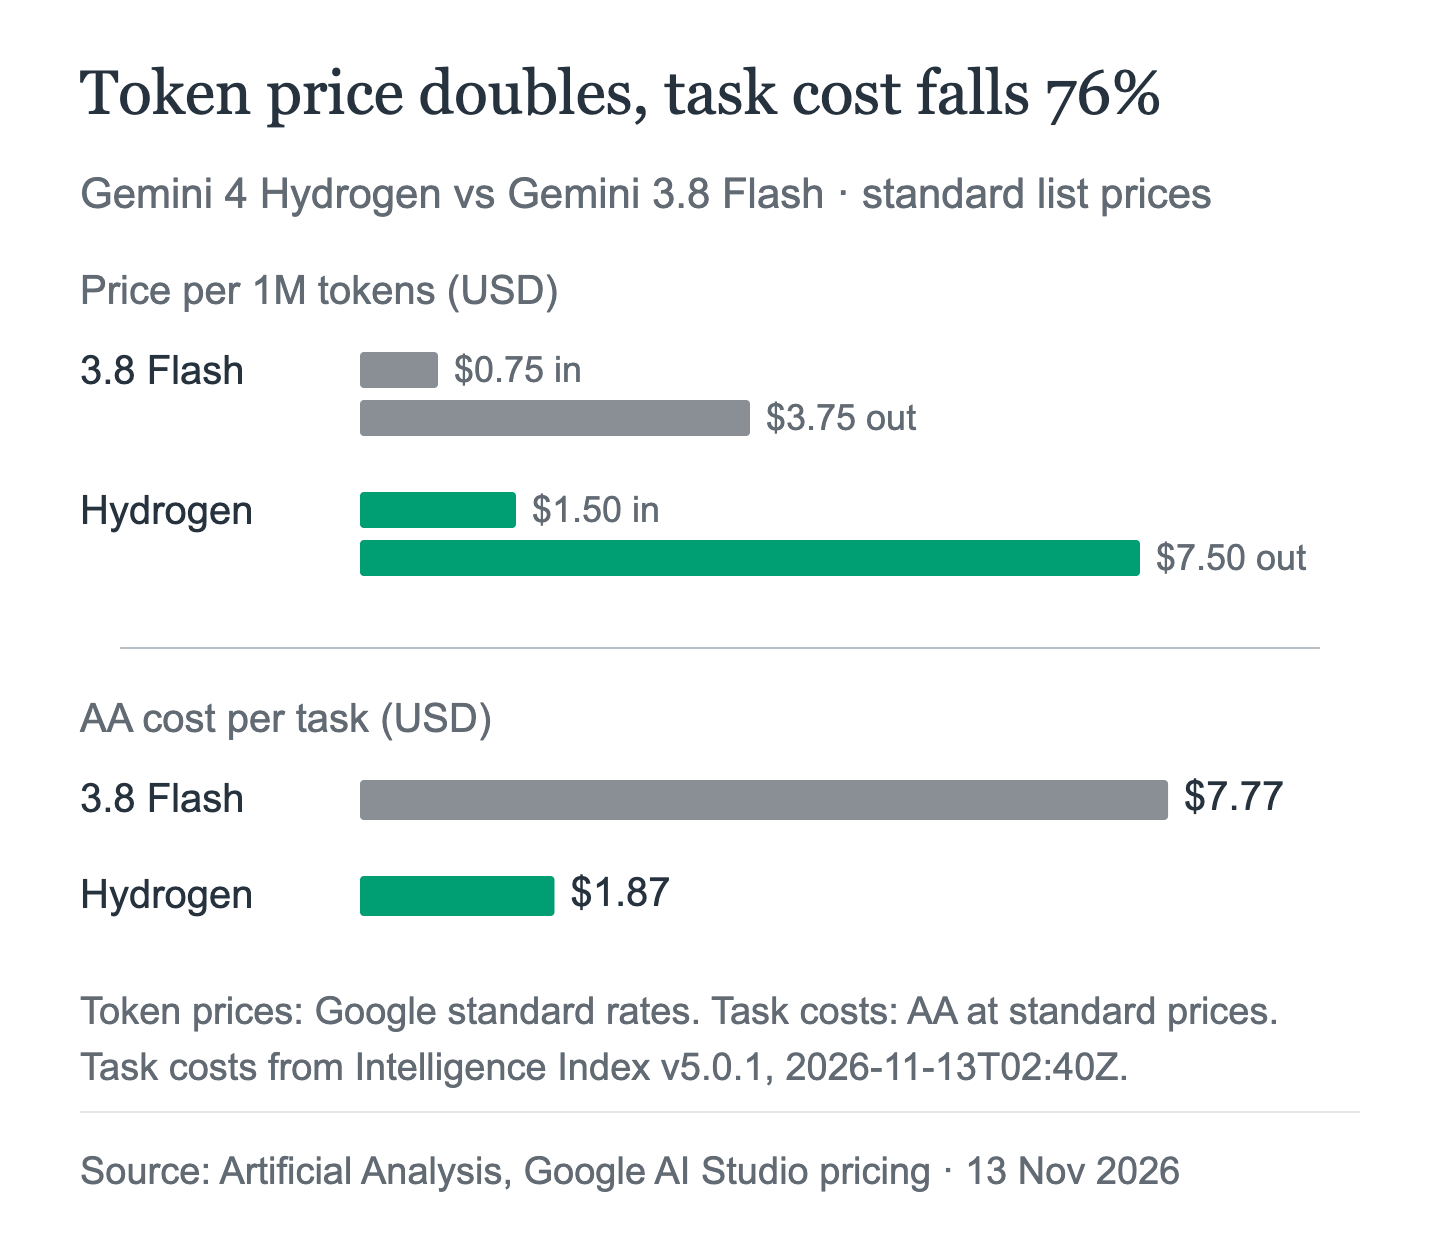
Entscheidend sind die Kosten pro Aufgabe. Hydrogen kostet pro Token doppelt so viel wie der Einführungspreis von Flash, doch die gemessenen Kosten pro Aufgabe liegen 75,9% niedriger. Der Unterschied ergibt sich daraus, wie viele Token die jeweiligen Modelle benötigen, um dieselbe Arbeit abzuschließen – das zeigt ein Preis pro Token nicht. Das erste Antwort-Token von Hydrogen kommt nach 18,89 Sekunden, etwa 1,4 Sekunden später als bei Flash mit 17,53 Sekunden. Die Aufgabe erledigt Hydrogen in 8,3 Minuten, Flash in 14,7 Minuten.
Mit xhigh erreicht Hydrogen 54 Punkte bei 3,16 $ pro Aufgabe und einer Dauer von 13,5 Minuten; das erste Token kommt nach 37,77 Sekunden. Damit liegt es in derselben Momentaufnahme vier Punkte über Gemini 4 Argon high (50) und sechs Punkte unter Carbon high (60). Die vier Stufen werden an anderer Stelle in dieser Reihe separat behandelt. Kurz gesagt: high ist die preiswerte Einstellung, xhigh ist für schwierige Aufgaben gedacht.
Googles Benchmark-Tabelle und die drei Kategorien, in denen Hydrogen verliert
Googles Modellkarte ist ein Anbieterdokument: Die Angaben stammen vom Anbieter selbst, wurden am 2026-11-12 veröffentlicht und vergleichen Hydrogen mit zwei Konkurrenten statt mit dem Vorgängermodell von Gemini. Hydrogen liegt in 7 von 10 aufgeführten Vergleichen vorn. Die drei Niederlagen sind der aufschlussreiche Teil.
| Benchmark | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| MKA | 53.4% | 52.0% | 43.8% |
| Chartography | 66.6% | 61.6% | 63.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
Terminal-Bench 4.1 ist in der Modellkarte als „cheating-adjusted“ gekennzeichnet. Sonnet 5.5 liegt bei Terminal-Bench 4.1 (63.9 gegenüber 57.0), OSWorld-2.1 (83.9 gegenüber 77.6) und Terminal-Bench-Science 0.1 (59.9 gegenüber 51.4) vorn. In diesen Bereichen bringt ein teureres Modell also weiterhin Vorteile. Laut Preisliste von Anthropic kostet Sonnet 5.5 2 $ für Eingaben und 10 $ für Ausgaben. Hydrogen ist damit pro Token 25% günstiger, liegt bei den meisten Werten der Modellkarte vorn und verliert bei den drei agentischsten beziehungsweise wissenschaftlichen Kategorien.
Die Werte von Carbon gehören nicht in diese Tabelle. In Carbons Modellkarte wird Terminal-Bench 4.0 mit 65.2 angegeben; in Hydrogens Modellkarte Terminal-Bench 4.1 mit 57.0. Unterschiedliche Benchmark-Versionen, unterschiedliche Vergleichsgruppen – ein gültiger Spaltenvergleich ist nicht möglich.
Googles Launch-Beitrag enthält zusätzliche Aussagen, die in der Modellkarte nicht wiederholt werden: Hydrogen erledigt Aufgaben bei seiner Standardeinstellung high „2.5-mal schneller“ als Gemini 3.8 Flash und reduziert erfundene Aussagen um „mehr als das 5-Fache“. Außerdem behauptet Google, Hydrogen belege Platz 5 in der Agent Arena, den ersten Platz im Vals Tax Agent Bench (52.3%) und teile sich den ersten Platz im Vals Legal Research Bench (55.8%). Diese Angaben stammen vom Anbieter und wurden hier nicht unabhängig reproduziert.
Preis: doppelte Token-Kosten, geringere Kosten pro Aufgabe
Der Standardpreis für Hydrogen beträgt 1,50 $ für Eingaben, 7,50 $ für Ausgaben und 0,075 $ für gecachte Eingaben. Batch und Flex kosten die Hälfte; Priority kostet 2,70 $ und 13,50 $. Der Preis bleibt über das gesamte Kontextfenster hinweg gleich.
| Modell / Tarif | Eingabe | Gecachte Eingabe | Ausgabe | Gültigkeit |
|---|---|---|---|---|
| Hydrogen Standard | $1.50 | $0.075 | $7.50 | Ab sofort |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | Ab sofort |
| Hydrogen Priority | $2.70 | $0.135 | $13.50 | Ab sofort |
| Gemini 3.8 Flash Standard | $0.75 | $0.075 | $3.75 | Bis 2026-12-31 |
| Gemini 3.8 Flash Standard | $1.50 | $0.15 | $7.50 | Ab 2027-01-01 |
| Gemini 4 Carbon / Argon | $2.00 | $0.10 | $10.00 | Bis 2026-11-30 |
| Gemini 4 Carbon / Argon | $4.00 | $0.20 | $20.00 | Ab 2026-12-01 |
Offizielle Preise in USD pro Million Token, laut Googles Preisseite, abgerufen am 2026-11-13. Für Hydrogen wurde keine künftige Preisänderung angekündigt.
Aus der Tabelle ergeben sich zwei Vergleiche. Hydrogens Preise für Eingaben und Ausgaben entsprechen exakt den Standardpreisen von Gemini 3.8 Flash ab 2027-01-01. Damit entfällt der Unterschied, dass Hydrogen „doppelt so teuer“ ist, am Neujahrstag. Gegenüber Carbon und Argon ist Hydrogen bis zum 30. November pro Token 25% günstiger und ab dem 1. Dezember, wenn sich deren Preise verdoppeln, 62.5% günstiger.
AIHubMix listet Hydrogen mit 1,50 $, 7,50 $ und 0,075 $ und entspricht damit dem Google-Standardpreis. Das kostenlose Kontingent stammt von Google, nicht vom Gateway: AIHubMix ist ein kostenpflichtiger Zugang.
Wo Hydrogen kein Upgrade ist
Die Protokolloberfläche ist eingeschränkter. Für Carbon und Argon gibt es Schema-Einträge für Chat Completions, Responses, Anthropic Messages und Gemini nativ. Im Modellindex-Snapshot vom 2026-11-11 hat Hydrogen keinen Schema-Eintrag; dokumentiert ist nur POST /v1/chat/completions. Clients für Responses im Codex-Stil und Anthropic-Clients im Claude-Code-Stil sollten nicht ohne Prüfung davon ausgehen, dass Hydrogen funktioniert.
Es ist eine kurzfristige GA-Version. Die Kündigungsfrist von 45 Tagen ist eine Einschränkung für die Planung, aber kein Grund, das Modell zu meiden. Sie ist ein Grund, die Modell-ID in der Konfiguration statt im Code abzulegen.
Einige Plattformfunktionen fehlen. Auf Googles Unternehmensseite sind Gemini Live API, RAG Engine, Tuning und ein festes Kontingent für Hydrogen als nicht unterstützt gekennzeichnet; Batch-Inferenz wird unterstützt.
Das Sicherheitsprofil ist durchwachsen. Laut Modellkarte schneidet Hydrogen bei der Textsicherheit besser ab als Gemini 3.8 Flash (+0.80pp bei Text-zu-Text, +1.10pp bei mehrsprachigen Aufgaben), weist jedoch 5.57 Prozentpunkte mehr ungerechtfertigte Ablehnungen auf – besonders bei multimodalen Prompts – und liegt beim Ton um 0.65 Punkte schlechter. Dabei handelt es sich um automatisierte Bewertungen, nicht um Red Teaming.
Carbon bleibt die Qualitätsobergrenze. Hydrogen high erreicht 51 Punkte gegenüber 60 für Carbon high, und Hydrogen xhigh liegt mit 54 immer noch sechs Punkte zurück. Bei anspruchsvollem Debugging, Architekturarbeit, wissenschaftlicher Arbeit und Sicherheitsanalysen macht das zusätzliche Denken von Carbon den Unterschied.
Die niedrigeren Stufen bieten nicht dieselbe Qualität. Hydrogen medium erreicht 41 Punkte und low 27 im AA-Index. Wer bei einer Migration den alten Standard im Grunde beibehält, indem er auf medium wechselt, büßt deutlich mehr Qualität ein, als der Token-Preis einspart.
So rufst du das Modell über AIHubMix auf
Der dokumentierte Weg führt über den OpenAI-kompatiblen Chat-Completions-Endpunkt. Auf der Modellseite sind zwei Anbieter aufgeführt: VertexAI und Google AI Studio, mit automatischem Retry.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Der Endpunkt lautet POST /v1/chat/completions. AIHubMix führt für Hydrogen Text-, Bild-, Audio-, Video- und PDF-Eingaben sowie Textausgabe auf. Angaben zu den Fähigkeiten für Reasoning, Tool-Nutzung oder strukturierte Ausgabe werden nicht veröffentlicht, und der Gemini-Leitfaden behandelt Denksteuerungen aus der Gemini-2.5-Ära statt der Stufen von Gemini 4. Gehe nicht davon aus, dass der Parameter thinking_level von Google oder der neue Wert xhigh über das Gateway weitergegeben wird. Begrenze max_tokens auf das synchrone Limit von 65,536, sofern lange Decoding-Läufe für deine Route nicht bestätigt sind. Für diesen Beitrag wurde kein Live-Test durchgeführt; das Beispiel zeigt daher das Anfrageformat und keine verifizierte Antwort.
Wer sollte jetzt wechseln?
Wechsle jetzt, wenn du Gemini 3.8 Flash nutzt und pro Token bezahlst: Laut Artificial Analysis sind die Kosten pro erledigter Aufgabe 76% niedriger, bei einem um 20 Punkte höheren Index. Außerdem bietet das kostenlose Kontingent eine kostenfreie Möglichkeit, die Qualität mit deinen eigenen Prompts zu prüfen. Wechsle, wenn dein Arbeitsaufkommen hoch ist und sich mit Chat Completions und Textausgabe bewältigen lässt, oder wenn du neben Carbon in einer Multi-Modell-Schleife ein günstigeres Ausführungsmodell möchtest.
Warte ab, wenn dein Client auf das Responses- oder Anthropic-Messages-Protokoll angewiesen ist, wenn du schwierige Aufgaben aus den Bereichen Debugging, Architektur oder Sicherheit bearbeitest, bei denen die Qualitätsobergrenze von Carbon weiterhin wichtig ist, oder wenn eine Abkündigungsfrist von 45 Tagen nicht zu deinem Release-Zyklus passt.
Teste zuerst, wenn du noch unentschlossen bist. Führe 20 bis 50 echte Anfragen mit Hydrogen high und Gemini 3.8 Flash in der Standardeinstellung aus und vergleiche die Kosten pro erledigter Aufgabe statt die Kosten pro Token. Die AIHubMix-Vergleichsseite hilft bei der Entscheidung mit Blick auf Carbon.
FAQ
Ist Hydrogen günstiger als Gemini 3.8 Flash?
Pro Token: nein. Der Preis beträgt $1.50/$7.50 gegenüber dem Einführungspreis von $0.75/$3.75. Pro erledigter Aufgabe misst Artificial Analysis $1.87 gegenüber $7.77, also etwa 76% weniger. Der Preis pro Aufgabe hängt vom Token-Verbrauch ab, nicht nur von der Preisliste.
Ist Hydrogen ein umbenanntes Gemini 3.8 Flash?
Nein. Laut Googles Modellkarte basiert Hydrogen auf Gemini 4 Carbon, und Google empfiehlt es als Upgrade von 3.8 Flash. Es bietet einen anderen Kontextpfad, eine vierte Denkstufe und eine andere Standardeinstellung.
Kann Hydrogen Bilder verarbeiten?
Ja. Googles Plattform akzeptiert Text-, Bild-, Audio-, Video-, PDF- und Office-Dateien. Auf der Modellseite von AIHubMix sind Text-, Bild-, Audio-, Video- und PDF-Eingaben mit Textausgabe aufgeführt; Office- und OpenDocument-Dateien werden dort nicht genannt.
Ist das kostenlose Kontingent bei AIHubMix verfügbar?
Nein. Das kostenlose Kontingent stammt von Google und ist in AI Studio und der Gemini API verfügbar. AIHubMix ist ein kostenpflichtiger Zugang für $1.50/$7.50.
Was ist die standardmäßige Denkstufe?
high. Bei Gemini 3.8 Flash war medium die Standardeinstellung; Hydrogen ergänzt oberhalb von high die Stufe xhigh.
Ist Hydrogen besser als Carbon?
Nein. Carbon high erreicht im AA-Index 60 Punkte gegenüber 51 für Hydrogen high und 54 für xhigh und ist pro Aufgabe teurer. Hydrogen ist das günstigere Ausführungsmodell, nicht das Spitzenmodell.
Kann ich die Denkstufe über AIHubMix festlegen?
Laut Dokumentation nicht. AIHubMix veröffentlicht für Hydrogen keine Angabe zu Reasoning-Fähigkeiten, und der Gemini-Leitfaden behandelt die Stufen von Gemini 4 nicht. Prüfe es, bevor du dich darauf verlässt.
Weiterlesen: die Gemini-4-Hydrogen-Serie
- Wenn du wissen möchtest, welche Denkstufe du verwenden solltest, misst der nächste Beitrag alle vier Stufen anhand desselben Index und zeigt, ab wann sich die nächste Stufe nicht mehr lohnt: Gemini 4 Hydrogen: Denkstufen low, medium, high und xhigh.
- Wenn du wissen möchtest, ob du Hydrogen neben Carbon oder Argon einsetzen solltest, vergleicht der dritte Beitrag die drei Modelle anhand von Preisen, Latenz und einer Tabelle zu den jeweiligen Einsatzgebieten: Gemini 4 Carbon vs. Hydrogen vs. Argon: Welches Modell für welchen Job?.
Quellen
- Google, Wir stellen Gemini 4 Hydrogen vor
- Google AI Studio, Gemini 4 Hydrogen: Was ist neu?
- Google DeepMind, Modellkarte zu Gemini 4 Hydrogen
- AIHubMix, Gemini 4 Hydrogen
- Artificial Analysis, Gemini 4 Hydrogen — Live-Snapshot 2026-11-13T02:40Z, Intelligence Index v5.0.1


