Gemini 4 Carbon ist keine neue Modellfamilie. Es ist Gemini 4 Argon mit mehr Denkaufwand pro Durchgang, zum gleichen Preis pro Token: 2 $ pro Million Eingabe-Tokens und 10 $ pro Million Ausgabe-Tokens zu Einführungspreisen bis zum 30. November 2026, danach 4 $ und 20 $ ab dem 1. Dezember. Die Frage ist nicht, welches Modell pro Token günstiger ist. Sie kosten gleich viel. Entscheidend ist, ob der zusätzliche Denkaufwand pro abgeschlossener Aufgabe genug bringt, um eine langsamere erste Antwort zu rechtfertigen.
Die aktuellen Zahlen von Artificial Analysis liefern eine klare Antwort für eine Art von Arbeit – und eine ebenso klare Warnung für eine andere. Carbon High liegt mit 60.03 auf Platz 4 von 104 im AA Intelligence Index, gegenüber 50.41 für Argon High. Die Kosten pro Aufgabe betragen 7.76 $ statt 9.95 $, und die Aufgabe ist in 25.6 statt 29.0 Minuten abgeschlossen. Doch bis zum ersten Antwort-Token vergehen bei Carbon 67.1 Sekunden, bei Argon 40.1. Carbon ist das bessere Modell für eine Warteschlange. Argon ist das bessere Modell für ein Gespräch.
Darum geht es in diesem Beitrag. Im Folgenden: Was sich geändert hat, was die Messwerte aussagen, was Googles Model Card ergänzt, wie sich der Preis am 1. Dezember ändert und welche Workloads bei Argon bleiben sollten.
Was sich gegenüber Argon geändert hat
Googles Model Card beschreibt die Beziehung eindeutig: „Gemini 4 Carbon basiert auf Gemini 4 Argon.“ Die Modell-ID lautet gemini-4-carbon – auch bei AIHubMix. Google dokumentiert ein Kontextfenster mit 1,048,576 Tokens. Als Denkstufen gibt es Low, Medium und High; Medium ist die Standardeinstellung. Die Standardausgabe umfasst 65,536 Tokens. Über Googles nativen Pfad für lange Dekodierung sind bis zu 1,048,576 Tokens abzüglich der Eingabe möglich; 131,072 und 262,144 werden als Beispiele genannt. AIHubMix dokumentiert derzeit nur Chat Completions. Halten Sie Gateway-Anfragen daher bei höchstens 65,536 Tokens, bis ein größerer Pfad dokumentiert ist. Der Wissensstand reicht bis März 2026. Google bietet das Modell nicht im kostenlosen Kontingent an.
Die Änderung wird in Googles AI-Studio-Hinweisen so beschrieben: „Carbon verwendet pro Durchgang mehr Denk-Tokens, um gründlich zu prüfen und seine Arbeit zu verifizieren. Dadurch steigen im Vergleich zu Argon der Tokenverbrauch und die Latenz pro Durchgang.“ Dieser Satz erklärt fast alle Unterschiede, um die es im weiteren Verlauf geht. Mehr Denkaufwand erhöht die Leistungsspitze bei schwierigen Aufgaben, steigert die Kosten pro Durchgang und verlängert die Wartezeit bis zum ersten Token.
Die Migration ist bewusst unkompliziert. „Für ein Upgrade von Argon sind keine Änderungen am Anfrage-Schema nötig.“ Auf API-Ebene genügt es, den Modellnamen auszutauschen. Google empfiehlt: „Lassen Sie thinking_level auf medium (Standard), sofern ein Workload nicht high benötigt, und achten Sie darauf, dass max_output_tokens und HTTP-Timeouts längere Reasoning-Durchläufe zulassen.“
Der gemessene Kompromiss: mehr Denkaufwand, geringere Kosten pro Aufgabe
Die folgenden Zahlen stammen aus den aktuellen Messungen von Artificial Analysis, abgerufen am 2026-11-11T05:23Z (Modellseiten um 06:01Z erneut geprüft, unverändert), bei Standardpreisen von 4 $ pro Million Eingabe-Tokens und 20 $ pro Million Ausgabe-Tokens.
Der aussagekräftige Vergleich setzt Qualität zu den Kosten pro abgeschlossener Aufgabe ins Verhältnis: Steigt Carbon im Index, während die Rechnung sinkt? Das Diagramm zeigt die vier Modellkonfigurationen getrennt.
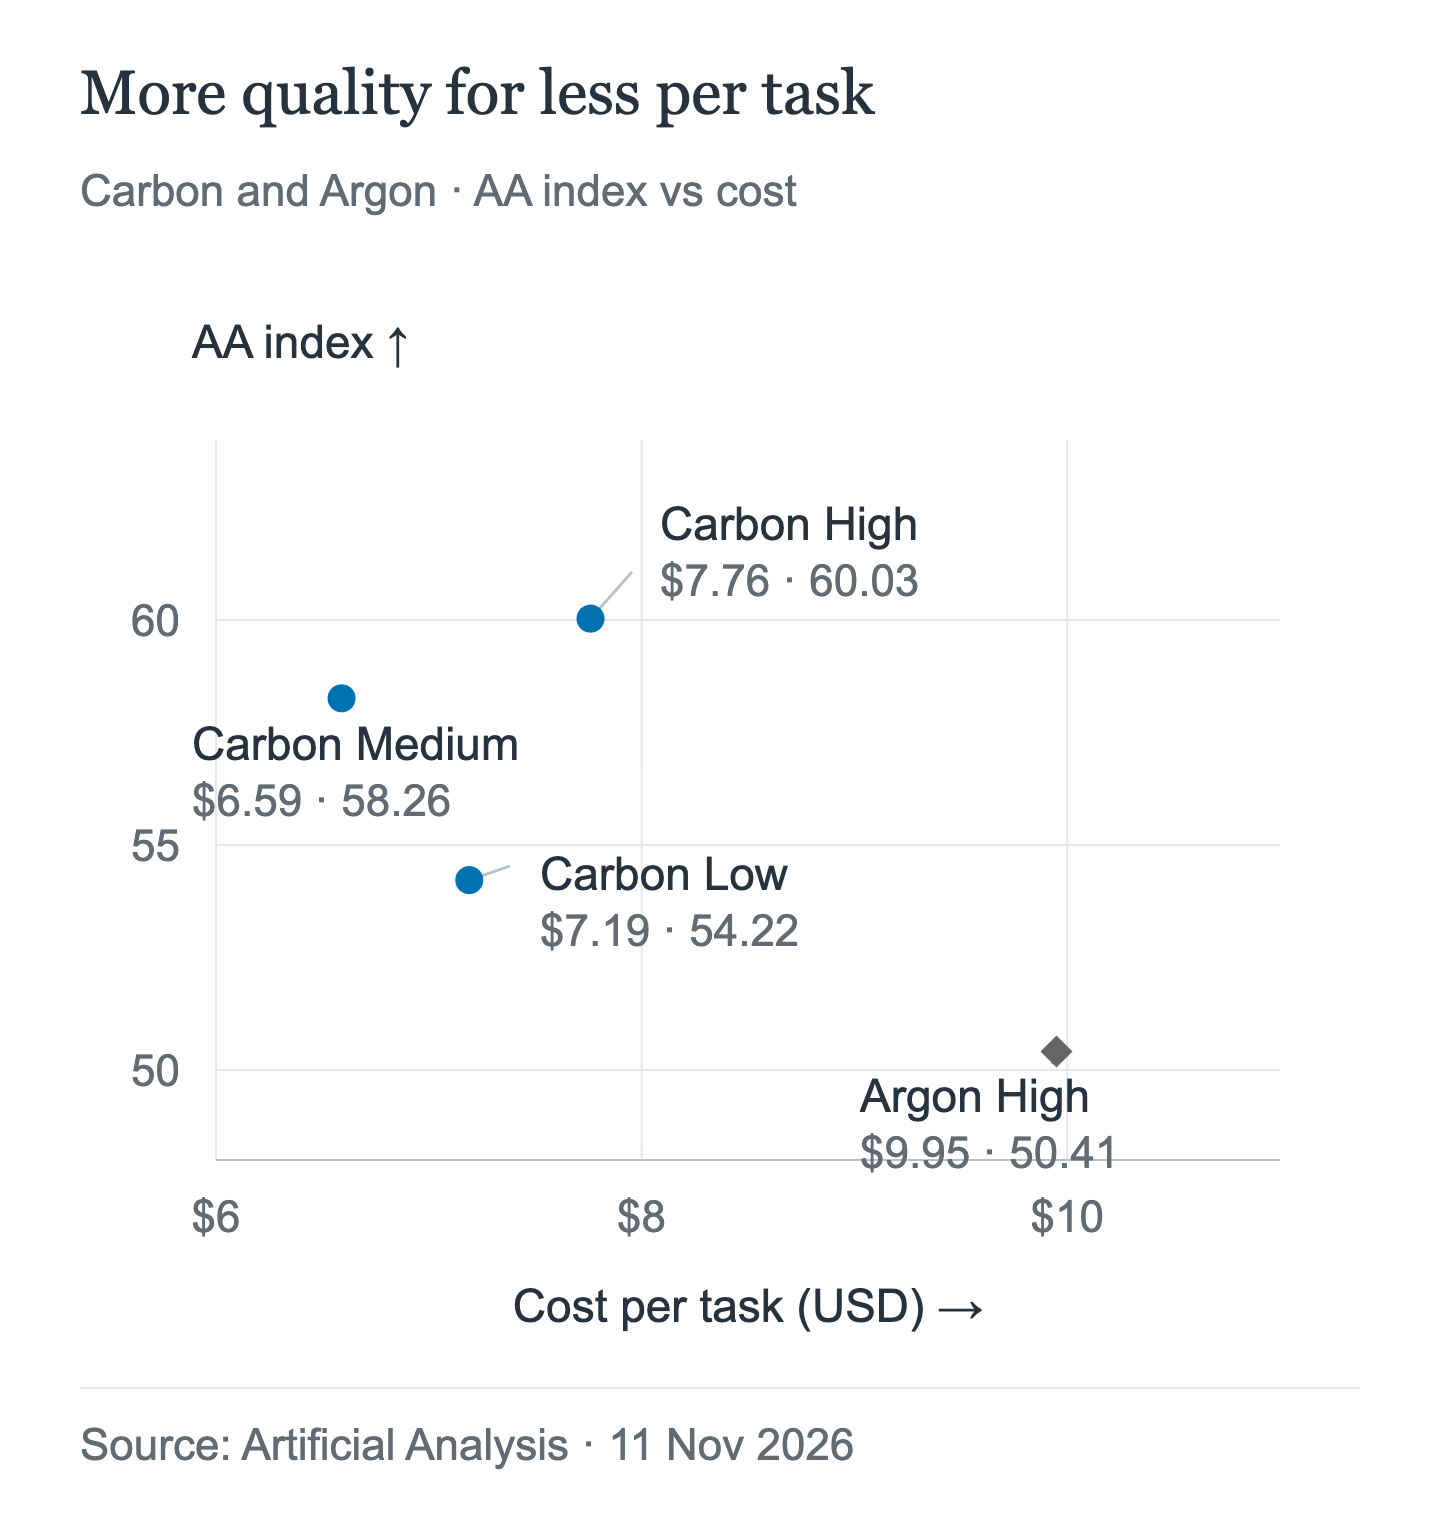
Carbon High liegt über und links von Argon High. In diesem Durchlauf ist Medium die günstigste Carbon-Einstellung; Low ist eine Wahl zugunsten der Latenz, nicht der niedrigsten Kosten. Es handelt sich um AA-Kosten pro Aufgabe zu Standardpreisen, nicht um Rechnungsbeträge für AIHubMix-Anfragen.
| Modell | AA-Index | $ pro Aufgabe | Min. pro Aufgabe | Erster Token | Ausgabe-Tokens/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium und Low belegen Platz 4, 6 und 14 von 104; Argon High liegt dahinter. Bei allen drei Einträgen vor Carbon High handelt es sich um Konfigurationen von Claude Fable 5.2. „Erster Token“ bezeichnet die Zeit bis zum ersten Antwort-Token. Carbon High im Vergleich zu Argon High: +9.62 Indexpunkte, 22.0% geringere Kosten pro Aufgabe und 25.6 statt 29.0 Minuten – aber 67.1 statt 40.1 Sekunden bis zum ersten Antwort-Token.
Der Abstand im Index ist groß genug, um die Position in einer Rangliste zu verändern. Der Latenzunterschied ist groß genug, um zu verändern, ob jemand wartet. Beide Aussagen beruhen auf derselben Zeile.
Artificial Analysis bezeichnet Carbon als „bemerkenswert langsam pro Aufgabe und sehr ausführlich“ und berichtet, dass das Modell beim Berechnen des Index 205 Millionen Tokens erzeugt hat, gegenüber 113 Millionen bei Argon und einem Median von 72.8 Millionen über alle gemessenen Modelle hinweg. In diesem AA-Durchlauf gehen deutlich höhere Ausgabemengen mit geringeren Kosten pro Aufgabe einher: gleicher Listenpreis, viel mehr Tokens und niedrigere Gesamtkosten pro Aufgabe.
Eine Anomalie verdient einen eigenen Satz. Carbon Low kostet 7.19 $ pro Aufgabe und damit mehr als Medium mit 6.59 $, obwohl es weniger Denkaufwand erfordert. Was auch immer der Grund ist: Low verhält sich wie eine Latenzoption, nicht wie eine Sparoption. Messen Sie daher die Kosten pro Aufgabe, bevor Sie ein größeres Anfragevolumen dorthin leiten.
Die Perspektive eines Coding-Agenten
Der Intelligence Index mittelt zahlreiche Aufgaben. Der Coding Agent Index v2 bildet besser ab, was API-Kunden einsetzen: einen Coding-Agenten mit Tools, durchgängig auf demselben Test-Framework gemessen. Carbon High belegt Platz 4, Argon High Platz 11.
| Rang | Agent + Modell | Index | $ pro Aufgabe | Min. pro Aufgabe | Cache-Treffer |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Gleicher Agent, dasselbe Test-Framework, anderes Modell – so isoliert der Vergleich das Modell und nicht das Setup. Carbon kostet pro Aufgabe 34.0% weniger, erzielt +6.2 Indexpunkte und ist 4.9 Minuten schneller. Die Ausgabemenge pro Aufgabe ist nahezu identisch: 109,031 Tokens gegenüber 109,236. Die Cache-Trefferquote ist höher, 0.95 gegenüber 0.87, und der Eingabeverbrauch niedriger: 12.44 Millionen Tokens gegenüber 13.76 Millionen.
Zwei Vorbehalte: Carbon liegt in diesem Index auf Platz 4. An der Spitze steht Claude Code mit Opus 5.5 Max und 61.7, gefolgt von Devin Fusion CLI und GitHub Copilot Fusion. Außerdem ist Fable 5.2 im Index gar nicht vertreten. Die Tabelle beantwortet daher nicht die Frage, wie Carbon im Vergleich zu Fable abschneidet.
Was Googles Model Card ergänzt – und was nicht
Googles Model Card ist ein Dokument des Anbieters: Die Ergebnisse stammen aus dem Oktober 2026, sind vom Anbieter selbst gemeldet und zeigen einen anderen Stand als die aktuellen Daten oben. In jeder der folgenden Zeilen liegt Googles Wert für Carbon höher.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (Anbieterangabe) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
Der AA-Wert von Google ist auf 59 gerundet und nicht der aktuelle Wert 60.03 aus der vorherigen Tabelle. Die beiden Zahlen stammen aus unterschiedlichen Momentaufnahmen und sollten nicht vermischt werden. Der externe Vergleich in der Model Card bezieht sich auf Fable 5.1, nicht auf Fable 5.2.
Nützlich ist die Beständigkeit des Ergebnisses: Der Vorteil zeigt sich nicht nur bei einem Benchmark. Auch die Grenzen sind klar. Eine Model Card des Anbieters nennt weder die Kosten pro Aufgabe noch die Latenz bis zum ersten Token oder die Anzahl der Durchgänge eines Agenten. Sie stützt die Aussage „Carbon ist im Durchschnitt das leistungsfähigere Modell“, nicht aber „Carbon ist das bessere Modell für Ihren Ablauf“.
Preis: dieselbe Preisliste, dieselbe Änderung am 1. Dezember
Bei Carbon und Argon stimmen alle Preiszeilen überein. Für beide gelten die Einführungspreise bis zum 30. November 2026; ab dem 1. Dezember verdoppeln sich die Preise.
| Modell | Eingabe | Ausgabe | Gecachter Lesezugriff |
|---|---|---|---|
| Carbon, Einführungspreis (bis 30. Nov.) | $2.00 | $10.00 | $0.10 |
| Carbon, ab 1. Dez. | $4.00 | $20.00 | $0.20 |
| Argon, Einführungspreis (bis 30. Nov.) | $2.00 | $10.00 | $0.10 |
| Argon, ab 1. Dez. | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Offizielle Preise in USD pro Million Tokens, Stand: 11. November 2026. Gemini 3.1 Pro Preview kostet oberhalb von 200k Prompt-Tokens 4 $/18 $/0.40 $, zuzüglich 4.50 $ pro Million Tokens und Stunde Speicherzeit. Schreibvorgänge in den Fable-5.2-Cache kosten 10 $ für fünf Minuten oder 16 $ für eine Stunde; der Batch-Preis ist um 50% reduziert. Die Einführungspreise für Carbon und Argon enden am 30. November; ab dem 1. Dezember verdoppeln sich alle Preise für Carbon und Argon.
AIHubMix listet Carbon für 2 $/10 $/0.10 $ und entspricht damit den Einführungspreisen von Google. Dieser Beitrag geht nicht davon aus, welche Preise das Gateway nach dem 30. November berechnet. Prüfen Sie den aktuellen Preis auf der Modellseite.
Wenn man die von Artificial Analysis gemessenen Tokenzahlen mit den Einführungspreisen neu berechnet, ergeben sich grobe Schätzwerte pro Aufgabe von 3.88 $ für Carbon High, 3.30 $ für Medium, 3.60 $ für Low und 4.98 $ für Argon High. Das sind berechnete Schätzungen, keine Messwerte von AA: Die Rechnung geht davon aus, dass der Token-Mix jeder Aufgabe gleich bleibt. Ihre Prompts und Ihre Cache-Trefferquote verändern das Ergebnis.
Pro Token kostet Fable 5.2 zu Standardpreisen doppelt so viel wie Carbon und zu Einführungspreisen viermal so viel. Das ist ein Preisunterschied, kein Qualitätsurteil; der dritte Beitrag der Reihe behandelt den Vergleich.
Wann Carbon nicht die bessere Wahl ist
Das Argument gegen Carbon lautet nicht, dass es schlechter ist. Vielmehr kann ein interaktives Produkt sich genau das nicht leisten, was Carbon bietet: mehr Denkaufwand pro Durchgang.
Der erste Token lässt auf sich warten. Bei Carbon High vergehen 67.1 Sekunden bis zum ersten Antwort-Token, bei Argon High 40.1. Medium verkürzt die Wartezeit auf 23.2 Sekunden und Low auf 12.9, gibt dafür aber Indexpunkte ab. Eine Chat-Oberfläche, die eine Minute lang pausiert, hat den Nutzer für diesen Durchgang bereits verloren – ganz gleich, wie die Antwort am Ende ausfällt.
Google empfiehlt Argon, wenn Geschwindigkeit zählt. Argon ist für „schnellere Antworten und einen geringeren Tokenverbrauch pro Durchgang“ bei „interaktivem Coding, alltäglicher Feature-Arbeit und schnellen Produktionsschleifen“ vorgesehen. Die Empfehlung in den Migrationshinweisen ist eindeutig: „Behalten Sie Argon bei, wenn Geschwindigkeit wichtig ist.“ Auch Googles Ankündigungsbeitrag betont: „Argon bleibt für den Großteil der Softwareentwicklung und Wissensarbeit die ideale Wahl.“
Die Ausgaben pro Durchgang sind höher, auch wenn die Kosten pro Aufgabe niedriger liegen. Der Preis pro Token ist gleich, doch Carbon verwendet pro Durchgang mehr Denk-Tokens. Für ein Team, das den Tokenverbrauch pro Durchgang überwacht oder ein Token-Kontingent rationiert, wirkt Carbon wie das teurere Modell. Der Lauf des Index mit 205 Millionen Tokens gegenüber 113 Millionen bei Argon zeigt diesen Effekt im Extrem.
Low ist nicht die günstige Option. Mit 7.19 $ pro Aufgabe kostet Carbon Low mehr als Medium mit 6.59 $. Wenn die Kosten pro abgeschlossener Aufgabe das Routing-Kriterium sind, fällt Low durch.
Benchmark-Siege machen verlorene Zeit nicht wett. OSWorld-2.1 und FrontierSWE 2 sprechen in Googles Tabelle beide für Carbon. Doch die Werte stammen vom Anbieter, und an der Wartezeit bis zum ersten Token ändern sie nichts. Benchmarks messen das Ergebnis; Nutzer erleben den Anfang.
Wer sollte jetzt wechseln – und wer bei Argon bleiben?
Wechsle jetzt zu Carbon, wenn du anbietereigene Batch- oder Agent-Jobs im Hintergrund ausführst (diese Möglichkeiten sind für Carbon auf AIHubMix nicht dokumentiert), wenn ein Qualitätsfehler mehr kostet als zusätzliche Laufzeit, wenn deine Anfragen längere Timeouts und ein höheres Ausgabebudget verkraften oder wenn du bereits für Wiederholungsversuche zahlst, die Carbon möglicherweise vermeiden könnte.
Bleib bei Argon, wenn du Chat, Autovervollständigung oder eine Schleife entwickelst, bei der ein Mensch wartet; wenn dein Budget oder Kontingent pro Durchlauf berechnet wird; oder wenn eine Latenz von unter etwa 30 Sekunden zum Produkt gehört.
Teste zuerst, wenn du dazwischenliegst. Schicke dieselben 20 bis 50 echten Anfragen durch beide Modelle, erfasse die Zeit bis zum ersten Token und die Kosten pro abgeschlossener Aufgabe und entscheide danach statt anhand des Index. Auf der Vergleichsseite von AIHubMix werden die beiden Modellseiten nebeneinander angezeigt.
So rufst du das Modell über AIHubMix auf
Carbon verwendet auf AIHubMix dasselbe Modell-ID-Muster und denselben dokumentierten Chat-Completions-Endpunkt.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Der Endpunkt lautet POST /v1/chat/completions; dies ist die einzige Route, die AIHubMix für dieses Modell dokumentiert. Text ist die aufgeführte Eingabemodalität. Bildeingaben und PDF-Eingaben, die Responses API, Anthropic Messages und der native Gemini-Endpunkt sind für Carbon auf AIHubMix nicht dokumentiert und sollten daher als unbestätigt gelten. Dasselbe gilt für die Zuordnung von reasoning_effort: Geh nicht davon aus, dass das Gateway einen Denkstufen-Parameter weiterleitet. Halte max_tokens innerhalb des standardmäßigen Ausgabelimits von 65,536; die höheren Limits erfordern Googles Hintergrundmodus und sind auf AIHubMix nicht bestätigt. Für diesen Beitrag wurde kein Live-Test durchgeführt. Das Beispiel zeigt daher die Form der Anfrage und keine verifizierte Antwort.
Häufig gestellte Fragen
Kostet Carbon genauso viel wie Argon?
Ja. Die offiziellen Preise von Google sind identisch: bis zum 30. November 2026 2 $ pro Million Eingabe-Tokens und 10 $ pro Million Ausgabe-Tokens, danach 4 $ und 20 $. Für Cache-Lesevorgänge sind es zunächst 0,10 $ und anschließend 0,20 $.
Ist Carbon besser als Argon?
Bei Qualität und Kosten pro abgeschlossener Aufgabe ja, laut den Messungen von Artificial Analysis: 60.03 gegenüber 50.41 im Intelligence Index und 7,76 $ gegenüber 9,95 $ pro Aufgabe. Bei der Reaktionsgeschwindigkeit nein: Bis zum ersten Antwort-Token vergehen 67,1 Sekunden statt 40,1.
Warum ist Carbon langsamer, wenn es Aufgaben schneller abschließt?
Carbon wartet länger, bevor es antwortet, schließt dann aber die gesamte Aufgabe schneller ab: in 25,6 statt 29,0 Minuten. Die Wartezeit bis zum ersten Token und die Gesamtzeit für die Aufgabe sind unterschiedliche Messwerte und weisen in entgegengesetzte Richtungen.
Müssen die Anfragen geändert werden?
Nein. Laut Google ist beim Upgrade von Argon keine Änderung am Schema erforderlich; der Modell-String wird zu gemini-4-carbon. Erhöhe das Ausgabelimit und das HTTP-Timeout, damit längere Denkprozesse abgedeckt sind.
Warum kostet Carbon Low pro Aufgabe mehr als Medium?
Artificial Analysis hat für Low 7,19 $ gegenüber 6,59 $ für Medium gemessen. Betrachte Low als Latenzeinstellung, nicht als Rabattoption, und ermittle die Kosten pro Aufgabe, bevor du größere Mengen darüber laufen lässt.
Welchen Rang belegt Carbon bei Artificial Analysis?
Carbon liegt auf Platz 4 im Intelligence Index, hinter drei Konfigurationen von Claude Fable 5.2. Googles Model Card weist für denselben Index einen gerundeten Wert von 59 aus; der aktuelle Wert beträgt 60.03. Diese Angaben sollten nicht miteinander vermischt werden.
Ist Carbon im kostenlosen Kontingent verfügbar?
Nein. Google bietet Gemini 4 Carbon nicht im kostenlosen Kontingent an. Der Zugriff ist daher über die kostenpflichtige API-Preisgestaltung oder ein Gateway wie AIHubMix möglich.
Weiterlesen: die Gemini 4 Carbon-Reihe
- Wenn dich dieser Beitrag dazu überzeugt hat, Carbon auszuprobieren, aber deine erste Anfrage fehlgeschlagen ist, behandelt der Migrationsleitfaden die 400-Fehler, Timeout-Einstellungen und Ausgabelimits, die sich bei längeren Denkphasen ändern: Gemini 4 Carbon API-Migration: 400-Fehler, Timeouts und Ausgabelimits.
- Wenn du dich fragst, ob Carbon für agentisches Programmieren leistungsfähig genug ist oder ob sich der Aufpreis für Fable 5.2 lohnt, stellt der dritte Beitrag dieselben Messwerte Fable 5.2 gegenüber: Gemini 4 Carbon vs. Fable 5.2: Welches Modell für agentisches Programmieren?.
Quellen
- Google AI Studio, Gemini 4 Carbon: Was ist neu?
- Google DeepMind, Gemini 4 Carbon Model Card
- Google AI Studio, Gemini API-Preise
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon