

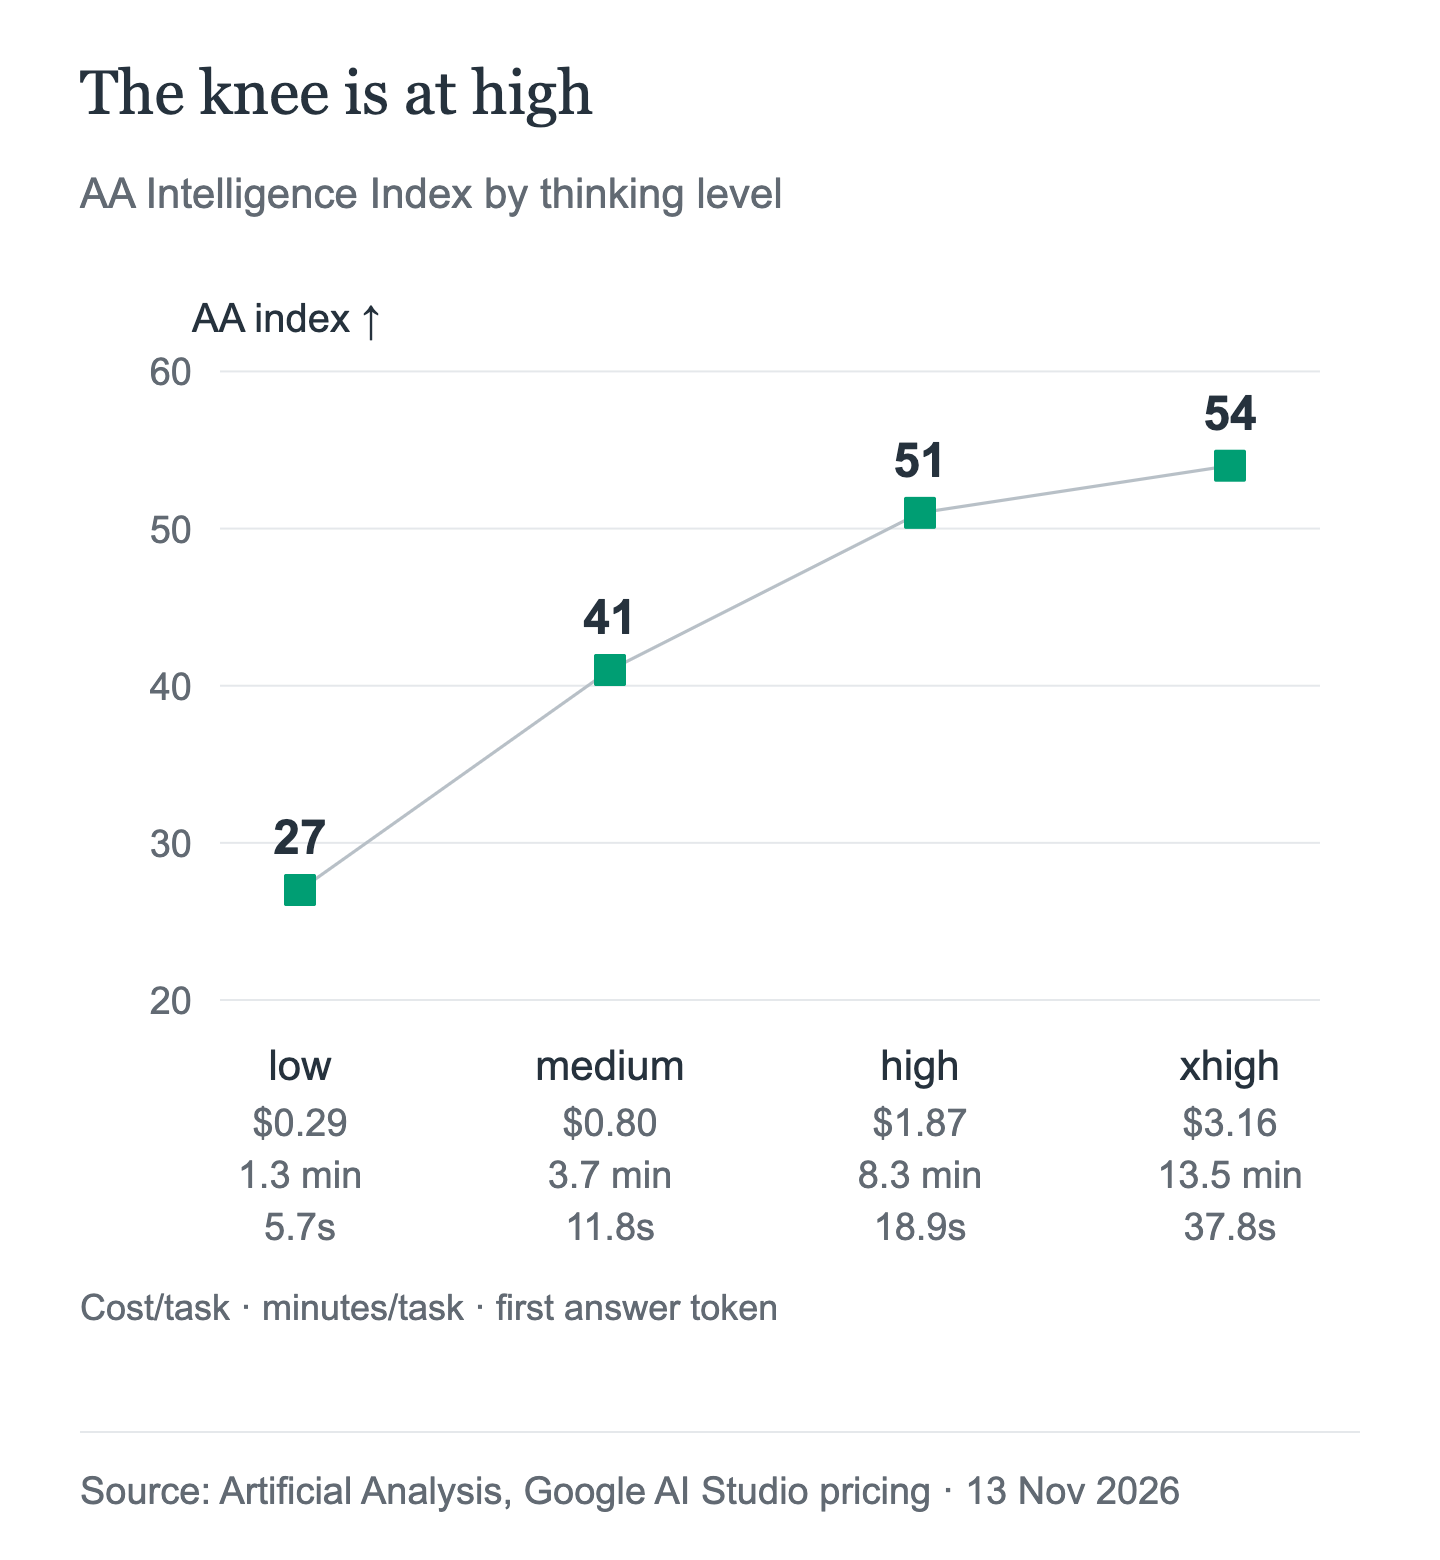
Gemini 4 Hydrogen hat vier Denkstufen, die sich wie vier verschiedene Modelle verhalten. In den Live-Messungen von Artificial Analysis erreicht dasselbe Modell bei low einen Wert von 27, bei medium 41, bei high 51 und bei xhigh 54. Standardmäßig ist high eingestellt. xhigh ist neu in der Gemini-4-Familie: Carbon und Argon gehen nur bis high.
Die Unterschiede sind groß: Zwischen low und xhigh liegen beim selben Modell 27 Indexpunkte. Der Wechsel von medium zu high bringt 10 Indexpunkte und kostet pro Aufgabe etwa 1,07 $ mehr. Der Wechsel von high zu xhigh bringt 3 Punkte für 1,29 $ und lässt die Wartezeit auf das erste Antwort-Token nahezu doppelt so lang werden. Die praktische Empfehlung: mit high beginnen, xhigh für schwierige Aufgaben mit mehreren Schritten reservieren und low sowie medium als Latenzeinstellungen betrachten, deren Qualität separat geprüft werden muss.
Im Folgenden geht es darum, wofür die einzelnen Stufen gedacht sind, was sie kosten, was sich an der API ändert und was AIHubMix dokumentiert – und was nicht.
Die vier Stufen und die Änderungen
Gemini 4 Hydrogen unterstützt low, medium, high und xhigh. Googles Versionshinweise bringen es auf den Punkt: „Standardmäßig ist high eingestellt, und xhigh wird neu eingeführt.“ Das sind zwei Änderungen gegenüber Gemini 3.8 Flash, bei dem standardmäßig medium eingestellt ist und das nur bis high geht.
Beim Rest der Familie hat sich nichts geändert. Carbon und Argon unterstützen low, medium und high, wobei medium die Standardeinstellung ist. Hydrogen ist das einzige Gemini-4-Modell mit einer Einstellung oberhalb von high.
| Modell | Stufen | Standard |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL gehört nicht dazu. In der Dokumentation zu Gemini-4-Denkstufen heißt es, MINIMAL werde „bei Gemini-4-Modellen nicht unterstützt“, und Googles Versionshinweise zu Hydrogen besagen, dass das Modell „minimal mit einem Fehler zurückweist“. Für dieses Modell ist keine dokumentierte Möglichkeit vorgesehen, den Denkmodus auszuschalten.
Was Google empfiehlt
Googles Empfehlungen sind ein sinnvoller erster Anhaltspunkt, wurden jedoch vor den weiter unten aufgeführten Messungen verfasst. Insbesondere setzt die Empfehlung von medium für interaktives Programmieren ein Qualitätsniveau voraus, das Artificial Analysis bei medium nicht feststellt.
| Stufe | Beschreibung und empfohlene Verwendung von Google |
|---|---|
| low | „Weniger Tokens, niedrigste Latenz“ – schnelle Chats, hohes Volumen |
| medium | „Weniger Tokens, schnellere Antworten“ – interaktives Programmieren, UI-Prototypen |
| high | „Ausgewogenes Verhältnis zwischen Intelligenz und Geschwindigkeit“ – Standard für die meisten Aufgaben |
| xhigh | „Am meisten Tokens, tiefgründigstes Schlussfolgern“ – schwierige Programmieraufgaben mit mehreren Schritten |
Bei dieser Tabelle sind zwei Hinweise zu beachten. „Die Verwendung von xhigh erhöht die Latenz und den Token-Verbrauch und kann bei einfacheren Prompts zu übermäßigem Nachdenken führen“, so Google. Auch die Empfehlung zur Evaluierung ist eindeutig: „Führen Sie Ihre Evaluierungen mit einem hohen Wert für max_output_tokens auf allen vier Stufen durch.“
Die gemessene Abstufung
Artificial Analysis hat alle vier Stufen gemessen. Verwendet wurde Intelligence Index v5.0.1 mit 78 gerankten Modellen, abgerufen am 2026-11-13T02:40Z, zu den regulären Listenpreisen. Das sind Aufgabenkosten von AA, keine Rechnungsbeträge von AIHubMix.
| Stufe | AA-Rang | AA-Index | $/Aufgabe | Min./Aufgabe | Erstes Antwort-Token |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Besonders aufschlussreich sind die Unterschiede zwischen den Stufen:
lowbismedium: +14 Indexpunkte, +$0.51 pro Aufgabe, +2.4 Minuten, +6.1 Sekunden bis zum ersten Token.mediumbishigh: +10 Indexpunkte, +$1.07 pro Aufgabe, +4.6 Minuten, +7.1 Sekunden bis zum ersten Token.highbisxhigh: +3 Indexpunkte, +$1.29 pro Aufgabe, +5.2 Minuten, +18.9 Sekunden bis zum ersten Token.
high ist der Knickpunkt. Hier ist der Qualitätszuwachs im Verhältnis zu den zusätzlichen Kosten zum letzten Mal groß; bei xhigh verdoppelt sich die Wartezeit auf das erste Token nahezu, während der Index nur geringfügig steigt. Das macht xhigh nicht zu einer schlechten Einstellung. Es ist vielmehr eine Einstellung für Aufgaben, bei denen high versagt – genau so beschreibt Google sie.
Zum Vergleich: Im selben Snapshot erzielt Carbon high einen Wert von 60 bei 5,48 $ pro Aufgabe und 28,1 Minuten, Carbon medium 58 bei 4,68 $, Carbon low 54 bei 5,22 $ und Argon high 50 bei 4,97 $ und 30,6 Minuten. Hydrogen xhigh erreicht mit 54 denselben Wert wie Carbon low, bei 39.5% geringeren Kosten pro Aufgabe (3,16 $ gegenüber 5,22 $); das erste Token braucht allerdings 37.77 Sekunden statt 13.61. Hydrogen high übertrifft Argon high um einen Indexpunkt und kostet pro Aufgabe 62.4% weniger.
Wo die Abstufung an ihre Grenzen stößt
low ist keine geringfügige Herabstufung. Mit 27 liegt die Stufe 24 Indexpunkte unter high. Wer eine Arbeitslast von high auf low umstellt, um 1,58 $ pro Aufgabe zu sparen, erhält nicht dasselbe Produkt mit weniger Denkaufwand, sondern ein deutlich schwächeres Modell. Für Klassifizierung, Routing oder kurze Informationsextraktion kann das passen. Für Programmier- oder Agentenaufgaben ist es ohne aufgabenspezifische Evaluierung keine gute Wahl.
medium ist eine Latenz-, keine Qualitätseinstellung. Die Stufe erreicht einen Wert von 41 – 10 Punkte weniger als high – und kostet 0,80 $ statt 1,87 $. Die Einsparung ist beachtlich: 57% pro Aufgabe. Doch der Qualitätsabstand ist größer, als der Preisunterschied vermuten lässt. Google empfiehlt medium für interaktives Programmieren; der AA-Wert legt nahe, diese Empfehlung vor der Übernahme anhand eigener Aufgaben zu prüfen.
xhigh kann übermäßig nachdenken. Google warnt ausdrücklich davor. Die Kosten- und Zeitangaben von AA zeigen die Auswirkungen: 3,16 $ pro Aufgabe, 13,5 Minuten und eine Wartezeit von 37.77 Sekunden bis zum ersten Token. Für einen einfachen Prompt ist das eine lange Latenz für einen geringen Zugewinn. Bei einer schwierigen Programmieraufgabe mit mehreren Schritten, an der high scheitert, ist dies die einzige Stufe, die noch weiter geht.
Ausführlichkeit schlägt sich in den Kosten nieder. Artificial Analysis beschreibt Hydrogen als „sehr ausführlich“: Beim xhigh-Durchlauf wurden zur Berechnung des Index 304 Millionen Output-Tokens erzeugt – Rang #76 von 77 –, gegenüber einem Median von 72.8 Millionen. Zu den Output-Tokens zählen auch Tokens für den Denkprozess, und die Ausgabe kostet 7,50 $ pro Million. Eine höhere Stufe denkt nicht nur länger, sondern erzeugt auch mehr kostenpflichtige Tokens.
Die Kosten: Wie Denkprozesse zu Tokens werden
Die Preisliste ist einfach: Hydrogen kostet 1,50 $ pro Million Input-Tokens, 7,50 $ pro Million Output-Tokens und 0,075 $ pro Million zwischengespeicherter Input-Tokens. Zu den Output-Tokens zählen auch Tokens für den Denkprozess. Deshalb ist die Stufe wichtiger als der Tarif: Abgerechnet werden die vom Modell ausgegebenen Tokens fürs Schlussfolgern, nicht der Name der Stufe.
Drei Abrechnungsregeln übersieht man leicht.
Die Standardeinstellung hat sich geändert. Bei Gemini 3.8 Flash war standardmäßig medium eingestellt, bei Hydrogen ist es high. Eine Arbeitslast, bei der nie eine Stufe festgelegt wurde, verbraucht nach der Migration pro Durchlauf mehr Output-Tokens – selbst wenn der Preis pro Token gleich bleibt. So verbirgt sich eine Budgetänderung hinter einem Modellwechsel.
Nur implizites Caching wird unterstützt. Hydrogen unterstützt implizites Caching mit einem Minimum von 4,096 Tokens und einem Rabatt von 95% bei Cache-Treffern; explizites Caching wird nicht unterstützt. Auf Googles Enterprise-Seite steht außerdem: „Cache-Schreibvorgänge werden standardmäßig mit dem 1,25-Fachen des regulären Preises für Input-Tokens abgerechnet.“ Das ist Googles Formulierung zur Abrechnung; die Abrechnung von Caches bei AIHubMix ist für dieses Modell nicht dokumentiert.
Für lange Ausgaben gilt eine Höchstgrenze pro Durchlauf. Eine synchrone Anfrage erzeugt pro Durchlauf bis zu 65,536 Tokens – unabhängig davon, ob Streaming verwendet wird. Für längere Ausgaben sind eine Ausführung im Hintergrund oder Fortsetzungstokens erforderlich. Außerdem begrenzt max_output_tokens die kombinierte Anzahl der Denk- und Output-Tokens. Wenn Sie background=true ohne max_output_tokens festlegen, beendet der Server die Ausgabe nach 65,536 Tokens. Google empfiehlt für lange Decodes Budgets von 131,072 oder 262,144, bis maximal 1,048,576 abzüglich der Eingabe.
Was die API unterstützt und zurückweist
Der Parameter heißt thinking_level (snake_case). Googles Python-Beispiel setzt ihn innerhalb von thinking_config; im Node-Beispiel ist er unter thinkingConfig verschachtelt (camelCase). Auf der Modellseite sind die Werte als LOW, MEDIUM, HIGH und XHIGH aufgeführt; in den Versionshinweisen stehen sie kleingeschrieben. Verwenden Sie den Enum-Wert oder die dokumentierte Zeichenfolge Ihres SDKs, statt eine Variante mit selbst gewählter Groß- und Kleinschreibung einzugeben.
Drei Arten von Anfragen schlagen fehl:
thinking_budgetbei einem beliebigen Gemini-4-Modell führt zu400: INVALID_ARGUMENT. Werden sowohlthinking_levelals auchthinking_budgetfestgelegt, tritt ebenfalls ein Fehler auf.thinking_level="MINIMAL"wird nicht unterstützt und von Hydrogen zurückgewiesen.- Benutzerdefinierte Werte für
temperature,top_pundtop_kwerden ignoriert. Die festen Standardwerte sind temperature 1.0, topP 0.95 und topK 64.
Auf Googles Plattform unterstützt Hydrogen außerdem Function Calling, Codeausführung, URL-Kontext und Computersteuerung. Verwenden Sie in der Interactions API previous_interaction_id für mehrstufige Sitzungen und Sitzungen mit Tool-Aufrufen.
Was AIHubMix dokumentiert – und was nicht
Die dokumentierte Route von AIHubMix für Hydrogen lautet POST https://aihubmix.com/v1/chat/completions mit model="gemini-4-hydrogen". Auf der Modellseite sind Text-, Bild-, Audio-, Video- und PDF-Eingaben mit Textausgabe aufgeführt; in llms.txt steht noch eine ältere Zeile, die nur Texteingaben nennt. Daher ist die Modellseite die aktuellere Quelle. Für Tool-Nutzung, strukturierte Ausgabe und Reasoning lauten die Fähigkeitsangaben „nicht veröffentlicht“. Das Modell ist nicht im Modellindex enthalten, der am 2026-11-11 generiert wurde, und es ist kein Protokollschema veröffentlicht.
Das ist für diesen Beitrag relevant, weil AIHubMix nicht dokumentiert, wie sich für ein Gemini-4-Modell eine Denkstufe festlegen lässt. Der Gemini-Leitfaden behandelt reasoning_effort für Modelle aus der Gemini-2.5-Ära, nicht aber thinking_level oder xhigh für Gemini 4. Gehen Sie weder davon aus, dass einer der beiden Parameter über das Gateway weitergereicht wird, noch davon, dass bei AIHubMix dieselbe Standardeinstellung gilt, die auf Googles API beobachtet wurde.
Die sichere Anfrageform entspricht der von AIHubMix dokumentierten:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Wenn die Steuerung der Denkstufe zwingend erforderlich ist, rufen Sie Googles API direkt auf oder überprüfen Sie das Verhalten des Gateways mit einer kleinen Anfrage, bevor Sie Produktivverkehr darüber leiten. Die Vergleichsseite von AIHubMix hilft bei der Kostenabwägung. Für diesen Beitrag wurde kein Live-Test durchgeführt.
Wo Sie je nach Workload beginnen sollten
| Workload | Einstiegslevel und Begründung |
|---|---|
| Schneller Chat, Routing, Klassifizierung | medium, low testen; low erreicht 27 Punkte |
| Interaktive Programmierung, UI-Prototyping | high; AA erreicht mit medium 41 |
| Agent-Ausführung, Tool-Schleifen | high; xhigh nur, wenn Sie nicht weiterkommen |
| Schwieriges Debugging, Architektur, Planung | xhigh oder Carbon; 3 Punkte mehr für 69% höhere Kosten |
| Batch-Verarbeitung mit hohem Volumen nach der Evaluierung | low oder medium; am günstigsten, aber mit einem Indexwert von 27/41 |
| Striktes Latenzbudget unter 15 Sekunden | medium oder low; mit high beträgt die Wartezeit 18.89 s |
Das sind Empfehlungen für den Einstieg, keine Routing-Regeln. Das richtige Level ist das niedrigste, das Ihre eigene Evaluierung besteht. Google empfiehlt, diese Evaluierung auf allen vier Levels durchzuführen.
FAQ
Welche Denkstufen bietet Gemini 4 Hydrogen?
Vier: low, medium, high und xhigh. Standardmäßig ist high eingestellt.
Was hat sich gegenüber Gemini 3.8 Flash geändert?
Der Standard wurde von medium auf high angehoben, und über high wurde xhigh hinzugefügt. Bei Carbon und Argon ist weiterhin medium der Standard; das höchste Level ist high.
Lohnt sich xhigh?
Bei schwierigen Aufgaben mit mehreren Schritten, an denen high scheitert, ja: Es bringt 3 Indexpunkte mehr. Pro Aufgabe kostet es jedoch 69% mehr als high, und die Wartezeit bis zum ersten Token ist fast doppelt so lang. Daher eignet es sich nicht als Standard für einfache Prompts.
Warum schneidet low so viel schlechter ab?
Artificial Analysis bewertet es im Index mit 27 Punkten, also 24 Punkte niedriger als high. Eine Aufgabe kostet $0.29 statt $1.87, doch der Qualitätsunterschied ist deutlich größer als der Preisunterschied. Verwenden Sie es nur, wenn eine aufgabenspezifische Evaluierung zeigt, dass es ausreicht.
Unterstützt AIHubMix thinking_level oder xhigh?
Laut Dokumentation nicht. AIHubMix veröffentlicht weder ein Flag für Reasoning-Funktionen von Hydrogen noch eine Anleitung zu den Denkstufen von Gemini 4. Prüfen Sie dies, bevor Sie sich auf eines davon verlassen.
Was passiert, wenn ich thinking_budget sende?
Gemini 4 gibt 400: INVALID_ARGUMENT zurück. Werden sowohl thinking_budget als auch thinking_level gesetzt, tritt ebenfalls ein Fehler auf.
Kann ich den Denkmodus ausschalten?
Es gibt keinen dokumentierten Schalter zum Ausschalten. MINIMAL wird von Gemini 4 nicht unterstützt; Hydrogen weist den Wert mit einem Fehler zurück.
Weiterlesen: die Gemini 4 Hydrogen-Reihe
- Wenn Sie noch entscheiden, ob Hydrogen das richtige Upgrade von Gemini 3.8 Flash ist, behandelt der erste Beitrag den Start, die Preisänderung und die Benchmark-Abwägungen: Gemini 4 Hydrogen vs Gemini 3.8 Flash: Lohnt sich das Upgrade?.
- Wenn Sie wissen möchten, wie Hydrogen bei derselben Aufgabe im Vergleich zu Carbon und Argon abschneidet, stellt der dritte Beitrag alle drei Modelle mit Preisen, Latenz und einer Workload-Tabelle gegenüber: Gemini 4 Carbon vs Hydrogen vs Argon: Welches Modell für welche Aufgabe?.
Quellen
- Google AI Studio, Gemini 4 Hydrogen: Was ist neu?
- Google, Gemini 4 Thinking
- Google, Gemini 4 Hydrogen-Modellseite
- Google AI Studio, Gemini API-Preise
- Artificial Analysis, Gemini 4 Hydrogen — aktueller Snapshot 2026-11-13T02:40Z, Intelligence Index v5.0.1


