Gemini 4 Carbon ist auf Ebene des Anfrage-Schemas ein direkter Ersatz für Gemini 4 Argon. Derselbe Chat-Completions-Request-Body funktioniert: Die Modell-ID ändert sich, einige Parameterwerte werden jedoch nicht übernommen. Die relevanten Fehler liegen eine Ebene tiefer – Parameterfehler, die 400 zurückgeben, Ausgabelimits, die unbemerkt abschneiden, sowie ein Timeout- und Abrechnungsprofil, das auf langes Reasoning ausgelegt ist.
Vier Standardeinstellungen bestimmen die erste Woche:
- Lassen Sie
max_tokensbei AIHubMix auf 65,536 oder darunter; das Gateway dokumentiert ausschließlich Chat Completions und veröffentlicht keinen höheren Ausgabepfad. - Setzen Sie für native Google-Interactions-/Hintergrundläufe
store=trueund einen expliziten Wert fürmax_output_tokens; diese Felder sind für Carbon auf AIHubMix nicht dokumentiert. - Erhöhen Sie bei Verwendung des nativen Anbieterpfads für lange Decodes die HTTP-Lese-Timeouts auf 15–20 Minuten pro Stream.
- Entfernen Sie
temperature,top_pundtop_k, da sie ignoriert werden, ebenso Penalties undcandidate_count-Werte über 1, die laut Googles Carbon-Leitfaden 400 zurückgeben.
Die unveränderten Grundlagen – Zugriff, Sicherheitsverweigerungen und Kosten pro Aufgabe – finden Sie im Argon-Migrationsbeitrag. Dieser Beitrag behandelt Carbon-spezifisches Verhalten.
Was lautstark scheitert und was stillschweigend
Fehler lassen sich klar einteilen: Ein 400-Fehler ist sofort erkennbar, eine stille Begrenzung erst auf der Rechnung.
| Beobachtung | Kategorie | Erster Schritt |
|---|---|---|
| HTTP 400 bei einem Parameter | Laut | Nicht unterstütztes Feld entfernen |
| 400 bei einer Hintergrundanfrage | Laut | store=true hinzufügen |
| Antwort endet bei 65,536 Token | Still | max_tokens erhöhen, bis auf 65,536 |
| Leerer Text, Status „incomplete“ | Still | Limit erhöhen und erneut versuchen |
| Hintergrundlauf endet bei etwa 64K | Still | max_output_tokens festlegen |
| Antwort wirkt weniger tiefgehend | Still | Denkstufe explizit festlegen |
| Rechnung höher als geschätzt | Still | Reasoning und Decode-Schritte mitzählen |
AIHubMix listet gemini-4-carbon über Chat Completions mit 2 $ pro Million Eingabe-Token, 10 $ pro Million Ausgabe-Token und 0,10 $ pro Million gecachte Token – Googles Einführungspreisen. Sie sind befristet; siehe Abrechnung.
Lautstarke Fehler: die dokumentierten 400-Fehler
Viele dokumentierte 400-Fehler sind Parameter-Validierungsfehler; Probleme mit dem Verlauf und vorab ausgefüllte Modell-Turns sind Fehler im Anfragezustand. Sofern nicht anders angegeben, stammen die folgenden Regeln aus Googles nativem Carbon-Leitfaden; AIHubMix dokumentiert für Carbon derzeit nur Chat Completions. Der Carbon-Eintrag von AIHubMix beschreibt die Fehlerklasse in einer Zeile: „400 — Parameterfehler; die meisten werden vom vorgelagerten Anbieter durchgereicht.“ Das beschreibt das Gateway, keinen Test. Die Details stammen aus Googles Carbon-Leitfaden und der „What's new“-Seite.
| Auslöser | Beobachtung | Behebung |
|---|---|---|
| max_output_tokens > 1M* | 400; über dem Limit | Nativ ≤1M; Gateway ≤65K* |
| frequency/presence penalty | 400; nicht unterstützt | Felder entfernen |
| candidate_count > 1 | 400; mehrere Kandidaten | Weglassen oder auf 1 setzen |
| background ohne store* | 400; store erforderlich* | store=true hinzufügen |
| Verlauf endet mit Modell | Abgelehnt; nicht unterstützt | Mit einem User-Turn enden |
| beide Steuerungsfelder | 400; nicht kombinierbar | Nur eines senden |
| thinking_budget oder MINIMAL | 400; Carbon-Leitfaden | low/medium/high verwenden |
Google gibt die Meldung genau so aus: „store=true is required for background interactions.“ * Nur nativ bei Google: max_output_tokens ist auf 1M begrenzt und für Hintergrundläufe ist store=true erforderlich; AIHubMix hat diesen Pfad nicht dokumentiert. Verwenden Sie auf dem Chat-Completions-Pfad höchstens 65K.
Die Zeile minimal hat zwei Bedeutungen. Bei Googles nativen Carbon-Feldern führen thinking_budget und thinking_level=MINIMAL zu HTTP 400; verwenden Sie low, medium oder high. In Googles OpenAI-Kompatibilitätsschicht wird reasoning_effort=minimal auf low abgebildet; AIHubMix hat nicht veröffentlicht, ob diese Zuordnung für Carbon gilt.
Der Umgang mit Tools ist eine verwandte Stolperfalle. Googles Carbon-Leitfaden empfiehlt sequenzielle Tool-Ausführungs-Turns, und AIHubMix' Gemini-Leitfaden dokumentiert tool_choice="auto"; die Unterstützung von Tools für Carbon im Gateway ist weiterhin unbestätigt.
Die kleinste sichere Anfrage an /v1/chat/completions lässt alles weg, was Carbon ignoriert:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Wenn diese Anfrage 200 zurückgibt, ist die Transportschicht erledigt. Im Folgenden geht es um Antworten, die keinen Fehler auslösen.
Stille Fehler: kein Fehler, falsche Ausgabe, falsche Rechnung
Das standardmäßige Ausgabelimit liegt bei 65,536; der native Pfad für lange Decodes ist separat
Die standardmäßige Ausgabebegrenzung von Carbon liegt bei 65,536 Token. Bei Chat Completions heißt das Limit-Feld max_tokens; Googles native Leitfäden nennen es max_output_tokens. Googles nativer Pfad für lange Decodes kann bis zu 1,048,576 Token abzüglich der Eingabe erreichen; 131,072 und 262,144 sind Beispiele. Auf Googles „What's new“-Seite steht die Regel: „Wenn Sie background: true festlegen, ohne max_output_tokens zu definieren, stoppt der Server nach 64K Token.“ AIHubMix hat Hintergrundverarbeitung oder Fortsetzung für Carbon nicht dokumentiert.
Ein nativer Anbieterpfad für lange Decodes läuft in Segmenten: 64K pro Schritt mit Hintergrundverarbeitung oder Streaming, 32K pro Schritt ohne Streaming; eine einzelne nicht gestreamte REST-Anfrage endet nach 32,768. Googles Leitfaden weist darauf hin: „Ältere SDK-Versionen und die OpenAI-Kompatibilitätsschicht können lange Vervollständigungen nicht mit Fortsetzungstoken abrufen.“ Setzen Sie bei AIHubMix max_tokens vorsichtshalber auf höchstens 65,536 – ein unbestätigtes Gateway-Limit. Planen Sie nicht, längere Antworten zusammenzufügen, solange die Modellseite das nicht dokumentiert.
Ein niedriges Limit schneidet das Reasoning ab, und leere Ausgaben werden berechnet
Das Limit gilt auch für das Reasoning, nicht nur für den Text. Googles Leitfaden für lange Decodes sagt: „Ein niedriger Wert, etwa 8,192, stoppt das Modell, bevor es mit dem Reasoning fertig ist.“ Der Status wird zu incomplete, und „der Text kann leer sein, wenn das Modell noch mit dem Reasoning beschäftigt war.“ Bezahlt wird in beiden Fällen. Planen Sie Token für Reasoning und Antwort ein und behandeln Sie eine leere, unvollständige Antwort als Problem mit dem Limit: Erhöhen Sie es, versuchen Sie es erneut und rechnen Sie damit, dass der erste Versuch auf der Rechnung steht.
Der standardmäßige Denkmodus ist medium
Carbon verwendet standardmäßig medium, genau wie Argon. Teams, die von Gemini 3.1 Pro Preview kommen, dessen Standard high ist, verlieren ohne Codeänderung eine Denkstufe und halten die weniger tiefgehende Antwort für eine Regression. Google empfiehlt medium für die meisten Programmier- und Agentenaufgaben. Legen Sie die Stufe in der Staging-Umgebung explizit fest und senden Sie nur ein Steuerungsfeld: reasoning_effort und thinking_level lassen sich nicht kombinieren.
Sampling-Parameter werden ignoriert
temperature, top_p und top_k werden ignoriert – kein Fehler, keine Änderung der Stichprobe. Entfernen Sie sie. Penalties und candidate_count-Werte über 1 führen zu 400.
Explizites Caching entfällt
cachedContents und caches.create werden nicht unterstützt. Implizites Caching greift ab 4,096 Token und bietet einen Rabatt von 95%. Löschen Sie den Code für explizites Caching, setzen Sie den stabilen Prompt-Präfix an den Anfang und prüfen Sie die Nutzung gecachter Token, bevor Sie den Rabatt in die Kalkulation aufnehmen.
Für den Gesprächsverlauf gilt eine Regel
Google empfiehlt für die Fortsetzung previous_interaction_id. Chat Completions hat kein entsprechendes Feld; behalten Sie daher den Verlauf bei, beenden Sie ihn aber mit einem User-Turn. Ein Verlauf, der mit einer Modellrolle endet, oder ein vorab ausgefüllter Modell-Turn wird nicht unterstützt.
Timeouts: 15 bis 20 Minuten, nicht 60 Sekunden
Googles Leitfaden für lange Decodes empfiehlt HTTP-Lese-Timeouts von 15 bis 20 Minuten pro Stream; die Migrations-Checkliste wiederholt das Minimum von 15 Minuten. Diese Empfehlung gilt für Anfragen mit langen Decodes. Eine separate Messung von AA zeigt die Wartezeit bis zum ersten Antwort-Token: Carbon High benötigte 67.1 Sekunden, Medium 23.2, Low 12.9 und Argon High 40.1. Reicht eine Abbruchgrenze von 60 Sekunden überhaupt aus, damit das erste Token eintrifft?
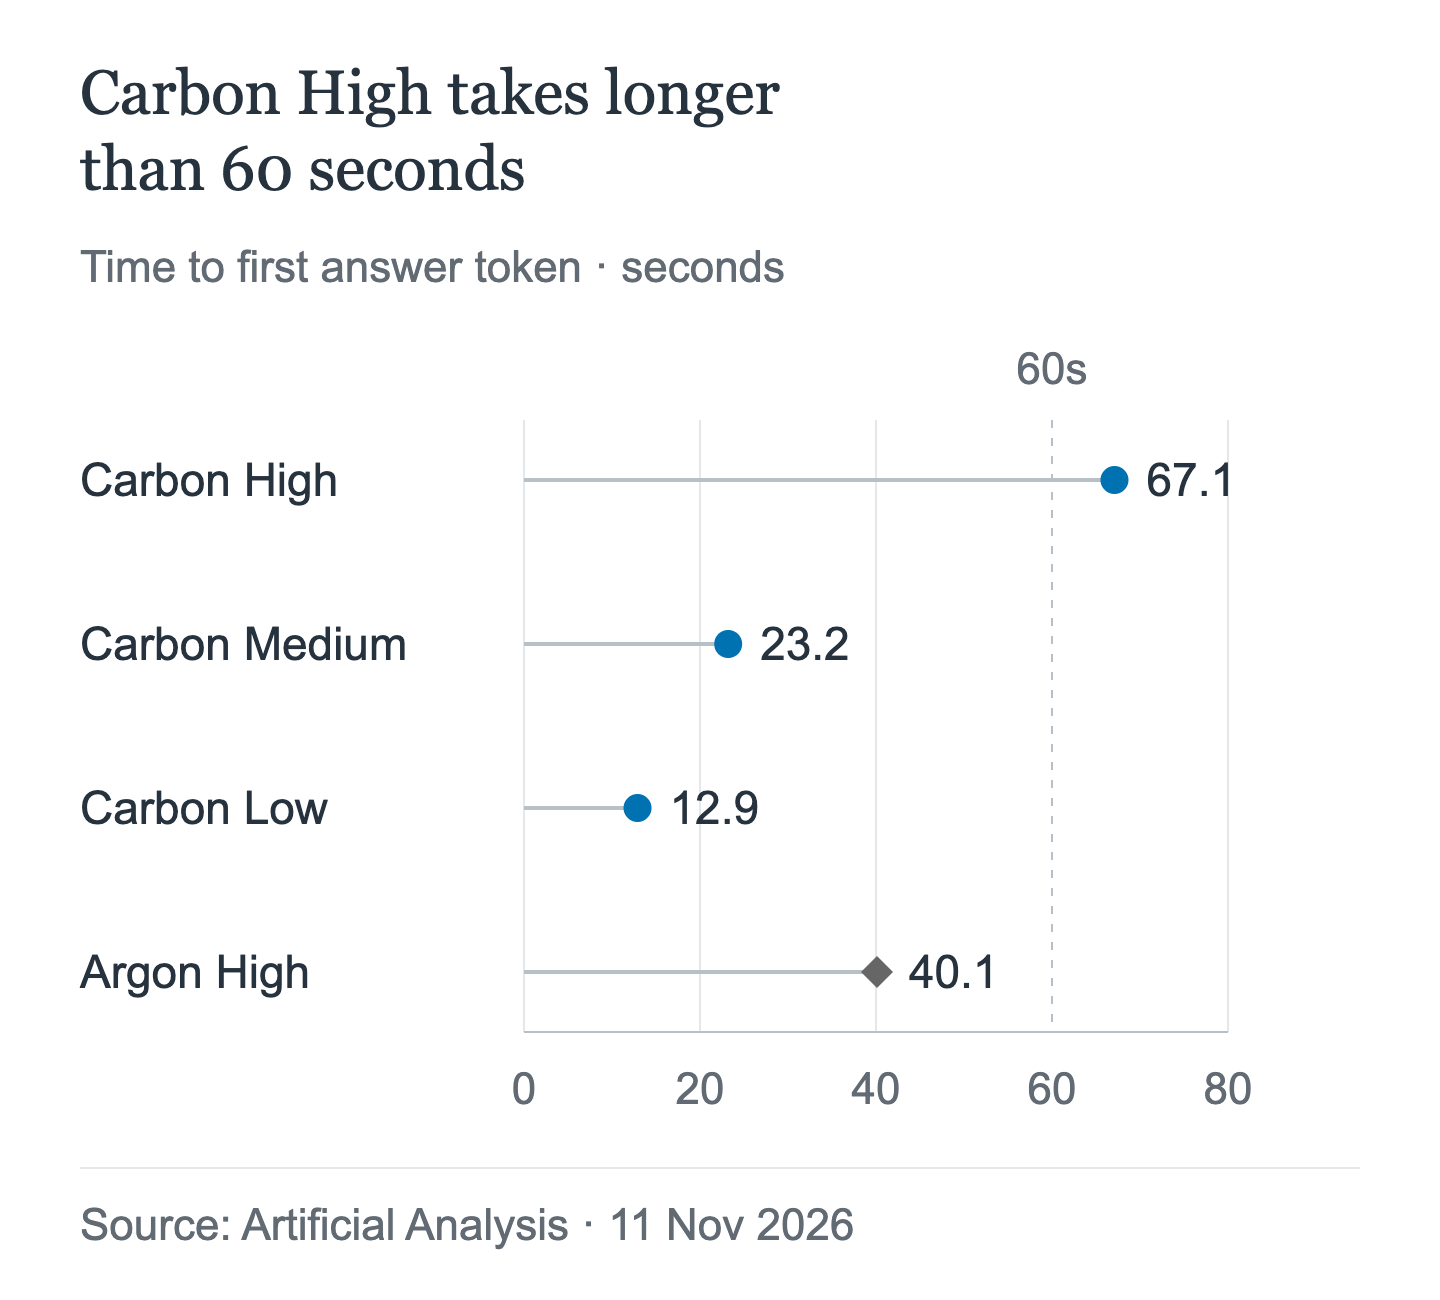
Carbon High überschreitet in dieser Messung den Richtwert von 60 Sekunden. Die Zeit bis zum ersten Token sagt nichts über ein sicheres Timeout für die gesamte Anfrage aus: Die Empfehlung von 15–20 Minuten weiter oben stammt aus Googles Leitfaden für lange Decodes. Dies sind Ergebnisse einer einzelnen Momentaufnahme, keine Latenzgarantien und kein Test von AIHubMix.
Die nativen Client-Schrittlimits von Google sind strenger als das Hintergrundlimit: 20 Minuten für einen Stream, 10 für einen Aufruf ohne Streaming, gegenüber 24 Stunden für Hintergrundläufe. AIHubMix dokumentiert diese Hintergrundlimits nicht.
Mindestversionen nativer SDKs für lange Decodes: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. API_TIMEOUT_MS von Claude Code ist standardmäßig auf 10 Minuten eingestellt. Falls später bestätigt wird, dass Carbon über Claude Code genutzt werden kann, erhöhen Sie den Wert vor dem ersten Lauf.
Abrechnungsfallen
Der Tokenpreis von Carbon ist einfach, die Rechnung nicht. Mehrere Mechanismen erhöhen die Rechnung, und eine angekündigte Änderung verdoppelt jeden Preis.
Reasoning wird als Ausgabe berechnet
Reasoning-Token werden als Ausgabe berechnet. Der Ausgabepreis von Carbon liegt derzeit bei 10 $ pro Million Token und ab dem 1. Dezember bei 20 $.
Jeder Schritt eines langen Decodes wird berechnet
Googles Rechenbeispiel: Bei einem Prompt mit 1,000 Token und einer Ausgabe von 200,000 Token beträgt total_input_tokens über die Schritte mit 1,000, 66,536, 132,072 und 197,608 hinweg insgesamt 397,216. „Sie zahlen für jedes Token in jedem Schritt, auch für Schritte, die ausschließlich Reasoning enthalten.“ Implizites Caching reduziert die Kosten für den Großteil der Eingabe um 95%, die Schritte bleiben jedoch in der Nutzung enthalten. Auch abgeschlossene Arbeit wird berechnet, wenn ein Lauf fehlschlägt oder abgebrochen wird: „Abgeschlossene Segmente werden am Ende jedes Segments berechnet, auch wenn ein späteres Segment fehlschlägt oder abgebrochen wird“ und „Sie zahlen für die gesamte Arbeit, die vor dem Ende der Interaction abgeschlossen wurde.“
Grounding hat eine eigene Abrechnung
Beim nativen Google-Dienst umfasst Grounding mit Google Search 5,000 kostenlose Anfragen pro Monat, gemeinsam für Gemini 3 und neuere Versionen; danach kostet es 14 $ pro 1,000 Anfragen, bei einer Obergrenze von 1,500 pro Tag. AIHubMix hat Grounding für Carbon nicht dokumentiert.
Die Vertex-Fußnote gilt nur für den Anbieter
Googles Vertex-Preisseite ergänzt eine Regel: Vervollständigungen mit mehr als 32K Token werden anhand der abrufbaren Token-Nutzung berechnet, selbst wenn die Anfrage wegen eines Client- oder Server-Timeouts fehlschlägt; gültig ab dem 13. November 2026. Das ist eine Anbieterregel. Ob der VertexAI-Anbieter von AIHubMix sie anwendet, wurde nicht veröffentlicht. Fragen Sie nach, bevor Sie davon ausgehen.
Am 1. Dezember verdoppelt sich jeder Preis
| Preisart | Bis zum 30. November | Ab dem 1. Dezember |
|---|---|---|
| Eingabe | 2 $ pro 1M | 4 $ pro 1M |
| Ausgabe | 10 $ pro 1M | 20 $ pro 1M |
| Gecachte Lesezugriffe | 0,10 $ pro 1M | 0,20 $ pro 1M |
Für Carbon und Argon gelten dieselben Einführungspreise; am 1. Dezember verdoppelt sich jeder Preis. AIHubMix listet derzeit die Einführungspreise und hat die Preise nach Dezember noch nicht veröffentlicht. Gehen Sie davon aus, dass die Verdopplung sicher ist und der Gateway-Preis unbekannt; prüfen Sie beides, bevor Sie ein Budget festlegen.
Agenten mit echten Berechtigungen
Für native Google-Aufrufe empfiehlt der Carbon-Leitfaden sequenzielle Tool-Ausführungsrunden. Verwenden Sie bei diesem Ansatz jeweils nur einen Aufruf. Im Gemini-Leitfaden von AIHubMix ist tool_choice="auto" dokumentiert, aber die Carbon-spezifische Tool-Unterstützung und das Erzwingen von Tools über das Gateway sind nicht bestätigt.
Der Verlauf darf nicht mit einer Modellrunde enden, und vorausgefüllte Modellrunden werden nicht unterstützt. Fehlt ein Tool-Ergebnis, senden Sie eine Nutzerrunde mit der Frage nach dem nächsten Schritt.
Laut Modellkarte kann es gelegentlich zu Verzögerungen oder Timeouts sowie zu zusätzlichen Tokens bei höheren Stufen kommen; der Wissensstand endet im März 2026. Bei Schreibzugriff besteht das eigentliche Risiko in einem Timeout: Überschreitet ein Durchlauf das Client-Limit, können Teilergebnisse zurückbleiben, und abgeschlossene Segmente werden trotzdem abgerechnet.
Coding-Tools: Modellseite prüfen, bevor Sie etwas einrichten
Im Carbon-Eintrag von AIHubMix sind nur Chat Completions dokumentiert, und Carbon ist noch nicht im öffentlichen Modellindex enthalten. Claude Code benötigt Anthropic Messages; Codex benötigt Responses. Für Carbon auf AIHubMix ist keines von beiden bestätigt. Gehen Sie nicht davon aus, dass eines davon funktioniert: Öffnen Sie die oben verlinkte Carbon-Modellseite und prüfen Sie die Protokollliste. Ist dort nur Chat Completions aufgeführt, verwenden Sie einen OpenAI-kompatiblen Client oder warten Sie.
Die Anforderungsstruktur entspricht der von Argon, aber die verfügbaren Protokolle unterscheiden sich: Derzeit ist Carbon auf AIHubMix nur für Chat Completions dokumentiert. Im Beitrag zu Claude Code geht es um ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN und API_TIMEOUT_MS; im Beitrag zu Codex um den Provider-Block, wire_api und model_reasoning_effort. Entscheidend ist, ob das jeweilige Protokoll verfügbar ist.
| Client | Benötigtes Protokoll | Carbon auf AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Nicht dokumentiert |
| Codex | Responses API | Nicht dokumentiert |
| OpenAI SDK | Chat Completions | Dokumentiert |
Einstellungen:
- Modell-ID:
gemini-4-carbon. - Denkmodus: low, medium, high; Standardwert: medium.
- Effort-Zuordnung: natives Feld
thinking_level, Kompatibilitätsfeldreasoning_effort; Google ordnet den Effort-Werten Stufen zu, aber AIHubMix hat die Carbon-Zuordnung nicht veröffentlicht. Senden Sie nur einen der beiden Parameter. - Kontext: Laut Google 1,048,576; AIHubMix hat kein Carbon-Limit veröffentlicht. Richten Sie sich daher nicht nach dem Anbieterwert.
- Bekannte Probleme: langsamer erster Token bei high, Empfehlung des Anbieters, sequenzielle Tool-Runden zu bevorzugen, ein konservatives, nicht verifiziertes AIHubMix-Limit von 65,536 Ausgabetokens und ein Wissensstand bis März 2026.
Smoke-Test, 10–15 Minuten:
- Wählen Sie ein kleines Repository mit einem fehlschlagenden Unit-Test und einem Testbefehl, der in weniger als einer Minute durchläuft.
- Legen Sie
gemini-4-carbonals Modell fest, setzen Siemax_tokensauf höchstens 65,536 und stellen Sie das HTTP-Timeout auf mindestens 15 Minuten ein. - Bitten Sie das Tool, die kleinstmögliche Änderung vorzunehmen, mit der der Test erfolgreich ist. Führen Sie anschließend den Testbefehl aus und prüfen Sie den Diff.
- Bestanden: Die Änderung ist minimal und der Test besteht innerhalb von 10–15 Minuten. Nicht bestanden: Halten Sie fest, ob die Antwort ein 400-Fehler, unvollständig, ein Timeout oder eine fehlerhafte Änderung war; für jeden Fall gibt es oben eine andere Lösung.
- Wenn das Tool die Stufe zugänglich macht, testen Sie medium und high und behalten Sie die Stufe bei, die innerhalb des Zeitfensters fertig wird.
Checkliste vor der ersten Produktionsanfrage
- Modell-ID auf
gemini-4-carbongesetzt. - Kein
temperature,top_podertop_k. - Kein
frequency_penaltyoderpresence_penalty;candidate_countauf 1 setzen oder weglassen. max_tokensauf höchstens 65,536 gesetzt.- Native Google-Hintergrundanfragen senden
store=trueund einen expliziten Wert fürmax_output_tokens; AIHubMix hat diesen Pfad nicht dokumentiert. - HTTP-Timeout auf mindestens 15 Minuten eingestellt; Streaming wird empfohlen.
- Nur eines von
reasoning_effortundthinking_levelverwenden. - Bei Google native sequenzielle Tool-Runden bevorzugen; AIHubMix dokumentiert
tool_choice="auto", aber die Carbon-Unterstützung ist nicht bestätigt. - Keine expliziten Cache-Aufrufe; der stabile Prompt-Präfix kommt zuerst.
- Das Budget berücksichtigt Denk-Tokens und jeden Schritt einer langen Dekodierung.
- Preise zum 1. Dezember mit der für das Budget verantwortlichen Person geprüft.
- Coding-Tool vor der Konfiguration anhand der Modellseite geprüft.
FAQ
Muss der Request-Body geändert werden, wenn ich von Argon zu Carbon wechsle?
Nein. Das Schema ist unverändert. Ändern Sie die Modell-ID, prüfen Sie die Werte und entfernen Sie Felder, die nun einen 400-Fehler auslösen.
Warum löst max_output_tokens einen 400-Fehler aus?
Googles native Carbon-API lehnt Werte über 1,048,576 ab. Für den Chat-Completions-Pfad von AIHubMix gilt eine separate, konservative Empfehlung: Setzen Sie max_tokens auf höchstens 65,536, bis ein größerer Grenzwert dokumentiert ist. Ein niedriger Wert schneidet stattdessen das Denken ab, was noch schlechter ist: Die Antwort kann unvollständig sein und wird trotzdem abgerechnet.
Warum ist die Antwort leer?
Wenn der Status „incomplete“ lautet, kann der Text leer sein, weil das Modell noch nachgedacht hat. Die Arbeit wird Ihnen berechnet. Erhöhen Sie das Limit und versuchen Sie es erneut.
Warum endet eine Hintergrundanfrage bei 64K?
Wenn bei Googles nativem Hintergrundpfad max_output_tokens weggelassen wird, stoppt der Server bei 64K. Legen Sie das Limit explizit fest; die native Langzeitdekodierung kann bis zu 1,048,576 abzüglich der Eingabe erreichen. AIHubMix hat den Hintergrundmodus nicht dokumentiert.
Wird temperature berücksichtigt?
Nein. temperature, top_p und top_k werden ignoriert. Bei Werten für Penalties und candidate_count über 1 wird stattdessen ein 400-Fehler zurückgegeben.
Wird Carbon am 1. Dezember doppelt so viel kosten?
Googles Preise verdoppeln sich: Eingabe von $2 auf $4, Ausgabe von $10 auf $20, Cache-Lesezugriffe von $0.10 auf $0.20. AIHubMix hat seinen Preis nach Dezember noch nicht veröffentlicht. Bestätigen Sie ihn daher, bevor Sie ein Budget festlegen.
Kann ich Claude Code oder Codex mit Carbon verwenden?
Nicht bestätigt. AIHubMix dokumentiert für Carbon Chat Completions; Claude Code benötigt Anthropic Messages und Codex benötigt Responses. Prüfen Sie zuerst die Modellseite.
Weiterlesen: die Gemini-4-Carbon-Reihe
- Wenn die Migration läuft und nur noch offen ist, ob Carbon seinen Preis überhaupt wert ist, stellt der Vergleich die gemeinsamen Einführungspreise gegenüber.
Gemini 4 Carbon vs. Argon: gleicher Preis – wann lohnt sich Carbon? - Wenn Sie statt einer Migration des Endpunkts einen Coding-Agent auswählen, vergleicht der direkte Vergleich den Tool-Einsatz und die Kosten pro Aufgabe.
Gemini 4 Carbon vs. Fable 5.2: Welches Modell eignet sich für agentisches Coding?