Anthropic veröffentlichte Claude Fable 5.2 am 9. November 2026. Google brachte Gemini 4 Carbon einen Tag später allgemein auf den Markt. In der Benchmark-Tabelle zur eigenen Markteinführung führt Anthropic eine Carbon-Spalte auf. Das macht die Tabelle zu einem nützlichen Vergleich für dieselbe langfristige Coding-Aufgabe.
Beide Modelle werden für dieselbe Aufgabe angeboten: langfristiges agentisches Coding. Der Agent liest ein Repository, bearbeitet mehrere Dateien, führt Befehle aus, liest Testergebnisse und arbeitet 15 bis 45 Minuten ohne menschliche Eingabe weiter. Genau diese Aufgabe wird hier bewertet. Chat, Autovervollständigung und kurze Skripte sind ein anderer Test.
Die kurze Antwort
Fable 5.2 liegt bei den aufgeführten anspruchsvollen Coding-Benchmarks vorn und ist bei gleichem Reasoning effort schneller. Die drei Spitzenplätze bei AA gehen an Fable, vor Carbon High auf Platz 4. Carbon erzielt bei den aufgeführten Terminal-Bench-4.0- und AutomationBench-AA-Ergebnissen höhere Werte und ist pro Aufgabe bei hohem Reasoning effort günstiger, solange Googles Einführungspreis bis zum 30. November gilt. Bei mittlerem Reasoning effort ist Fable günstiger und deutlich schneller, während Carbon beim AA-Index höher abschneidet.
Wählen Sie Fable für anspruchsvolles Code-Reasoning und Carbon für Terminal-Ausführung und Automatisierung. Prüfen Sie vor der Nutzung beider Modelle die Eingabe-, Aufbewahrungs- und Ausgabelimits.
Was ein einheitliches Test-Setup zeigt
Artificial Analysis testet alle Modelle mit demselben Test-Setup und denselben Aufgaben; die Seiten zu Carbon und Fable enthalten die Ergebnisse der einzelnen Evaluationen. Die Zahlen stammen aus dem Snapshot vom 11. November 2026; AA verwendet die regulären Listenpreise, nicht Googles Einführungspreis.
| Modell | AA-Index | $/Aufgabe | Min./Aufgabe | Erstes Token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Hinweis: AA Intelligence Index und Kosten pro Aufgabe zu Standardpreisen, Snapshot 2026-11-11T05:23Z. Fable Max, Xhigh und High belegen die Plätze 1 bis 3; Carbon High liegt auf Platz 4, Opus 5.5 Max auf Platz 5 und Carbon Medium auf Platz 6. „Erstes Token“ bezeichnet die Zeit bis zum ersten Antwort-Token.
Bei hohem Reasoning effort liegt Fable um 1.79 Punkte vorn, kostet pro Aufgabe 17.0% mehr ($9.08 gegenüber $7.76), ist aber nach 17.3 statt 25.6 Minuten fertig und gibt sein erstes Token nach 30.4 statt 67.1 Sekunden aus. Max kostet pro Aufgabe $26.54, also das 3.4-Fache von Carbon High, und wartet 233.9 Sekunden.
Bei mittlerem Reasoning effort ändert sich die Reihenfolge: Fable erzielt 56.41 gegenüber 58.26 bei Carbon, liegt also 1.85 Punkte zurück, kostet aber $3.80 statt $6.59 und benötigt 7.8 statt 23.3 Minuten. Der niedrigere Tokenpreis von Carbon macht es hier nicht günstiger pro Aufgabe: Es verbraucht mehr Token.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Anteil ohne Halluzinationen % | 88.58 | 42.02 | 40.73 | 49.66 |
| Genauigkeit % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase-Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Hinweis: Artificial Analysis, dasselbe Test-Setup und derselbe Snapshot. „Ohne Halluzinationen“ bezeichnet den Anteil der Omniscience-Antworten ohne erfundene Behauptungen; Genauigkeit ist ein separater Wert. Höhere Werte sind in jeder Zeile besser. Fable Xhigh ist der Übersichtlichkeit halber nicht aufgeführt; sein FrontierCode-2.0-Wert beträgt 47.58.
Welches Modell liegt bei jedem Test mit hohem Reasoning effort vorn? Die vorzeichenbehaftete Differenz unten ergibt sich aus Carbon minus Fable. So wird die Richtung sichtbar, während die obige Tabelle die absoluten Werte zeigt.
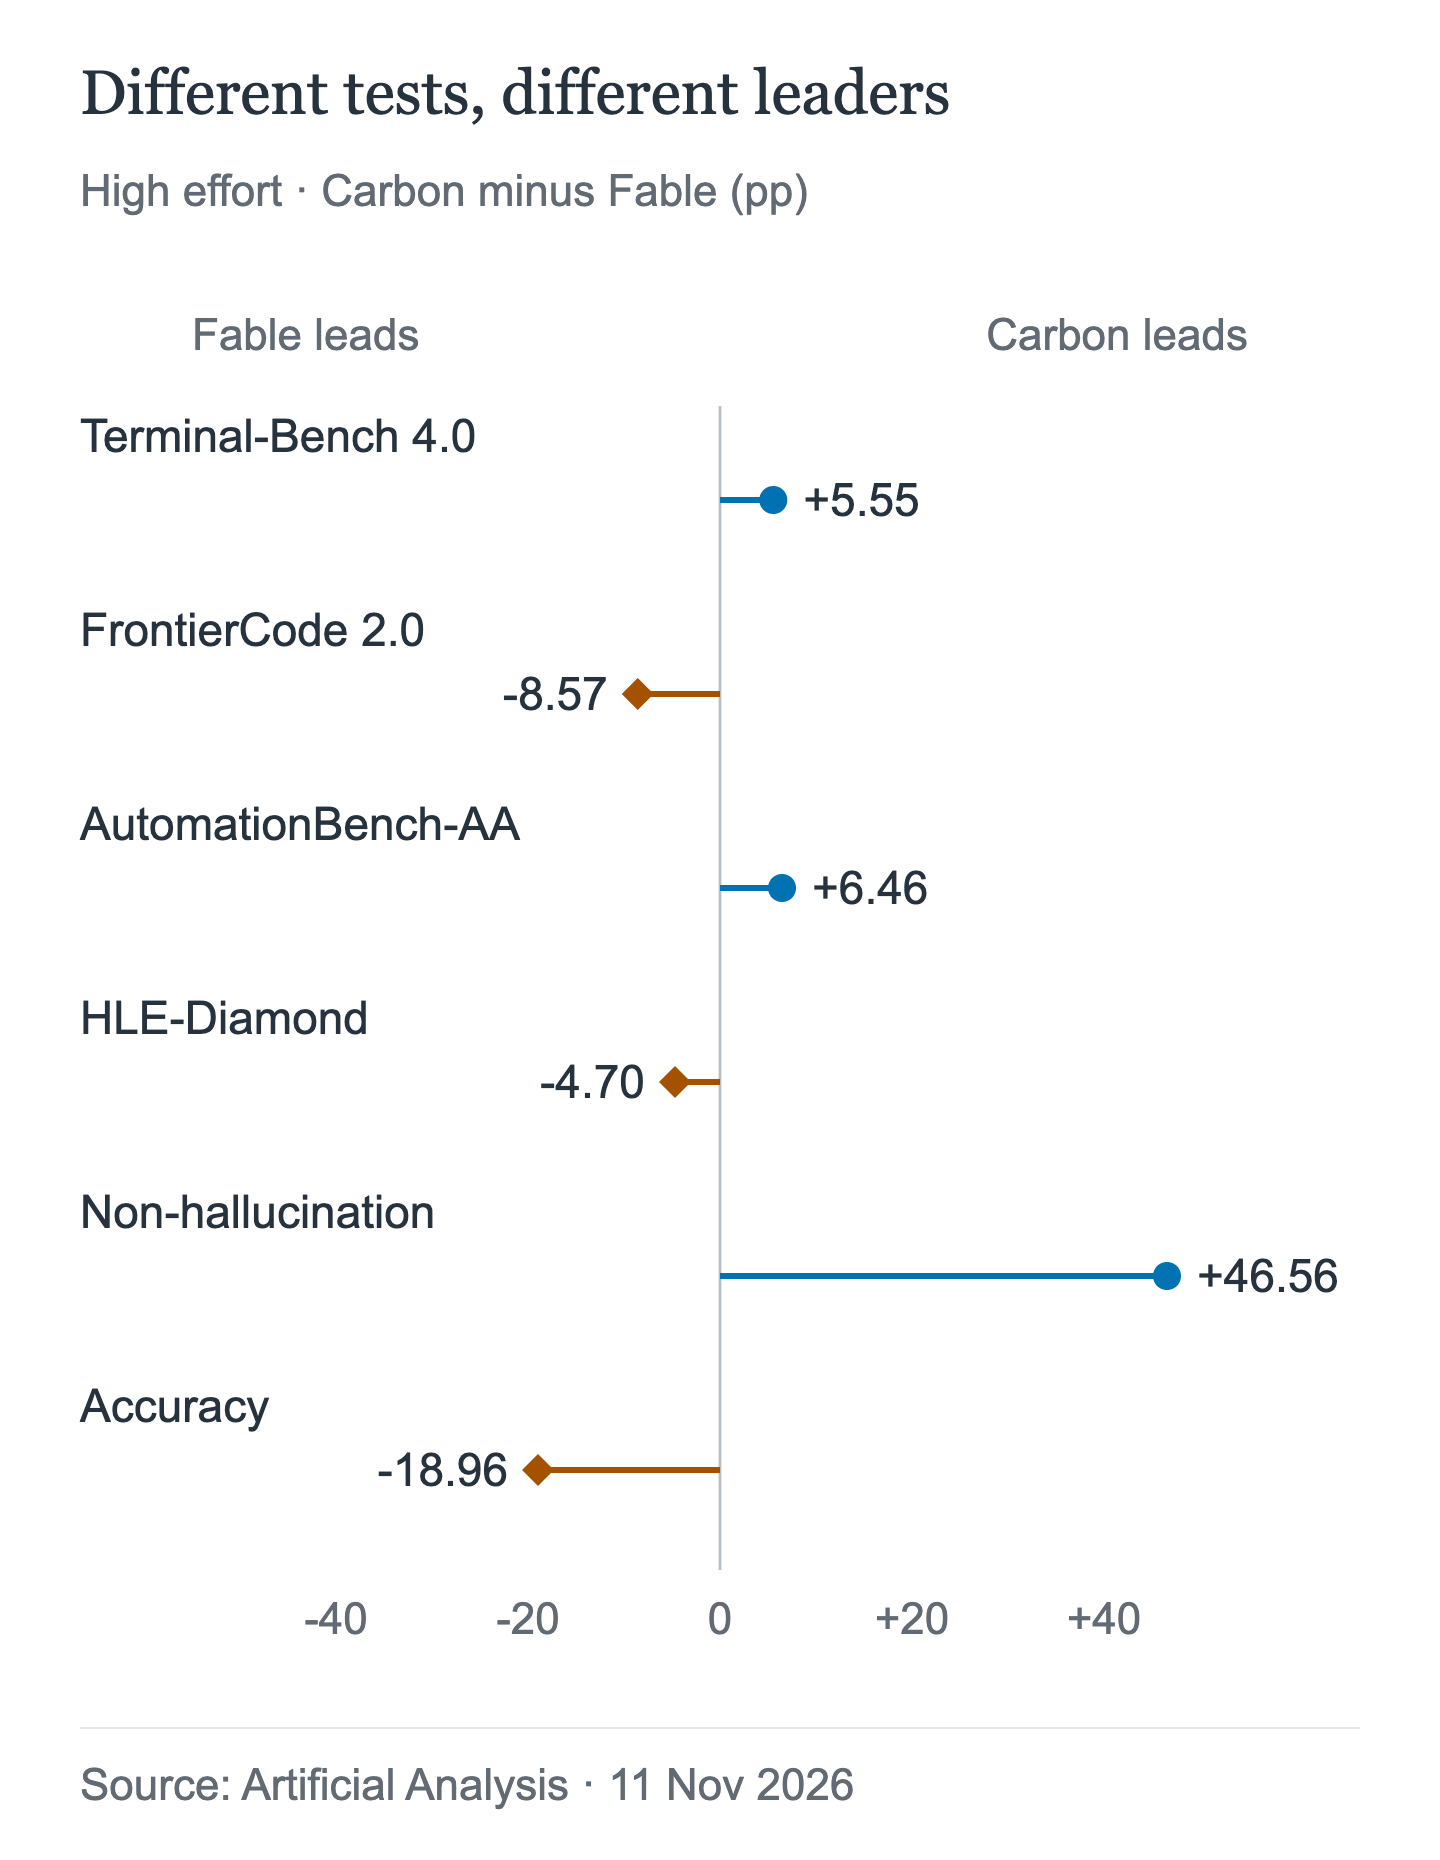
Das sind Differenzen in Prozentpunkten bei unabhängigen Tests, kein kombinierter Qualitätswert. Eine größere Differenz bei einem Benchmark bedeutet nicht, dass die allgemeinen Fähigkeiten stärker verbessert sind. Insbesondere messen der Anteil ohne Halluzinationen und die Genauigkeit unterschiedliche Ergebnisse.
Fable liegt bei FrontierCode 2.0 mit hohem Reasoning effort um 8.57 Punkte und bei HLE-Diamond um 4.7 Punkte vorn; beim Briefcase-Elo erzielt es 1677.4 gegenüber 1610.6. FrontierCode kommt schwierigen Änderungen an mehreren Dateien am nächsten. Carbon liegt bei Terminal-Bench 4.0 um 5.55 und bei AutomationBench um 6.46 Punkte vorn. Diese Benchmarks bewerten die Ausführung von Befehlen, Fehlerbehebung und Automatisierung.
Die Differenz beim Anteil ohne Halluzinationen ist die größte in der Tabelle: Carbon erreicht mit hohem Reasoning effort 88.58%, Fable 42.02%. Bei der Genauigkeit ist es umgekehrt: 58.27% gegenüber 77.23%. Carbon erfindet seltener etwas, gibt aber auch seltener eine richtige Antwort. Für einen Agenten, der keine API erfinden darf, kann das entscheidend sein; muss er hingegen eine Antwort liefern, ist Fables Genauigkeit das aussagekräftigere Signal.
Mehr Reasoning effort ist nicht immer besser: Fable Max erreicht bei FrontierCode 48.76 und liegt damit knapp unter dem Wert von 49.13 bei High; bei Terminal-Bench bleibt das Ergebnis bei 59.6.
Anthropics eigene Tabelle
Auf seiner Launch-Seite veröffentlicht Anthropic eine herstellerübergreifende Tabelle mit Carbon. Die Einstellungen unterscheiden sich von denen bei AA: Fable wird mit Xhigh getestet, dem höchsten ausgewiesenen Reasoning effort, Carbon mit Medium. Vergleichen Sie die Werte nur innerhalb dieser Tabelle.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase-Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Hinweis: von Anthropic selbst gemeldet. Fable wurde mit Xhigh getestet, seinem höchsten verfügbaren Reasoning effort; Carbon mit Medium. Die Skala von Anthropics AutomationBench unterscheidet sich von der von AA (51.4/53.9 gegenüber 71.36/77.82), daher sollten Sie die Werte nur innerhalb dieser Tabelle vergleichen. Carbons FrontierCode-Wert von 41.1 stammt aus einem Test mit Medium; der AA-Wert von 40.56 wurde mit hohem Reasoning effort und einem anderen Test-Setup erzielt.
Die Ergebnisse weisen in dieselbe Richtung wie bei AA: Fable liegt bei FrontierCode, FrontierSWE, OSWorld und TB-Science vorn; Carbon führt bei AutomationBench mit 2.5 Punkten Vorsprung, weniger als die 6.5 Punkte bei AA, aber in dieselbe Richtung. Die Tabelle stützt die Aussage „Carbon ist bei Automatisierung konkurrenzfähig“, nicht aber „Carbon ist das bessere Modell für anspruchsvolles Coding“.
Anthropics eigene Empfehlung macht die Behauptung „Fable ist das Upgrade“ komplizierter: „Für die meisten Coding- und Wissensaufgaben empfehlen wir Nutzern, mit Claude Opus 5.5 zu beginnen.“ Bei hohem Reasoning effort, so Anthropic, erzielt Fable ungefähr dasselbe Ergebnis wie Opus 5.5 bei dessen bestem Wert (45.3% gegenüber 45.5%), kostet pro Aufgabe aber ungefähr halb so viel.
Was die Token kosten
| Modell | Eingabe | Ausgabe | Cache-Lesen |
|---|---|---|---|
| Carbon, bis 30. Nov. | $2 | $10 | $0.10 |
| Carbon, ab 1. Dez. | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Hinweis: USD pro 1M Token, offizielle Preise. Cache-Schreibvorgänge bei Fable: $10 (5 Min.) oder $16 (1 Stunde); Batch mit 50% Rabatt. Der angegebene Cache-Preis für Carbon gilt für Lesevorgänge; der offizielle Cache-Lesepreis von Opus 5.5 beträgt $0.20.
Der Tokenpreis von Fable ist doppelt so hoch wie Carbons regulärer Preis und viermal so hoch wie dessen Einführungspreis. Das Verhältnis ist einfach; die Kosten pro Aufgabe sind es nicht. AA maß für Carbon High bei $4/$20 Kosten von $7.76 pro Aufgabe, gegenüber $9.08 bei Fable High, eine Differenz von 17.0%. Zum Preis von $2/$10 bei Google kostet dieselbe Nutzung schätzungsweise etwa $3.88. Bis zum 30. November kostet Fable High pro Aufgabe etwa das 2.3-Fache; ab dem 1. Dezember beträgt die Differenz wieder 17.0%.
Zu Standardpreisen kostet Fable Medium $3.80 gegenüber $6.59 bei Carbon, also 42% weniger, obwohl der Tokenpreis doppelt so hoch ist. Carbon benötigt 23.3 Minuten und verbraucht mehr Token; Fable braucht 7.8 Minuten. Zum Einführungspreis kostet Carbon Medium auf dieselbe Weise berechnet etwa $3.30 und damit fast so viel wie Fable. Dieser Vorteil entfällt am 1. Dezember.
Max kostet pro Aufgabe das 3.4-Fache von Carbon High ($26.54) und braucht 45.2 Minuten. Höhere Ausgaben ergeben nicht automatisch einen besseren Coding-Agenten: Max liegt bei FrontierCode knapp unter High.
AIHubMix bietet Carbon zum Einführungspreis von Google an. Die hier genannten Fable-Preise sind die offiziellen Tarife von Anthropic.
Verhaltensunterschiede, die bei der Bereitstellung entscheidend sind
| Dimension | Carbon | Fable 5.2 |
|---|---|---|
| Maximale Ausgabe | 65,536; nativ ≤1,048,576−Eingabe* | 128,000 |
| Kontextfenster | 1,048,576 (nativ bei Google) | 1M |
| Denkmodus | low / medium / high; Standard: medium | adaptiv; Standard: high |
| Erzwungene Tools | auto dokumentiert* | beliebige / Tool-Aufruf gibt 400 zurück |
| Sampling | ignoriert; entfernen | einige Werte geben 400 zurück |
| Aufbewahrung | kein Limit angegeben | 30 Tage; kein ZDR |
| Eingabe | Text auf AIHubMix | Text, Bild, PDF† |
| Cutoff | März 2026 | Juni 2026 |
Hinweis: *Die höheren Limits von Carbon beziehen sich auf die nativen Long-Decode-Funktionen von Google; AIHubMix dokumentiert derzeit nur Texteingabe und Chat Completions, daher ist die Unterstützung über das Gateway nicht bestätigt. †Die Eingabemodalitäten von Fable stammen aus dem AIHubMix-Modellindex. *AIHubMix dokumentiert tool_choice="auto", aber die Carbon-spezifische Unterstützung ist nicht bestätigt. Für Fable sind 128,000 Token als dokumentiertes Modelllimit angegeben. ZDR steht für Zero Data Retention (keine Datenspeicherung).
Erzwungene Tool-Nutzung ist bei Fable ein hartes Ausschlusskriterium: „Erzwungene Tool-Nutzung (die Typen any und tool von tool_choice) gibt einen 400-Fehler zurück.“ Ein Agent, der in jedem Durchlauf ein bestimmtes Tool aufrufen muss, kann Fable nicht unverändert verwenden. Googles Carbon-Leitfaden empfiehlt sequenzielle Tool-Ausführungsdurchläufe; AIHubMix dokumentiert tool_choice="auto" in seinem Gemini-Leitfaden, doch die Carbon-spezifische Tool-Unterstützung über das Gateway ist weiterhin nicht bestätigt.
Die Aufbewahrungsrichtlinie kann Fable ausschließen. In der Übersicht heißt es, das Modell „erfordert eine 30-tägige Datenaufbewahrung und ist ohne ausdrückliche Genehmigung durch Anthropic nicht verfügbar, wenn keine Daten gespeichert werden dürfen“. In der hier herangezogenen Dokumentation für Carbon wird keine solche Einschränkung genannt; das ist jedoch keine Garantie. Regulierte Teams sollten beide Richtlinien vor der Bereitstellung bestätigen.
Das reguläre Limit von 65,536 Token bei Carbon reicht für die meisten Änderungen; bei der Generierung ganzer Dateien kann es erreicht werden. Der native Hintergrundmodus von Google ermöglicht bis zu 1,048,576 minus die Eingabe, berechnet Gebühren für Segmentübergänge und kann incomplete mit leerem Text zurückgeben, obwohl die Nutzung berechnet wird. AIHubMix hat diesen Ablauf nicht dokumentiert. Fable liefert seine 128,000 Token in einer Antwort.
Bei keinem der beiden Modelle lässt sich der Denkmodus deaktivieren. Carbon bietet low, medium und high, verwendet standardmäßig medium und ignoriert Sampling-Parameter. Fables „adaptives Denken ist immer eingeschaltet und lässt sich nicht ausschalten“, ist standardmäßig auf high eingestellt und gibt bei einigen Sampling-Werten einen 400-Fehler zurück.
Google stellte Carbon über sein Fairwind-Programm bereits vor der allgemeinen Verfügbarkeit für die Verteidigung bereit. Fables Klassifikatoren blockieren Anfragen zu Penetrationstests und Exploits und wechseln bei Aufgaben aus den Bereichen Cyber und Biologie auf andere Modelle. Bei Sicherheitstests ist das Ablehnungsverhalten wichtiger als ein Benchmark-Wert.
Opus 5.5 als Vergleichswert
Opus 5.5 ist kein Konkurrent, aber Anthropics eigener Vergleichswert. Bei $4/$20 erreicht es 59.11 bei AA, kostet pro Aufgabe $10.04, braucht 25.0 Minuten und liefert sein erstes Token nach 356.4 Sekunden – der längsten Wartezeit in der Tabelle (die AA-Zeile bezieht sich auf Max; der Standard ist medium). Beim Briefcase-Elo liegt es mit 1800.6 vorn, bei FrontierCode aber hinter Fable High und bei Terminal-Bench hinter Carbon High. Dennoch empfiehlt Anthropic weiterhin, bei den meisten Coding-Aufgaben mit Opus 5.5 zu beginnen.
Für wen eignet sich welches Modell?
Wählen Sie Fable 5.2, wenn anspruchsvolle Codeänderungen im Mittelpunkt stehen und Sie die besten gemessenen Ergebnisse bei FrontierCode und HLE möchten. Bei mittlerem Reasoning effort ist es günstiger und schneller – $3.80 und 7.8 Minuten gegenüber $6.59 und 23.3 bei Carbon –, während Carbon beim AA-Index höher abschneidet. Entscheiden Sie sich dafür, wenn Sie Bildeingaben oder einen Cutoff im Juni 2026 benötigen oder wenn 30 Tage Datenaufbewahrung und der Verzicht auf erzwungene Tool-Aufrufe akzeptabel sind.
Wählen Sie Carbon, wenn Terminal-Aufgaben überwiegen: Test-Fix-Schleifen, Shell-Automatisierung und mehrstufige Abläufe. Bei den aufgeführten Ergebnissen für Terminal-Bench 4.0 und AutomationBench-AA schneidet Carbon besser ab und ist bis zum 30. November bei High effort günstiger. Sein Google-natives Kontextfenster und die Obergrenzen für lange Ausgaben sind über AIHubMix nicht bestätigt; setzen Sie es daher zunächst nur für Text ein und verwenden Sie tool_choice="auto" erst, nachdem die Tool-Unterstützung von Carbon bestätigt wurde. Der Wert für Nicht-Halluzinieren ist höher, die Genauigkeit hingegen niedriger.
Wählen Sie Opus 5.5, wenn Sie Anthropic zufolge einen empfohlenen Ausgangspunkt und ein ausgewogenes Profil suchen; nehmen Sie dabei das langsame erste Token bei Max effort in Kauf.
Wählen Sie keines der beiden Modelle, wenn interaktive Latenz entscheidend ist: Das erste Token bei High effort dauert bei Fable 30.4 Sekunden und bei Carbon 67.1 Sekunden. Selbst Carbon Medium liegt mit 23.2 Sekunden noch weit von Chat-Geschwindigkeit entfernt.
Beide über AIHubMix ausführen
AIHubMix stellt beide Modelle über einen einzigen Schlüssel und einen gemeinsamen Chat-Completions-Endpunkt bereit. Carbons ID lautet gemini-4-carbon; die Modellseite dokumentiert Chat Completions, Texteingabe und Googles Einführungspreis. Die ID von Fable 5.2 lautet claude-fable-5-2; AIHubMix führt Chat Completions, Responses und Anthropic Messages sowie ein Kontextfenster von 1M und eine maximale Ausgabe von 128K auf. Die dokumentierte Oberfläche von Carbon ist eingeschränkter: Chat Completions, nicht die native Gemini API. Das Gateway versucht es außerdem beim nächstbesten Anbieter erneut, daher kann sich das Verhalten von einer Bereitstellung bei einem einzelnen Anbieter unterscheiden.
Der Schnellstart beschreibt die Authentifizierung und die Basis-URL. Ein Smoke-Test kann prüfen, ob beide IDs über denselben Schlüssel aufgelöst werden; für diesen Entwurf wurde kein Live-Test durchgeführt:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Damit wird das Routing geprüft, nicht die Leistungsfähigkeit: Es werden weder Tools noch lange Ausgaben getestet. Für einen aussagekräftigen Vergleich führen Sie dieselbe Agent-Trace mit beiden IDs aus und erfassen Sie Aufgabenzeit, Tokenverbrauch und Fehler. Die Vergleichsseite stellt Kontextfenster, Protokolle und Preise gegenüber.
FAQ
Ist Gemini 4 Carbon für agentisches Coding besser als Fable 5.2?
Keines der Modelle ist in allen Bereichen überlegen. Fable 5.2 liegt bei High effort in FrontierCode 2.0 und im Gesamtindex vorn; Carbon führt bei Terminal-Bench 4.0 und AutomationBench. Entscheiden Sie anhand der Arbeitslast, die der Agent tatsächlich bewältigen muss.
Warum kostet Fable 5.2 viermal so viel wie Carbon?
Zu den offiziellen Preisen kostet Fable 8 $/40 $ pro Million Token, während Carbons Einführungspreis bei 2 $/10 $ liegt – also das Vierfache für Eingabe und Ausgabe. Verglichen mit Carbons Standardpreis von 4 $/20 $ ab dem 1. Dezember ist es das Doppelte.
Kostet Fable 5.2 bei Medium tatsächlich weniger pro Aufgabe?
Zu Standardpreisen: ja. Fable kostet 3.80 $, Carbon Medium 6.59 $; außerdem dauert es 7.8 statt 23.3 Minuten. Carbons Einführungspreis pro Token verringert den Abstand; der Vergleich zu Standardpreisen ist jedoch langfristig aussagekräftiger.
Kann Fable 5.2 einen Tool-Aufruf erzwingen?
Nein. Anthropic dokumentiert, dass die Werte any und tool für tool_choice einen 400-Fehler auslösen. Agenten, die einen erzwungenen Aufruf benötigen, brauchen eine andere Schleife oder ein anderes Modell.
Halluziniert Carbon seltener als Fable 5.2?
Gemessen an AAs Omniscience-Maß für Nicht-Halluzinieren: ja. Bei High liegt Carbon bei 88.58% gegenüber 42.02%. Seine Genauigkeit ist mit 58.27% gegenüber 77.23% jedoch niedriger, daher ist auch die Wahrscheinlichkeit geringer, dass es die richtige Antwort gibt.
Lassen sich beide Modelle mit einem Schlüssel über AIHubMix ausführen?
Ja. Verwenden Sie gemini-4-carbon und claude-fable-5-2 mit demselben Schlüssel und derselben Basis-URL. AIHubMix dokumentiert Chat Completions für Carbon sowie Chat Completions, Responses und Messages für Fable.
Weiterlesen: die Gemini 4 Carbon-Reihe
- Bevor Sie sich für einen Konkurrenten entscheiden, klären Sie zunächst die Frage nach dem Schwestermodell: Gemini 4 Carbon vs. Argon: gleicher Preis – wann lohnt sich Carbon?
- Sobald Carbon eingebunden ist, gehen die ersten 400-Fehler und Timeouts meist auf die Konfiguration zurück, nicht auf das Modell: Gemini 4 Carbon API-Migration: 400-Fehler, Timeouts und Ausgabelimits
Quellen
- Gemini 4 Carbon jetzt verfügbar — Google, 10. November 2026.
- Claude Fable 5.2 — Anthropic, 9. November 2026.
- Überblick zu Claude Fable 5.2 — Anthropic-Dokumentation.
- Gemini 4 Carbon und Claude Fable 5.2 — Artificial Analysis, Snapshot vom 11. November 2026.
- Gemini 4 Carbon auf AIHubMix — Modellseite und Preise.