

Am 2026-11-03/04 wurde die APB-Full-Suite über AIHubMix mit DeepSeek V4.1 Flash 1017 bei fünf Anbietern durchgeführt. Bei allen Anbietern kamen dieselben Fragen, Parameter und Request-Skripte zum Einsatz; die fünf Anbietereinträge finden sich auf der Modellseite. Dieses APB-Profil bezieht sich ausschließlich auf den offiziellen DeepSeek-Kanal. Der Zugriff erfolgt über die offizielle DeepSeek-Lieferantenroute von AIHubMix und nicht über eine direkte Verbindung zur DeepSeek-API.
Dieser Beitrag berichtet ausschließlich Scores, ohne Anbieter zu ranken oder einen Anbieter zu empfehlen: Q 42.45, F 94.00, P 86.14, K 98.38 und R 100. Q, F, P und R sind die Scores der vier Bereiche; K ist ein Subscore von P. Der Gesamtscore von 73.76 ist ein zusammenfassender Index, keine Zertifizierung, und hat kein Konfidenzintervall. Bewertungsmaßstab ist der AIHubMix Provider Benchmark Standard v2.0.
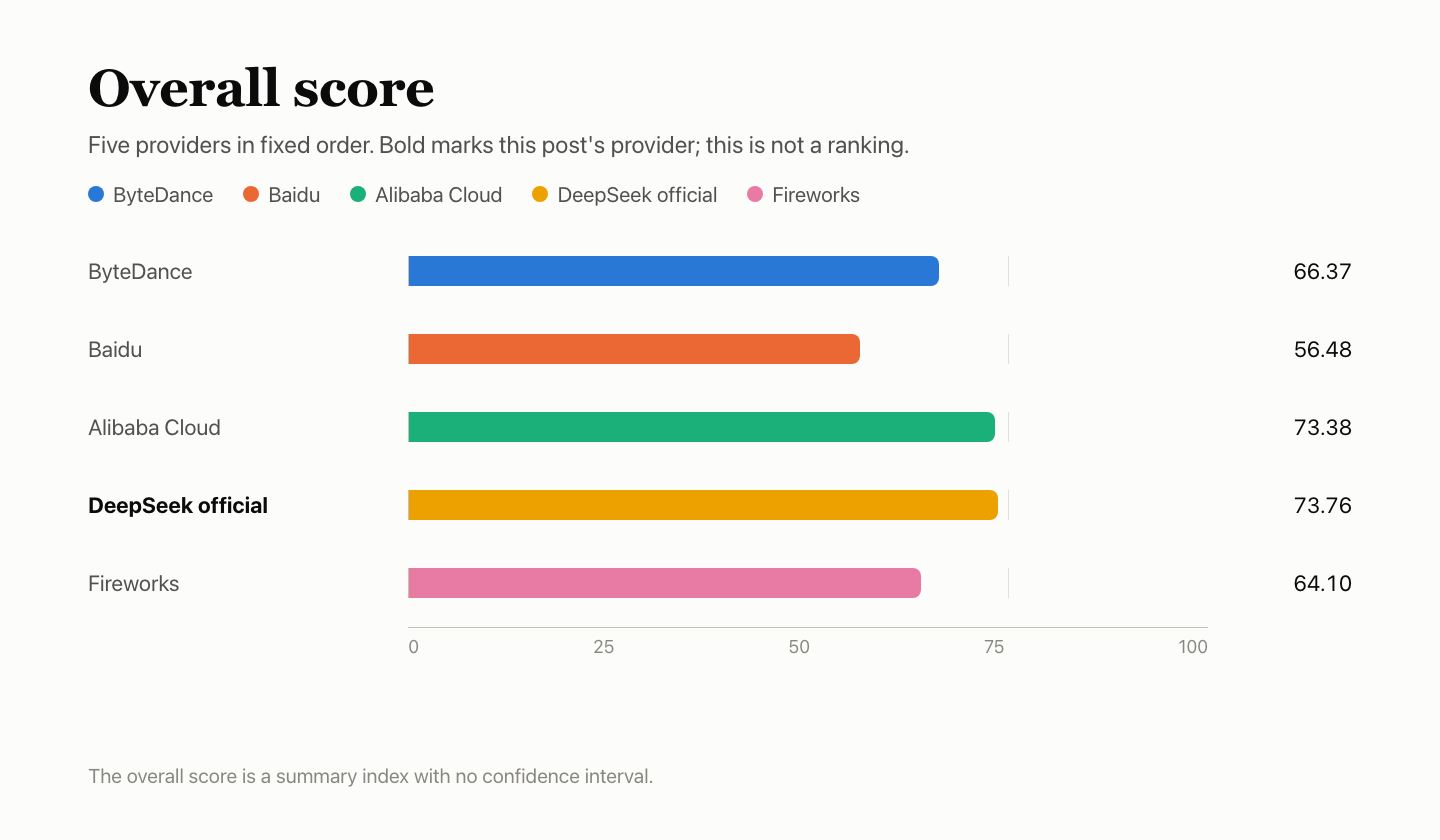
Scores von fünf Anbietern
Fett markiert den Anbieter dieses Beitrags. Die Anbieter sind in einer festen Reihenfolge aufgeführt, nicht nach Rang. K ist ein Subscore von P mit einem Anteil von 20% und wird separat zur Referenz aufgeführt. Der Gesamtscore ist ein zusammenfassender Index ohne Konfidenzintervall. Der offizielle DeepSeek-Kanal und Alibaba Cloud unterscheiden sich beim Gesamtscore um 0.37 und sind nicht voneinander zu unterscheiden.
Auf einen Blick
- Antwortqualität: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Sieben HLE-Ausgaben wurden am max_tokens-Limit abgeschnitten und als falsch gewertet. Dieser Kanal dient den anderen vier als Q-Baseline.
- Funktionsunterstützung: F 94.00. 137 von 147 gewerteten Checks bestanden. Weitere 27 Checks, die von exakten Token-Anzahlen abhängen, wurden für ungültig erklärt und aus dem Nenner ausgeschlossen.
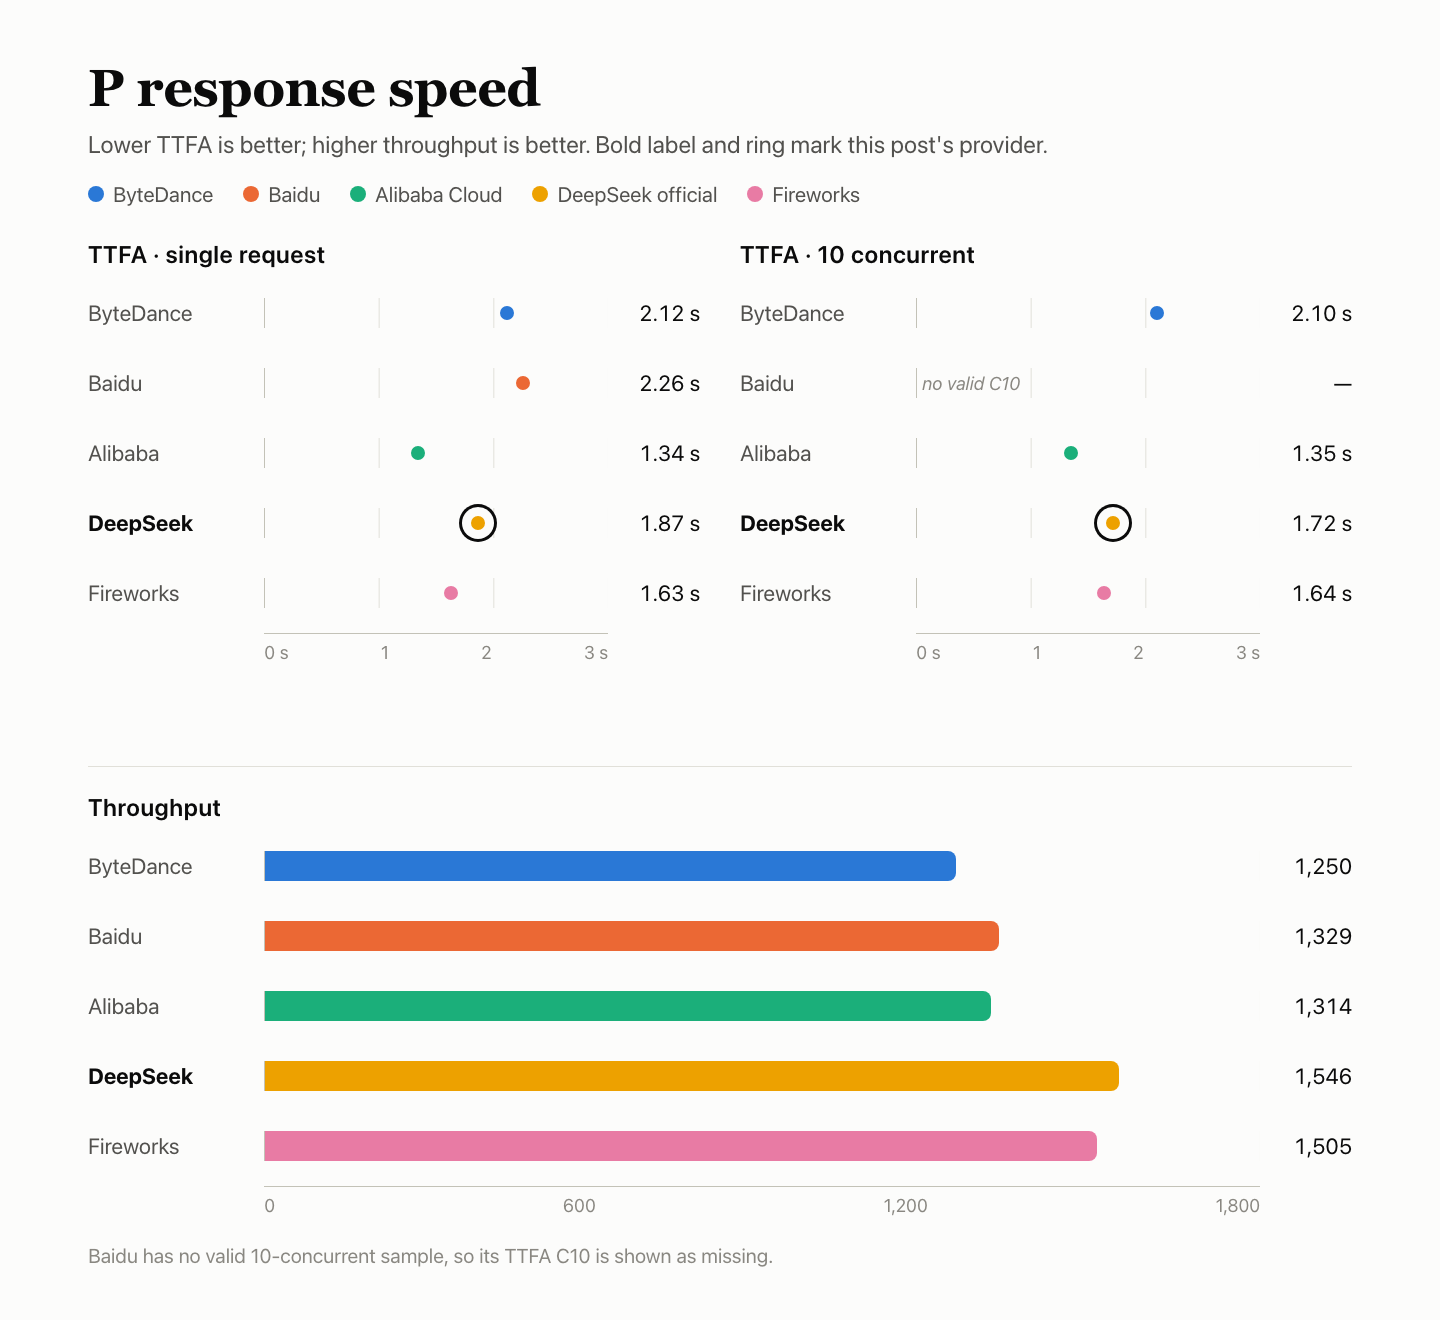
- Antwortgeschwindigkeit: P 86.14. Im ersten Fenster mit Einzelkonkurrenz waren 15 von 30 Requests ungültig (12 × 503, 2 × Deadline, 1 × Read-Timeout) und wurden mit unendlich gewertet; Median bis zum ersten Token: 1.87 s (nur gültige Requests: 1.72 s); bei 10-facher Konkurrenz: 1.72 s; TPOT: 2.84 ms.
- Cache: K 98.38. Alle 18 Hot-Requests bei 8k und 32k erzielten einen Cache-Treffer; die Cold-Kontrollen lasen keinen Cache.
- Servicestabilität: R 100. Alle 300 dedizierten Requests waren beim ersten Versuch erfolgreich.
Testaufbau
Die Requests liefen über AIHubMix und wurden über die offizielle DeepSeek-Lieferantenroute geleitet; der Schnellstart beschreibt die Zugriffskonfiguration.
| Punkt | Details |
|---|---|
| Modell | DeepSeek V4.1 Flash 1017 |
| Angeforderte Modell-ID | deepseek-flash |
| Zurückgegebener Modellname | deepseek-flash |
| Zugriffsroute | Offizielle DeepSeek-Lieferantenroute von AIHubMix; keine direkte Verbindung zur DeepSeek-API |
| Parameter | Nicht-Denkmodus, temperature 1.0, max_tokens 16,384, Timeout 300 s, keine automatischen Wiederholungen |
| Denkmodus deaktiviert | Alle Requests verwendeten reasoning_effort=none |
| Zeitraum | 2026-11-03 18:07 – 11-04 16:33 UTC+8; fünf Anbieter nutzten denselben Mac mini, dasselbe Netzwerk und dasselbe Konto |
| Stichproben | Antwortqualität: 4,250 Versuche (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); Funktionsfälle: 60 × 3 Fenster; Geschwindigkeit: 90 bei Einzelkonkurrenz und 90 bei 10-facher Konkurrenz; Stabilität: 300; Cache: 30 (je drei Gruppen mit 8k- und 32k-Präfixen) |
Q — Antwortqualität: 42.45
Die Suite umfasst BFCL mit 500 Fragen × 3 Durchläufen, HLE mit 250 × 10 und AA-LCR mit 25 × 10. BFCL wird anhand automatischer Regeln bewertet; HLE und AA-LCR werden vom Bewertungsmodell deepseek-flash beurteilt. Alle fünf Anbieter beantworteten dieselben Fragen. Zehn Antworten konnten nicht bewertet werden und wurden entfernt; damit blieben 4,240 bewertete Versuche.
| Benchmark | Fragen | Richtig | Genauigkeit | Fehler |
|---|---|---|---|---|
| BFCL-Tool-Aufrufe | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| HLE anspruchsvolle Fragen und Antworten | 250 × 10 | 375/2,490 | 15.06% | 7 |
| AA-LCR-Schlussfolgerungen aus langen Dokumenten | 25 × 10 | 133/250 | 53.20% | 0 |
| Gesamt · 95%-KI 40.08%–44.73% | 4,240 bewertet | 1,800/4,240 | 42.45% | 7 |
Servicefehler – ein fehlgeschlagener Request oder eine abgeschnittene Ausgabe – bleiben im Nenner und zählen als falsch. Hier betrifft das sieben HLE-Ausgaben, die das max_tokens-Limit erreichten. BFCL wird automatisch bewertet; HLE und AA-LCR werden von einem Bewertungsmodell beurteilt.
Die BFCL-Nenner sind Summen über drei Durchläufe.
| BFCL-Kategorie | Bestanden | Erfolgsquote |
|---|---|---|
| simple_python — eine Funktion, korrekter Aufruf und korrekte Argumente | 334/360 | 92.78% |
| multiple — aus mehreren Funktionen die richtige auswählen | 268/300 | 89.33% |
| parallel — dieselbe Funktion mehrmals parallel aufrufen | 271/300 | 90.33% |
| parallel_multiple — mehrere verschiedene Funktionen parallel aufrufen | 207/240 | 86.25% |
| irrelevance — keine Funktion ist relevant, es sollte keine aufgerufen werden | 113/150 | 75.33% |
| ahm_multi_turn — Tool-Kette mit drei Stufen | 99/150 | 66.00% |
Vergleich mit den anderen vier
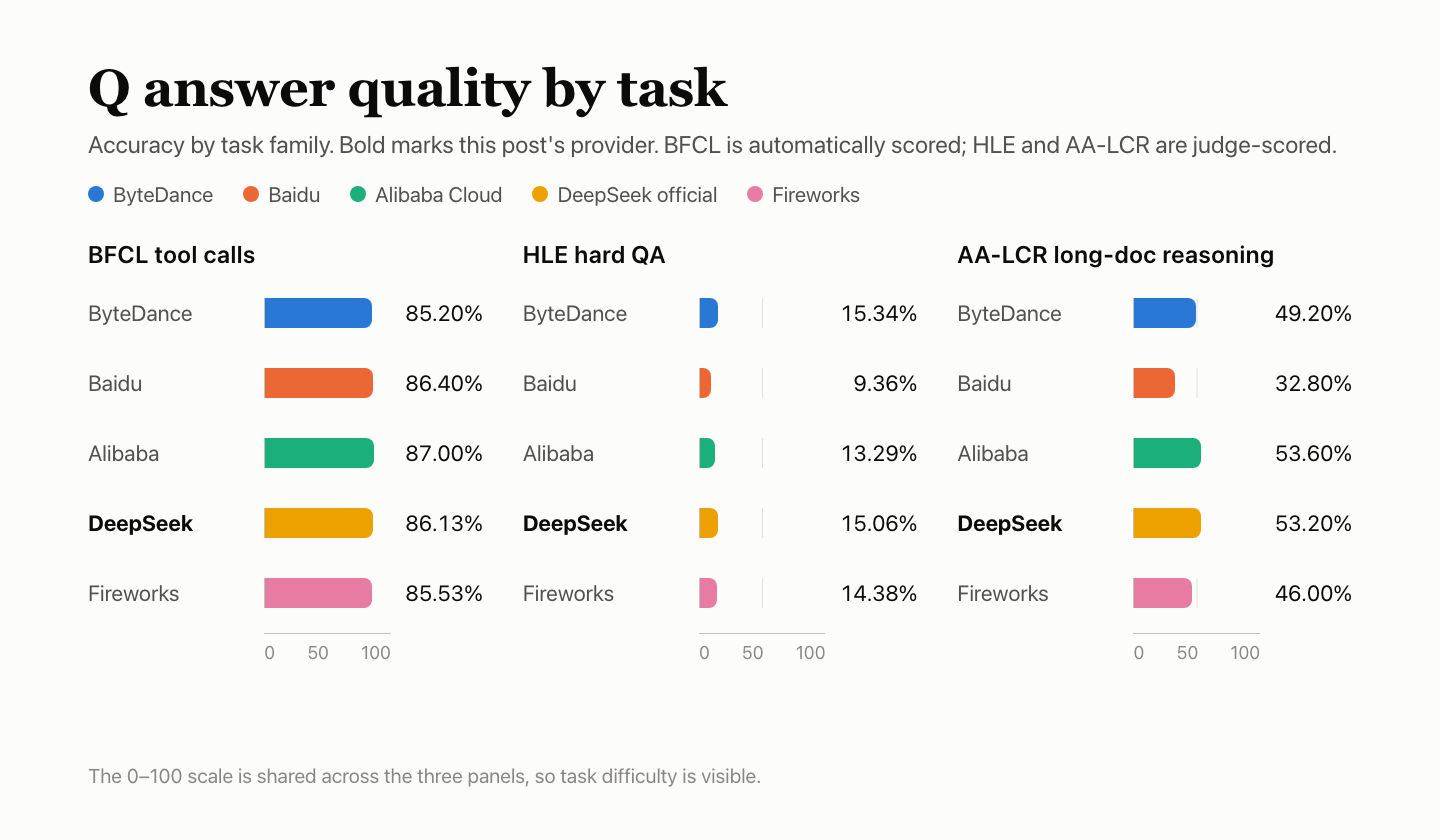
Jede Differenz wird in Prozentpunkten gegenüber dieser Baseline angegeben, mit einem 95%-Intervall als Whisker; wenn ein Intervall die 0 schneidet, ist kein Unterschied erkennbar. Das Bewertungsmodell gehört zur selben DeepSeek-Familie wie das getestete Modell und wurde nicht kalibriert; die Bewertungen von HLE und AA-LCR könnten daher großzügig ausfallen.
F — Funktionsunterstützung: 94.00
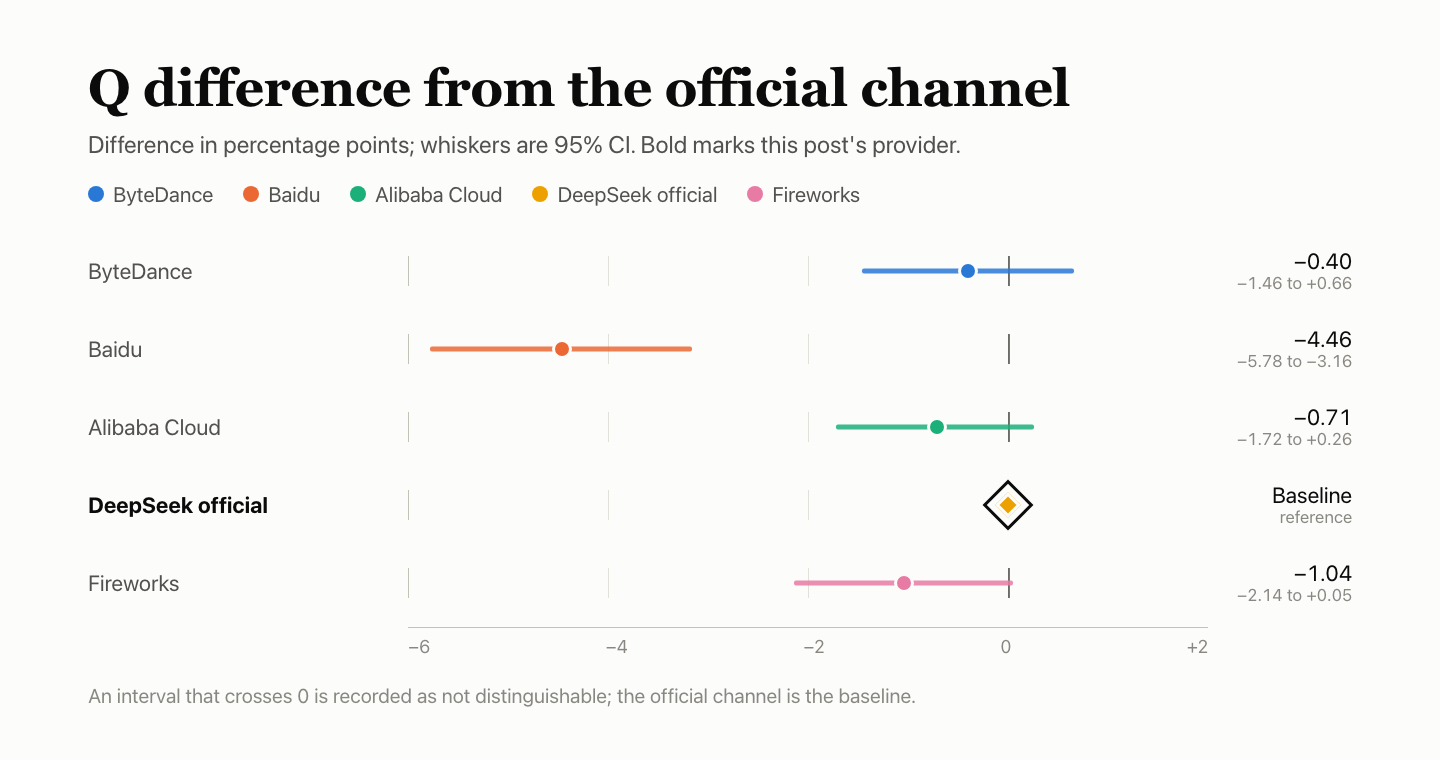
Die Funktionsfälle prüfen das Protokollverhalten, nicht die Antwortqualität. In jedem von drei Fenstern liefen 60 Fälle in sechs Gruppen – insgesamt 180 Checks –, bewertet anhand des Formats, das in der Dokumentation des jeweiligen Anbieters spezifiziert ist. Nicht zutreffende, ungültige und nicht beobachtete Checks werden aus dem Nenner herausgenommen. Dieser Kanal bestand 137 von 147 gewerteten Checks und erzielte gewichtet 94.00; der gewichtete Score entspricht nicht einfach 137/147.
| Gruppe | Gewichtung | Bestanden | Ausgeschlossen | Gruppenscore |
|---|---|---|---|---|
| Streaming und Nachrichtenprotokoll | 20% | 27/27 | 3 | 100.00 |
| Tool-Schnittstelle | 20% | 30/30 | — | 100.00 |
| Ausgabebeschränkungen und Parameter | 20% | 30/30 | — | 100.00 |
| Kontext und Zustand | 15% | 14/15 | 15 | 93.33 |
| Fehler und Wiederherstellung | 15% | 24/30 | — | 80.00 |
| Abrechnung und Cache-Protokoll | 10% | 12/15 | 15 | 80.00 |
| Gesamt · gewichtet | — | 137/147 | 33 | 94.00 |
Der gewichtete Score richtet sich nach den Gruppen-Gewichtungen; er entspricht nicht der Zahl bestandener Checks geteilt durch 147.
| Fehlgeschlagener Fall | Fenster mit Fehlern | Grund |
|---|---|---|
| Fehlerhafte Nachrichten (Fehler und Wiederherstellung) | 3/3 | 400 zurückgegeben, aber der Body war leer und enthielt keine strukturierte Fehlerbeschreibung |
| Fehlerhafte stream_options (Fehler und Wiederherstellung) | 3/3 | 400 zurückgegeben, aber der Body war leer und enthielt keine strukturierte Fehlerbeschreibung |
| Abrechnung von Denk-Token (Abrechnung und Cache-Protokoll) | 3/3 | Es wurde keine Anzahl der Denk-Token zurückgegeben |
| Request-Isolierung (Kontext und Zustand) | 1/3 | Der erste Schritt antwortete nicht wie erforderlich ausschließlich mit STORED, daher konnte die Isolierungsprüfung nicht fortgesetzt werden |
Ausgeschlossene Checks zählen weder als bestanden noch als fehlgeschlagen.
| Status | Fall | Anzahl | Grund |
|---|---|---|---|
| Nicht beobachtet | Streaming-Stoppsequenz | 3 | Nach dem vorherigen Schritt wurde der Request für diesen Schritt nicht gesendet und konnte daher nicht bewertet werden |
| Ungültig | 10k lange Eingabe; innerhalb des Kontextlimits; 32k lange Eingabe; 100k lange Eingabe; Kontextlimit überschritten; native Eingabeanzahl; Tool-Definitionen in der Eingabe gezählt; Eingabeanzahl vor und nach dem Cache konsistent; Eingabeanzahl bei Streaming und ohne Streaming konsistent | 27 | Die auf der Testseite festgelegte Vorlage für die native Anzahl stimmte nicht mit der von diesem Kanal gemeldeten Nutzung überein; daher wurden Checks, die von exakten Anzahlen abhängen, für ungültig erklärt und aus dem Nenner ausgeschlossen |
| Nicht zutreffend | Explizites cache_control | 3 | Vorab als von dieser Schnittstelle nicht unterstützt erfasst |
Die 27 ungültigen Checks sind die Fälle zu langen Eingaben, Kontextlimits, nativen Anzahlen und Cache-Konsistenz in der Liste. Da die festgelegte Vorlage nicht mit der von diesem Kanal gemeldeten Nutzung übereinstimmte, wurde jeder Check, der von einer exakten Anzahl abhing, ausgeschlossen statt bewertet.
Zwei Fälle schlugen bei allen fünf Anbietern fehl: fehlerhafte messages und fehlerhafte stream_options. Beide gaben einen 400-Fehler mit leerem Body zurück, sodass der Client keine strukturierte Fehlerbeschreibung erhielt. Das gemeinsame Muster deutet eher auf die AIHubMix-Gateway-Ebene hin, die separat untersucht werden muss. Auch die Abrechnung von Denk-Token schlug bei allen fünf Anbietern fehl, allerdings aus unterschiedlichen Gründen: ByteDance und Fireworks meldeten weiterhin Denk-Token, obwohl der Denkmodus deaktiviert war, während die anderen drei keine Anzahl der Denk-Token zurückgaben.
Vergleich mit den anderen vier
P — Antwortgeschwindigkeit: 86.14
Jeder Request enthielt etwa 10,000 Eingabe-Token und forderte etwa 1,100 Ausgabe-Token an. In drei Fenstern wurden jeweils 30 Requests bei Einzelkonkurrenz und 30 bei 10-facher Konkurrenz gesendet, insgesamt 180.
| Metrik | Wert |
|---|---|
| TTFA bis zum ersten Token | Einzelkonkurrenz: Median 1.87 s (Median gültiger Requests: 1.72 s). 10-fache Konkurrenz: Median 1.72 s |
| TPOT | Einzelkonkurrenz: 2.84 ms/Token. 10-fache Konkurrenz: 2.67 ms/Token |
| Gültiger Durchsatz (Goodput) | 10-fache Konkurrenz: 1,546.0 Token/s |
| Gültige Requests | Einzelkonkurrenz 75/90 (Fenster 1: 15/30); 10-fache Konkurrenz 90/90. Ungültig: 12 × 503 service_unavailable_error, 2 × Deadline erreicht, 1 × Read-Timeout |
| Teil-Scores | TTFA 51.65, TPOT 100.00, Durchsatz 100.00; bei TTFA und TPOT gilt der niedrigere Wert der beiden Stufen, gewichtet mit 35% / 35% / 30%; Antwortscore 83.08 |
| Zusammensetzung von P | Antwortscore 83.08 mit 80%, Cache K 98.38 mit 20%; P 86.14 |
Alle 15 ungültigen Requests fielen im ersten Fenster mit Einzelkonkurrenz an: 12 gaben 503 zurück, bei 2 wurde die Deadline erreicht und 1 lief in einen Read-Timeout. Ungültige Requests werden mit unendlich gewertet, daher beträgt der angegebene Median 1.87 s. Betrachtet man nur gültige Requests, beträgt der Median 1.72 s. Bei 10-facher Konkurrenz liegt der Median ebenfalls bei 1.72 s. TPOT beträgt bei Einzelkonkurrenz 2.84 ms/Token und bei 10-facher Konkurrenz 2.67 ms/Token.
Vergleich mit den anderen vier
Fünf Anbieter nutzten denselben Mac mini, dasselbe Netzwerk und dasselbe Konto. Die drei Fenster wurden Anbieter für Anbieter geplant, sodass sich die Erhebungszeiträume nicht vollständig überschneiden; kleine Abstände sollten nicht überinterpretiert werden.
K — Cache: 98.38
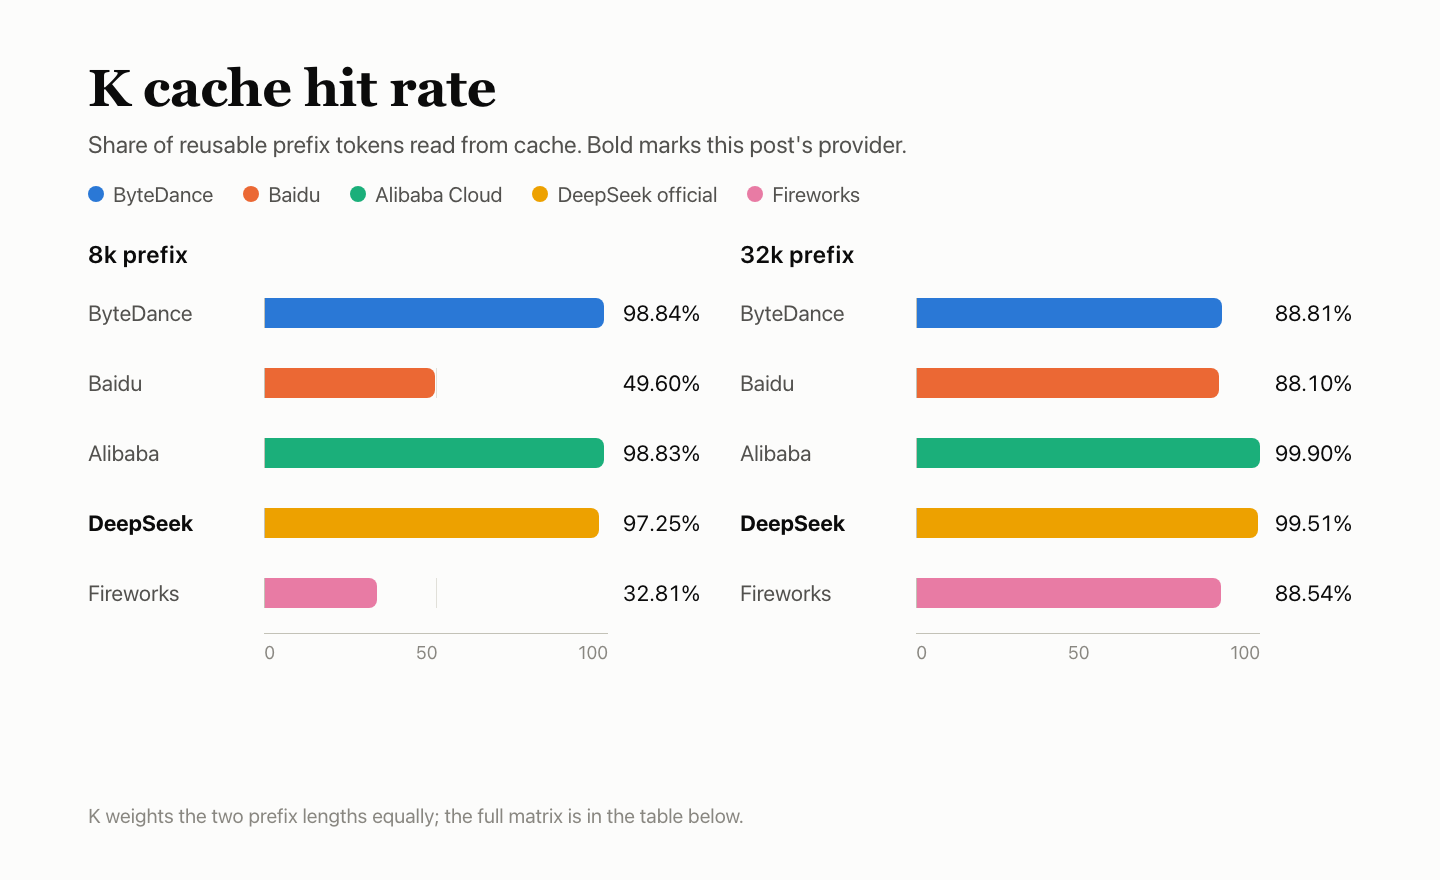
Jede Gruppe sendet fünf Requests. Der erste legt ein festes 8k- oder 32k-Präfix im Cache an. Bei den Requests zwei bis vier bleibt das Präfix unverändert und nur die letzte Frage ändert sich, nach 5, 30 und 120 Sekunden. Der fünfte verwendet als Cold-Kontrolle ein neues Präfix. Drei Fenster × zwei Längen ergeben 30 Requests. K teilt die bei Hot-Requests gelesenen Cache-Token durch die wiederverwendbare Token-Anzahl; beide Längen zählen jeweils zur Hälfte. K macht 20% von P aus. Die API-Dokumentation von DeepSeek beschreibt das Kontext-Caching.
| Präfix | Fenster | Initialisierung | +5 s | +30 s | +120 s | Cold-Kontrolle |
|---|---|---|---|---|---|---|
| 8k | Fenster 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Fenster 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Fenster 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Fenster 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Fenster 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Fenster 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Bei den 8k-Hot-Requests erzielten alle 9 von 9 einen Cache-Treffer und lasen jeweils 7,808 Token: 70,272 gelesen gegenüber 72,261 wiederverwendbaren Token, 97.25. Bei den 32k-Hot-Requests erzielten alle 9 von 9 einen Cache-Treffer und lasen jeweils 31,872 Token: 286,848 gegenüber 288,270, 99.51. Die Cold-Kontrollen lasen keinen Cache. K beträgt über beide Längen hinweg 98.38.
Vergleich mit den anderen vier
R — Servicestabilität: 100
Die 300 Requests decken kurze Texte, 10k lange Eingaben, Tool-Aufrufe und mehrstufigen Verlauf ab und wurden über drei Fenster bei Einzelkonkurrenz gesendet. Geprüft werden nur Gültigkeit und Vollständigkeit beim ersten Versuch – nicht die Richtigkeit der Antwort –, und es gibt keine Wiederholungen. Fehler bei Antwortqualität und Geschwindigkeit werden unter Q und P erfasst und nicht noch einmal unter R.
| Request-Typ | Beim ersten Versuch erfolgreich |
|---|---|
| Kurzer Text | 120/120 |
| 10k lange Eingabe | 90/90 |
| Tool-Aufrufe | 60/60 |
| Mehrstufiger Verlauf | 30/30 |
| Gesamt · 95%-KI 98.78%–100% | 300/300 |
Alle 300 Anfragen lieferten beim ersten Versuch eine gültige, vollständige Antwort. R 100 umfasst nur diese 300 eigens dafür vorgesehenen Anfragen; das bedeutet nicht, dass der gesamte Pfad fehlerfrei war. Bei 300 Erfolgen liegt die Untergrenze des 95%-Konfidenzintervalls bei 98.78%. Die Daten sprechen also dafür, dass die Fehlerrate wahrscheinlich unter 1.22% liegt.
Im Vergleich zu den anderen vier
R umfasst nur die 300 eigens dafür vorgesehenen Anfragen; Fehler bei Antwortqualität und Geschwindigkeit werden unter Q und P erfasst und nicht erneut unter R gezählt.
| Anbieter | Erfolgsrate beim ersten Versuch | 95%-KI |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek offiziell | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Ist dies eine direkte Verbindung zur API von DeepSeek?
Nein. Die Anfragen laufen über AIHubMixs offizielle DeepSeek-Anbieterroute und werden nicht direkt an die API von DeepSeek gesendet.
Warum dient der offizielle DeepSeek-Kanal als Q-Baseline?
Es ist DeepSeeks offizieller Kanal für dasselbe Modell. Daher werden die Ergebnisse der anderen vier Anbieter zur Antwortqualität als Abweichungen davon angegeben. Die Rolle als Baseline bedeutet keine Rangfolge der Antwortqualität.
Was geschah im ersten Geschwindigkeitsfenster mit einer einzelnen gleichzeitigen Anfrage?
15 von 30 Anfragen waren ungültig: 12 lieferten 503, 2 erreichten die Deadline und 1 lief in einen Lese-Timeout. Sie werden mit unendlicher Dauer gezählt, daher liegt der Median bei 1.87 s; berücksichtigt man nur gültige Anfragen, beträgt er 1.72 s.
Was sind die 27 ungültigen Funktionsprüfungen?
Sie hängen von exakten Token-Anzahlen ab: lange Eingaben, Kontextlimits, native Eingabezählungen und die Konsistenz der Cache-Eingaben. Die festgelegte Vorlage für native Zählungen auf der Testseite stimmte nicht mit der vom Kanal gemeldeten Nutzung überein. Daher wurden die Prüfungen aus dem Nenner ausgeschlossen, statt als Fehler gewertet zu werden.
Warum garantiert R 100 nicht, dass die Route fehlerfrei ist?
R umfasst nur die 300 eigens dafür vorgesehenen Stabilitätsanfragen. Fehler während der Läufe zur Antwortqualität und Geschwindigkeit werden unter Q und P erfasst. Bei 300 Erfolgen von 300 liegt die Untergrenze des 95%-Konfidenzintervalls bei 98.78%. Die Fehlerrate liegt also wahrscheinlich unter 1.22%, ist aber nicht nachweislich null.
Wie unterscheidet der Cache-Test zwischen warmen und kalten Lesezugriffen?
Jede Gruppe speist ein 8k- oder 32k-Präfix ein und wiederholt das Präfix nach 5, 30 und 120 Sekunden mit einer neuen abschließenden Frage. Anschließend wird als Kaltkontrolle ein neues Präfix gesendet. Bei beiden Längen trafen 9 von 9 warmen Anfragen, und bei jeder Kaltkontrolle wurden null gecachte Token gelesen.
Weiterlesen: die DeepSeek V4.1 Flash-Reihe
- ByteDance liegt bei Q innerhalb von 0.40 Punkten dieser Baseline, doch die Ergebnisse zu Funktionsunterstützung und Cache unterscheiden sich: DeepSeek V4.1 Flash bei ByteDance: Tool-Aufrufe stimmen, Abrechnung nicht.
- Bei Baidu gingen Anfragen durch
no_available_channelverloren, was sich sowohl in Q als auch in P zeigt: DeepSeek V4.1 Flash bei Baidu: Kein verfügbarer Kanal beeinträchtigt Q und P. - Alibaba Cloud weicht insgesamt um 0.37 ab, ein Unterschied, der sich nicht feststellen lässt: DeepSeek V4.1 Flash bei Alibaba Cloud: 1.34s bis zum ersten Token, 99.37 Cache.
- Fireworks erzielte bei den warmen 8k-Anfragen 3 von 9 Treffern, hier waren es 9 von 9: DeepSeek V4.1 Flash bei Fireworks: leere Stop-Antworten, 3/9 Cache-Treffer.


