

Am 2026-11-03/04 wurde die APB Full Suite mit DeepSeek V4.1 Flash 1017 bei fünf Anbietern über AIHubMix ausgeführt. Bei allen Anbietern kamen dasselbe Modell, dieselben Fragen und Parameter sowie dieselben Request-Skripte zum Einsatz. Das Modell ist auf der AIHubMix-Modellseite aufgeführt, die fünf Anbietereinträge finden sich auf der Modellseite. Dieses APB-Profil behandelt ausschließlich Alibaba Cloud: was die einzelnen Abschnitte messen und welche Ergebnisse erzielt wurden.
Dieser Beitrag gibt Ergebnisse wieder, ohne die Anbieter zu ranken oder einen davon zu empfehlen. Q, F, P, K und R stehen an erster Stelle; K ist ein Teilwert von P. Der Gesamtscore ist ein zusammenfassender Index, keine Zertifizierung, und hat kein Konfidenzintervall. Die Bewertungsregeln sind im AIHubMix Provider Benchmark Standard v2.0 festgelegt.
Ergebnisse der fünf Anbieter
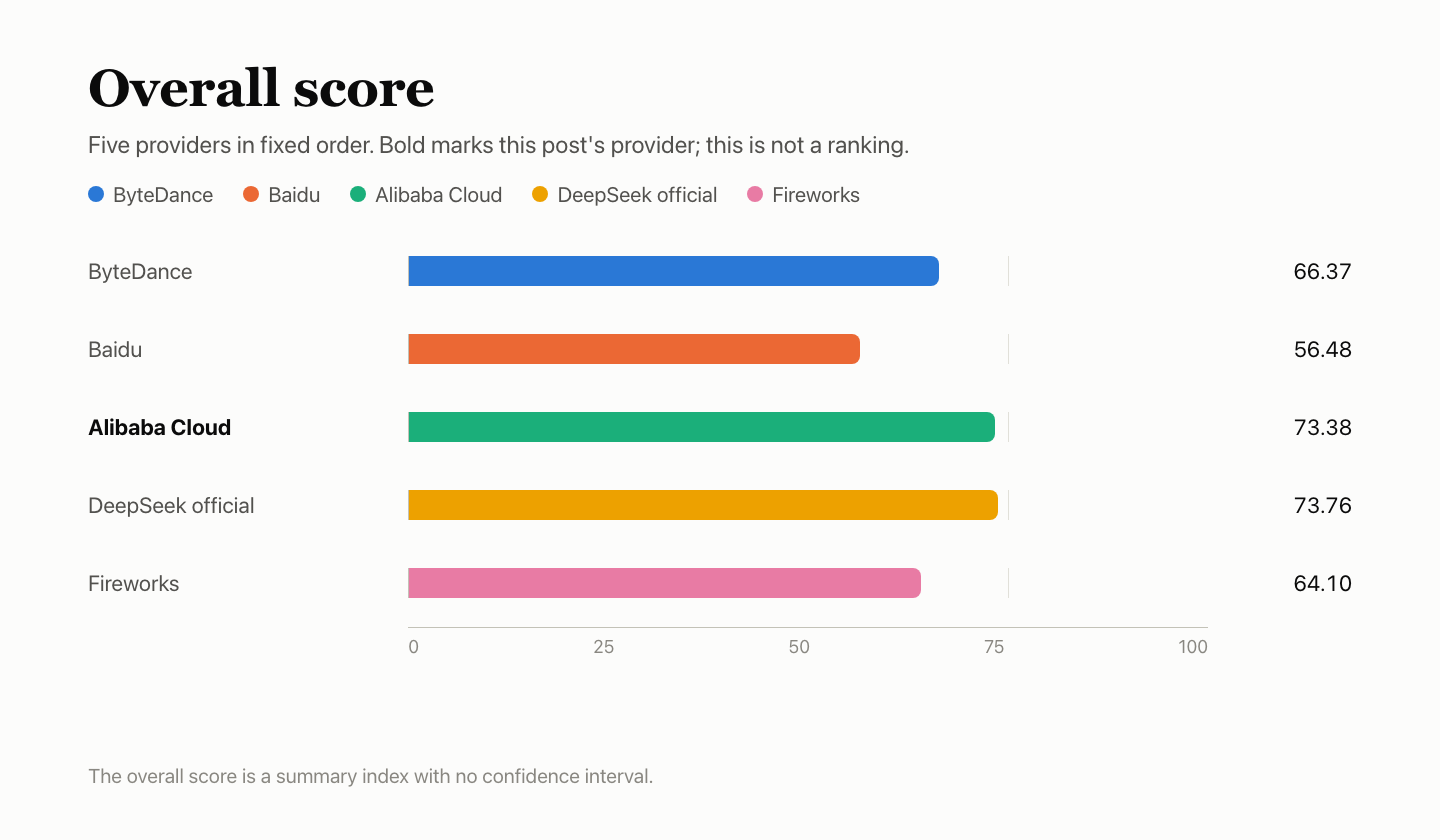
Fett markiert den Anbieter dieses Beitrags. Die Anbieter erscheinen in einer festen Reihenfolge, nicht als Rangliste. K ist ein Teilwert von P mit einer Gewichtung von 20% und wird separat als Referenz ausgewiesen. Der Gesamtscore ist ein zusammenfassender Index ohne Konfidenzintervall. Der Unterschied im Gesamtscore zwischen dem offiziellen DeepSeek-Kanal und Alibaba Cloud beträgt 0.37 und ist nicht signifikant.
Auf einen Blick
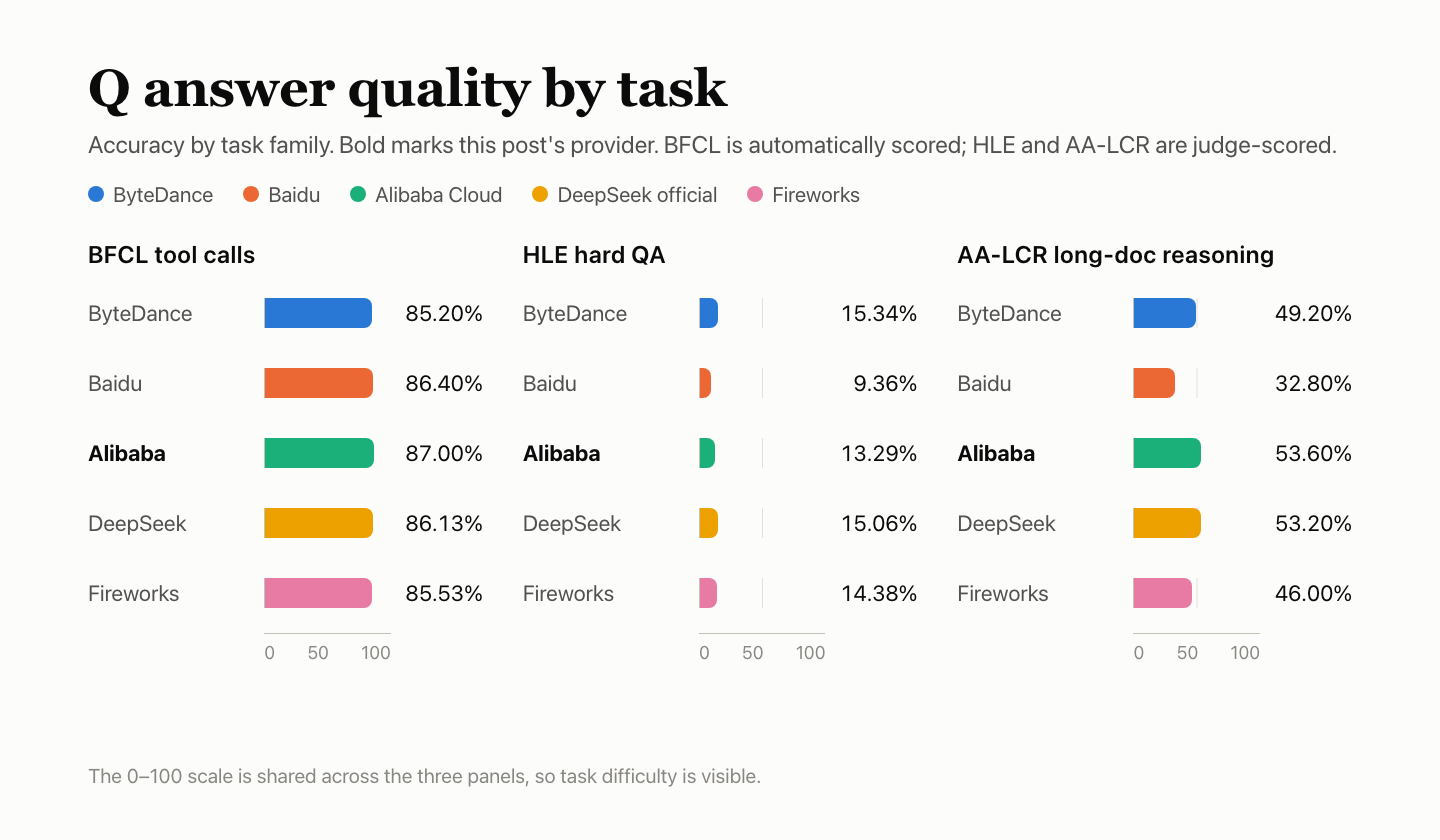
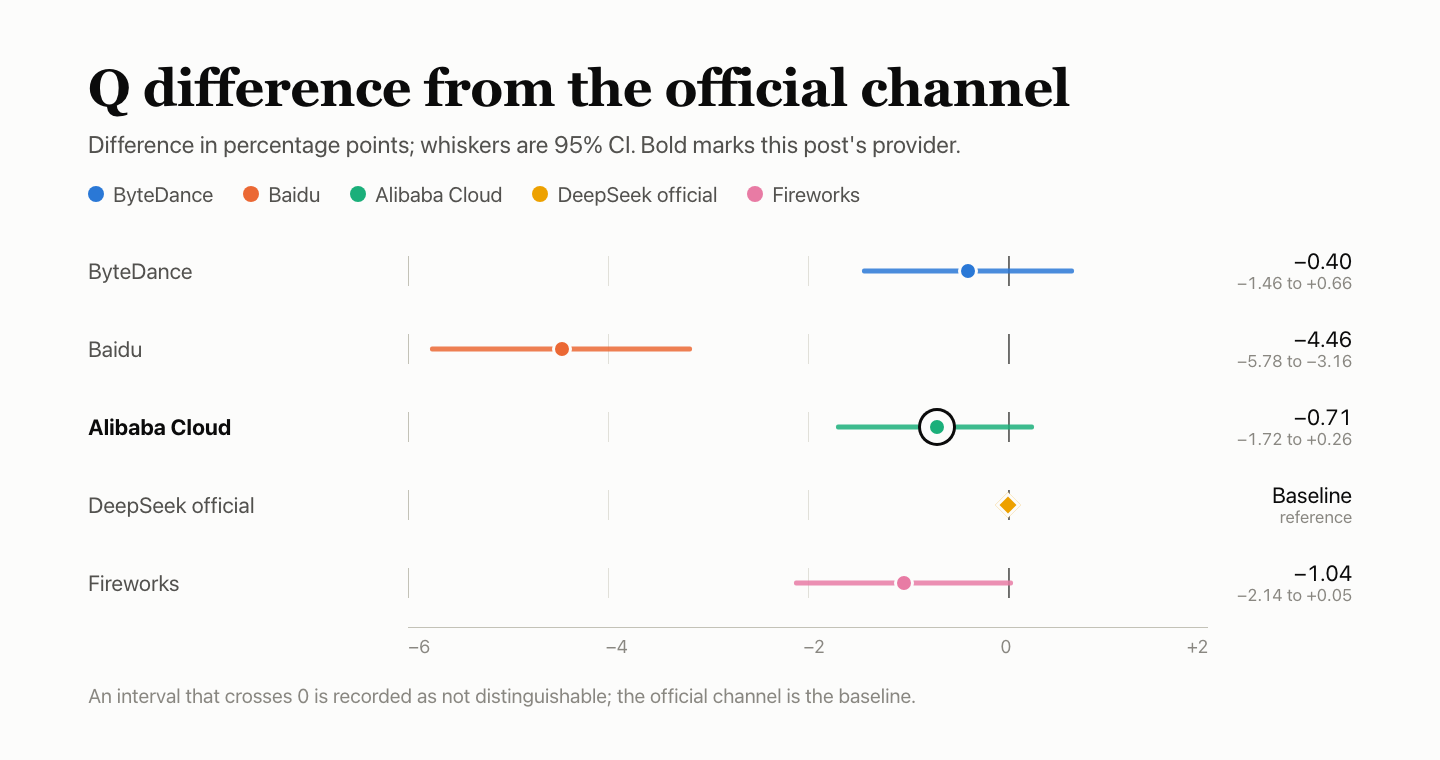
- Antwortqualität: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. Gegenüber dem offiziellen Kanal beträgt der Unterschied −0.71 Prozentpunkte; das 95%-Intervall reicht von −1.72 bis +0.26. Die beiden Ergebnisse sind daher nicht unterscheidbar.
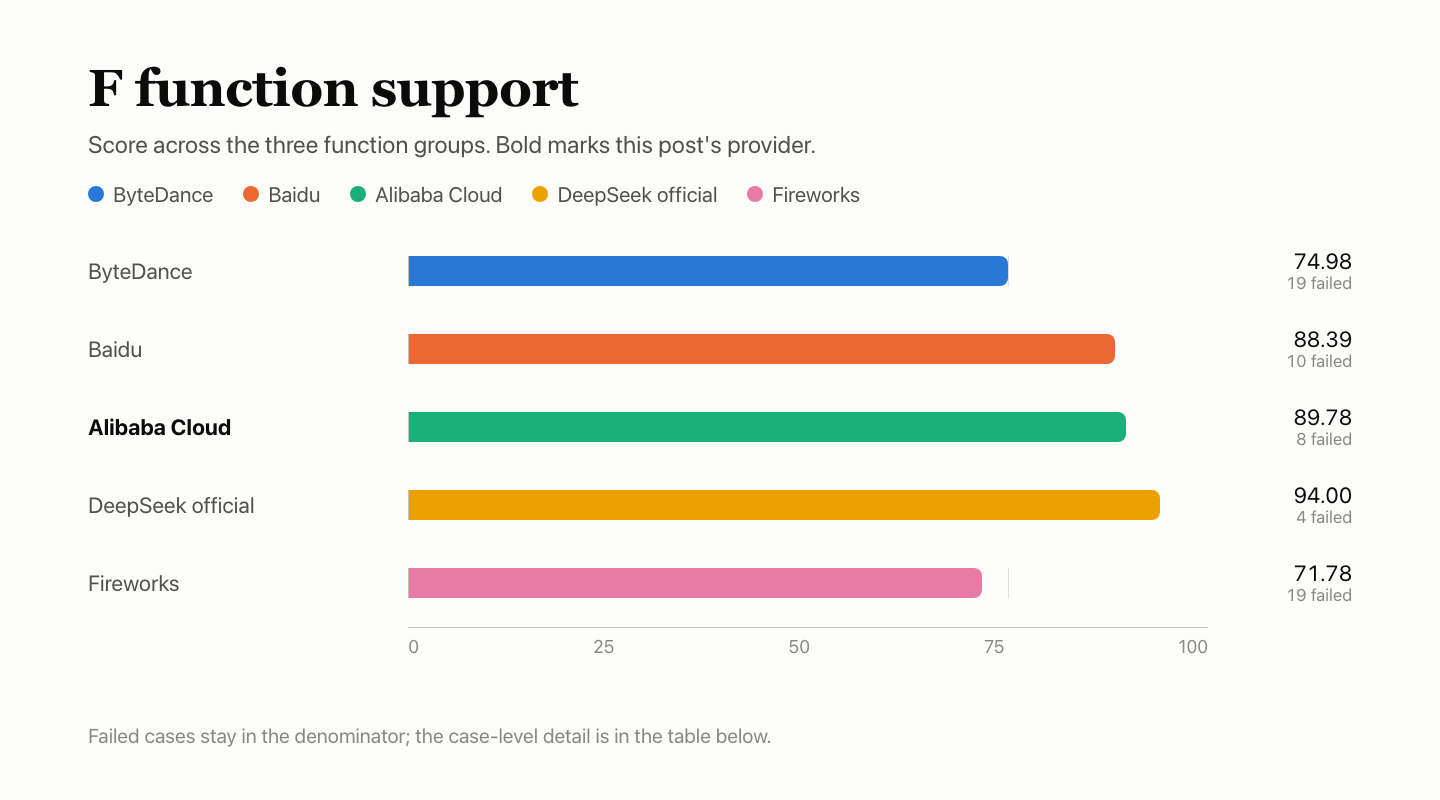
- Funktionsunterstützung: F 89.78. 155 der 177 Prüfungen im Nenner wurden bestanden. Ein ungültiges Tool-Schema ergab 503 statt eines Parameterfehlers, bei einer Überschreitung des Kontextfensters wurde nicht der dokumentierte Fehlertyp zurückgegeben, und ein isoliertes Tool-Ergebnis ergab 200.
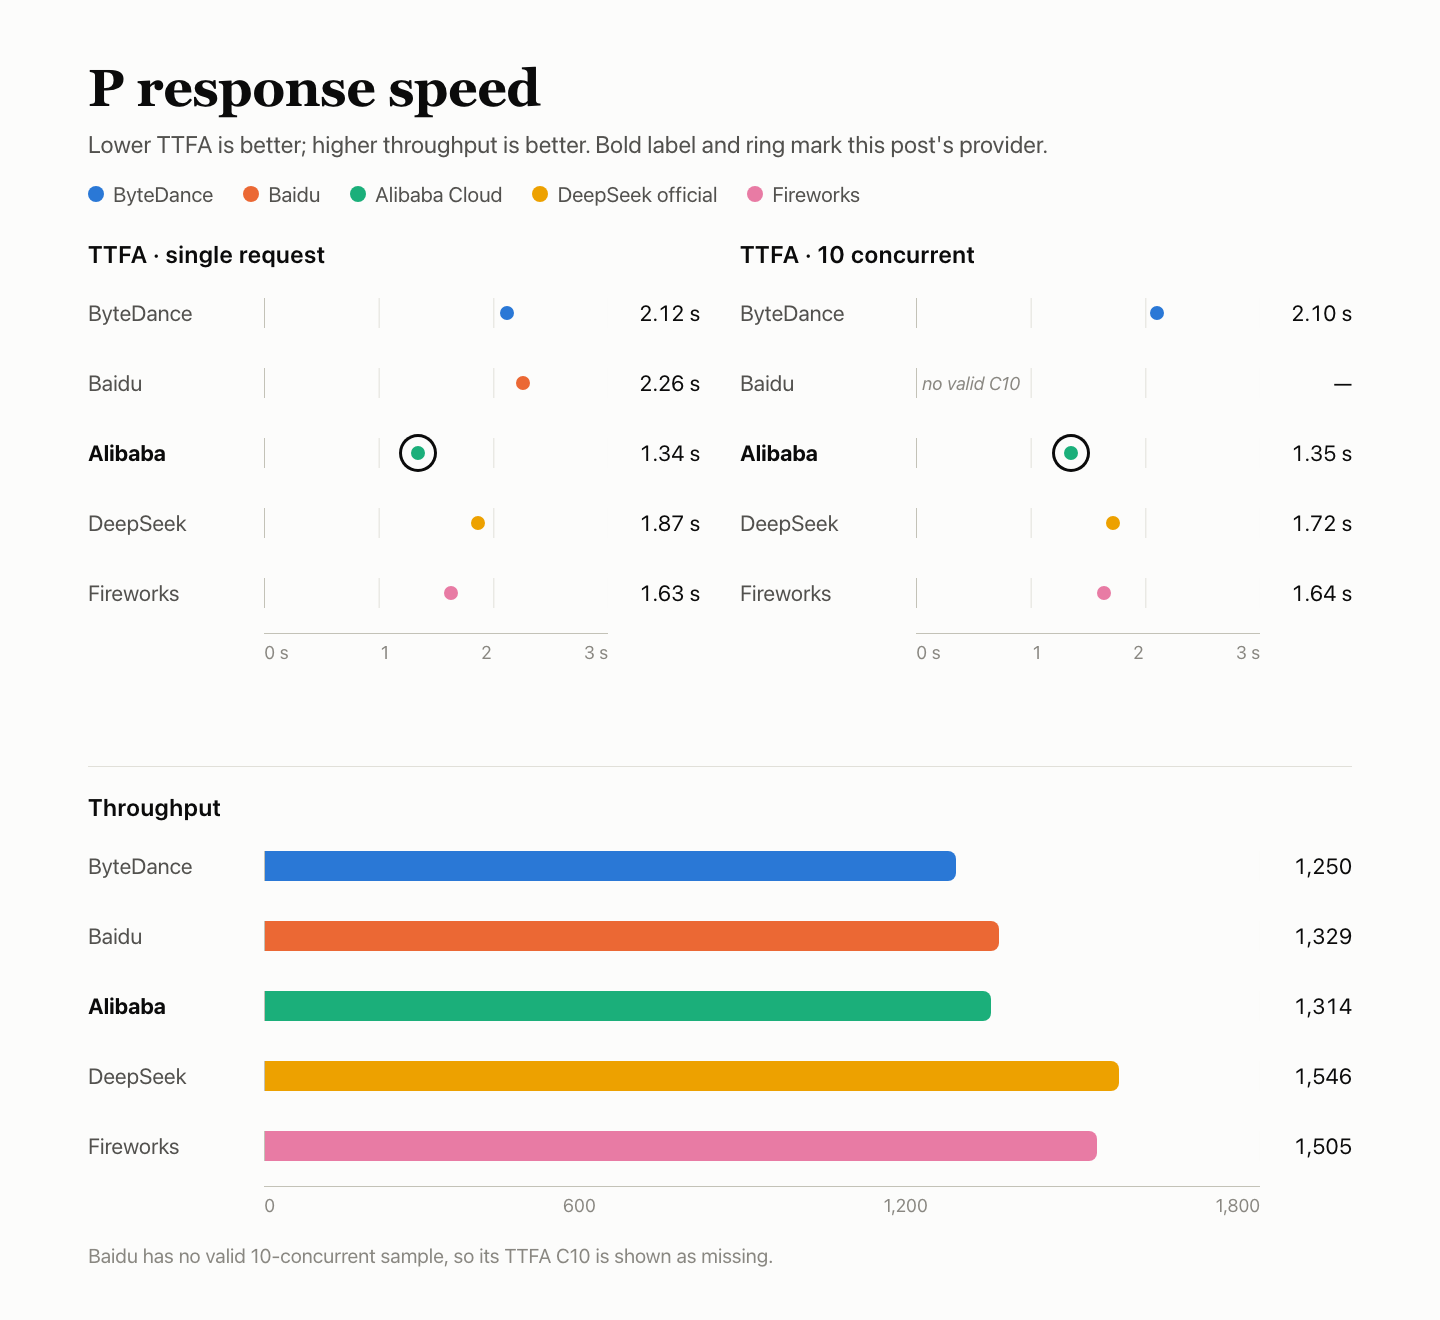
- Antwortgeschwindigkeit: P 88.58. Der Median bis zum ersten Inhaltstoken lag bei einer parallelen Anfrage bei 1.34 s und bei 10 parallelen Anfragen bei 1.35 s. Das TPOT betrug 4.69 ms, und alle 180 Geschwindigkeitsanfragen waren gültig.
- Cache: K 99.37. Alle 18 Hot-Anfragen über die 8k- und 32k-Präfixe erzielten einen Cache-Treffer; keine Cold-Kontrollanfrage griff auf den Cache zu.
- Servicestabilität: R 100. Alle 300 dedizierten Anfragen waren bereits beim ersten Versuch erfolgreich.
Testaufbau
Der Test lief über AIHubMix, indem die Modell-ID des Anbieters ausgewählt wurde; die Schnellstartanleitung beschreibt die Route. Die Preisseite von DeepSeek führt die veröffentlichten Tarife des Modells auf.
| Element | Details |
|---|---|
| Modell | DeepSeek V4.1 Flash 1017 |
| Angeforderte Modell-ID | alicloud-deepseek-v4.1-flash-1017 |
| Zurückgegebener Modellname | deepseek-v4.1-flash-1017 |
| Zugriffsroute | Über AIHubMix durch Auswahl der Modell-ID des Anbieters, nicht durch Verbindung mit dem eigenen Konto des Anbieters |
| Parameter | Denkmodus aus, temperature 1.0, max_tokens 16,384, Timeout 300 s, keine automatischen Wiederholungen |
| Thinking aus | Für alle Anfragen wurde reasoning_effort=none verwendet |
| Zeitraum | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Die fünf Anbieter nutzten denselben Mac mini, dasselbe Netzwerk und dasselbe Konto. |
| Stichproben | Antwortqualität: 4,250 Frage-Durchläufe (BFCL 500 × 3 Runden, HLE 250 × 10, AA-LCR 25 × 10); Funktionsfälle: 60 × 3 Zeitfenster; Geschwindigkeit: 90 bei einer parallelen Anfrage und 90 bei 10 parallelen Anfragen; Stabilität: 300; Cache: 30 (8k- und 32k-Präfixe, jeweils 3 Gruppen) |
Q — Antwortqualität: 41.75
Für die Antwortqualität kamen drei Fragensets zum Einsatz: 500 BFCL-Fragen mit jeweils 3 Runden, 250 HLE-Fragen mit jeweils 10 Runden und 25 AA-LCR-Fragen mit jeweils 10 Runden. BFCL wurde anhand automatischer Regeln bewertet; HLE und AA-LCR beurteilte das Bewertungsmodell deepseek-flash. Alle fünf Anbieter erhielten dieselben Fragen. Die drei Sets wurden zu einer gemeinsamen Genauigkeit zusammengefasst. Zehn Antworten wurden ausgeschlossen, weil sich die zugehörigen Fragen nicht bewerten ließen. Es blieben 4,240 bewertete Frage-Durchläufe.
| Aufgabe | Fragen | Richtig | Genauigkeit | Fehler |
|---|---|---|---|---|
| BFCL-Tool-Aufrufe | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Schwierige HLE-Fragen und -Antworten | 250 × 10 | 331/2,490 | 13.29% | 8 |
| AA-LCR-Reasoning zu langen Dokumenten | 25 × 10 | 134/250 | 53.60% | 0 |
| Gesamt · 95%-Intervall 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Servicefehler (fehlgeschlagene Anfragen oder abgeschnittene Ausgabe) bleiben im Nenner und gelten als falsch; sie werden nicht ausgeschlossen. Bei Alibaba Cloud erreichte die HLE-Ausgabe 8 Mal das max_tokens-Limit und wurde abgeschnitten.
Bei BFCL wird jede Frage in 3 Runden beantwortet; die Tabelle fasst die Ergebnisse der 3 Runden zusammen.
| BFCL-Kategorie | Bestanden | Erfolgsquote |
|---|---|---|
| simple_python: eine Funktion, korrekter Aufruf und korrekte Argumente | 332/360 | 92.22% |
| multiple: aus mehreren Funktionen die richtige auswählen | 270/300 | 90.00% |
| parallel: dieselbe Funktion mehrmals parallel aufrufen | 273/300 | 91.00% |
| parallel_multiple: mehrere unterschiedliche Funktionen parallel aufrufen | 212/240 | 88.33% |
| irrelevance: keine Funktion ist relevant, es darf keine aufgerufen werden | 113/150 | 75.33% |
| ahm_multi_turn: dreistufige Tool-Kette | 105/150 | 70.00% |
Vergleich mit den anderen vier
Im Vergleich zum offiziellen Kanal: Unterschied der Genauigkeit in Prozentpunkten, mit dem 95%-Intervall als Whisker dargestellt; wenn das Intervall 0 einschließt, gilt das Ergebnis als nicht unterscheidbar. Das Bewertungsmodell deepseek-flash für HLE und AA-LCR gehört zur selben DeepSeek-Familie wie das getestete Modell und wurde nicht kalibriert, weshalb seine Bewertung möglicherweise zu großzügig ausfällt.
F — Funktionsunterstützung: 89.78
Bei den Funktionsfällen wird geprüft, ob sich die Schnittstelle protokollkonform verhält, nicht ob das Modell gute Antworten gibt. Die 60 Fälle sind in sechs Gruppen unterteilt und wurden jeweils in drei Zeitfenstern ausgeführt, was 180 Prüfungen ergibt. Bewertet wurde anhand des Formats, das jeder Anbieter dokumentiert. Nicht anwendbare, ungültige oder nicht beobachtete Prüfungen wurden aus dem Nenner ausgeschlossen. Alibaba Cloud bestand 155 der 177 Prüfungen im Nenner; die Gewichtung der Gruppen ergibt 89.78.
Der gewichtete Score wird anhand der Gruppengewichtungen berechnet und nicht durch einfaches Zählen der bestandenen Prüfungen von insgesamt 177.
| Gruppe | Gewichtung | Bestanden | Ausgeschlossen | Gruppenscore |
|---|---|---|---|---|
| Streaming- und Nachrichtenprotokoll | 20% | 30/30 | — | 100.00 |
| Tool-Schnittstelle | 20% | 30/30 | — | 100.00 |
| Ausgabebeschränkungen und Parameter | 20% | 30/30 | — | 100.00 |
| Kontext und Status | 15% | 26/30 | — | 86.67 |
| Fehler und Wiederherstellung | 15% | 18/30 | — | 60.00 |
| Abrechnungs- und Cache-Protokoll | 10% | 21/27 | 3 | 77.78 |
| Gesamt · gewichteter Score | — | 155/177 | 3 | 89.78 |
Ein Zeitfensterwert von 3/3 bedeutet, dass der Fall in allen drei Zeitfenstern fehlgeschlagen ist.
| Fehlgeschlagener Fall | Fehler in den Zeitfenstern | Grund |
|---|---|---|
| Überschreitung des Kontextfensters (Kontext und Status) | 3/3 | Es wurde ein Fehler zurückgegeben, aber nicht der dokumentierte Fehler für die Kontextlänge |
| Fehler im messages-Format (Fehler und Wiederherstellung) | 3/3 | 400 mit leerem Antworttext zurückgegeben, ohne strukturierte Fehlerbeschreibung |
| Ungültiges Tool-Schema (Fehler und Wiederherstellung) | 3/3 | Es hätte ein Parameterfehler zurückgegeben werden müssen; stattdessen kam 503 |
| Isoliertes Tool-Ergebnis (Fehler und Wiederherstellung) | 3/3 | Es hätte ein Parameterfehler zurückgegeben werden müssen; stattdessen kam 200 |
| Fehler im stream_options-Format (Fehler und Wiederherstellung) | 3/3 | 400 mit leerem Antworttext zurückgegeben, ohne strukturierte Fehlerbeschreibung |
| Abrechnung von Reasoning-Tokens (Abrechnungs- und Cache-Protokoll) | 3/3 | Keine Anzahl der Reasoning-Tokens zurückgegeben |
| Tool-Definitionen als Eingabe gezählt (Abrechnungs- und Cache-Protokoll) | 3/3 | Mit Tool-Definitionen war die gemeldete Anzahl der Eingabe-Token nicht höher als ohne sie |
| Anfrageisolation (Kontext und Status) | 1/3 | Im ersten Schritt wurde nicht wie erforderlich ausschließlich STORED zurückgegeben, daher konnte die Isolationsprüfung nicht fortgesetzt werden |
Diese Prüfungen werden aus dem Nenner ausgeschlossen und zählen weder als bestanden noch als fehlgeschlagen.
| Status | Fall | Anzahl | Grund |
|---|---|---|---|
| Nicht anwendbar | Explizites cache_control | 3 | Vorab als von dieser Schnittstelle nicht unterstützt registriert |
Die Testfälle mit einem Fehler im messages-Format und im stream_options-Format schlugen bei allen fünf Anbietern fehl: Jeder gab 400 mit leerem Antworttext zurück, sodass der Client keine strukturierte Fehlerbeschreibung erhielt. Da sich dieses Verhalten bei allen fünf zeigt, liegt die Ursache wahrscheinlich eher in der AIHubMix-Gateway-Schicht und muss separat untersucht werden. Auch die Abrechnung von Reasoning-Tokens schlug bei allen fünf fehl, allerdings aus unterschiedlichen Gründen: ByteDance und Fireworks meldeten Reasoning-Tokens, obwohl der Denkmodus ausgeschaltet war, während die übrigen drei keine Anzahl der Reasoning-Tokens zurückgaben.
Vergleich mit den anderen vier
P — Antwortgeschwindigkeit: 88.58
Jede Anfrage enthielt etwa 10,000 Eingabe-Token und forderte etwa 1,100 Ausgabe-Token an. In drei Zeitfenstern wurden jeweils 30 Anfragen bei einer parallelen Anfrage und 30 bei 10 parallelen Anfragen gesendet, insgesamt also 180. Die Wartezeit bis zum ersten Inhaltstoken (TTFA) wird für jede gültige Anfrage gemessen; in der Tabelle stehen die Mediane. Das TPOT wird anhand der Zeitstempel von Streaming-Chunks geschätzt, nicht anhand einer Hardwaremessung pro Token. Der Durchsatz entspricht den gültigen Ausgabe-Token bei 10 parallelen Anfragen, geteilt durch die verstrichene Gesamtzeit des Batches.
| Metrik | Ergebnis |
|---|---|
| TTFA bis zum ersten Inhaltstoken | Median bei einer parallelen Anfrage: 1.34 s, Median bei 10 parallelen Anfragen: 1.35 s |
| Generierungsgeschwindigkeit (TPOT) | Bei einer parallelen Anfrage: 4.63 ms/Token, bei 10 parallelen Anfragen: 4.69 ms/Token |
| Effektiver Durchsatz (Goodput) | 1,313.6 Token/s bei 10 parallelen Anfragen |
| Gültige Anfragen | Bei einer parallelen Anfrage: 90/90, bei 10 parallelen Anfragen: 90/90 |
| Teilwerte | TTFA 59.65, TPOT 100.00, Durchsatz 100.00; für TTFA und TPOT wird der niedrigere der beiden Werte verwendet, Gewichtung 35% / 35% / 30%, Antwortscore 85.88 |
| P-Score | Antwortscore 85.88 mit 80% Gewichtung, Cache K 99.37 mit 20% Gewichtung, Gesamt 88.58 |
Vergleich mit den anderen vier
Alle fünf Anbieter nutzten dieselbe Maschine, dasselbe Netzwerk und dasselbe Konto. Die drei Zeitfenster wurden Anbieter für Anbieter eingeplant, sodass sich die Erhebungszeiträume nicht vollständig überschneiden. Kleine Abstände sollten daher nicht überinterpretiert werden.
K — Cache: 99.37
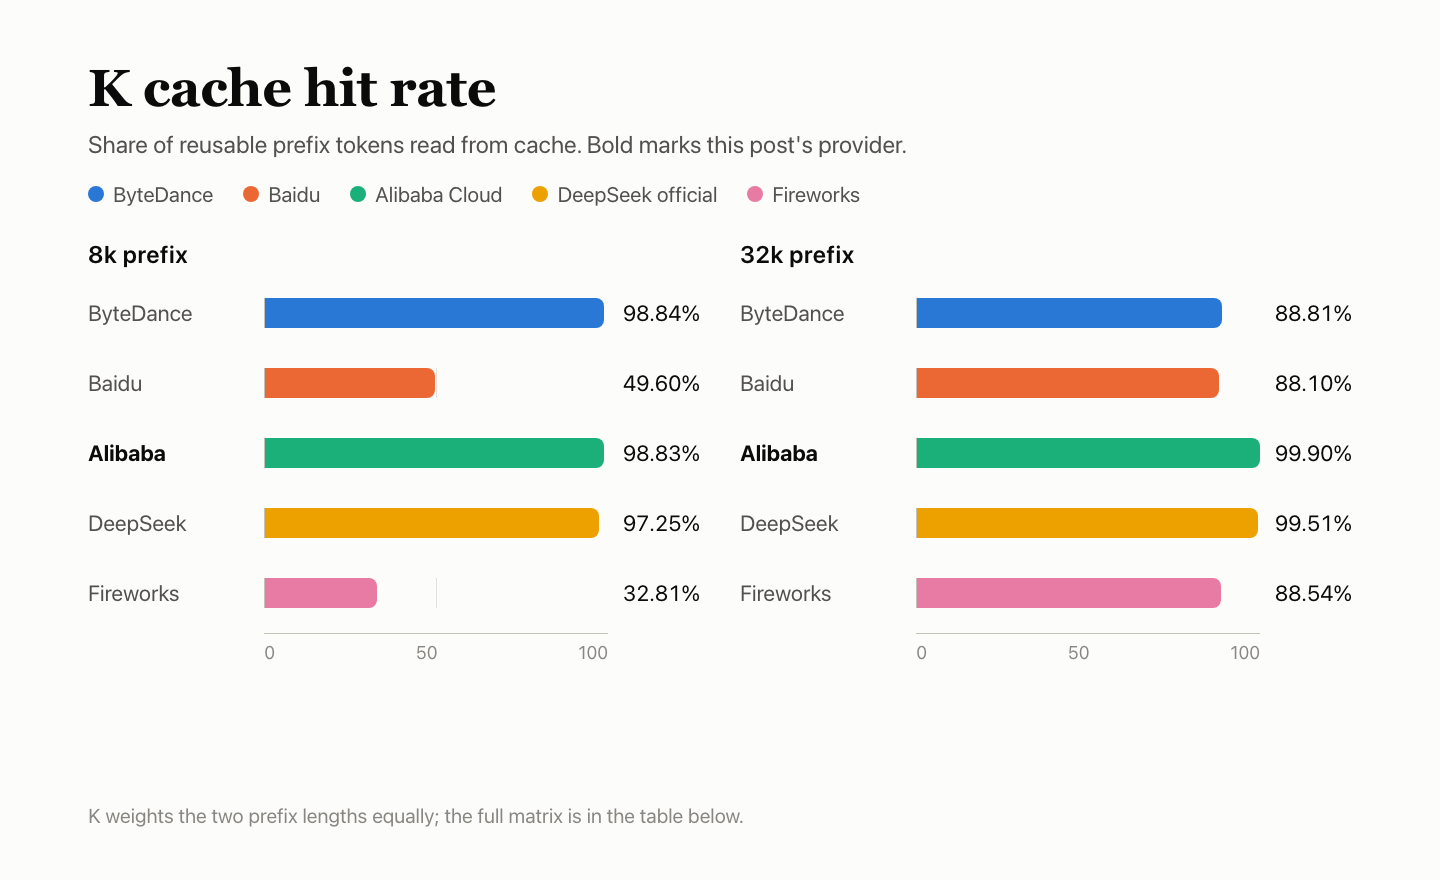
Jede Gruppe umfasst fünf Anfragen: Die erste enthält ein festes Präfix mit etwa 8k oder 32k Token und befüllt den Cache. Bei den Anfragen 2–4 bleibt das Präfix gleich, während nur die abschließende Frage geändert wird; sie erfolgen nach 5, 30 und 120 Sekunden. Die fünfte Anfrage verwendet als Cold-Kontrolle ein neues Präfix. Drei Zeitfenster × zwei Längen ergeben 30 Anfragen. K entspricht den bei Hot-Anfragen gelesenen Cache-Token geteilt durch die Token, die laut Regel wiederverwendbar sein sollten; jede Länge zählt zur Hälfte. K macht 20% von P aus. Die Matrix zeigt die vom Server gemeldeten Cache-Token-Lesezugriffe.
| Präfix | Zeitfenster | Seed (Anfrage 1) | Hot nach 5 s | Hot nach 30 s | Hot nach 120 s | Cold-Kontrolle (Anfrage 5) |
|---|---|---|---|---|---|---|
| 8k | Zeitfenster 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Zeitfenster 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Zeitfenster 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Zeitfenster 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Zeitfenster 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Zeitfenster 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Präfix | Hot-Treffer | Gelesene Token | Sollten wiederverwendbar sein | Score |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k und 32k, jeweils zur Hälfte gewichtet) | 99.37 |
Alle 9 Hot-Anfragen mit 8k erzielten einen Cache-Treffer und lasen jeweils 7,936 Token; alle 9 Hot-Anfragen mit 32k erzielten einen Cache-Treffer und lasen jeweils 32,000 Token. Bei den Seed-Anfragen und den Cold-Kontrollen wurden keine Cache-Daten gelesen, sodass sich Hot- und Cold-Anfragen klar unterscheiden.
Vergleich mit den anderen vier
R — Servicestabilität: 100
Die 300 Anfragen umfassten vier Typen — kurzen Text, lange Eingaben mit 10k Token, Tool-Aufrufe und mehrstufigen Gesprächsverlauf — und wurden in drei Zeitfenstern mit einer parallelen Anfrage gesendet. Nur die erste Antwort wurde auf Gültigkeit und Vollständigkeit geprüft; die Korrektheit der Antwort wurde nicht bewertet und es gab keine Wiederholungsversuche. Fehler in den Abschnitten zu Antwortqualität und Geschwindigkeit werden jeweils bei Q und P berücksichtigt, nicht noch einmal bei R.
| Anfragetyp | Erfolg beim ersten Versuch |
|---|---|
| Kurzer Text | 120/120 |
| Lange Eingabe mit 10k Token | 90/90 |
| Tool-Aufrufe | 60/60 |
| Mehrstufiger Gesprächsverlauf | 30/30 |
| Gesamt · 95%-Intervall 98.78%–100% | 300/300 |
Alle 300 Anfragen lieferten bereits beim ersten Versuch eine gültige, vollständige Antwort. R 100 bezieht sich ausschließlich auf diese 300 gezielten Anfragen und bedeutet nicht, dass die gesamte Kette fehlerfrei war. Die Untergrenze des 95%-Intervalls liegt bei 98.78%: Selbst bei 300/300 liegt die Ausfallrate wahrscheinlich unter 1.22%.
Im Vergleich zu den anderen vier
R bezieht sich ausschließlich auf diese 300 gezielten Anfragen; Fehler bei Antwortqualität und Geschwindigkeit werden in Q und P erfasst und nicht erneut bei R gezählt.
| Anbieter | Erfolg beim ersten Versuch | 95%-Intervall |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Ist der Gesamtunterschied von 0.37 zwischen Alibaba Cloud und dem offiziellen Kanal aussagekräftig?
Nein. Bei diesem Durchlauf lassen sich die beiden nicht unterscheiden: Der Q-Unterschied beträgt −0.71 Prozentpunkte, bei einem 95%-Intervall von −1.72 bis +0.26, das 0 einschließt. Der Gesamtwert ist ein zusammenfassender Index ohne Konfidenzintervall.
Was fließt in den Q-Wert ein?
Drei Testsätze: BFCL mit 500 Fragen × 3 Durchläufen, automatisch ausgewertet; HLE mit 250 × 10 und AA-LCR mit 25 × 10, bewertet durch das Bewertungsmodell deepseek-flash. Die kombinierte Genauigkeit beträgt 41.75% bei 4,240 ausgewerteten Frage-Durchläufen.
Warum beträgt F 89.78, obwohl 155 von 177 Prüfungen bestanden wurden?
Der Wert wird nach Gruppen gewichtet und ist kein einfacher Anteil bestandener Prüfungen. Fehler und Wiederherstellung erzielten 60.00, Abrechnung und Cache-Protokoll 77.78, während die drei Protokollgruppen jeweils 100.00 erreichten.
Warum weist R den Wert 100 aus, wenn in anderen Abschnitten Anfragen fehlgeschlagen sind?
R bezieht sich ausschließlich auf die 300 gezielten Stabilitätsanfragen. Fehler bei Antwortqualität und Geschwindigkeit werden in Q und P erfasst und nicht erneut bei R gezählt.
Ist K 99.37 eine Cache-Trefferquote?
Es handelt sich um das Verhältnis der bei Anfragen mit warmem Cache gelesenen gecachten Token zu den wiederverwendbaren Token, wobei 8k und 32k jeweils zur Hälfte gewichtet werden. Das 8k-Präfix erzielte 98.83, das 32k-Präfix 99.90.
Bedeutet die Zeit von 1.34 s bis zum ersten Token, dass die vollständige Antwort nach 1.34 s eintrifft?
Nein. Gemeint ist die Wartezeit bis zum ersten Inhaltstoken. Bei jeder Anfrage wurden etwa 1,100 Ausgabetoken angefordert; TPOT bei einer Parallelität von 10 betrug 4.69 ms pro Token.
Weiterlesen: die DeepSeek V4.1 Flash-Reihe
- Der kombinierte Q-Wert von Alibaba Cloud weicht um 0.71 Prozentpunkte vom offiziellen Referenzwert ab und liegt innerhalb eines Intervalls, das 0 einschließt. Das ByteDance-Profil führt denselben Vergleich bis zur Abrechnung von Tool-Aufrufen weiter: DeepSeek V4.1 Flash bei ByteDance: Tool-Aufrufe stimmen überein, Abrechnung nicht.
- Alibaba Cloud lieferte alle 180 Geschwindigkeitsanfragen gültig zurück. Das Baidu-Profil nutzt denselben Testaufbau, bei dem kein verfügbarer Kanal Q und P beeinflusste: DeepSeek V4.1 Flash bei Baidu: Kein verfügbarer Kanal beeinflusst Q und P.
- Der offizielle Kanal dient in diesem Beitrag als Referenz für den Vergleich der Antwortqualität; sein eigenes Profil umfasst F 94.00 und 15 ungültige Prüfungen bei Einzelparallelität: DeepSeek V4.1 Flash beim offiziellen Kanal: 94.00 F, 15 ungültige Prüfungen.
- Alibaba Cloud erzielte bei beiden Präfixlängen 9/9 Anfragen mit warmem Cache; das Fireworks-Profil umfasst leere Stop-Antworten und 3/9 Cache-Treffer bei 8k: DeepSeek V4.1 Flash bei Fireworks: leere Stop-Antworten, 3/9 Cache-Treffer.


