

Am 2026-11-03/04 wurde DeepSeek V4.1 Flash 1017 über AIHubMix mit der vollständigen APB-Suite bei fünf Anbietern getestet: jedes Mal dieselben Fragen, Parameter und Request-Skripte. Dieses APB-Profil behandelt ausschließlich den Baidu-Testlauf, Abschnitt für Abschnitt.
Die folgenden Zahlen sind ausschließlich Scores, keine Rangliste und keine Anbieterempfehlung. Zuerst kommen Q 38.00, F 88.39, P 37.77, K 68.85 und R 100; der Gesamtwert 56.48 ist ein zusammenfassender Index ohne Konfidenzintervall. Es gelten die Bewertungsregeln des AIHubMix Provider Benchmark Standard v2.0.
Scores der fünf Anbieter
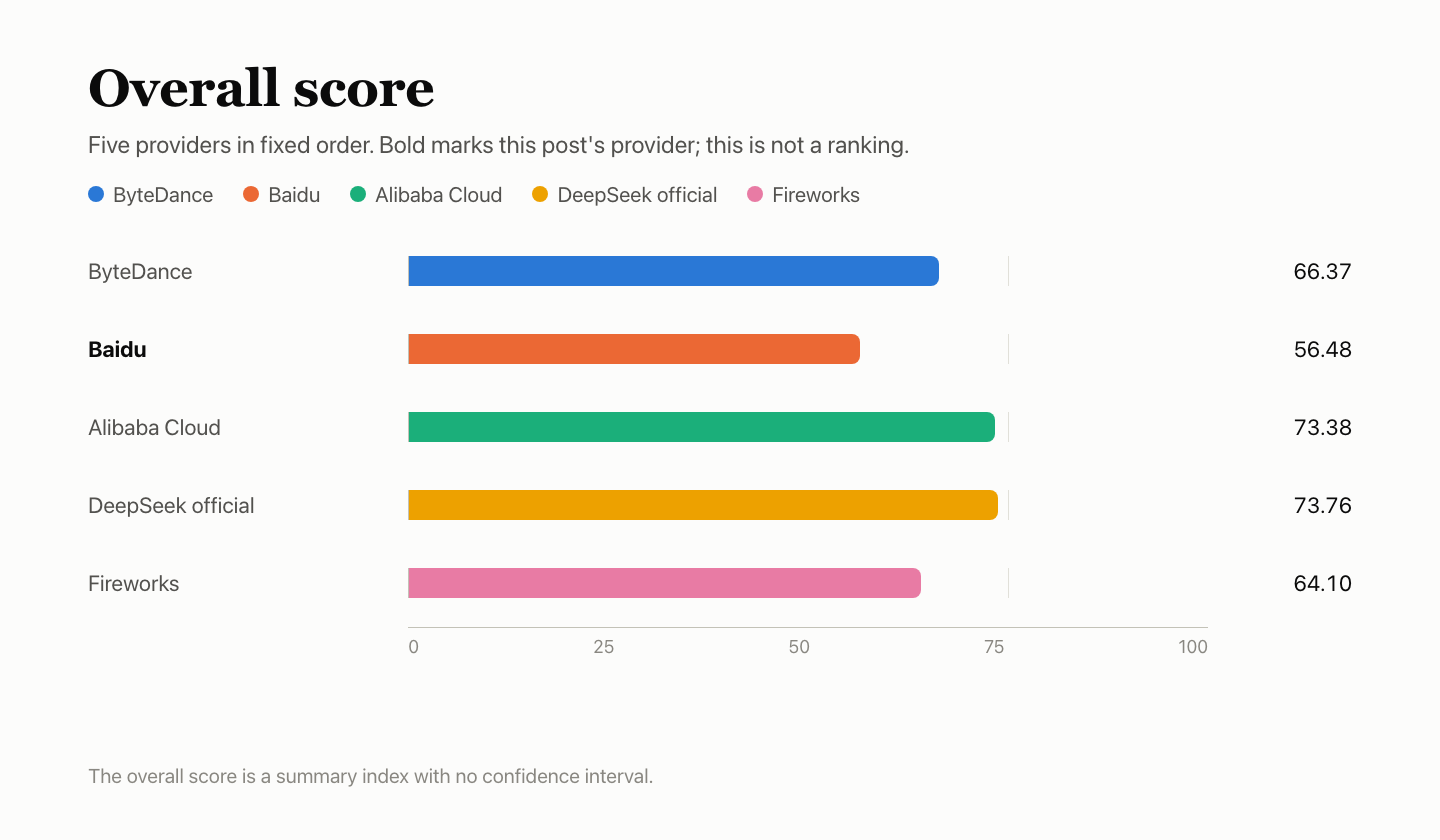
Fett markiert den Anbieter dieses Beitrags. Die Anbieter werden in einer festen Reihenfolge aufgeführt, nicht nach Rang. K ist ein Teilscore von P und zählt 20%. Der Gesamtwert ist ein zusammenfassender Index ohne Konfidenzintervall. Zwischen dem offiziellen Endpunkt und Alibaba Cloud liegt ein Unterschied von 0.37, der nicht statistisch unterscheidbar ist.
Auf einen Blick
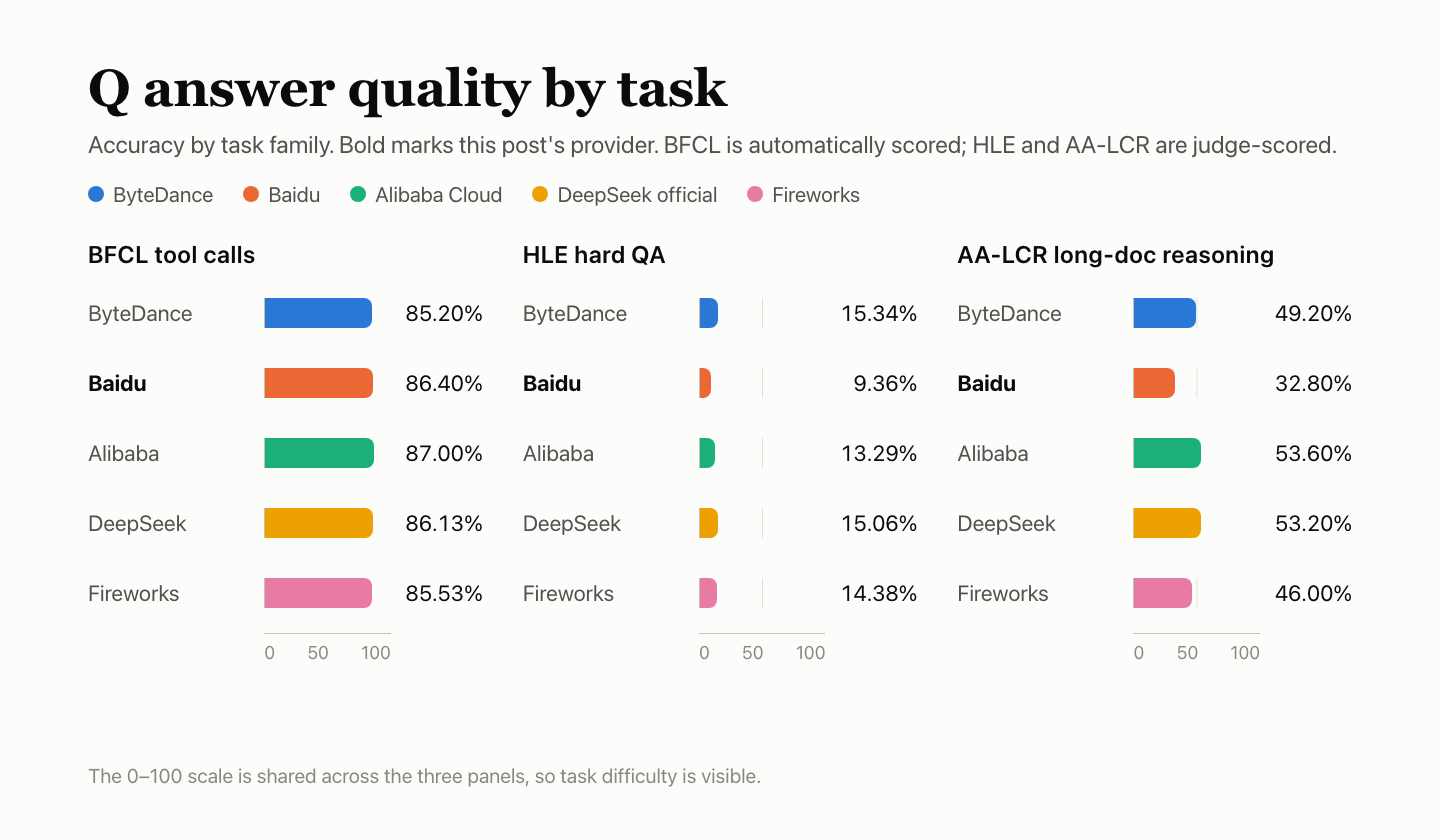
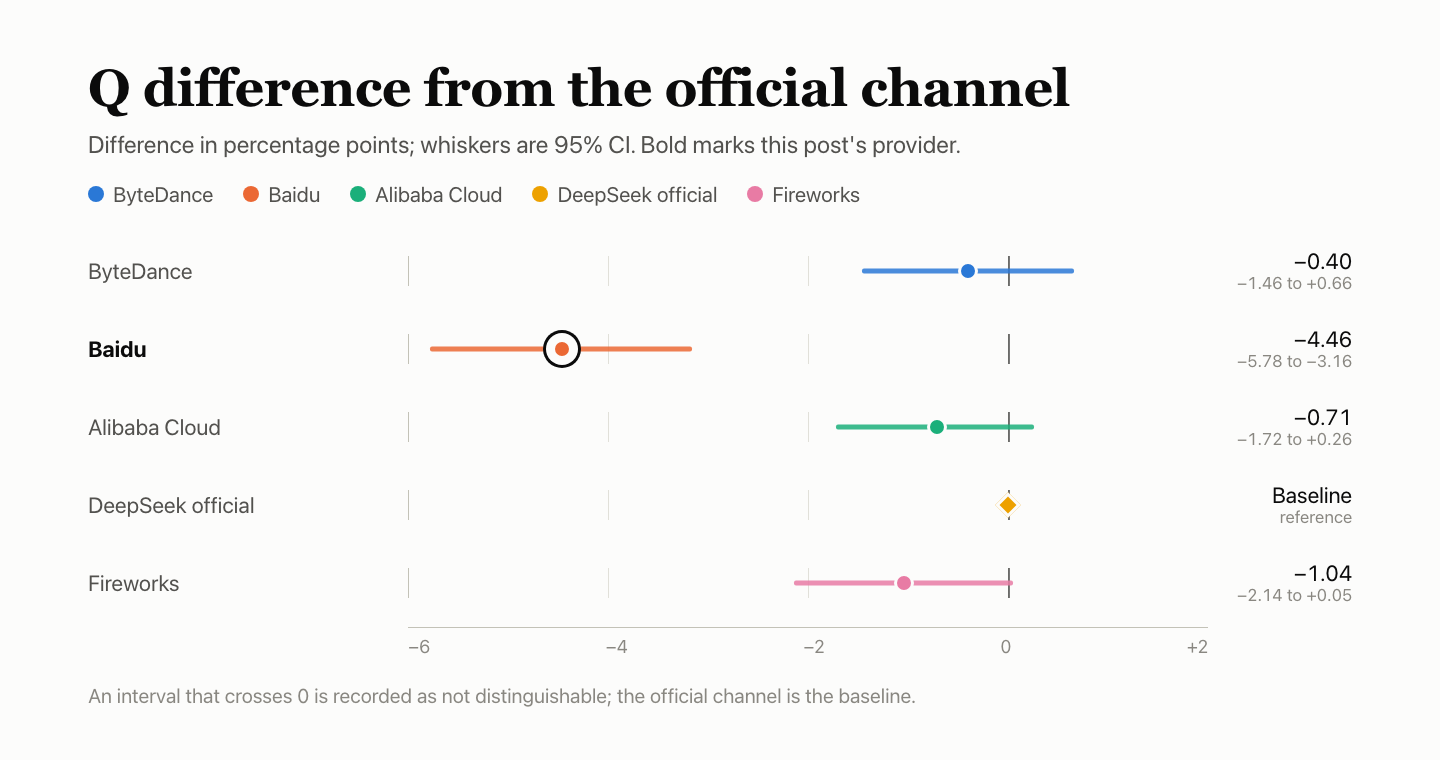
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. Das Gesamtergebnis liegt 4.46 Punkte unter dem offiziellen Endpunkt; das 95%-Intervall reicht von −5.78 bis −3.16 und schließt 0 aus. Bei HLE wurden 864 fehlgeschlagene Requests und bei AA-LCR 100 verzeichnet, fast alle im ersten Zeitfenster; sie wurden als falsche Antworten gezählt.
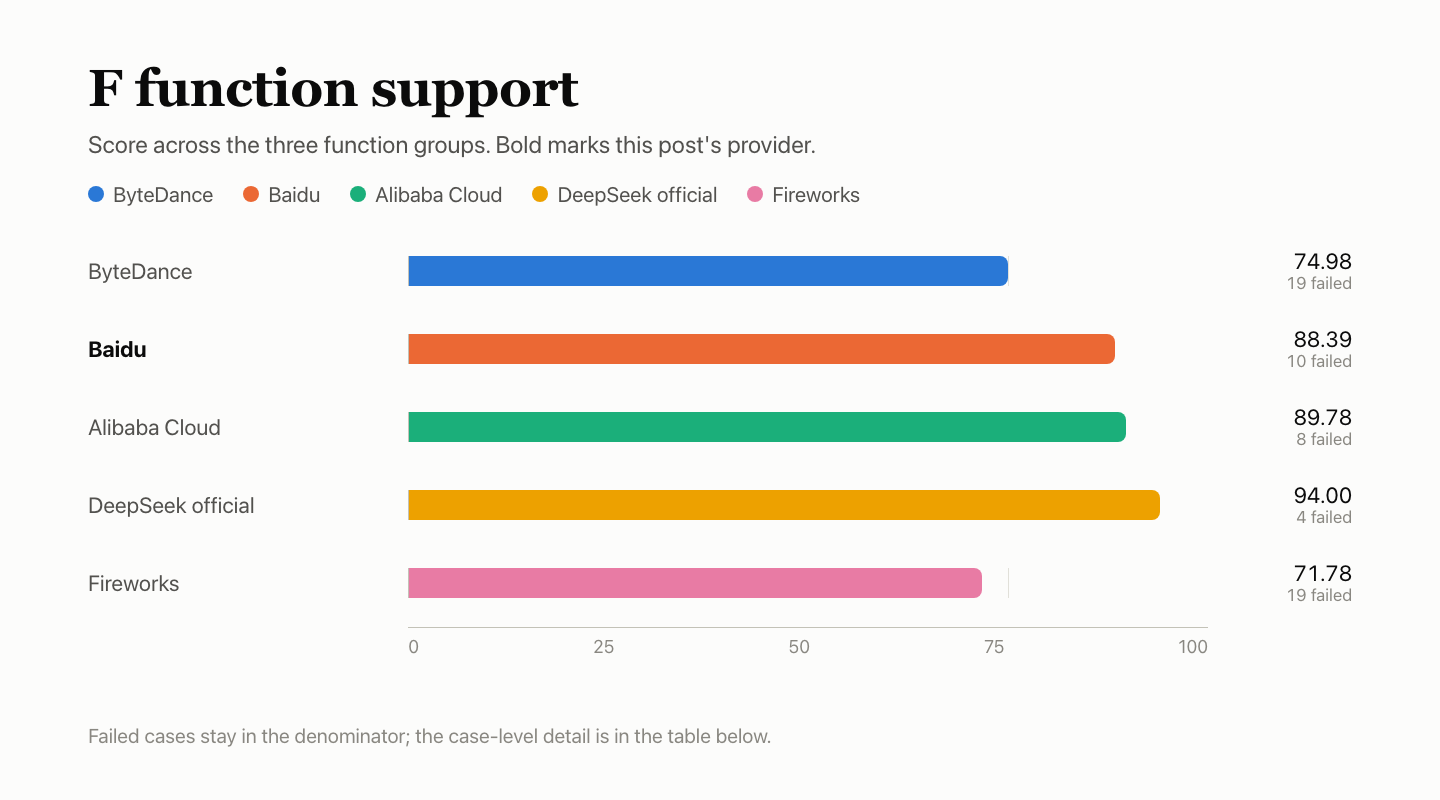
- F: 88.39. 148 von 174 gewerteten Prüfungen bestanden. Das Cache-Lesefeld und die Anzahl der Thinking-Tokens wurden nicht zurückgegeben; Fälle mit überschrittenem Kontext und verwaistem Tool-Ergebnis lieferten den Statuscode 200.
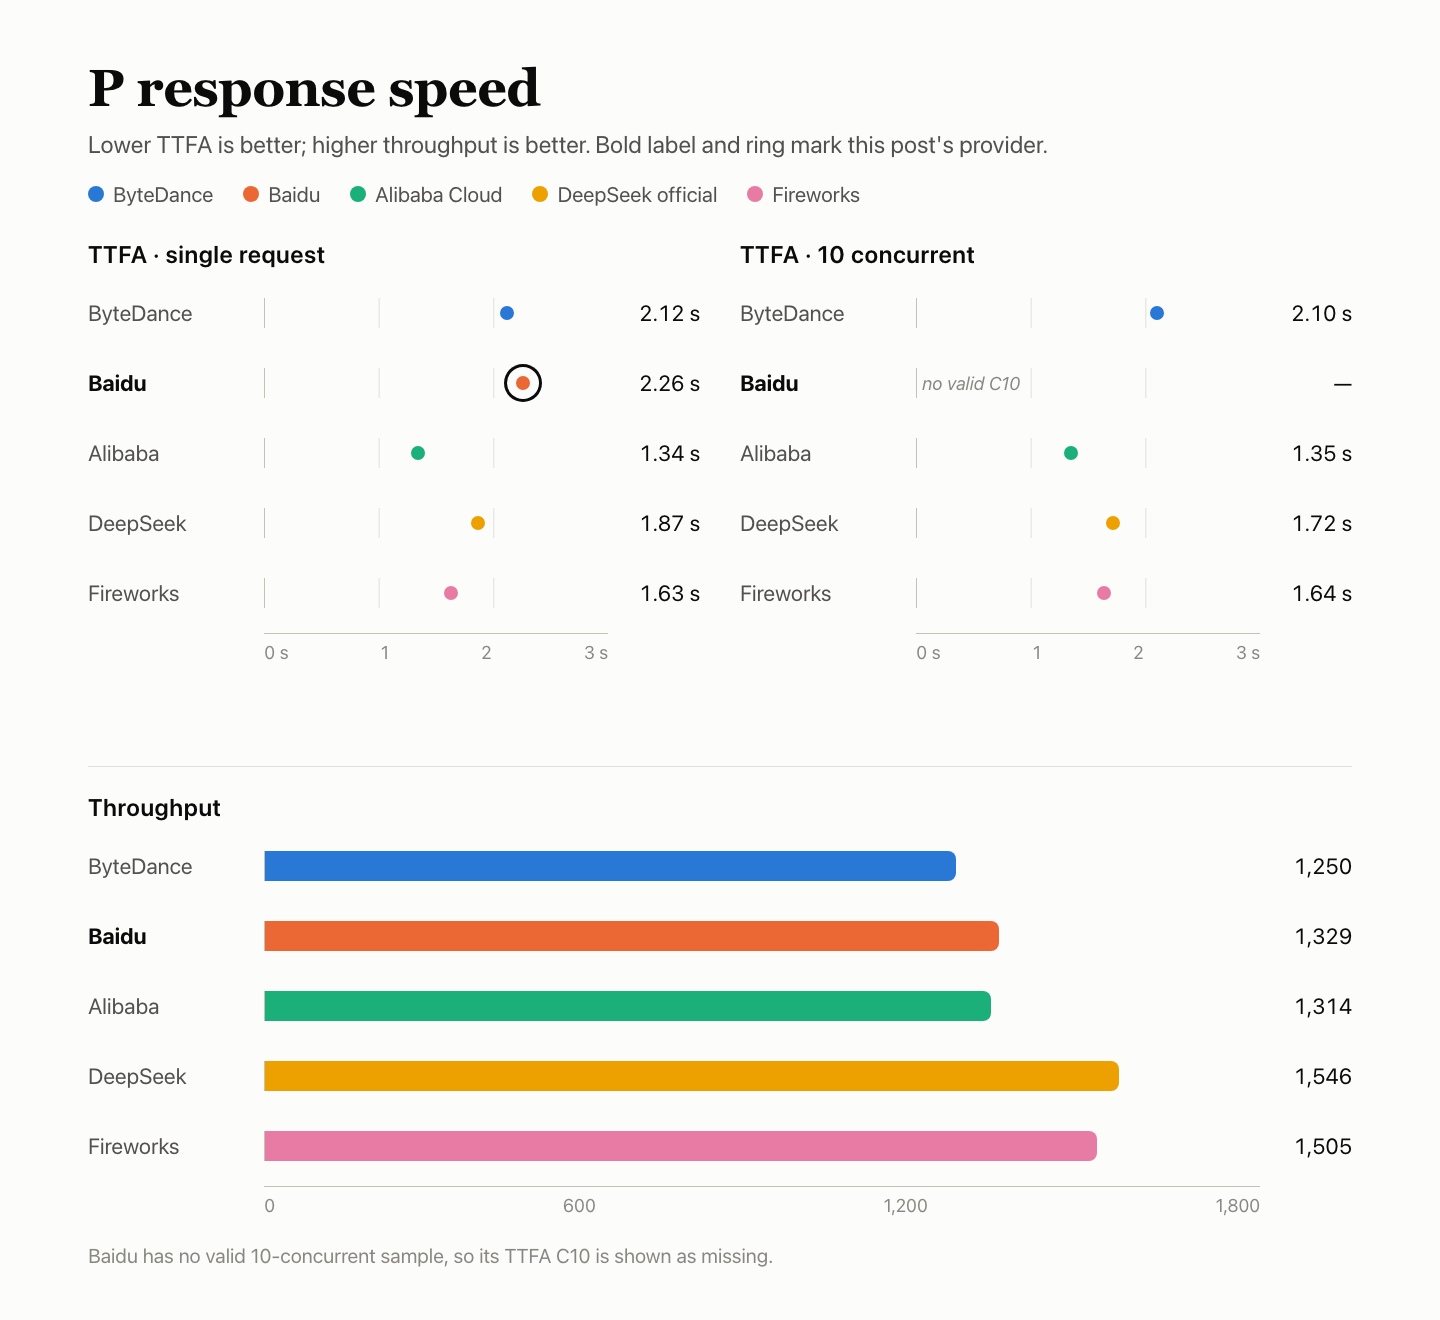
- P: 37.77. 50 von 90 Probes mit zehn parallelen Requests lieferten
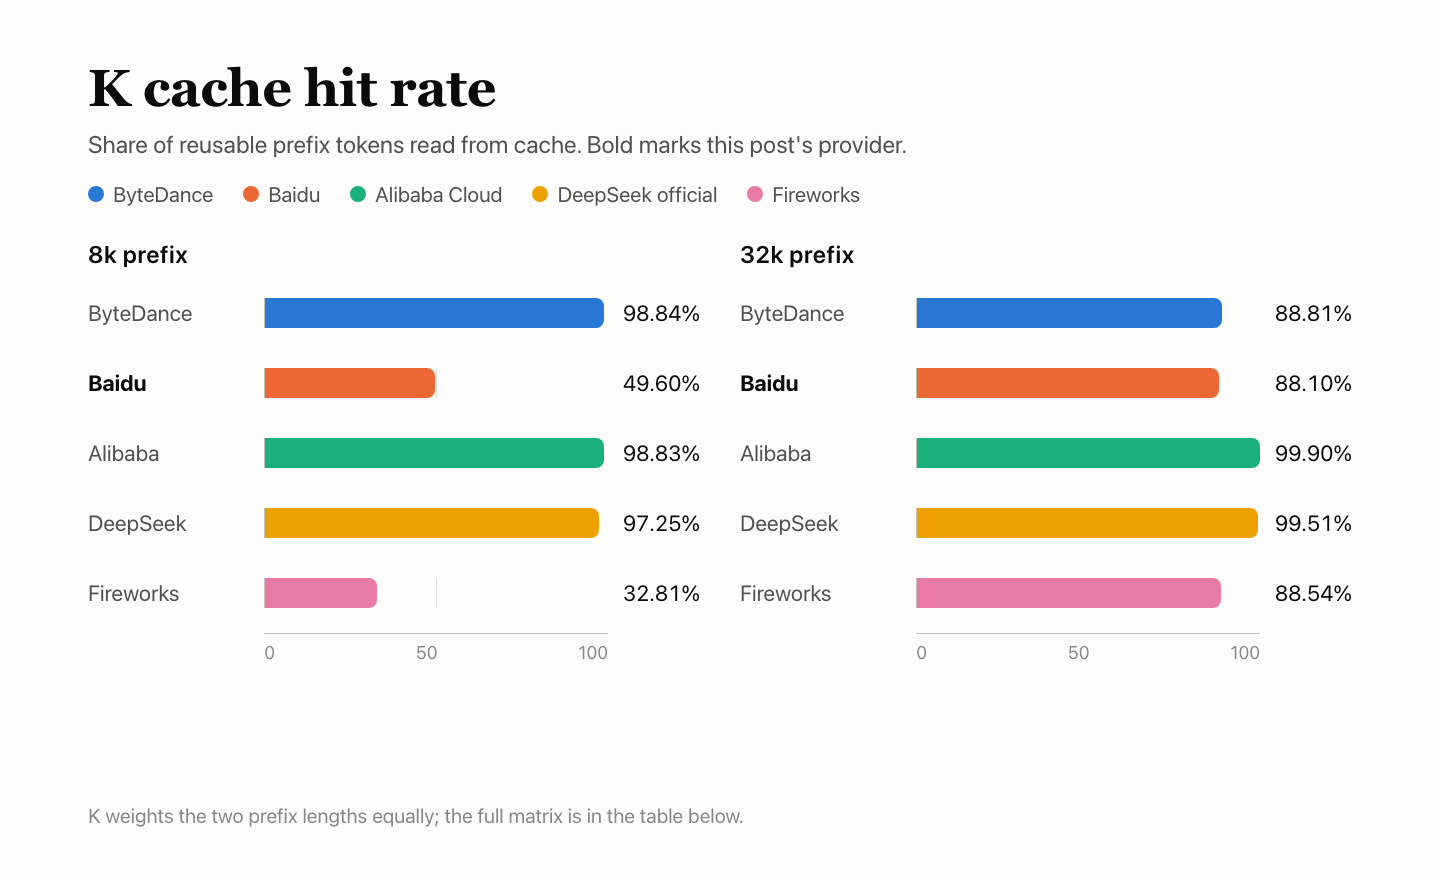
no_available_channel; damit war mehr als die Hälfte ungültig, und TTFA sowie TPOT wurden mit ihren Strafwerten bewertet. Bei Einzelparallelität waren 78 von 90 Probes gültig. - K: 68.85. Bei den 8k-Hot-Requests gab es 5 Treffer von 9 Versuchen und 3 fehlgeschlagene Requests; beim 32k-Präfix waren es 8 Treffer von 9. Treffer werden in Blöcken zu 1,024 Token angegeben: 7,168 Token für 8k und 31,744 für 32k.
- R: 100. Alle 300 eigens dafür gesendeten Requests waren beim ersten Versuch erfolgreich. Kanalausfälle beim Beantworten und bei den Geschwindigkeitstests werden unter Q und P gezählt.
Testaufbau
Die Requests verwendeten die Route AIHubMix Schnellstart mit einer anbieterspezifischen ID; die Parameter richten sich nach der API-Dokumentation von DeepSeek. Die IDs anderer Anbieter sind auf der Modellseite aufgeführt. Es handelt sich nicht um eine direkte Verbindung zu einem eigenen Baidu-Konto.
| Feld | Wert |
|---|---|
| Modell | DeepSeek V4.1 Flash 1017 |
| Angefragte Modell-ID | baidu-deepseek-v4.1-flash-1017 |
| Zurückgegebener Modellname | deepseek-v4.1-flash-1017 |
| Zugriffsroute | Über AIHubMix mit der anbieterspezifischen Modell-ID; keine direkte Verbindung zum eigenen Konto des Anbieters |
| Parameter | Denkmodus deaktiviert, temperature 1.0, max_tokens 16,384, Timeout 300 s, keine automatischen Wiederholungsversuche |
| Denkmodus deaktiviert | Bei jedem Request wurde reasoning_effort=none verwendet |
| Zeitraum | 2026-11-03 18:07 – 11-04 16:33 UTC+8; alle fünf Anbieter nutzten denselben Mac mini, dasselbe Netzwerk und dasselbe Konto |
| Stichproben | 4,250 Antwortversuche (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 Funktionsfälle × 3 Zeitfenster; 90 Probes mit Einzelparallelität und 90 Probes mit zehn parallelen Requests; 300 Stabilitäts-Requests; 30 Cache-Probes (je drei Gruppen für 8k- und 32k-Präfixe) |
Q — Antwortqualität: 38.00
Die Antwortqualität wird anhand dreier Aufgabentypen bewertet: 500 BFCL-Aufgaben, die jeweils dreimal beantwortet wurden, 250 HLE-Aufgaben mit je zehn Antworten und 25 AA-LCR-Aufgaben mit je zehn Antworten. BFCL wird anhand automatisierter Regeln bewertet; bei HLE und AA-LCR beurteilt das Bewertungsmodell deepseek-flash die Antworten als richtig oder falsch. Alle fünf Anbieter erhielten denselben Aufgabensatz; die drei Aufgabentypen fließen in eine gemeinsame Genauigkeitsrate ein. Zehn Antworten wurden ausgeschlossen, weil die Aufgabe nicht beurteilt werden konnte. Damit blieben 4,240 bewertete Versuche.
| Aufgabe | Elemente | Richtig | Genauigkeit | Fehler |
|---|---|---|---|---|
| BFCL-Tool-Aufrufe | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Schwierige HLE-Fragen, vom Bewertungsmodell beurteilt | 250 × 10 | 233/2,490 | 9.36% | 875 |
| AA-LCR-Reasoning über lange Dokumente | 25 × 10 | 82/250 | 32.80% | 100 |
| Gesamt · 95%-Intervall 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Servicefehler, egal ob ein Request fehlschlägt oder die Ausgabe abgeschnitten wird, bleiben im Nenner und zählen als falsche Antworten. Bei HLE gab es 864 fehlgeschlagene Requests (863 im ersten Zeitfenster, 1 im zweiten) und 11 Ausgaben, die am max_tokens-Limit abgeschnitten wurden. Bei AA-LCR gab es 100 fehlgeschlagene Requests, alle im ersten Zeitfenster.
Jede BFCL-Aufgabe wird dreimal beantwortet; die Tabelle fasst die drei Durchläufe zusammen.
| BFCL-Kategorie | Bestanden | Erfolgsrate |
|---|---|---|
| simple_python: eine Funktion, korrekter Aufruf und korrekte Argumente | 336/360 | 93.33% |
| multiple: aus mehreren Funktionen die richtige auswählen | 269/300 | 89.67% |
| parallel: eine Funktion mehrfach parallel aufrufen | 268/300 | 89.33% |
| parallel_multiple: mehrere verschiedene Funktionen parallel aufrufen | 206/240 | 85.83% |
| irrelevance: keine Funktion ist geeignet, also keine aufrufen | 113/150 | 75.33% |
| ahm_multi_turn: dreistufige Tool-Kette | 104/150 | 69.33% |
Vergleich mit den anderen vier
Der Unterschied zum offiziellen Endpunkt wird in Prozentpunkten angegeben; die Whisker zeigen das 95%-Intervall. Ein Intervall, das 0 einschließt, gilt als nicht unterscheidbar. Das Bewertungsmodell deepseek-flash für HLE und AA-LCR gehört zur selben DeepSeek-Familie wie das getestete Modell und wurde nicht kalibriert. Seine Bewertungen könnten daher zu großzügig ausfallen.
F — Funktionsunterstützung: 88.39
Die Funktionsfälle prüfen, ob sich die Schnittstelle gemäß den Protokollspezifikationen verhält, nicht, ob das Modell gute Antworten liefert. 60 Fälle in sechs Gruppen wurden in jedem der drei Zeitfenster einmal ausgeführt, also insgesamt 180 Prüfungen. Bewertet wurde anhand des vom Anbieter dokumentierten Formats. Nicht anwendbare, ungültige oder nicht beobachtete Prüfungen sind vom Nenner ausgeschlossen. Für Baidu wurden 174 Prüfungen gewertet, von denen 148 bestanden wurden; der gewichtete Score beträgt 88.39.
Der Gruppen-Score wird nach dem Anteil jeder Gruppe gewichtet und entspricht nicht einfach 148/174.
| Fallgruppe | Gewichtung | Bestanden | Ausgeschlossen | Gruppen-Score |
|---|---|---|---|---|
| Streaming und Nachrichtenprotokoll | 20% | 27/27 | 3 | 100.00 |
| Tool-Schnittstelle | 20% | 30/30 | — | 100.00 |
| Ausgabebeschränkungen und Parameter | 20% | 29/30 | — | 96.67 |
| Kontext und Zustand | 15% | 26/30 | — | 86.67 |
| Fehler und Wiederherstellung | 15% | 21/30 | — | 70.00 |
| Abrechnungs- und Cache-Protokoll | 10% | 15/27 | 3 | 55.56 |
| Gesamt, gewichtet | 100% | 148/174 | 6 | 88.39 |
| Fehlgeschlagener Fall | Fehlgeschlagene Zeitfenster | Grund |
|---|---|---|
| Kontext überschritten (Kontext und Zustand) | 3/3 | Es sollte ein Parameterfehler zurückgegeben werden; stattdessen kam 200 zurück |
| Fehlerhafte Nachrichten (Fehler und Wiederherstellung) | 3/3 | 400 mit leerem Body zurückgegeben, kein strukturierter Fehler |
| Verwaistes Tool-Ergebnis (Fehler und Wiederherstellung) | 3/3 | Es sollte ein Parameterfehler zurückgegeben werden; stattdessen kam 200 zurück |
| Fehlerhafte stream_options (Fehler und Wiederherstellung) | 3/3 | 400 mit leerem Body zurückgegeben, kein strukturierter Fehler |
| Cache-Lesefeld (Abrechnungs- und Cache-Protokoll) | 3/3 | Kein Cache-Lesefeld zurückgegeben; der Wert lässt sich nicht bestätigen |
| Abrechnung der Thinking-Tokens (Abrechnungs- und Cache-Protokoll) | 3/3 | Keine Anzahl der Thinking-Tokens zurückgegeben |
| Tool-Definitionen in der Eingabe mitgezählt (Abrechnungs- und Cache-Protokoll) | 3/3 | Mit Tool-Definitionen war die gemeldete Anzahl der Eingabe-Token nicht höher als ohne |
| Eingabeanzahl vor und nach dem Cache konsistent (Abrechnungs- und Cache-Protokoll) | 3/3 | Kein Cache-Lesefeld zurückgegeben; der Wert lässt sich nicht bestätigen |
| Vielfalt der Stichproben (Ausgabebeschränkungen und Parameter) | 1/3 | Die wiederholten Ausgaben bei Temperatur 0 und 1 unterschieden sich zu wenig und lagen unter dem vorab festgelegten Standard |
| Isolierung zwischen Requests (Kontext und Zustand) | 1/3 | Der erste Schritt gab nicht wie gefordert ausschließlich STORED zurück, daher konnte die Isolierungsprüfung nicht fortgesetzt werden |
Diese Prüfungen sind vom Nenner ausgeschlossen: Sie gelten weder als bestanden noch als fehlgeschlagen.
| Status | Fall | Anzahl | Grund |
|---|---|---|---|
| Nicht beobachtet | Streaming-Stoppsequenz | 3 | Der Request für diesen Schritt wurde nach dem vorherigen Schritt nicht gesendet und kann daher nicht beurteilt werden |
| Nicht anwendbar | Explizites cache_control | 3 | Vorab als nicht von dieser Schnittstelle unterstützt festgelegt |
Fehlerhafte messages und fehlerhafte stream_options schlugen bei allen fünf Anbietern fehl: Beide lieferten 400 mit leerem Body zurück, sodass dem Client kein strukturierter Fehler zur Verfügung stand. Ein Fehler, der bei allen fünf auftritt, liegt wahrscheinlich eher auf der Ebene des AIHubMix-Gateways und muss separat untersucht werden. Auch die Abrechnung der Thinking-Tokens schlug bei allen fünf fehl, allerdings aus unterschiedlichen Gründen: ByteDance und Fireworks meldeten Thinking-Tokens, obwohl der Denkmodus deaktiviert war; die übrigen drei gaben keine Anzahl der Thinking-Tokens zurück.
Vergleich mit den anderen vier
P — Antwortgeschwindigkeit: 37.77
Jeder Request enthielt etwa 10,000 Eingabe-Token und verlangte eine Ausgabe von etwa 1,100 Token. In drei Zeitfenstern wurden jeweils 30 Probes mit Einzelparallelität und 30 Probes mit zehn parallelen Requests gesendet, insgesamt also 180 Requests.
| Metrik | Ergebnis |
|---|---|
| TTFA bis zum ersten Token | Einzelparallelität: Median 2.26 s (Median gültiger Requests 2.05 s); bei zehn parallelen Requests war mehr als die Hälfte ungültig, Median daher als unendlich gewertet (Median gültiger Requests 1.86 s) |
| Generierungsgeschwindigkeit TPOT | Einzelparallelität: 3.48 ms/Token; zehn parallele Requests: 50.00 ms/Token (mehr als die Hälfte ungültig, Strafwert) |
| Goodput (gültiger Durchsatz) | Zehn parallele Requests: 1,329.2 Token/s |
| Gültige Requests | Einzelparallelität: 78/90 (erstes Zeitfenster 18/30); zehn parallele Requests: 40/90 (erstes Zeitfenster 0/30, drittes Zeitfenster 10/30) |
| Grund für ungültige Requests | 62 Probes lieferten 400 no_available_channel zurück |
| Teilscore | TTFA 0.00, TPOT 0.00, Durchsatz 100.00; Antwort-Score 30.00 |
| Zusammensetzung von P | Antwort-Score 30.00 mit einer Gewichtung von 80%, Cache K 68.85 mit einer Gewichtung von 20%, Gesamtwert 37.77 |
TPOT wird anhand gestreamter Chunks geschätzt und nicht für jedes Token auf der Hardware gemessen. Der Goodput entspricht der Anzahl gültiger Ausgabe-Token bei zehn parallelen Requests, geteilt durch die Batch-Laufzeit.
In der Stufe mit zehn parallelen Requests lieferten 50 von 90 Probes no_available_channel zurück. Da mehr als die Hälfte ungültig war, wird die Medianzeit bis zum ersten Token als unendlich behandelt; TTFA und TPOT erhalten beide ihre Strafwerte. Bei Einzelparallelität waren 78 von 90 Probes gültig.
Alle fünf Anbieter nutzten denselben Rechner, dasselbe Netzwerk und dasselbe Konto. Die drei Zeitfenster wurden nacheinander für die einzelnen Anbieter angesetzt, sodass sich die Erhebungszeiträume nicht vollständig überschneiden. Kleine Abweichungen sollten daher nicht überinterpretiert werden.
K — Cache: 68.85
Jede Gruppe umfasst fünf Requests. Der erste enthält ein festes Präfix mit etwa 8k oder 32k Token und befüllt den Cache. Bei den Requests 2–4 bleibt das Präfix unverändert; nur die Frage am Ende wird geändert. Die Abstände betragen 5 s, 30 s und 120 s. Der fünfte Request verwendet als Kontrolle ohne Cache ein neues Präfix. Drei Zeitfenster × zwei Längen ergeben 30 Requests. K entspricht der Zahl der von Hot-Requests gelesenen Cache-Token geteilt durch die Token, die laut den Regeln wiederverwendbar sein sollten; beide Präfixlängen werden gleich gewichtet. K macht 20% von P aus.
Die Tabelle zeigt die vom Server gemeldete Anzahl der gelesenen Cache-Token; „nicht zurückgegeben“ bedeutet, dass das Feld in der Antwort fehlte.
| Präfix | Zeitfenster | Befüllung | +5 s | +30 s | +120 s | Kontrolle ohne Cache |
|---|---|---|---|---|---|---|
| 8k | 1 | Fehlgeschlagen | Fehlgeschlagen | Fehlgeschlagen | Nicht zurückgegeben | Nicht zurückgegeben |
| 8k | 2 | Nicht zurückgegeben | 7,168 | 7,168 | Fehlgeschlagen | Fehlgeschlagen |
| 8k | 3 | Nicht zurückgegeben | 7,168 | 7,168 | 7,168 | Nicht zurückgegeben |
| 32k | 1 | Nicht zurückgegeben | Nicht zurückgegeben | 31,744 | 31,744 | Nicht zurückgegeben |
| 32k | 2 | Nicht zurückgegeben | 31,744 | 31,744 | 31,744 | Nicht zurückgegeben |
| 32k | 3 | Nicht zurückgegeben | 31,744 | 31,744 | 31,744 | Nicht zurückgegeben |
Der 8k-Präfix erzielte bei 5 von 9 häufigen Anfragen einen Treffer. Dabei wurden 35,840 von 72,252 Tokens gelesen, die wiederverwendbar sein sollten: 49.60. Der 32k-Präfix erzielte bei 8 von 9 Anfragen einen Treffer und las 253,952 von 288,261 Tokens: 88.10. Bei gleicher Gewichtung der beiden Längen ergibt sich für K ein Wert von 68.85. Insgesamt schlugen fünf 8k-Anfragen fehl: das Seed-Request sowie die Anfragen nach 5 s und 30 s in Fenster 1 und die Anfragen nach 120 s sowie die Cold-Control-Anfrage in Fenster 2. Bei allen lautete der Fehler no_available_channel. Damit gab es in der 8k-Stufe drei fehlgeschlagene häufige Anfragen.
Bei einem Treffer wird der gemeldete Lesewert in Blöcken zu 1,024 Tokens gezählt: 7,168 Tokens für den 8k-Präfix und 31,744 für den 32k-Präfix. Bei einem Fehlschlag fehlt prompt_tokens_details im Nutzungsblock. In der Tabelle ist der Wert als „nicht zurückgegeben“ vermerkt und wird mit 0 angesetzt.
Im Vergleich zu den anderen vier
R – Dienststabilität: 100
Die 300 Anfragen gehören zu vier Typen: kurze Texte, lange Eingaben, Tool-Aufrufe und mehrstufige Gesprächsverläufe. Sie wurden bei einer Parallelität von 1 über drei Zeitfenster gesendet. Geprüft wird nur, ob die erste Antwort gültig und vollständig war; die Antworten werden nicht bewertet und es werden keine Wiederholungsversuche unternommen. Fehler beim Beantworten und in den Geschwindigkeitstests werden unter Q und P gezählt, nicht erneut unter R.
| Anfragetyp | Erfolg beim ersten Versuch |
|---|---|
| Kurzer Text | 120/120 |
| 10k lange Eingabe | 90/90 |
| Tool-Aufruf | 60/60 |
| Mehrstufiger Gesprächsverlauf | 30/30 |
| Gesamt | 300/300, 95%-KI 98.78%–100% |
Alle 300 Anfragen lieferten beim ersten Versuch eine gültige, vollständige Antwort. R 100 gilt nur für diese 300 eigens dafür gesendeten Anfragen; es bedeutet nicht, dass der gesamte Ablauf fehlerfrei war. Bei 300 erfolgreichen Anfragen von 300 liegt die Untergrenze des 95%-Intervalls bei 98.78%. Die Fehlerquote liegt daher wahrscheinlich unter 1.22%.
Im Vergleich zu den anderen vier
R umfasst nur diese 300 eigens dafür gesendeten Anfragen; Fehler beim Beantworten und in den Geschwindigkeitstests werden unter Q und P erfasst, nicht erneut unter R.
| Anbieter | Erfolg beim ersten Versuch | 95%-Intervall |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek offiziell | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Was sagt die Gesamtbewertung aus?
Sie ist ein zusammenfassender Index ohne Konfidenzintervall, keine Zertifizierung. Dieser Beitrag berichtet über Q, F, P, K und R und gibt keine Anbieterempfehlung ab.
Warum ist die Hälfte der Tests mit 10 gleichzeitigen Anfragen fehlgeschlagen?
50 der 90 Anfragen lieferten no_available_channel. Da mehr als die Hälfte ungültig war, wird die mediane Zeit bis zum ersten Token als unendlich behandelt und TTFA sowie TPOT werden mit ihren Strafwerten bewertet.
Bedeutet R 100, dass es keine Kanalfehler gab?
Nein. R umfasst 300 eigens dafür gesendete Anfragen, die alle beim ersten Versuch erfolgreich waren. Die 62 Antworten mit no_available_channel im Geschwindigkeitstest und die Fehler im Beantwortungstest werden unter P und Q gezählt.
Warum beträgt K 68.85, obwohl der 32k-Präfix bei 8 von 9 Anfragen einen Treffer erzielte?
Beide Längen werden gleich gewichtet. Der 8k-Präfix erzielte bei 5 von 9 häufigen Anfragen einen Treffer und erreichte 49.60, während der 32k-Präfix bei 8 von 9 einen Treffer erzielte und 88.10 erreichte. Der Durchschnitt beträgt 68.85.
Lässt sich die Antwortqualität von Baidu von der des offiziellen Kanals unterscheiden?
Ja. Der kombinierte Unterschied bei Q beträgt −4.46 Prozentpunkte. Das 95%-Intervall reicht von −5.78 bis −3.16 und schließt 0 aus. Es ist das einzige Ergebnis eines Anbieters unterhalb des offiziellen Kanals, dessen Intervall 0 ausschließt.
Welche Prüfungen wurden aus F ausgeschlossen?
Sechs: drei Prüfungen von Stoppsequenzen im Streaming, die nie beobachtet wurden, weil die Anfrage für den vorherigen Schritt nicht gesendet wurde, und drei explizite Prüfungen von cache_control, die vorab als von dieser Schnittstelle nicht unterstützt registriert worden waren.
Weiterlesen: die DeepSeek V4.1 Flash-Reihe
- Die BFCL-Genauigkeit von Baidu lag nahe am offiziellen Kanal. Im Beitrag zu ByteDance wird dieselbe Testsuite anhand der Tool-Aufrufe und der Zählergebnisse untersucht: DeepSeek V4.1 Flash bei ByteDance: Tool-Aufrufe stimmen, Zählergebnisse nicht
- Baidus TTFA von 2.26 s bei einfacher Parallelität steht einem Testlauf mit 1.34 s gegenüber: DeepSeek V4.1 Flash bei Alibaba Cloud: erstes Token nach 1.34 s, Cache 99.37
- Baidus F-Wert von 88.39 steht einem Referenzlauf mit 94.00 und 15 ungültigen Tests gegenüber: DeepSeek V4.1 Flash über den offiziellen Kanal: F 94.00, 15 ungültige Tests
- Baidus 8k-Cache-Treffer von 5/9 im Vergleich zu einem Lauf mit 3/9 und leeren Stoppantworten: DeepSeek V4.1 Flash bei Fireworks: leere Stoppantworten, 3/9 Cache-Treffer


