

Am 2026-11-03/04 wurde DeepSeek V4.1 Flash 1017 über die APB-Full-Suite bei fünf Anbietern getestet. Alle wurden über AIHubMix mit denselben Fragen, Parametern und Anfrageskripten aufgerufen. Dieses APB-Profil behandelt ausschließlich Fireworks. Das Modell ist als DeepSeek V4.1 Flash 1017 aufgeführt.
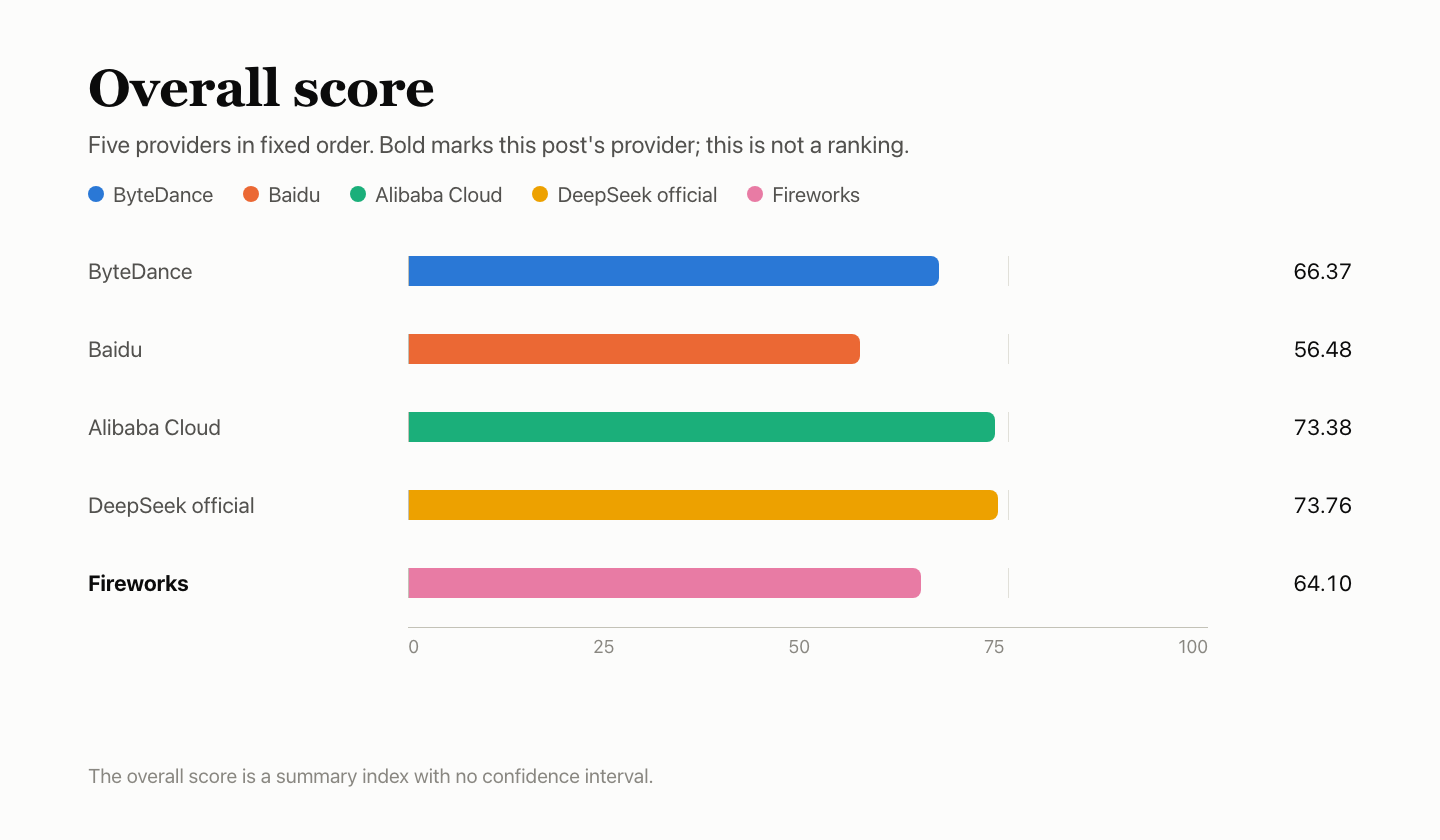
Die Werte lauten Q 41.42, F 71.78, P 79.51, K 60.68 und R 100; der Gesamtindex beträgt 64.10. Dieser Beitrag berichtet nur die Werte, ohne Ranking oder Anbieterempfehlung. Q, F, P, K und R stehen an erster Stelle; der Gesamtindex ist eine zusammenfassende Kennzahl ohne Konfidenzintervall. Der Standard ist AIHubMix Provider Benchmark Standard v2.0.
Werte für fünf Anbieter
Fettdruck kennzeichnet den Anbieter dieses Beitrags. Feste Anbieterreihenfolge, kein Ranking. K ist ein Teilwert von P und macht 20% aus. Der Gesamtindex ist eine zusammenfassende Kennzahl ohne Konfidenzintervall. DeepSeek Official Channel und Alibaba Cloud unterscheiden sich um 0.37 und sind nicht voneinander zu unterscheiden.
Auf einen Blick
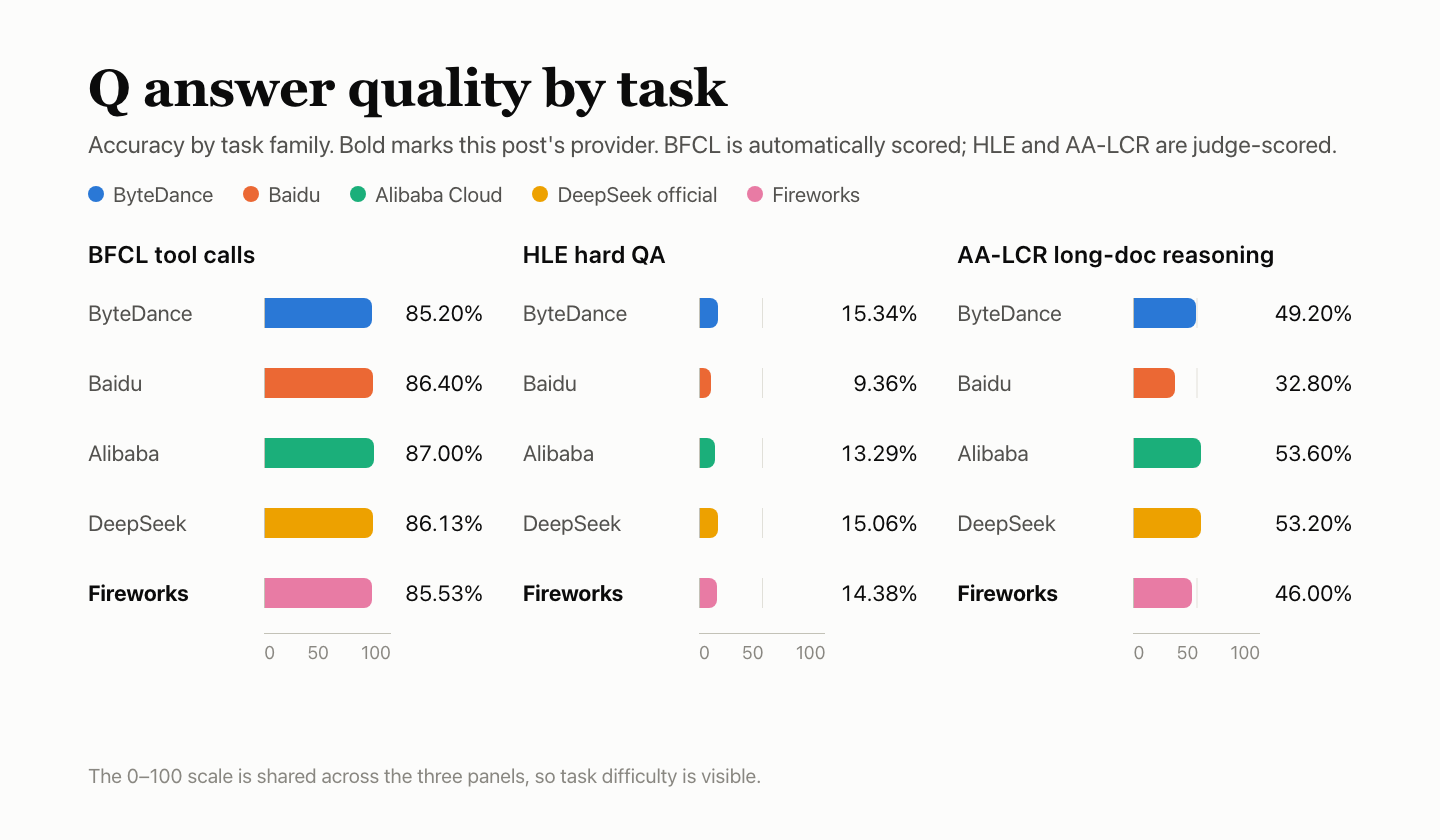
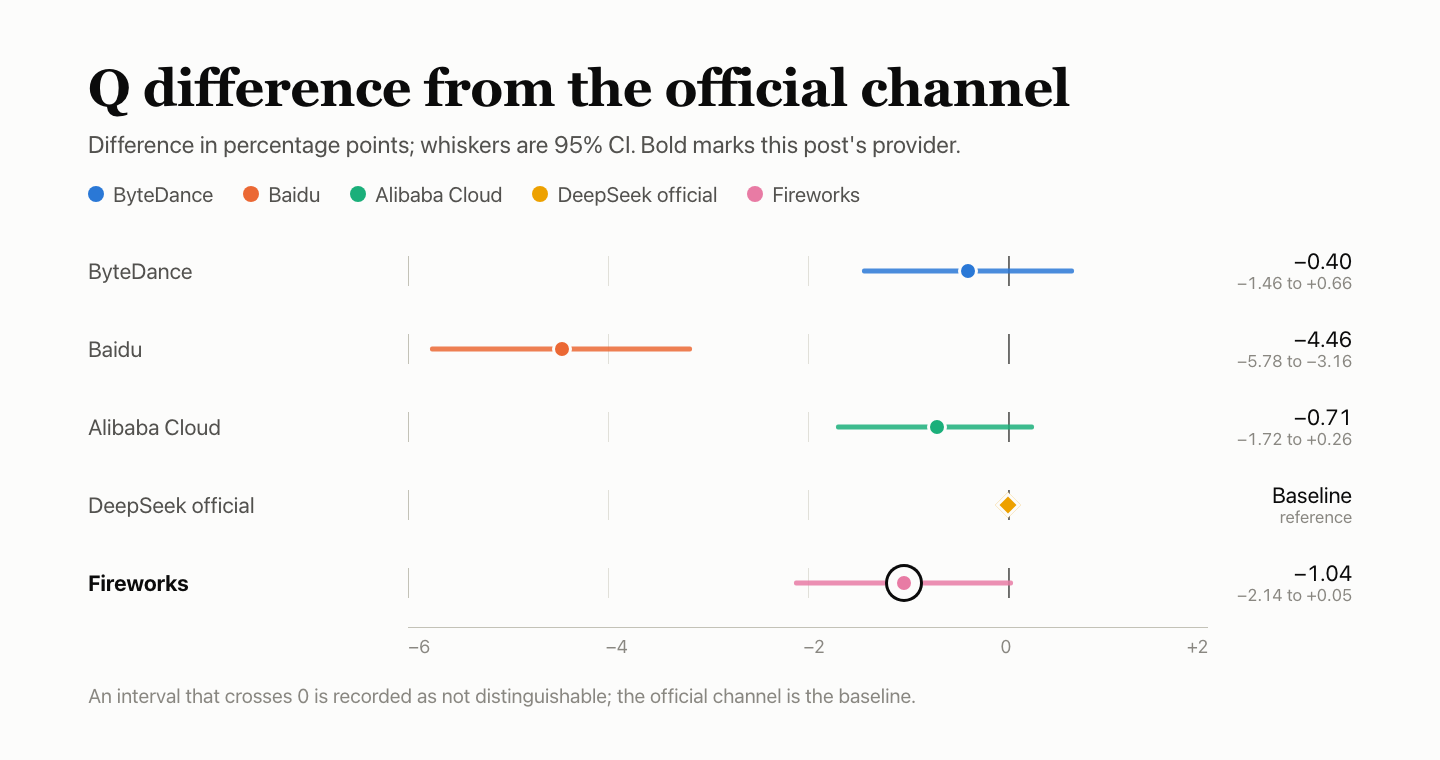
- Q — Antwortqualität: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. Gegenüber dem Official Channel: −1.04 Prozentpunkte, 95%-KI −2.14 bis +0.05, kein statistisch unterscheidbarer Unterschied. Alle 34 AA-LCR-Fehler traten in Fenster 2 auf und wurden als falsch gewertet.
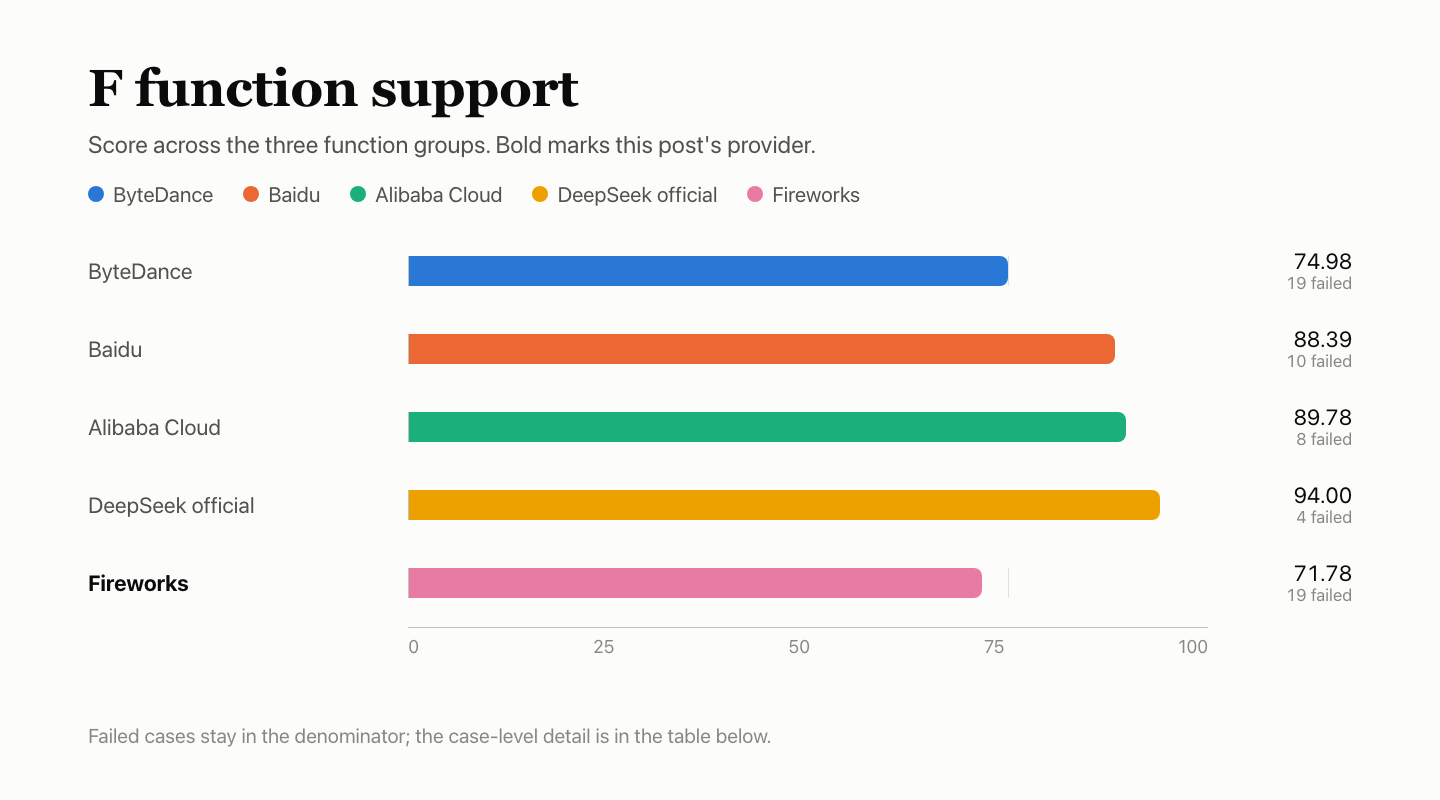
- F — Funktionsunterstützung: 71.78. 122/177 gewertete Prüfungen bestanden. Beide Stop-Fälle lieferten einen leeren Body zurück;
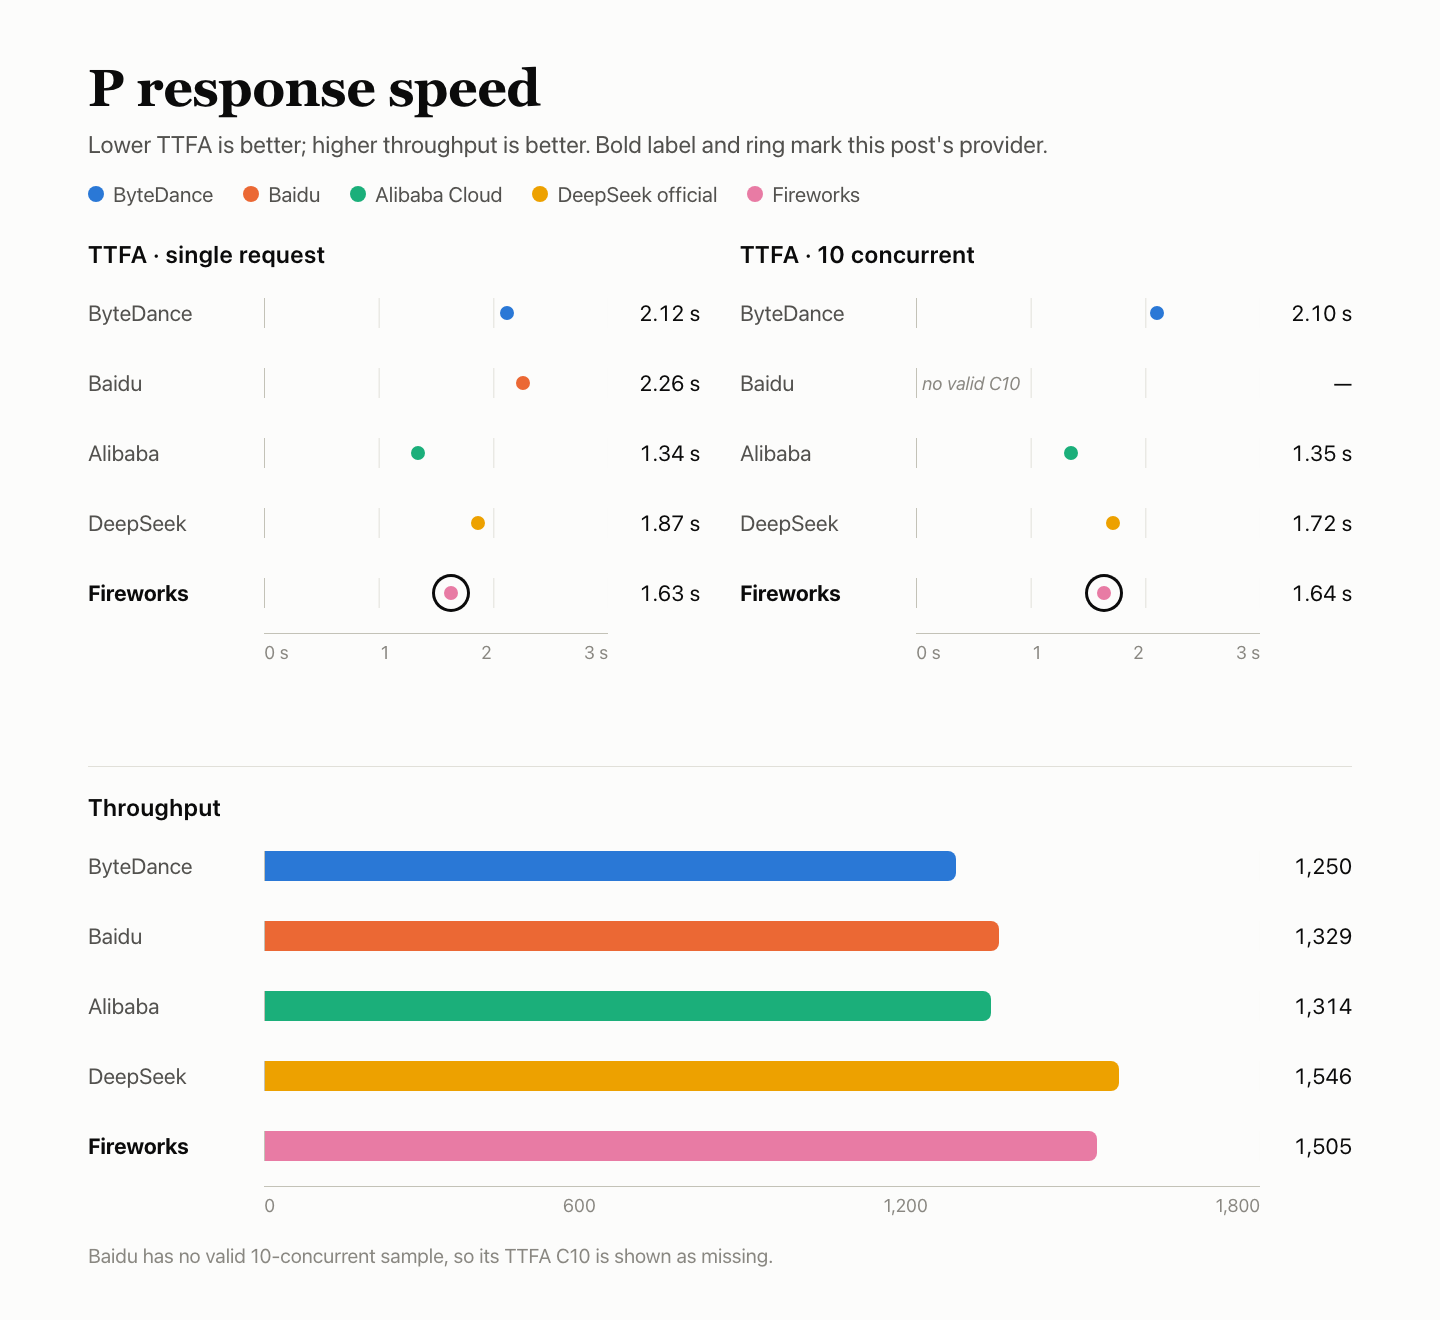
reasoning_effort=noneschaltete den Denkmodus nicht aus; bei einer Eingabe mit 10k wurden 10,026 Token angegeben, gegenüber einer nativen Zählung von 10,000. - P — Antwortgeschwindigkeit: 79.51. Antwortwert 84.22, Cache-K bei 20%. TTFA-Median 1.63 s bei Einzelanfragen, 1.64 s bei 10 gleichzeitigen Anfragen; TPOT 3.29 ms. 1 von 180 Ausgaben bestand aus einem einzelnen Token und wurde als ungültig markiert.
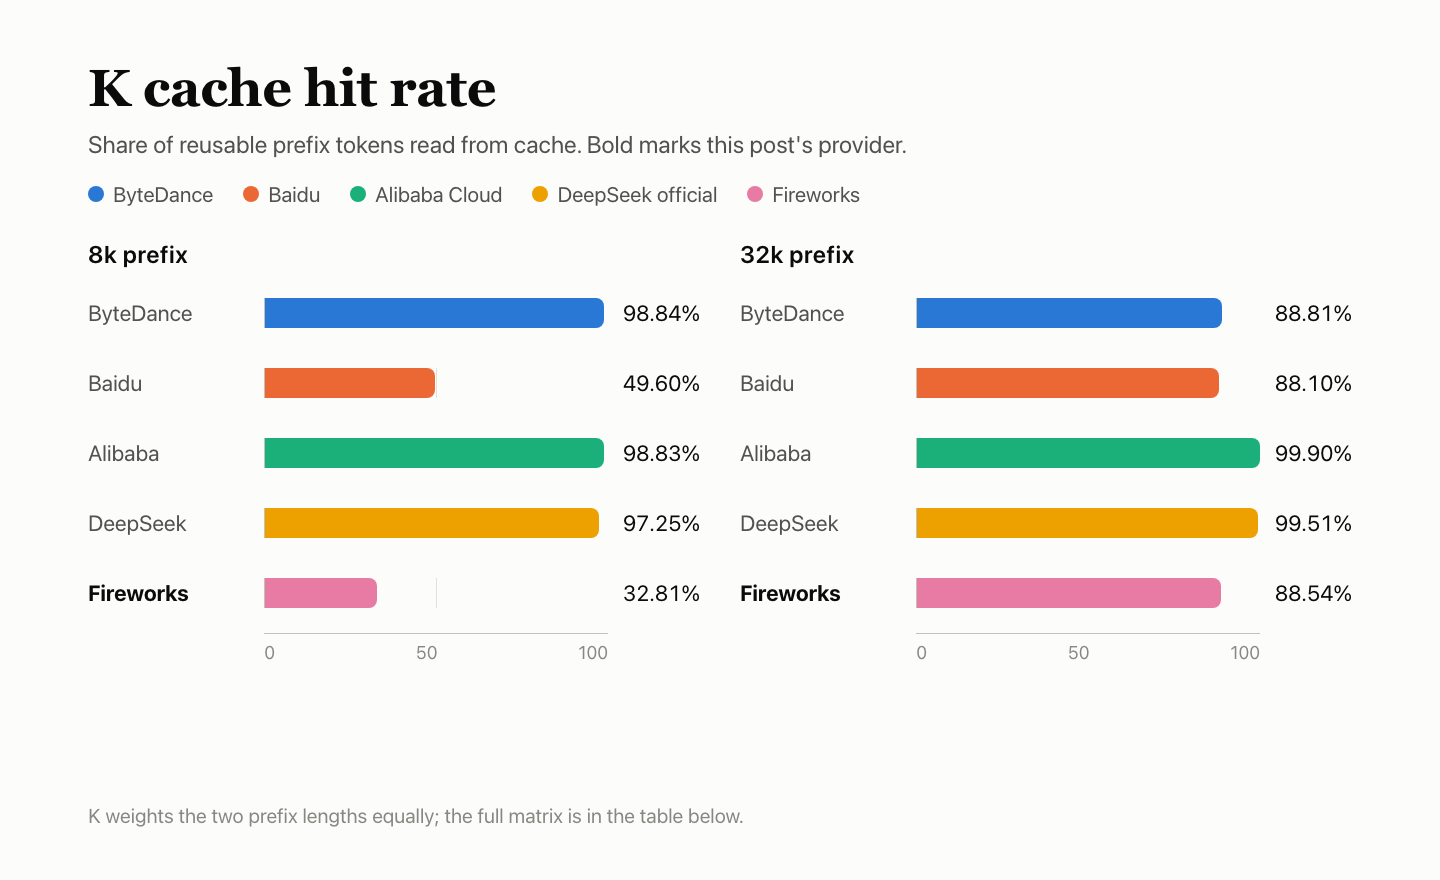
- K — Cache: 60.68. Bei den K-Prüfungen wurde die dokumentierte Sitzungsaffinität verwendet. 32k warm 8/9; 8k warm 3/9.
- R — Dienststabilität: 100. 300/300 dedizierte Anfragen waren beim ersten Versuch erfolgreich.
Testaufbau
| Element | Einstellung |
|---|---|
| Modell | DeepSeek V4.1 Flash 1017 |
| Angeforderte Modell-ID | fireworks-deepseek-v4.1-flash-1017 |
| Zurückgegebener Modellname | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Zugriffsroute | AIHubMix-Anbietermodell-ID, nicht das eigene Konto des Anbieters |
| Parameter | Denkmodus aus, Temperatur 1.0, max_tokens 16,384, Timeout 300 s, keine Wiederholungsversuche |
| Denkmodus aus | Native Einstellung thinking.type=disabled; reasoning_effort=none schaltet den Denkmodus nicht aus. Bei den Funktionsfällen blieb reasoning_effort=none eingestellt. |
| Zeit | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Ein Mac mini, ein Netzwerk und ein Konto für alle fünf. |
| Stichproben | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Zusätzliche Einstellungen | Die K-Prüfungen enthielten das dokumentierte user-Feld und den Header x-session-affinity zur Replikat-Affinität. |
Für die Anfragen wurde der Schnellstart von AIHubMix verwendet; die Modell-IDs stehen auf der Modellseite. Für den deaktivierten Denkmodus wurde die native Einstellung thinking.type=disabled aus der API-Dokumentation des Modells verwendet.
Q — Antwortqualität: 41.42
Die Suite umfasste 500 BFCL-Fragen × 3 Durchläufe, 250 HLE × 10 und 25 AA-LCR × 10. BFCL wurde automatisch bewertet; HLE und AA-LCR wurden von deepseek-flash beurteilt. Alle fünf erhielten dieselben Fragen. Zehn nicht bewertbare Antworten wurden entfernt; es blieben 4,240 bewertete Instanzen.
| Aufgabe | Fragen | Richtig | Genauigkeit | Fehler |
|---|---|---|---|---|
| BFCL-Tool-Aufrufe | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| HLE anspruchsvolle QA | 250 × 10 | 358/2,490 | 14.38% | 5 |
| AA-LCR Schlussfolgern mit langen Dokumenten | 25 × 10 | 115/250 | 46.00% | 34 |
| Gesamt · 95%-KI 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Fehler bleiben im Nenner und werden als falsch gewertet: BFCL 2 (Fenster 2 und 3), HLE 5 wegen max_tokens abgeschnitten, AA-LCR 34, alle in Fenster 2.
| BFCL-Kategorie | Bestanden | Bestehensquote |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python bestand 333/360 (92.50%), parallel 270/300 (90.00%), ahm_multi_turn 95/150 (63.33%) und irrelevance 111/150 (74.00%).
Vergleich mit den anderen vier
Unterschied in Prozentpunkten gegenüber dem Official Channel; das 95%-Intervall ist als Whisker dargestellt. Wenn das Intervall 0 schneidet, ist kein Unterschied erkennbar. Der Beurteiler deepseek-flash gehört zur selben Modellfamilie und ist nicht kalibriert, daher könnte er großzügig bewerten.
F — Funktionsunterstützung: 71.78
Die 60 Fälle bilden sechs Gruppen und wurden jeweils in drei Fenstern ausgeführt: insgesamt 180 Prüfungen, bewertet anhand des dokumentierten Formats des Anbieters. Nicht zutreffende, ungültige und nicht beobachtete Prüfungen bleiben außerhalb des Nenners. 122 von 177 gewerteten Prüfungen bestanden; die Gewichtung der Gruppen ergibt 71.78.
| Fallgruppe | Gewichtung | Bestanden | Ausgeschlossen | Gruppenwert |
|---|---|---|---|---|
| Streaming und Nachrichten | 20% | 24/30 | — | 80.00 |
| Tool-Schnittstelle | 20% | 29/30 | — | 96.67 |
| Ausgabebeschränkungen | 20% | 21/30 | — | 70.00 |
| Kontext und Zustand | 15% | 15/30 | — | 50.00 |
| Fehler und Wiederherstellung | 15% | 21/30 | — | 70.00 |
| Abrechnung und Cache | 10% | 12/27 | 3 | 44.44 |
| Gesamt · gewichtet | — | 122/177 | 3 | 71.78 |
„Fehlgeschlagene Fenster“ zählt die drei Fenster, in denen der Fall nicht bestanden wurde.
| Fehlgeschlagener Fall | Fehlgeschlagene Fenster | Grund |
|---|---|---|
| Streaming-Stop | 3/3 | Bei Stop leerer Body; ohne Stop funktioniert es. |
| Reasoning im Body | 3/3 | reasoning_effort=none gab weiterhin Reasoning zurück. |
| Stop-Sequenz | 3/3 | Bei Stop leerer Body; ohne Stop funktioniert es. |
| Denkmodus-Einstellung | 3/3 | reasoning_effort=none gab weiterhin Reasoning zurück. |
| Sampling-Diversität | 3/3 | Temp 0/1 zu ähnlich |
| Lange Eingabe mit 10k | 3/3 | 10,026 angegeben; nativ 10,000. |
| Innerhalb des Kontextlimits | 3/3 | 10,026 angegeben; nativ 10,000. |
| Lange Eingabe mit 32k | 3/3 | 10,026 angegeben; nativ 10,000. |
| Lange Eingabe mit 100k | 3/3 | 10,026 angegeben; nativ 10,000. |
| Außerhalb des Kontexts | 3/3 | Sollte einen Parameterfehler auslösen; gab 200 zurück. |
| Fehlerhafte Nachrichten | 3/3 | 400, leerer Body |
| Verwaistes Tool-Ergebnis | 3/3 | Sollte einen Parameterfehler auslösen; gab 200 zurück. |
| Fehlerhafte stream_options | 3/3 | 400, leerer Body |
| Abrechnung von Denk-Token | 3/3 | Denk-Token wurden trotz Deaktivierung angegeben. |
| Native Eingabezählung | 3/3 | 34 angegeben; nativ 8. |
| Tool-Definitionen in der Eingabe | 3/3 | Bereits die Kontrolle ohne Tools stimmte nicht überein. |
| Eingabezählung über den Cache hinweg | 3/3 | Die Zählung des wiederholten Präfixes wich von der nativen ab. |
| Übereinstimmung der Streaming-Eingabe | 3/3 | 34 angegeben; nativ 8 |
| Jeweils ein Tool | 1/3 | Upstream-500. |
Beide Stop-Fälle lieferten in allen drei Fenstern einen leeren Body, während dieselbe Eingabe ohne Stop funktionierte. reasoning_effort=none gab in beiden Denkmodus-Fällen weiterhin Reasoning zurück.
Ausgeschlossene Prüfungen zählen weder als bestanden noch als fehlgeschlagen.
| Status | Fall | Anzahl | Grund |
|---|---|---|---|
| Nicht zutreffend | Explizites cache_control | 3 | Vorab als von dieser Schnittstelle nicht unterstützt registriert |
Fehlerhafte messages und stream_options schlugen bei allen fünf Anbietern fehl: 400 mit leerem Body und ohne strukturierten Fehler. Das gemeinsame Ergebnis liegt wahrscheinlich auf der Gateway-Ebene von AIHubMix und muss separat untersucht werden. Auch die Abrechnung von Denk-Token schlug bei allen fünf fehl, aber ByteDance und Fireworks gaben Denk-Token trotz Deaktivierung an, während die anderen drei keine Denk-Token-Zahl zurückgaben.
Vergleich mit den anderen vier
P — Antwortgeschwindigkeit: 79.51
Jede Anfrage enthielt etwa 10,000 Eingabe-Token und forderte etwa 1,100 Ausgabe-Token an. In jedem der drei Fenster wurden 30 Anfragen mit Einzelparallelität und 30 mit 10 gleichzeitigen Anfragen gesendet, insgesamt also 180.
| Metrik | Ergebnis |
|---|---|
| TTFA | 1.63 s bei Einzelanfragen; 1.64 s bei 10 gleichzeitigen Anfragen |
| TPOT | 3.24 ms bei Einzelanfragen; 3.29 ms bei 10 |
| Goodput | 1,504.5 Token/s bei 10 |
| Gültig | 90/90 bei Einzelanfragen; 89/90 bei 10 (29/30 in Fenster 3), eine Ausgabe mit nur einem Token |
| Komponenten | TTFA 54.91, TPOT 100.00, Goodput 100.00; Gewichtungen 35/35/30 |
| Zusammensetzung von P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 von 180 waren gültig; die ungültige Anfrage gab ein Token zurück und wird bei den Medianen als unendlich gewertet, sodass die Mediane höher sein können als bei ausschließlich gültigen Anfragen. TPOT wird aus Streaming-Chunks ermittelt; Goodput entspricht den gültigen Ausgabe-Token bei 10 gleichzeitigen Anfragen geteilt durch die Batch-Dauer.
Ein Rechner, ein Netzwerk und ein Konto; die Zeitfenster wurden nach Anbieter geplant.
K — Cache: 60.68
Jede Gruppe besteht aus fünf Anfragen: Zunächst wird ein 8k- oder 32k-Präfix vorbereitet, dann dasselbe Präfix mit einer neuen abschließenden Frage nach 5 s, 30 s und 120 s verwendet, anschließend folgt ein neues Präfix als kalte Kontrolle. Drei Fenster × zwei Längen = 30. K entspricht den gelesenen Token aus dem warmen Cache geteilt durch die wiederverwendbaren Token; beide Längen werden gleich gewichtet. K macht 20% von P aus.
| Präfix | Fenster | Seed | +5 s | +30 s | +120 s | Kalte Kontrolle |
|---|---|---|---|---|---|---|
| 8k | Fenster 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Fenster 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Fenster 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Fenster 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Fenster 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Fenster 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Beim 8k-Präfix gab es bei 3 von 9 warmen Anfragen einen Cache-Treffer; dabei wurden 23,706 von 72,252 wiederverwendbaren Tokens gelesen, also 32.81. Beim 32k-Präfix waren es 8 von 9 Anfragen und 255,212 von 288,261 Tokens, also 88.54. Bei gleicher Gewichtung der beiden Längen liegt K bei 60.68. Die kalten Kontrollanfragen lasen 0. Die beiden Präfixlängen verhielten sich beim gleichen Design also unterschiedlich. Die K-Probes verwendeten das dokumentierte Feld user und den Header x-session-affinity.
R – Dienststabilität: 100
300 Anfragen deckten kurze Texte, lange Eingaben, Tool-Aufrufe und mehrstufige Gesprächsverläufe bei einer Parallelität von 1 über drei Fenster hinweg ab. Geprüft wurden nur die Gültigkeit und Vollständigkeit der ersten Antwort; die Antworten wurden nicht bewertet und es gab keine Wiederholungsversuche. Fehler bei Q und P werden hier nicht erneut gezählt.
| Anfragetyp | Erfolg beim ersten Versuch |
|---|---|
| Kurzer Text | 120/120 |
| Lange Eingabe mit 10k | 90/90 |
| Tool-Aufrufe | 60/60 |
| Mehrstufiger Gesprächsverlauf | 30/30 |
| Gesamt · 95%-Konfidenzintervall 98.78%–100% | 300/300 |
Alle 300 Anfragen lieferten beim ersten Versuch eine gültige, vollständige Antwort. Bei 300 Erfolgen liegt die untere Grenze des 95%-Konfidenzintervalls bei 98.78%. Die Daten belegen daher lediglich eine Fehlerrate unter 1.22%. R 100 bezieht sich auf diese 300 Anfragen, nicht auf den gesamten Ablauf.
| Anbieter | Erfolg beim ersten Versuch | 95%-Konfidenzintervall |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek offiziell | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Was umfasst Q 41.42?
BFCL, HLE und AA-LCR über 4,240 bewertete Instanzen: 1,756 richtige Antworten, 41.42%, 95%-Konfidenzintervall 39.13%–43.59%; der Abstand zum offiziellen Kanal ist statistisch nicht unterscheidbar.
Warum schlugen beide Stop-Fälle fehl?
Eine Anfrage mit stop lieferte in allen drei Fenstern einen leeren Body, während dieselbe Eingabe ohne stop funktionierte. Das zeigt sich sowohl bei Streaming als auch ohne Streaming.
Deaktiviert reasoning_effort=none das Denken?
Nein. In allen drei Fenstern wurde weiterhin Reasoning-Inhalt ausgegeben; bei anderen Anfragen kam der native Parameter thinking.type=disabled zum Einsatz.
Warum werden für eine Eingabe mit 10k 10,026 Tokens angegeben?
Für den 10k-Fall wurden 10,026 statt der nativen 10,000 angegeben. Auch bei den Fällen mit 32k und 100k wurden 10,026 angegeben; schon eine Kontrolle ohne Tools ergab eine Abweichung.
Warum gab es beim 8k-Präfix 3/9, beim 32k-Präfix aber 8/9 Treffer?
Beide verwendeten dasselbe Design und dieselben dokumentierten Affinity-Einstellungen. Der Unterschied zeigt sich bei den vom Server gemeldeten Lesevorgängen: Beim 8k-Präfix gab es in den Fenstern 1 und 2 Treffer, beim 32k-Präfix in allen drei.
Was umfasst R 100?
300 eigens dafür gesendete Anfragen, alle beim ersten Versuch gültig; die untere Grenze des 95%-Konfidenzintervalls liegt bei 98.78%. Fehler bei Q und P werden nicht bei R mitgezählt.
Weiterlesen: die DeepSeek V4.1 Flash-Reihe
- Wie bei Fireworks meldete ByteDance nach der Deaktivierung des Denkens Thinking-Tokens: DeepSeek V4.1 Flash auf ByteDance: Tool-Aufrufe stimmen, Abrechnung nicht
- Bei Baidu wurden Q 38.00 und P 37.77 gemessen: DeepSeek V4.1 Flash auf Baidu: Kein verfügbarer Kanal erreicht Q und P
- Bei Alibaba Cloud wurden ein erstes Token nach 1.34 s und ein Cache-Wert von 99.37 gemessen: DeepSeek V4.1 Flash auf Alibaba Cloud: erstes Token nach 1.34s, Cache-Wert 99.37
- Der offizielle Kanal dient als Q-Baseline und erreicht F 94.00: DeepSeek V4.1 Flash auf dem offiziellen Kanal: 94.00 F, 15 ungültige Probes


