
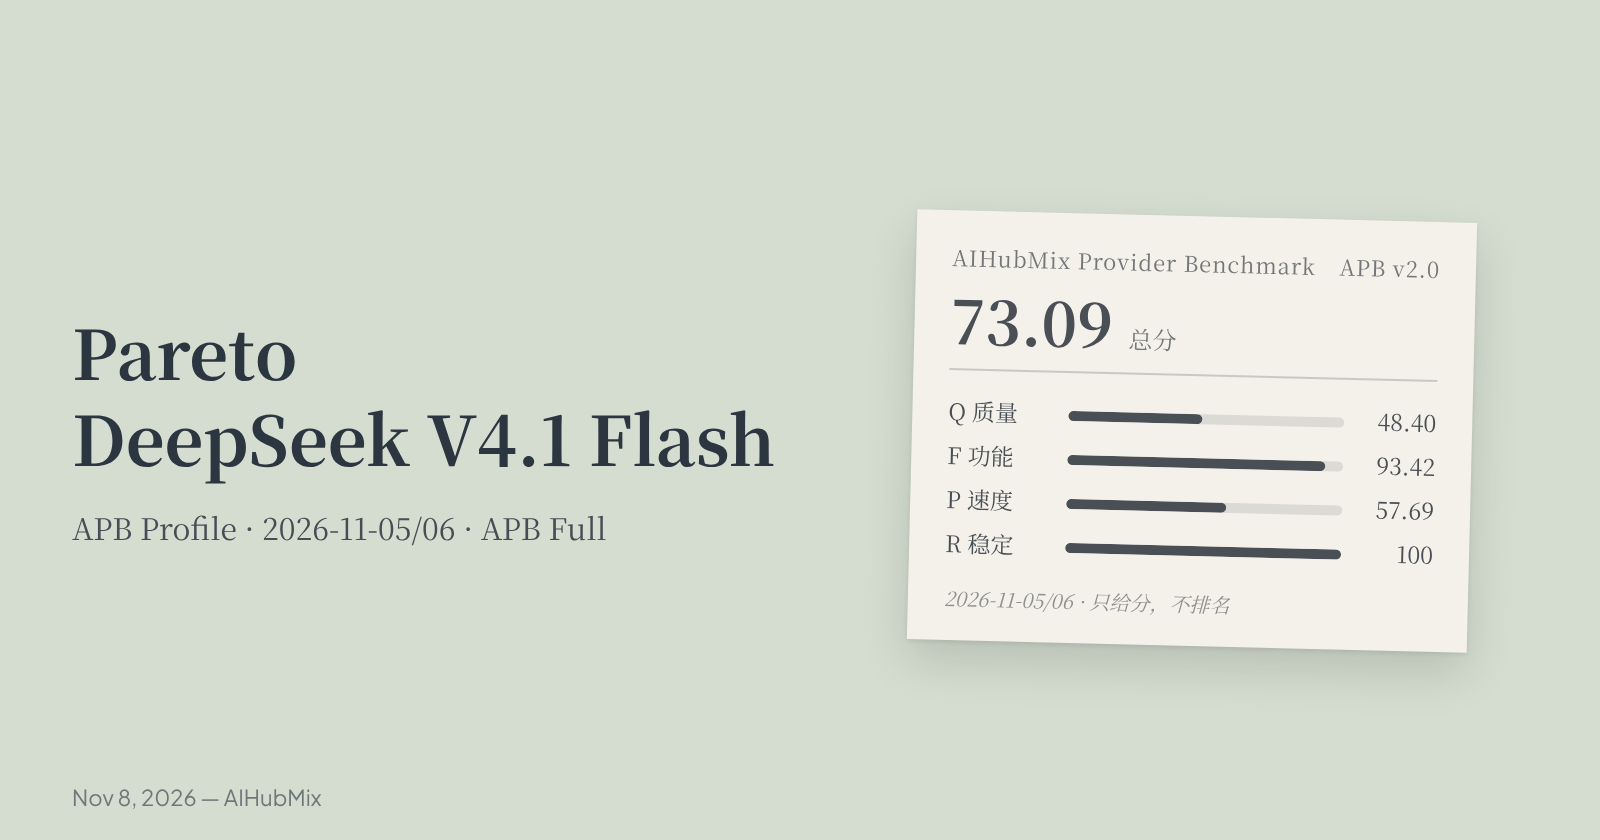
Am 2026-11-05/06 wurde DeepSeek V4.1 Flash 1017 auf Pareto mit der vollständigen AIHubMix Provider Benchmark (APB)-Suite getestet. Die Ergebnisse: Q 48.40, F 93.42, P 57.69, K 27.58 und R 100; der Gesamtindex liegt bei 73.09. Dieses APB-Profil umfasst ausschließlich Pareto. Das Modell ist als DeepSeek V4.1 Flash 1017 aufgeführt.
Dieser Beitrag berichtet ausschließlich Ergebnisse und enthält weder ein Ranking noch eine Empfehlung für einen Anbieter. Q, F, P, K und R stehen im Vordergrund; der Gesamtindex ist ein zusammenfassender Wert ohne Konfidenzintervall. Maßstab ist der AIHubMix Provider Benchmark Standard v2.0.
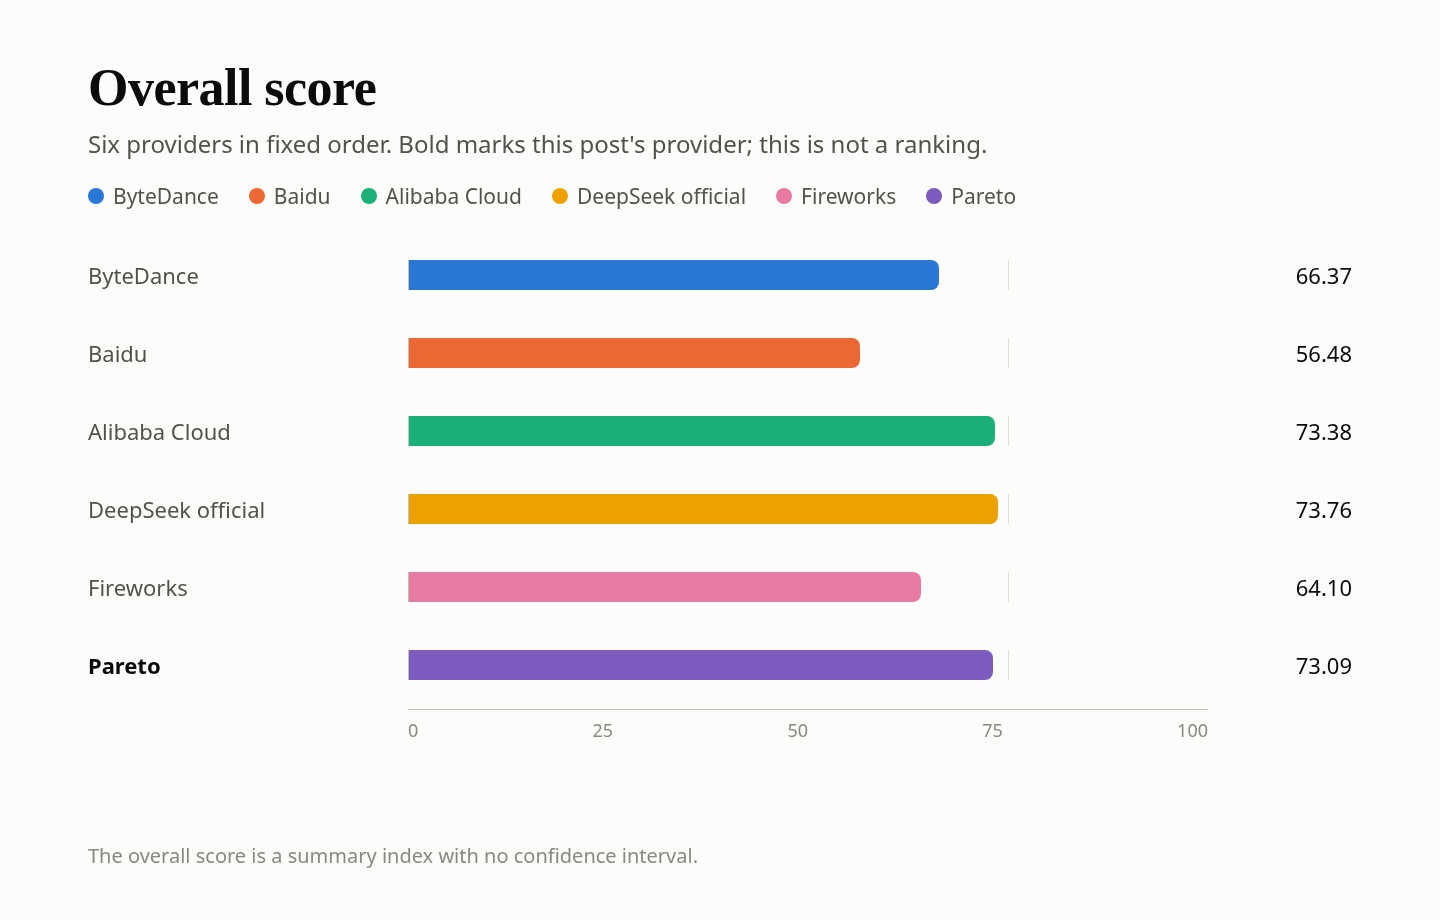
Ergebnisse bei sechs Anbietern
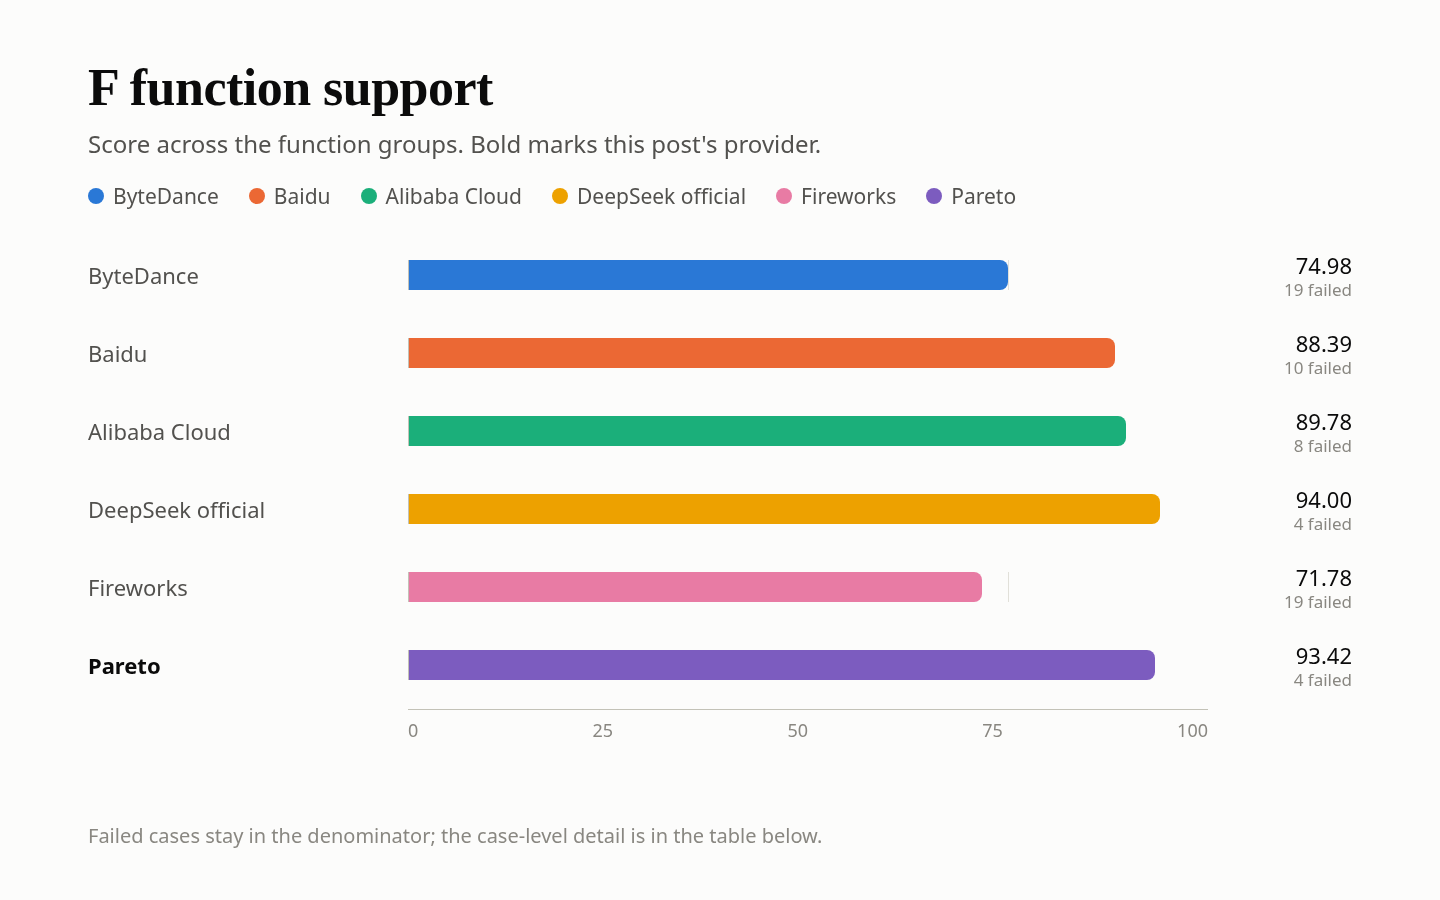
Fett markiert den Anbieter dieses Beitrags. Die Anbieter stehen in einer festen Reihenfolge, nicht in einer Rangfolge. K ist ein Teilwert von P und macht 20% davon aus. Der Gesamtindex ist ein zusammenfassender Wert ohne Konfidenzintervall. DeepSeek Official Channel und Alibaba Cloud unterscheiden sich um 0.37; der Unterschied ist nicht aussagekräftig.
Auf einen Blick
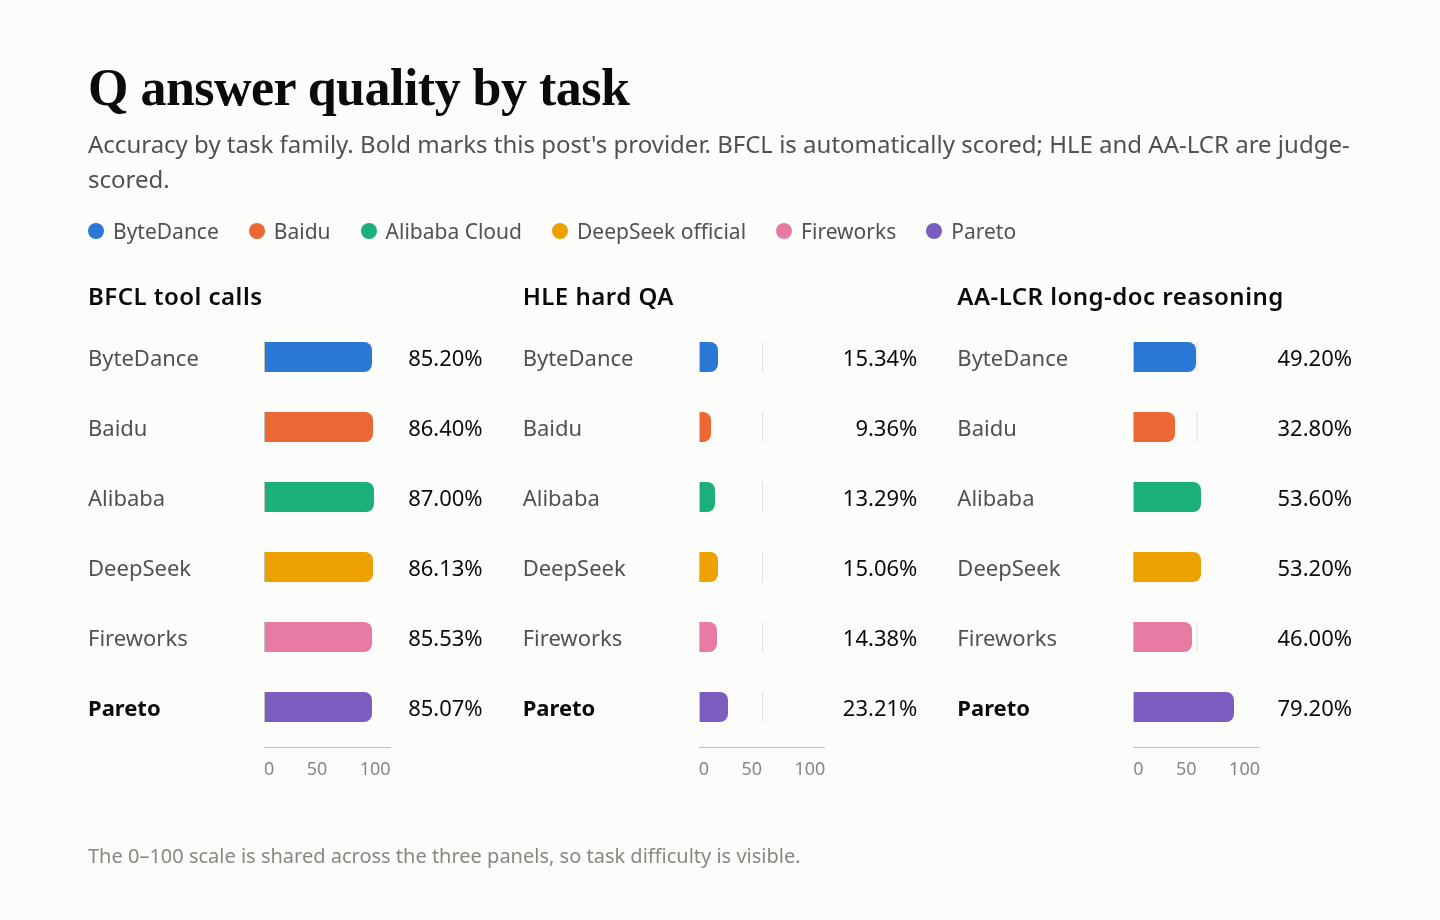
- Q — Antwortqualität: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. Gegenüber dem offiziellen Kanal: +5.94 Prozentpunkte, 95%-KI +3.54 bis +8.36. Bei HLE gab es 996 Servicefehler, die meisten durch Abschneiden, weil das Thinking das Ausgabelängenbudget aufbrauchte; sie zählen als falsch.
- F — Funktionsunterstützung: 93.42. 29 von 33 gewerteten Prüfungen bestanden (Streaming 23/27, Fehler 3/3, Abrechnung 3/3). 147 Prüfungen wurden nicht in die Berechnung einbezogen. Von 4 Fehlern waren 3 leere Antwortkörper bei Anfragen mit Stop-Sequenz; bei 1 Streaming-Text-Testfall stimmte die Antwort nicht exakt mit der Vorlage überein.
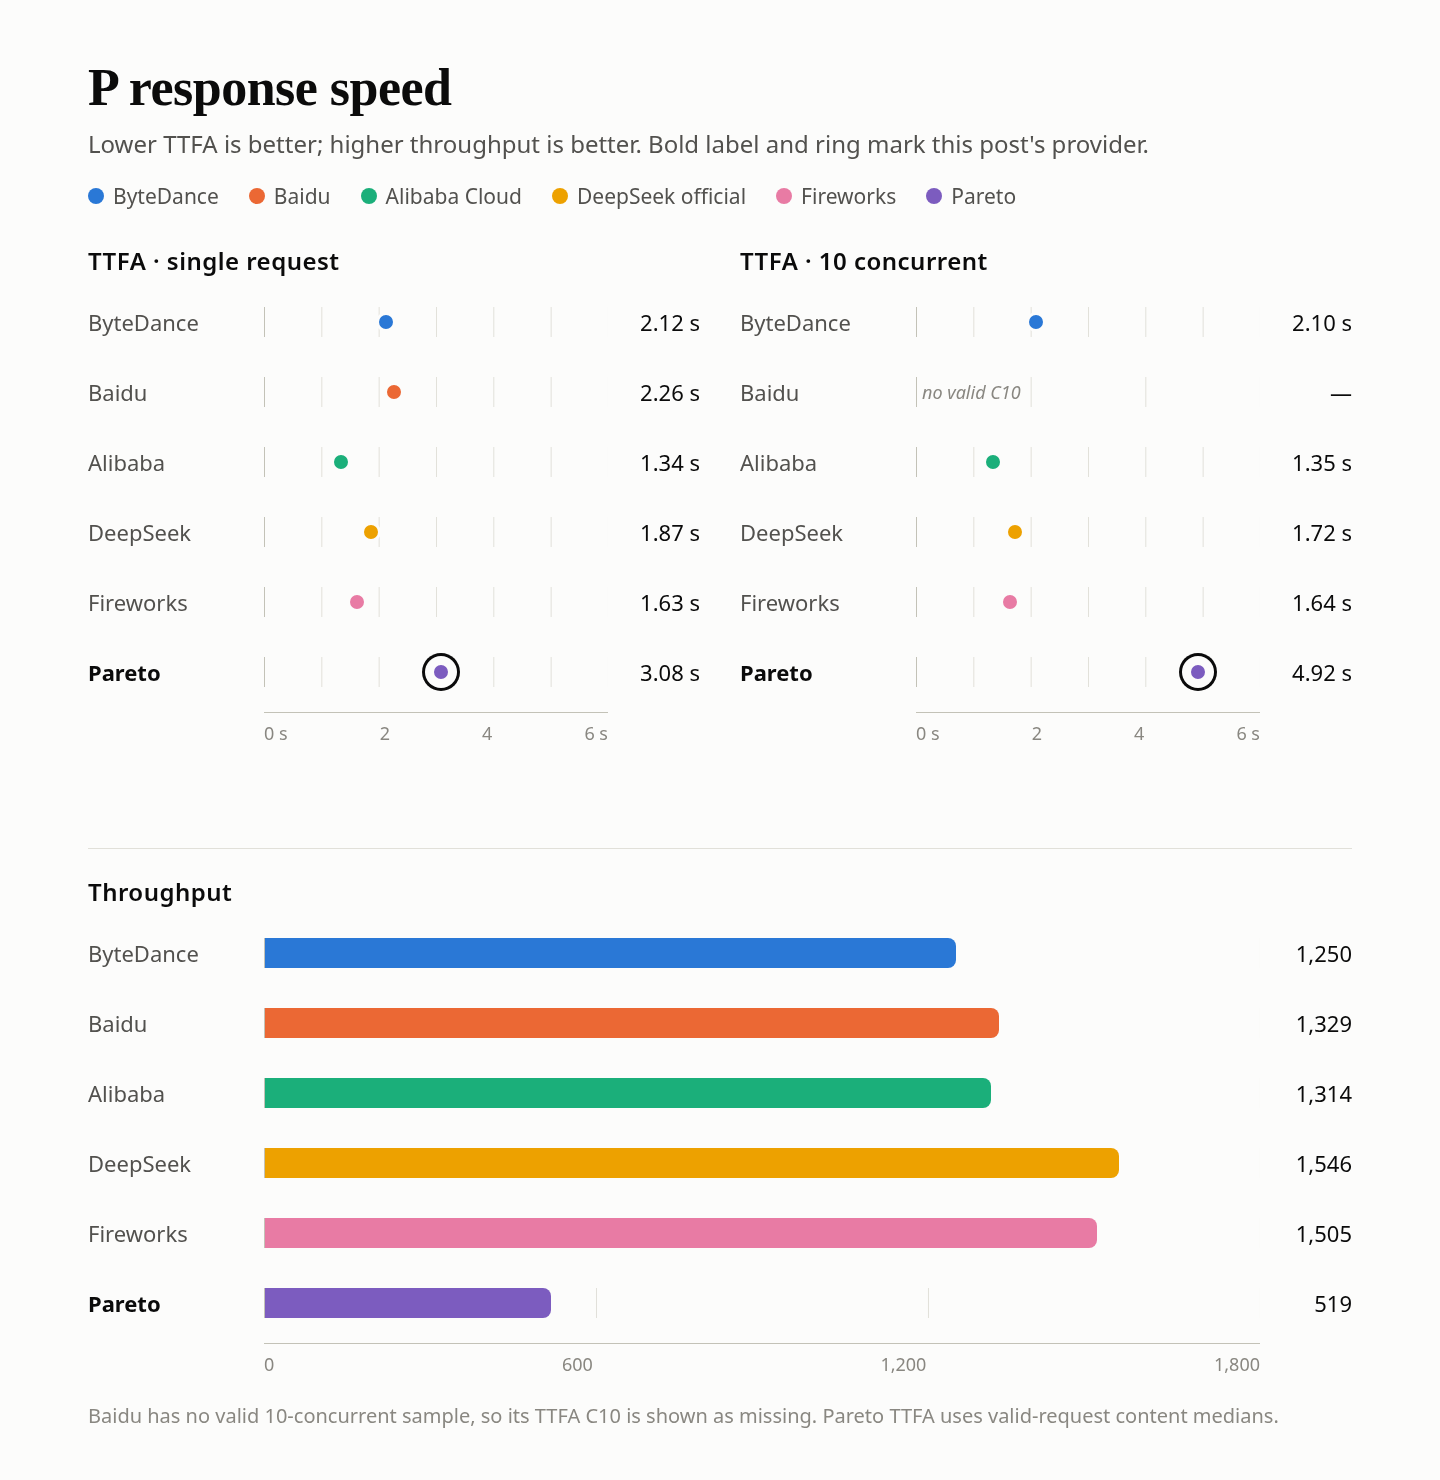
- P — Antwortgeschwindigkeit: 57.69. Antwortwert 65.22, Cache-K bei 20%. TTFA-Mediane gültiger Anfragen: 3.08 s bei Einzel- und 4.92 s bei 10 gleichzeitigen Anfragen; Bewertungsmediane einschließlich ungültiger Anfragen: 5.85 s und 6.13 s. 110 von 180 Tests waren gültig; 70 waren ungültig, weil das Thinking das Ausgabelängenbudget des Geschwindigkeitstests aufbrauchte.
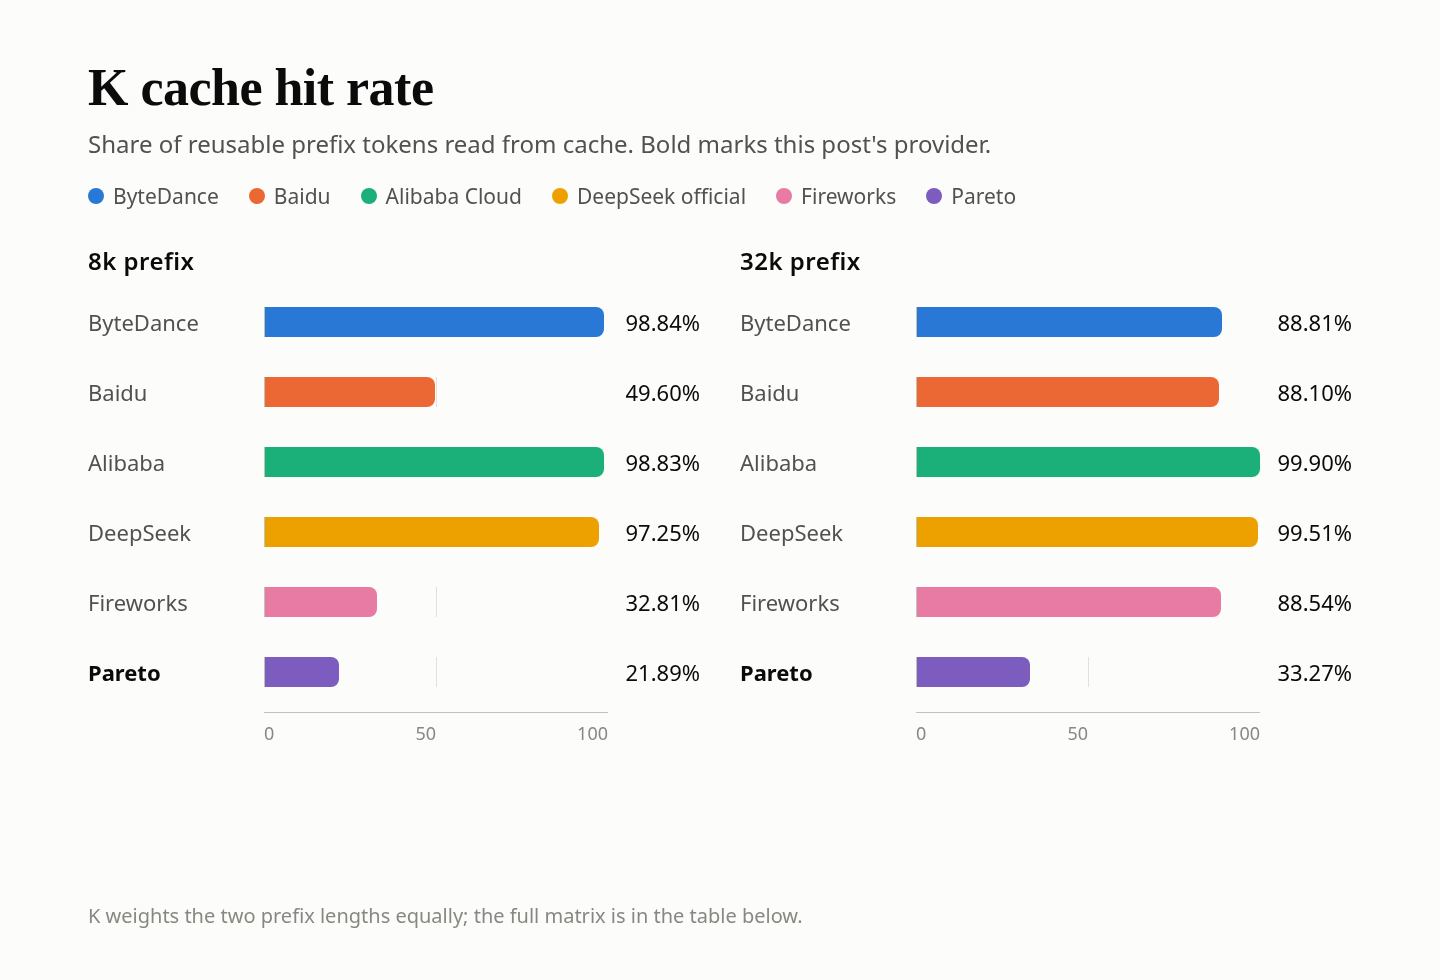
- K — Cache: 27.58. 8k-Hot-Treffer 2/9 (gelesen 15,872 / wiederverwendbar 72,504); 32k-Hot-Treffer 3/9 (gelesen 96,000 / wiederverwendbar 288,513). Bewertet mit der Standardkonfiguration.
- R — Dienststabilität: 100. 300/300 dedizierte Anfragen waren beim ersten Versuch erfolgreich.
Testaufbau
| Element | Einstellung |
|---|---|
| Modell | DeepSeek V4.1 Flash 1017 |
| Angeforderte Modell-ID | deepseek/deepseek-v4.1-flash |
| Zugriffsweg | Pareto, mit der oben genannten Modell-ID |
| Parameter | temperature 1.0, max_tokens 16,384, timeout 300 s; nur Streaming-Anfragen |
| Thinking | Thinking mit hoher Intensität aktiviert |
| Zeit | 2026-11-05/06 UTC+8; Cache ist ein Retest mit der Standardkonfiguration vom 2026-11-06 |
| Stichproben | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Hinweise | Bei diesem Test war Thinking mit hoher Intensität aktiviert; bei den anderen fünf Anbietern der Reihe kam es nicht zum Einsatz. Die Funktionsunterstützung wird anhand der Teilmenge bewertet, für die Streaming verfügbar ist; für den Cache gilt die Standardkonfiguration. |
Für die Anfragen wurde der Schnellstart von AIHubMix verwendet; die Modell-IDs stehen auf der Modellseite.
Q — Antwortqualität: 48.40
Die Suite umfasste 500 BFCL-Fragen × 3 Durchläufe, 250 HLE × 10 und 25 AA-LCR × 10. BFCL wurde automatisch bewertet; HLE und AA-LCR wurden von deepseek-flash beurteilt. Für alle drei Aufgabengruppen kamen dieselben Elemente wie bei den anderen Anbietern zum Einsatz. Zehn nicht bewertbare Antworten wurden entfernt; übrig blieben 4,240 bewertete Fälle.
| Aufgabe | Fragen | Richtig | Genauigkeit | Fehler |
|---|---|---|---|---|
| BFCL-Tool-Aufrufe | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE schwierige Fragen und Antworten | 250 × 10 | 578/2,490 | 23.21% | 996 |
| AA-LCR Schlussfolgern anhand langer Dokumente | 25 × 10 | 198/250 | 79.20% | 0 |
| Gesamt · 95%-KI 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Fehler bleiben als falsch im Nenner: Bei 996 HLE-Versuchen wurde die Ausgabe abgeschnitten, weil das Thinking das Ausgabelängenbudget aufbrauchte. Von den 1,494 HLE-Versuchen mit vollständiger Antwort waren 578 richtig (etwa 38.7%).
| BFCL-Kategorie | Bestanden | Bestehensquote |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python bestand 333/360 (92.50%), multiple 269/300 (89.67%), ahm_multi_turn 102/150 (68.00%) und irrelevance 104/150 (69.33%).
Vergleich mit den anderen fünf
Unterschied in Prozentpunkten gegenüber dem offiziellen Kanal; das 95%-Intervall wird als Fehlerbalken dargestellt. Wenn das Intervall 0 einschließt, ist der Unterschied nicht aussagekräftig. Der Beurteiler deepseek-flash gehört zur selben Modellfamilie und wurde nicht kalibriert, daher könnte er großzügig bewerten.
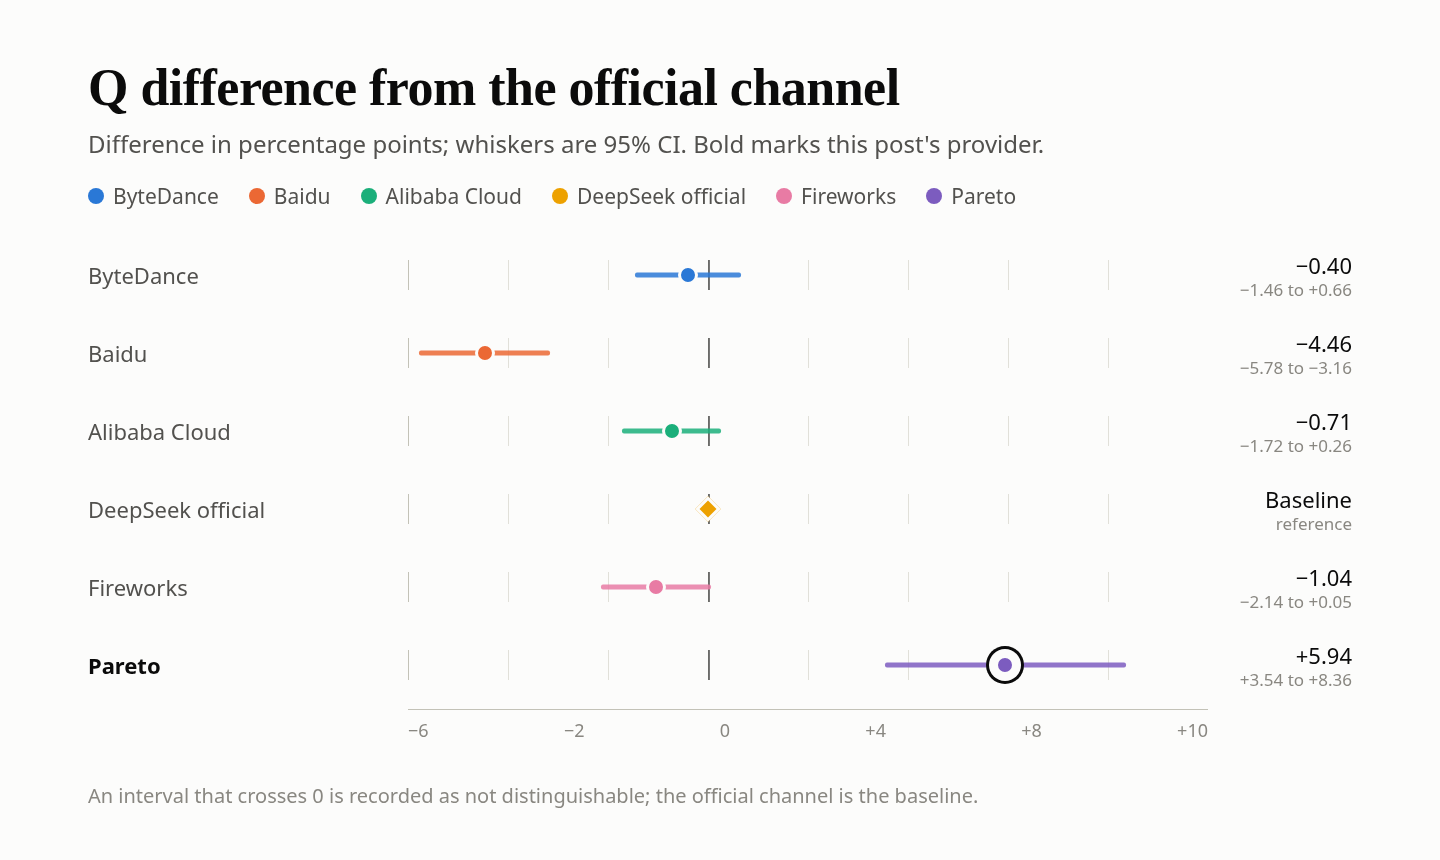
Gegenüber dem offiziellen Kanal beträgt der numerische Unterschied +5.94 (+3.54 bis +8.36).
F — Funktionsunterstützung: 93.42
29 von 33 gewerteten Prüfungen bestanden; 147 wurden nicht einbezogen. Der Wert 93.42 berechnet die ursprünglichen Gruppenanteile für die beobachteten Gruppen neu (Streaming 20%, Fehler 15%, Abrechnung 10%; insgesamt 45%). Die einfache Bestehensquote 29/33 beträgt 87.88%. Tools, Einschränkungen und Kontext wurden überhaupt nicht gewertet.
| Fallgruppe | Gewichtung | Bestanden | Ausgeschlossen | Gruppenwert |
|---|---|---|---|---|
| Streaming und Nachrichten | 20% | 23/27 | 3 | 85.19 |
| Tool-Schnittstelle | 20% | — | 30 | — |
| Ausgabebeschränkungen | 20% | — | 30 | — |
| Kontext und Zustand | 15% | — | 30 | — |
| Fehler und Wiederherstellung | 15% | 3/3 | 27 | 100.00 |
| Abrechnung und Cache | 10% | 3/3 | 27 | 100.00 |
| Beobachtet / gewichtet | — | 29/33 | 147 | 93.42 |
„Fehlgeschlagene Fenster“ zählt die drei Testfenster, in denen der Fall nicht bestanden wurde.
| Fehlgeschlagener Fall | Fehlgeschlagene Fenster | Grund |
|---|---|---|
| Streaming mit Stop-Sequenz | 3/3 | Leerer Antwortkörper bei Stop-Sequenz |
| Streaming-Text | 1/3 | Zusätzlicher Punkt am Ende des Antwortkörpers im Vergleich zur Vorlage |
Vergleich mit den anderen fünf
P — Antwortgeschwindigkeit: 57.69
Bewertet wird die Zeit bis zum ersten Inhaltstoken, nicht bis zum ersten Token beliebiger Art. Bei aktiviertem Thinking gibt das Modell zunächst Thinking-Inhalt aus, bevor sichtbarer Antworttext erscheint. Daher dauert es länger, bis Inhalt eintrifft, als bis das erste Paket ankommt. In jedem der drei Testfenster wurden 30 Anfragen mit Einzelparallelität und 30 mit 10-facher Parallelität gesendet, insgesamt also 180.
| Metrik | Ergebnis |
|---|---|
| TTFA bis zum Inhalt | Bewertungsmediane: 5.85 s (c=1) und 6.13 s (c=10); Mediane für gültige Anfragen: 3.08 s und 4.92 s |
| Erstes Token beliebiger Art | Mediane für gültige Anfragen: 1.46 s und 1.76 s |
| TPOT | Langsameres Bewertungsintervall: 4.87 ms/Token |
| Goodput | 519 Token/s bei 10 gleichzeitigen Anfragen |
| Gültig | 53/90 bei c=1 und 57/90 bei c=10, insgesamt 110/180; 70 ungültig, weil das Thinking das Ausgabelängenbudget des Geschwindigkeitstests (ca. 2,048 Token) aufbrauchte |
| Bestandteile | TTFA 24.59, TPOT 100.00, Goodput 72.05; Antwortwert 65.22 |
| Zusammensetzung von P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Thinking-Token werden nicht in den Goodput-Zähler einbezogen.
K — Cache: 27.58
Zusammengefasste Lesezugriffe aus dem Retest mit der Standardkonfiguration vom 2026-11-06. Einzelne Cache-Matrizen pro Anfrage sind nicht enthalten (die Rohdaten wurden nicht migriert). K gewichtet beide Präfixlängen gleich; K macht 20% von P aus.
| Präfix | Hot-Treffer | Gelesen / wiederverwendbar | Abschnitt |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (gleich gewichtet) | 27.58 |
Alle Cold-Kontrollen bestanden, jeweils 6/6 pro Länge.
R — Dienststabilität: 100
Die 300 Anfragen umfassten kurze Texte, lange Eingaben, Tool-Aufrufe und mehrstufige Dialogverläufe bei Einzelparallelität. Geprüft wurden nur die Gültigkeit und Vollständigkeit der ersten Antwort; die Antworten wurden nicht bewertet und es gab keine Wiederholungsversuche. Fehler bei Q und P werden hier nicht erneut gezählt.
| Anfragetyp | Beim ersten Versuch erfolgreich |
|---|---|
| Kurzer Text | 120/120 |
| 10k lange Eingabe | 90/90 |
| Tool-Aufrufe | 60/60 |
| Mehrstufiger Dialogverlauf | 30/30 |
| Gesamt · 95%-KI 98.78%–100% | 300/300 |
FAQ
Was umfasst Q 48.40?
BFCL, HLE und AA-LCR mit insgesamt 4,240 bewerteten Fällen: 2,052 richtig, 48.40%, 95%-KI 45.39%–51.26%. Gegenüber dem offiziellen Kanal beträgt der numerische Unterschied +5.94 (+3.54 bis +8.36).
Warum gab es bei HLE 996 Servicefehler?
Die meisten Antworten wurden abgeschnitten, weil das Thinking das Ausgabelängenbudget aufbrauchte; sie bleiben als falsch im Nenner.
Warum liegt F bei 93.42, obwohl 147 Prüfungen ausgeschlossen wurden?
Gewertet wird nur die Teilmenge, für die Streaming verfügbar ist. Die Gruppenanteile werden für die beobachteten Gruppen neu berechnet; Tools, Einschränkungen und Kontext werden überhaupt nicht gewertet.
Warum schlugen die Fälle mit Stop-Sequenz fehl?
Anfragen mit einer Stop-Sequenz lieferten in allen drei Testfenstern einen leeren Antwortkörper.
Warum waren 70 von 180 Geschwindigkeitstests ungültig?
Das Thinking brauchte das Ausgabelängenbudget des Geschwindigkeitstests auf (etwa 2,048 Token).
Was umfasst R 100?
300 dedizierte Anfragen, alle beim ersten Versuch gültig; die untere Grenze des 95%-Konfidenzintervalls liegt bei 98.78%. Fehler bei Q und P werden nicht in R mitgezählt.
Weiterlesen: die DeepSeek V4.1 Flash-Reihe
- ByteDance meldete Thinking-Token, obwohl Thinking deaktiviert war: DeepSeek V4.1 Flash auf ByteDance: Tool-Aufrufe stimmen, Abrechnung nicht
- Baidu erzielte Q 38.00 und P 37.77: DeepSeek V4.1 Flash auf Baidu: Kein verfügbarer Kanal erreicht Q und P
- Alibaba Cloud verzeichnete 1.34 s bis zum ersten Token und einen Cache-Wert von 99.37: DeepSeek V4.1 Flash auf Alibaba Cloud: 1.34s bis zum ersten Token, Cache 99.37
- Der offizielle Kanal dient als Q-Baseline und erzielte F 94.00: DeepSeek V4.1 Flash auf dem offiziellen Kanal: F 94.00, 15 ungültige Tests
- Fireworks lieferte leere Antworten bei Stop-Sequenzen und 3/9 Cache-Treffer bei 8k: DeepSeek V4.1 Flash auf Fireworks: leere Antworten bei Stop-Sequenzen, 3/9 Cache-Treffer


