

Im APB-Full-Lauf vom 2026-11-03/04 erzielte Pareto die vier Werte Q 44.58, F 93.42, P 57.69 und R 100, insgesamt 68.72. Bei den 8k-Hot-Requests gab es 2 von 9 Treffern, bei 32k 3 von 9.
Am 2026-11-03/04 wurde DeepSeek V4.1 Flash 1017 über AIHubMix bei sechs Anbietern mit der APB-Full-Suite getestet; für alle kamen dieselben Fragen, Parameter und Request-Skripte zum Einsatz. Dieses APB-Profil befasst sich ausschließlich mit Pareto: Was die einzelnen Abschnitte messen und wie die Ergebnisse ausfielen.
Bei den folgenden Zahlen handelt es sich um Werte, nicht um ein Ranking oder eine Anbieterempfehlung. Zuerst kommen die vier Werte Q, F, P und R; der Gesamtwert ist ein zusammenfassender Index, keine Zertifizierung, und hat kein Konfidenzintervall. Die Bewertungsregeln sind in AIHubMix Provider Benchmark Standard v2.0 definiert.
Werte von sechs Anbietern im Vergleich
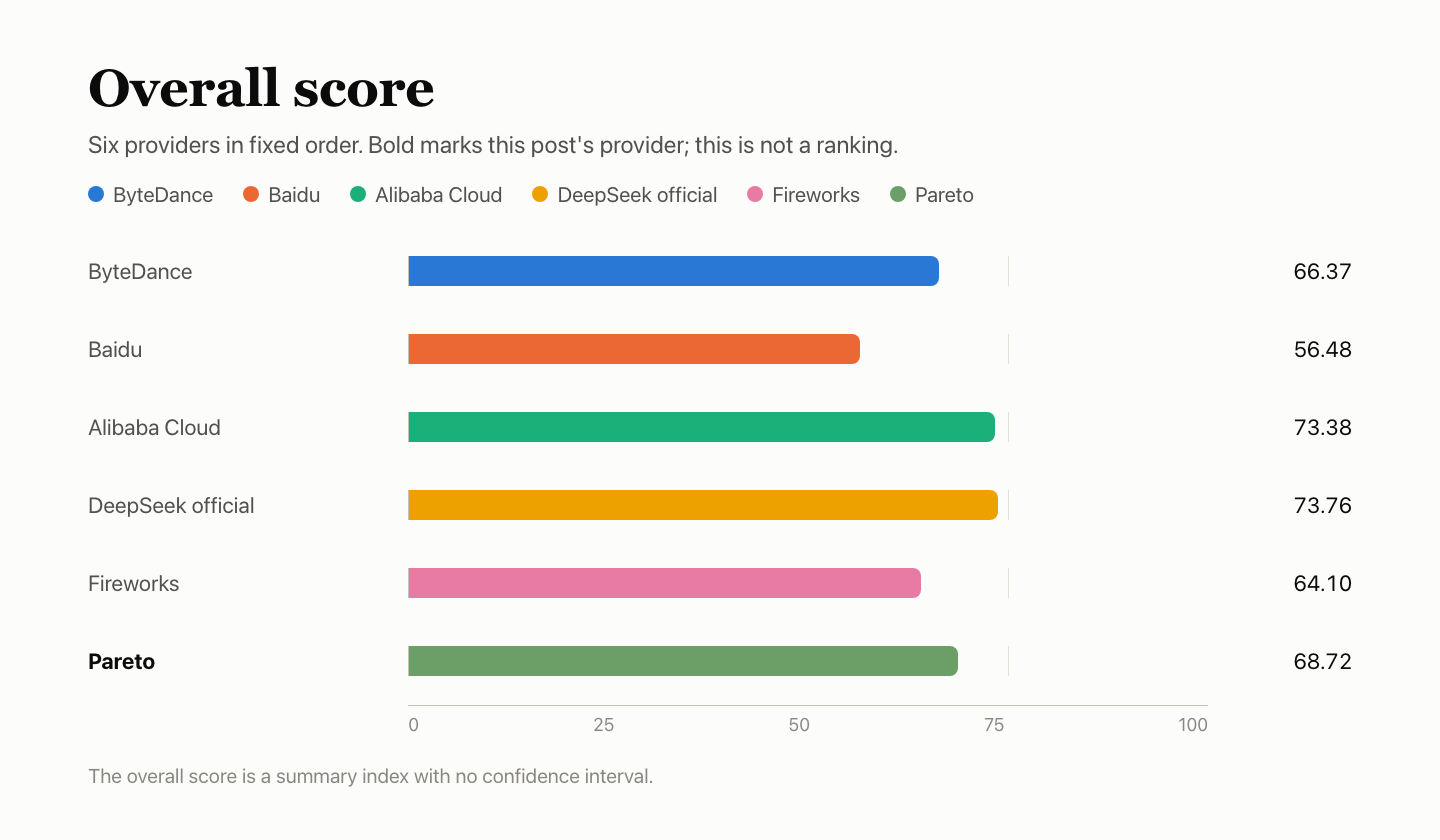
| Anbieter | Q Qualität | F Funktionen | P Geschwindigkeit | K Cache | R Stabilität | Gesamt |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Offizieller DeepSeek-Kanal | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (dieser Beitrag) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Die Anbieter sind in einer festen Reihenfolge aufgeführt, nicht nach Rang. K ist ein Teilwert von P und macht 20% davon aus; zur Orientierung wird K separat aufgeführt. Der Gesamtwert wird anhand der Zusammensetzungsregeln des AIHubMix Provider Benchmark Standard berechnet, die auch den Vergleich mit dem offiziellen Kanal und die Vollständigkeit der Nachweise berücksichtigen; er ist keine direkte Gewichtung der vier Werte in der Tabelle. Es handelt sich um einen zusammenfassenden Index ohne Konfidenzintervall. Der Unterschied beim Gesamtwert zwischen dem offiziellen DeepSeek-Kanal und Alibaba Cloud beträgt lediglich 0.37 und ist nicht unterscheidbar.
Auf einen Blick
- Antwortqualität: Q 44.58, mit BFCL 85.27%, HLE 19.32% und AA-LCR 52.00%. Der Abstand zum offiziellen Kanal beträgt +2.12 Prozentpunkte, bei einem 95%-Intervall von −0.02 bis +4.18: nicht unterscheidbar.
- Funktionsunterstützung: F 93.42; 29/33 der ursprünglich gewerteten Prüfungen bestanden. Für Tool-Aufrufe und den Roundtrip mit Tool-Ergebnissen, parallele und benannte Aufrufe, den JSON-Modus sowie den Gesprächsverlauf gibt es zusätzlich erfolgreiche Streaming-Aufzeichnungen; die Werte behalten ihre ursprüngliche Höhe.
- Antwortgeschwindigkeit: P 57.69. Median bis zum ersten Body-Token: 5.85 s bei einzelner Parallelität und 6.13 s bei 10-facher Parallelität; TPOT 4.63 ms. 110 von 180 Geschwindigkeits-Requests waren gültig.
- Cache: K 27.58. Bei den 8k-Hot-Requests gab es 2 von 9 Treffern, bei den 32k-Hot-Requests 3 von 9; keine Cold-Control-Anfrage las aus dem Cache.
- Servicestabilität: R 100. Alle 300 dedizierten Requests waren beim ersten Versuch erfolgreich.
Testaufbau
| Element | Details |
|---|---|
| Modell | DeepSeek V4.1 Flash 1017 |
| Angeforderte Modell-ID | deepseek/deepseek-v4.1-flash |
| Zurückgegebener Modellname | deepseek/deepseek-v4.1-flash |
| Zugriffsweg | Über AIHubMix mit einer anbieterspezifischen Modell-ID, keine direkte Verbindung zum Konto des Anbieters |
| Parameter | Festes APB-v2-Request-Profil, temperature 1.0, max_tokens 16,384, Timeout 300 s, keine automatischen Wiederholungen |
| Zeitraum | 2026-11-03 18:07 – 11-04 16:33; Cache-Requests 11-05 19:31 – 11-06 10:35; alles UTC+8. Alle sechs Anbieter nutzten denselben Mac mini, dasselbe Netzwerk und dasselbe Konto. |
| Stichproben | Q 4,250 Frage-Instanzen; F 180 Prüfungen; P 180 Requests; R 300; K 30 |
Die Requests nutzten den AIHubMix-Schnellstart-Zugriffsweg mit einer anbieterspezifischen Modell-ID; die IDs der anderen Anbieter sind auf der Modellseite aufgeführt. Die Parameter des Modells selbst sind in der API-Dokumentation von DeepSeek beschrieben.
Q — Antwortqualität: 44.58
Die Antwortqualität stützt sich auf drei Testsuiten: 500 BFCL-Fragen, jeweils 3-mal beantwortet, 250 HLE-Fragen, jeweils 10-mal beantwortet, und 25 AA-LCR-Fragen, jeweils 10-mal beantwortet. BFCL wird anhand automatischer Regeln bewertet; bei HLE und AA-LCR beurteilt das Richtermodell deepseek-flash die Antworten als richtig oder falsch. Alle sechs Anbieter erhielten dieselben Fragen; die Ergebnisse der drei Testsuiten werden zu einer gemeinsamen Genauigkeit zusammengeführt. Zehn Antworten wurden ausgeschlossen, weil die Frage nicht bewertet werden konnte. Somit blieben 4,240 gewertete Frage-Instanzen.
| Testsuite | Fragen × Durchläufe | Richtig | Genauigkeit | Servicefehler |
|---|---|---|---|---|
| BFCL-Tool-Aufrufe, automatisch bewertet | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE, schwierige QA, durch Richtermodell bewertet | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR, Schlussfolgern über lange Dokumente, durch Richtermodell bewertet | 25 × 10 | 130/250 | 52.00% | 0 |
| Gesamt · 95%-Intervall 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Auf jede Frage-Instanz wurde vollständig geantwortet; es gab keine Servicefehler.
| BFCL-Kategorie | Bestanden | Erfolgsquote |
|---|---|---|
| simple_python: eine Funktion, richtiger Aufruf und richtige Argumente | 333/360 | 92.50% |
| multiple: die richtige aus mehreren Funktionen auswählen | 269/300 | 89.67% |
| parallel: eine Funktion mehrmals gleichzeitig aufrufen | 265/300 | 88.33% |
| parallel_multiple: mehrere Funktionen gleichzeitig aufrufen | 203/240 | 84.58% |
| irrelevance: keine relevante Funktion, daher kein Aufruf | 109/150 | 72.67% |
| ahm_multi_turn: dreistufige Tool-Kette | 100/150 | 66.67% |
Jede BFCL-Frage wurde 3-mal beantwortet; die Tabelle summiert die 3 Durchläufe.
Vergleich mit den anderen fünf
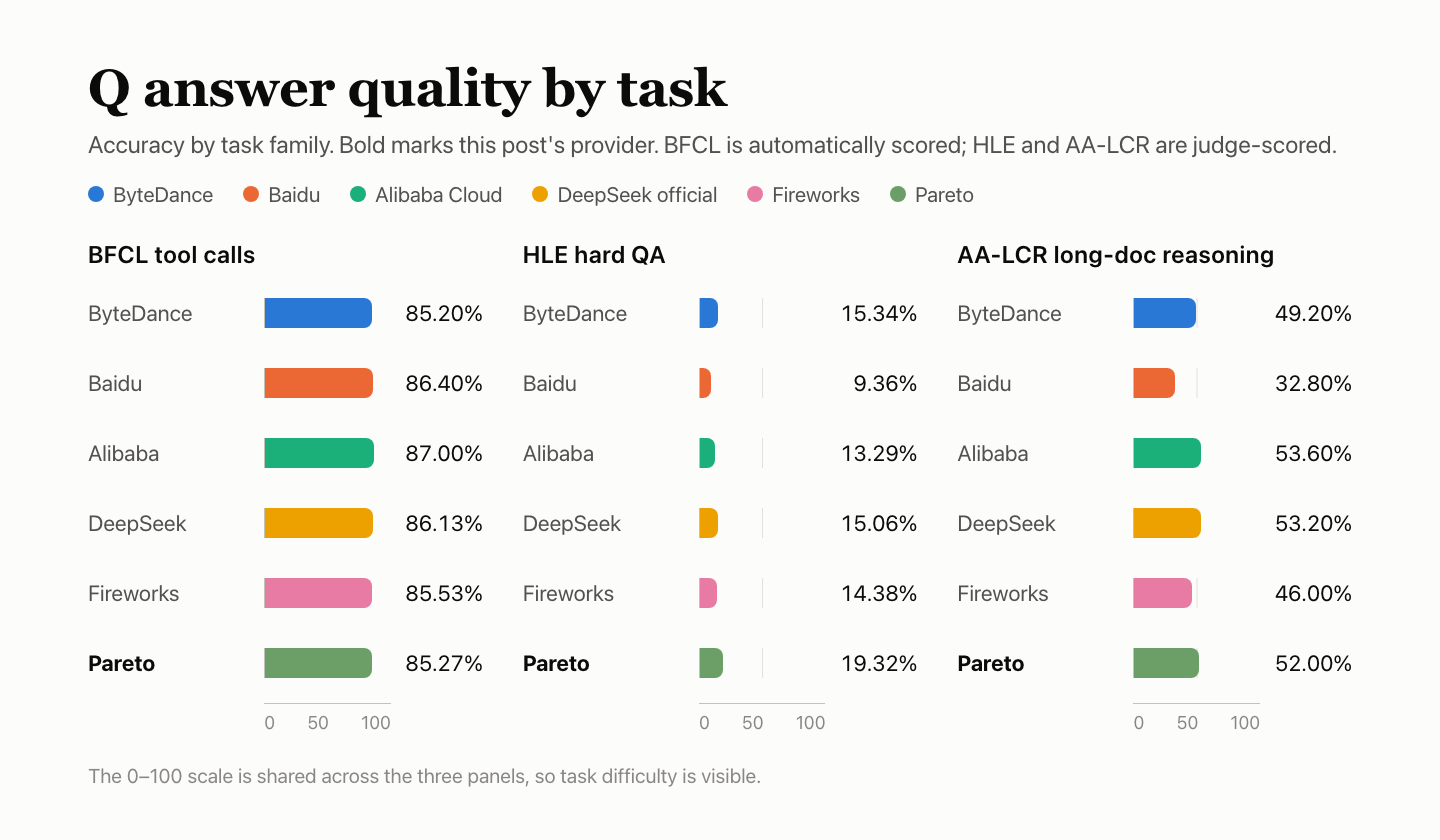
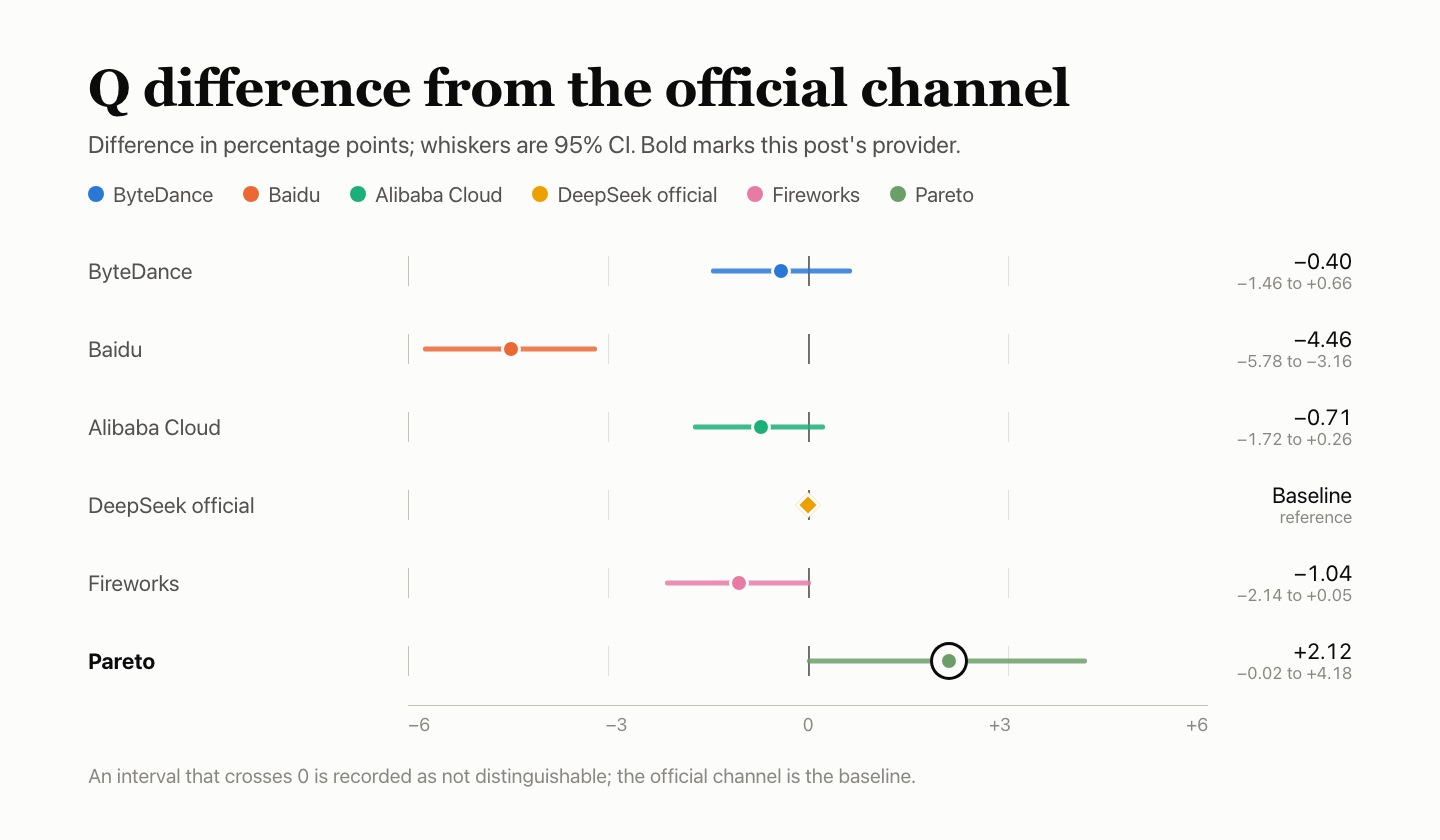
| Anbieter | BFCL | HLE | AA-LCR | Kombiniert | Im Vergleich zum offiziellen Kanal |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 bis +0.66), nicht unterscheidbar |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 bis −3.16), schlechter als der offizielle Kanal |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 bis +0.26), nicht unterscheidbar |
| Offizieller DeepSeek-Kanal | 86.13% | 15.06% | 53.20% | 42.45% | Baseline |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 bis +0.05), nicht unterscheidbar |
| Pareto (dieser Beitrag) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 bis +4.18), nicht unterscheidbar |
Im Vergleich zum offiziellen Kanal: Genauigkeitsunterschied in Prozentpunkten, mit dem 95%-Intervall in Klammern; überschreitet das Intervall 0, wird das Ergebnis als nicht unterscheidbar eingestuft. Der HLE- und AA-LCR-Richter deepseek-flash gehört zur selben DeepSeek-Familie wie das getestete Modell und wurde nicht kalibriert; seine Bewertungen könnten daher großzügig ausfallen.
F — Funktionsunterstützung: 93.42
Die Funktionsprüfungen testen, ob sich die Schnittstelle protokollkonform verhält. F 93.42 ergibt sich aus den 33 gewerteten Prüfungen (29 bestanden), nachdem die beobachteten Gruppengewichte neu normiert wurden; die übrigen 147 geplanten Prüfplätze der ursprünglichen Testsuite flossen nicht in die Bewertung ein.
| Prüfgruppe | Gewichtung | Bestanden / Streaming-Beobachtungen | Ausgeschlossen | Gruppenwert |
|---|---|---|---|---|
| Streaming- und Nachrichtenprotokoll | 20% | 23/27 | 3 | 85.19 |
| Tool-Schnittstelle Tool-Aufrufe, Roundtrip mit Tool-Ergebnissen, parallele und benannte Aufrufe | 20% | Erfolgreiche Streaming-Durchläufe beobachtet* | 30 | — |
| Ausgabebeschränkungen und Parameter JSON-Modus und deaktiviertes Denken | 20% | Erfolgreiche Streaming-Durchläufe beobachtet* | 30 | — |
| Kontext und Status Gesprächsverlauf und Systemanweisungen | 15% | Erfolgreiche Streaming-Durchläufe beobachtet* | 30 | — |
| Fehler und Wiederherstellung | 15% | 3/3 | 27 | 100.00 |
| Abrechnungs- und Cache-Protokoll | 10% | 3/3 | 27 | 100.00 |
| Gesamt · gewichteter Wert | 29/33 | 147 | 93.42 | |
- Für die aufgeführten Funktionen liegen erfolgreiche Streaming-Aufzeichnungen vor; das bedeutet nicht, dass die gesamte Gruppe die volle Punktzahl erhält. Der Bewertung werden keine Prüfungen hinzugefügt. F 93.42 und der Gesamtwert 68.72 behalten ihre ursprünglichen Werte.
| Nicht bestandene Prüfung | Fenster | Grund |
|---|---|---|
| Streaming-Stoppsequenz Streaming- und Nachrichtenprotokoll | 3/3 | Leerer Body mit Stoppsequenz; dieselbe Eingabe ohne Stoppsequenz funktionierte |
| Exakte Textausgabe Streaming- und Nachrichtenprotokoll | 1/3 | Ein zusätzlicher Punkt am Ende verhinderte eine exakte Textübereinstimmung |
„Fenster“ bezeichnet, in wie vielen der 3 Fenster die Prüfung nicht bestanden wurde.
Bei mehreren Anbietern gaben die Prüfungen für fehlerhafte Nachrichten und fehlerhafte Streaming-Optionen den Status 400 mit leerem Antwort-Body zurück. Die Abrechnung von Reasoning-Tokens unterschied sich je nach Anbieter.
Vergleich mit den anderen fünf
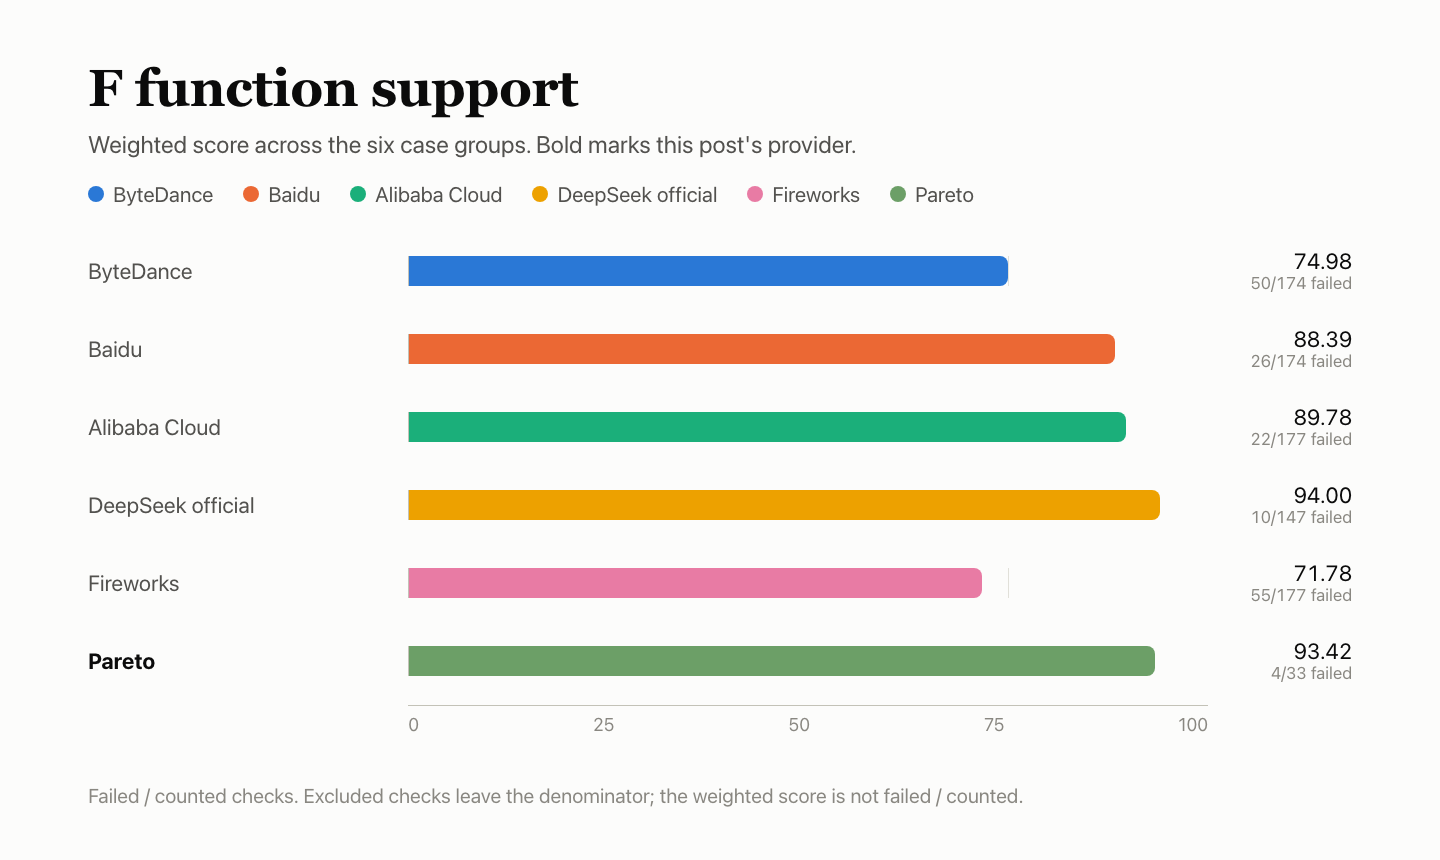
| Anbieter | Bestanden | Nicht bestanden | Ausgeschlossen | Gewichteter Wert |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Offizieller DeepSeek-Kanal | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (dieser Beitrag) | 29 | 4 | 147 | 93.42 |
P — Antwortgeschwindigkeit: 57.69
Jeder Request enthielt etwa 10,000 Eingabe-Token und forderte etwa 1,100 Ausgabe-Token im Body-Text an. In jedem der drei Zeitfenster liefen 30 Requests mit einfacher und 30 mit 10-facher Parallelität: insgesamt 180 Requests.
| Element | Details |
|---|---|
| Erstes Body-Token (TTFA) | Median: 5.85 s bei einfacher Parallelität (nur gültige Requests: 3.08 s), 6.13 s bei 10-facher Parallelität (nur gültige Requests: 4.92 s) |
| Generierungsgeschwindigkeit (TPOT) | 4.42 ms/Token bei einfacher Parallelität, 4.63 ms/Token bei 10-facher Parallelität |
| Effektiver Durchsatz | 519.4 Token/s bei 10-facher Parallelität |
| Gültige Requests | 53/90 bei einfacher Parallelität (Fenster 1–3: 15/30, 18/30, 20/30), 57/90 bei 10-facher Parallelität (23/30, 16/30, 18/30); ungültig: 70 gaben 200 mit None zurück |
| Teilwerte | TTFA 24.59, TPOT 100.00, Durchsatz 72.05; TTFA und TPOT erhalten die niedrigere Stufe, Gewichtung 35% / 35% / 30%: Antwortwert 65.22 |
| P-Wert | Antwortwert 65.22 × 80% + Cache K 27.58 × 20% = 57.69 |
Ungültige Requests werden als unendlich langsam gewertet, daher können die Mediane in der Tabelle höher sein als die Mediane nur gültiger Requests. TPOT wird anhand der gestreamten Chunks geschätzt und nicht pro Token auf der Hardware gemessen. Der Durchsatz entspricht den gültigen Ausgabe-Token bei 10-facher Parallelität geteilt durch die Wandzeit des Batches.
Vergleich mit den anderen fünf
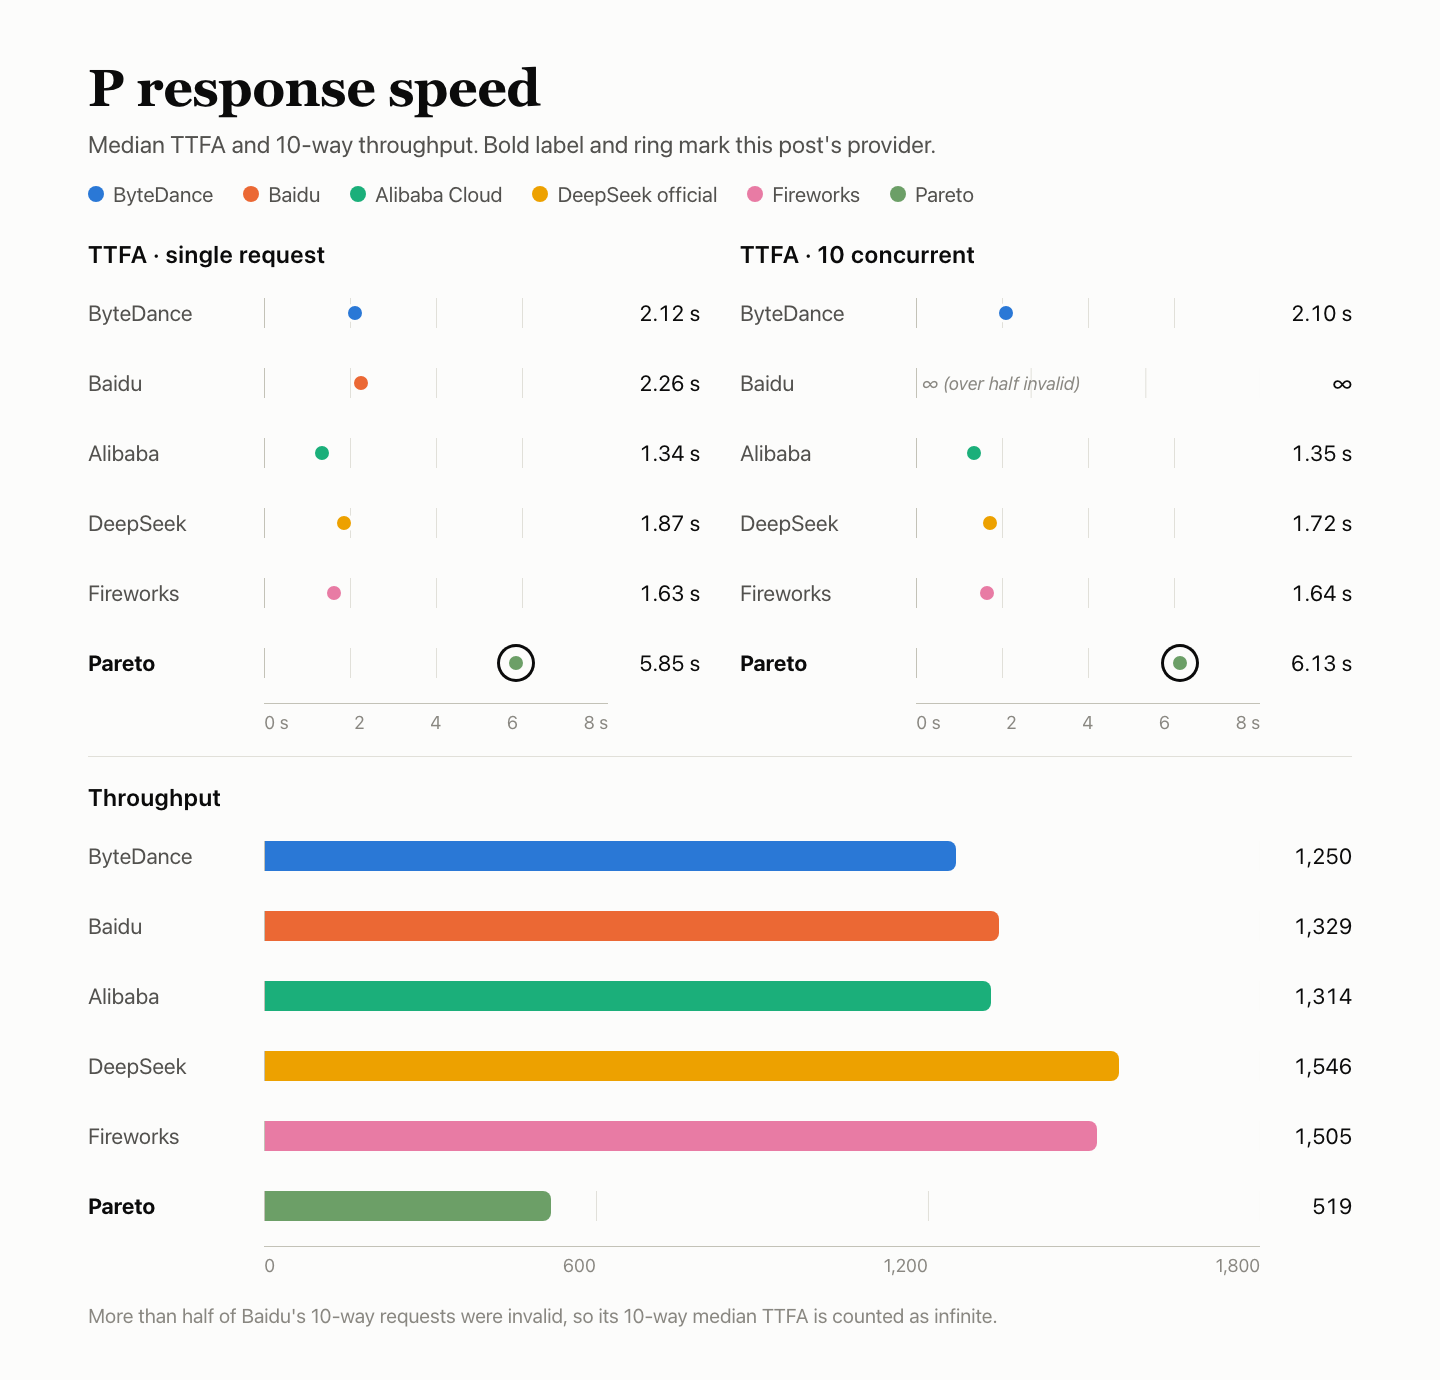
| Anbieter | Gültige Requests | TTFA, einfache Parallelität | TTFA, 10-fache Parallelität | TPOT (langsamer) | Durchsatz tok/s | Antwort |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Offizieller DeepSeek-Kanal | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (dieser Beitrag) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Alle sechs liefen auf derselben Maschine, demselben Netzwerk und demselben Konto. Die drei Zeitfenster wurden Anbieter für Anbieter geplant und überschneiden sich daher nicht vollständig; kleine Unterschiede sollten nicht überinterpretiert werden. ∞ bedeutet, dass mehr als die Hälfte der Anfragen ungültig war, weshalb der Median als unendlich gilt.
K – Cache: 27.58
Jede Gruppe sendet fünf Anfragen. Die erste enthält einen festen Präfix von etwa 8k oder 32k Tokens und befüllt den Cache. Bei den Anfragen 2–4 bleibt der Präfix gleich; nur die abschließende Frage ändert sich. Die Abstände betragen 5 s, 30 s und 120 s. Die fünfte Anfrage verwendet als Kontrolle mit kaltem Cache einen neuen Präfix. Drei Zeitfenster × zwei Längen ergeben 30 Anfragen. K entspricht den von den Hot-Anfragen gelesenen Cache-Tokens geteilt durch die Tokens, die nach den Regeln wiederverwendet werden sollten; beide Längen werden gleich gewichtet. K macht 20% von P aus.
| Zeitfenster | 1 · Seed | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · kalt |
|---|---|---|---|---|---|
| 8k-Präfix · Hot-Treffer 2/9 · 15,872 von 72,504 wiederverwendbaren Tokens gelesen · 21.89 | — | — | — | — | — |
| Zeitfenster 1 | 0 | 0 | 7,936 | 0 | 0 |
| Zeitfenster 2 | 0 | 0 | 0 | 0 | 0 |
| Zeitfenster 3 | 0 | 0 | 7,936 | 0 | 0 |
| 32k-Präfix · Hot-Treffer 3/9 · 96,000 von 288,513 wiederverwendbaren Tokens gelesen · 33.27 | — | — | — | — | — |
| Zeitfenster 1 | 0 | 0 | 32,000 | 0 | 0 |
| Zeitfenster 2 | 0 | 0 | 0 | 0 | 0 |
| Zeitfenster 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k und 32k gleich gewichtet) | — | — | — | — | 27.58 |
Die Werte geben die vom Server gemeldeten Cache-Lese-Tokens an; „Nicht zurückgegeben“ bedeutet, dass das Feld in der Antwort fehlte.
Bei den 8k-Hot-Anfragen gab es 2 Treffer von 9; bei jedem Treffer wurden 7,936 Tokens gelesen. Bei den 32k-Hot-Anfragen gab es 3 Treffer von 9; bei jedem Treffer wurden 32,000 Tokens gelesen. Kalte Anfragen lasen nichts aus dem Cache, sodass sich Hot- und Cold-Anfragen klar unterscheiden.
Vergleich mit den anderen fünf
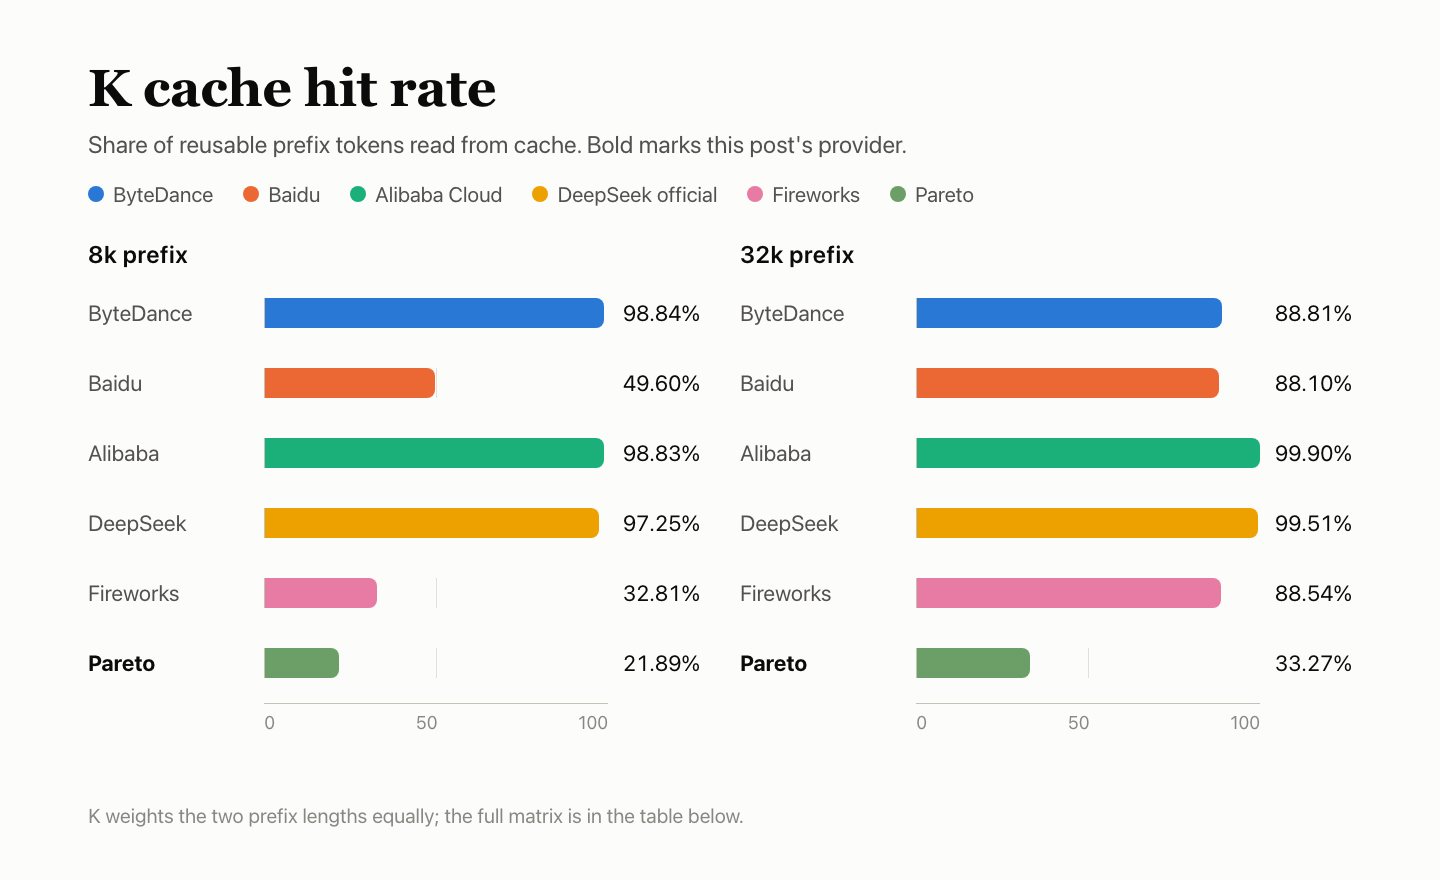
| Anbieter | 8k-Treffer | 8k | 32k-Treffer | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Offizieller DeepSeek-Kanal | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (dieser Beitrag) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R – Dienststabilität: 100
Die 300 Anfragen entfallen auf vier Typen: kurze Texte, lange Eingaben, Tool-Aufrufe und mehrstufige Verläufe. Sie wurden in drei Zeitfenstern mit paralleler Verarbeitung von jeweils einer Anfrage ausgeführt. Geprüft wird nur, ob der erste Versuch eine gültige, vollständige Antwort lieferte; die Antworten werden nicht bewertet und es gibt keine Wiederholungsversuche. Fehler in den Abschnitten zu Antwortqualität und Geschwindigkeit fließen in Q und P ein und werden bei R nicht erneut gezählt.
| Anfragetyp | Erfolg beim ersten Versuch |
|---|---|
| Kurzer Text | 120/120 |
| Lange Eingabe mit 10k | 90/90 |
| Tool-Aufrufe | 60/60 |
| Mehrstufiger Verlauf | 30/30 |
| Gesamt · 95%-Intervall 98.78%–100% | 300/300 |
Alle 300 Anfragen lieferten beim ersten Versuch eine gültige, vollständige Antwort. R = 100 bezieht sich nur auf diese 300 gezielten Anfragen; das bedeutet nicht, dass die gesamte Kette fehlerfrei war. Die Untergrenze des 95%-Intervalls liegt bei 98.78%: 300 Erfolge bei 300 Anfragen erlauben lediglich die Aussage, dass die Fehlerquote wahrscheinlich unter 1.22% liegt.
Vergleich mit den anderen fünf
| Anbieter | Erfolg beim ersten Versuch | 95%-Intervall |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Offizieller DeepSeek-Kanal | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (dieser Beitrag) | 300/300 | 98.78%–100% |
R umfasst nur diese 300 gezielten Anfragen; Fehler in den Abschnitten zu Antwortqualität und Geschwindigkeit werden unter Q und P erfasst und bei R nicht erneut gezählt.
FAQ
Warum liegt F bei 93.42, obwohl nur 33 Prüfungen gezählt wurden?
Die ursprünglich gezählten Prüfungen bestanden 29 von 33 Tests; nach Neugewichtung der beobachteten Gruppengewichte ergibt sich F 93.42. Die übrigen 147 geplanten Prüfplätze wurden von der Bewertung ausgeschlossen. Die Streaming-Aufzeichnungen beschreiben konkrete funktionierende Funktionen und fügen keine bewerteten Prüfungen hinzu. Der angezeigte Gesamtwert bleibt 68.72.
Warum liegt P bei 57.69, obwohl TPOT mit 100.00 bewertet wurde?
Nur 110 von 180 Geschwindigkeitsanfragen waren gültig; 70 lieferten den Status 200 mit None. Ungültige Anfragen zählen als unendlich, daher beträgt der Median bis zum ersten Body-Token 5.85 s bei Einzelanfragen und 6.13 s bei 10 gleichzeitigen Anfragen (nur gültige Anfragen: 3.08 s und 4.92 s). TTFA wurde mit 24.59 und der Durchsatz mit 72.05 bewertet, was einen Antwortwert von 65.22 ergibt. Mit dem Cache-Wert K von 27.58, der mit 20% gewichtet wird, liegt P bei 57.69.
Warum liegt K nur bei 27.58?
Bei den Hot-Anfragen gab es bei 8k 2 Treffer von 9 (21.89) und bei 32k 3 Treffer von 9 (33.27); beide Längen werden gleich gewichtet. Bei einem Treffer wurden 7,936 beziehungsweise 32,000 Tokens gelesen, und keine kalte Kontrollanfrage las aus dem Cache.
Ist die Antwortqualität von Pareto höher als die des offiziellen Kanals?
Nicht eindeutig. Die kombinierte Genauigkeit beträgt 44.58% gegenüber 42.45%, ein Abstand von +2.12 Punkten. Das 95%-Intervall reicht jedoch von −0.02 bis +4.18 und umfasst 0. Der HLE- und AA-LCR-Judge deepseek-flash wurde nicht kalibriert und könnte großzügig bewerten.
Welche F-Prüfungen sind fehlgeschlagen?
Zwei. Die Streaming-Stoppsequenz lieferte in allen drei Zeitfenstern einen leeren Body, während dieselbe Eingabe ohne Stopp funktionierte. Bei der exakten Textausgabe stand in einem von drei Zeitfenstern ein zusätzlicher Punkt am Ende.
Weiterlesen: die DeepSeek V4.1 Flash-Reihe
- Paretos Q-Abstand von +2.12 wird gegenüber dem offiziellen Kanal gemessen; der eigene Test des Baseline-Anbieters ist in Testbericht zu DeepSeek V4.1 Flash beim offiziellen DeepSeek-Kanal: Vergleichs-Baseline, 15 ungültige Anfragen bei Einzelverarbeitung zu finden.
- Auch Fireworks lieferte bei Stopp-Anfragen leere Bodys und erzielte bei 8k 3 Treffer von 9: Testbericht zu DeepSeek V4.1 Flash bei Fireworks: Stopp-Anfragen liefern leere Bodys, 3 von 9 Hot-Anfragen mit 8k-Cache treffen.
- Bei Alibaba Cloud trafen 18 von 18 Hot-Anfragen den Cache, bei Pareto waren es 5 von 18: Testbericht zu DeepSeek V4.1 Flash bei Alibaba Cloud: 1.34 s bis zum ersten Body-Token, alle 18 Hot-Anfragen treffen den Cache, Antworten nicht vom offiziellen Kanal zu unterscheiden.
- Alle Geschwindigkeitsanfragen bei ByteDance waren gültig; bis zum ersten Body-Token vergingen 2.12 s: Testbericht zu DeepSeek V4.1 Flash bei ByteDance: Antworten nicht vom offiziellen Kanal zu unterscheiden, Eingabeanzahlen stimmen nicht überein.
- Auch bei Baidu gingen viele Geschwindigkeitsanfragen wegen no_available_channel verloren: Testbericht zu DeepSeek V4.1 Flash bei Baidu: Tool-Aufrufe auf Augenhöhe mit dem offiziellen Kanal, häufiges no-available-channel senkt Antwortqualität und Geschwindigkeit.
Quellen
- Modellseite zu DeepSeek V4.1 Flash 1017 (AIHubMix)
- AIHubMix Provider Benchmark Standard v2.0 (AIHubMix-Dokumentation)
- Schnellstart (AIHubMix-Dokumentation)
- Modelle (AIHubMix)
- DeepSeek-API-Dokumentation (DeepSeek)


