

На 2026-11-03/04 пакетът APB Full беше изпълнен с DeepSeek V4.1 Flash 1017 при пет доставчика чрез AIHubMix. При всички доставчици бяха използвани едни и същи въпроси, параметри и скриптове за заявки; петте доставчика са посочени на страницата с модели. Този APB Profile обхваща само официалния канал на DeepSeek. Той се достига чрез маршрута на AIHubMix към официалния доставчик на DeepSeek, а не чрез директна връзка с API на DeepSeek.
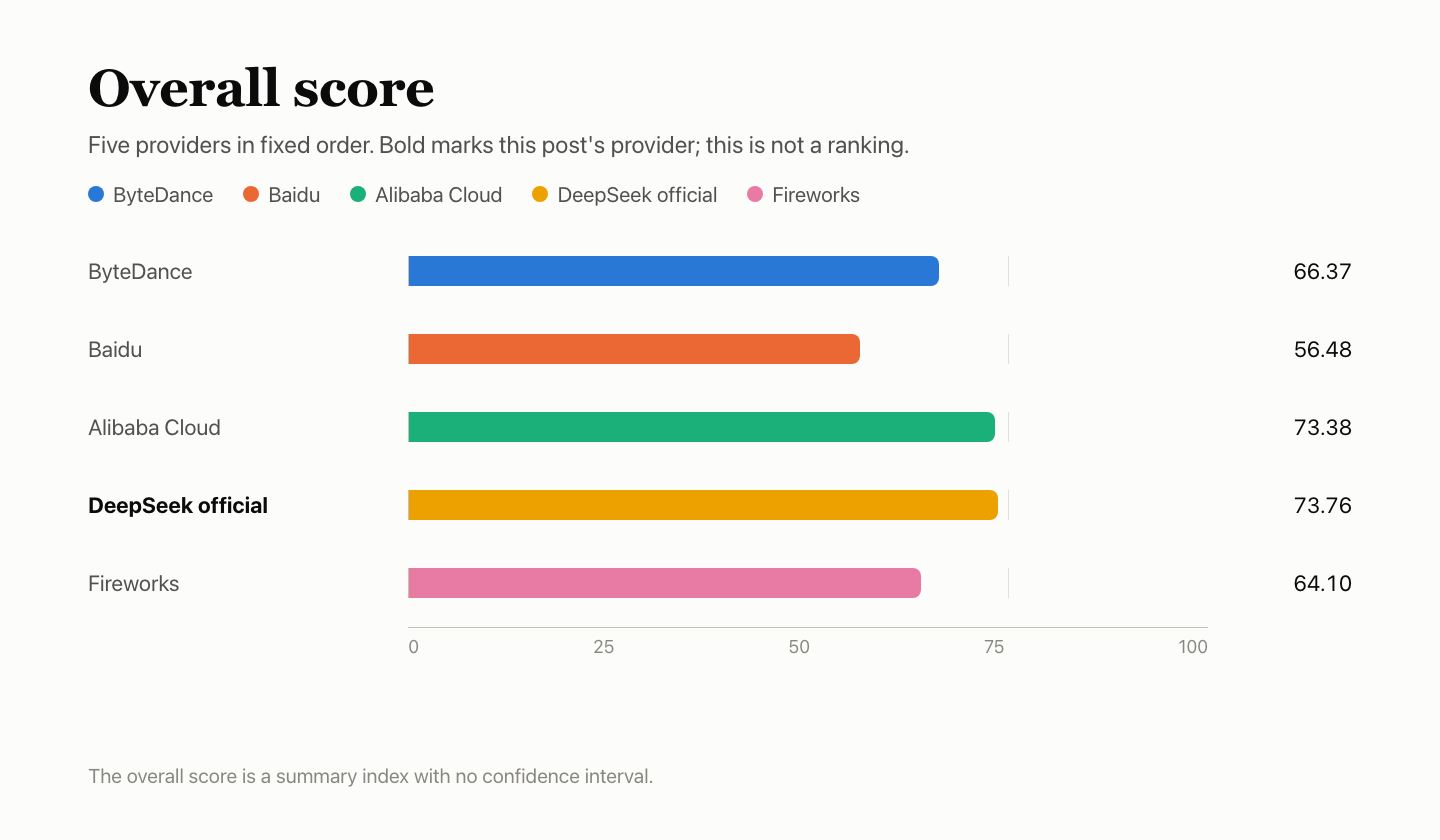
Тази публикация представя само резултати, без класиране на доставчиците или препоръка за някой от тях: Q 42.45, F 94.00, P 86.14, K 98.38 и R 100. Q, F, P и R са резултатите за четирите раздела; K е подрезултат на P. Общият резултат 73.76 е обобщаващ индекс, а не сертификат, и няма доверителен интервал. Стандартът за оценяване е AIHubMix Provider Benchmark Standard v2.0.
Резултати при пет доставчика
С удебелен шрифт е отбелязан доставчикът в тази публикация. Фиксиран ред на доставчиците, а не класиране. K е подрезултат на P с тегло 20% и е показан отделно за справка. Общият резултат е обобщаващ индекс без доверителен интервал. Официалният канал на DeepSeek и Alibaba Cloud се различават с 0.37 по общ резултат и не могат да бъдат разграничени.
Накратко
- Качество на отговорите: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Седем изхода от HLE бяха отрязани при достигане на лимита max_tokens и отчетени като грешни. Този канал е базовият резултат по Q за останалите четири.
- Поддръжка на функции: F 94.00. От 147 отчетени проверки 137 преминаха успешно. Още 27 проверки, зависещи от точния брой токени, бяха обявени за невалидни и изключени от знаменателя.
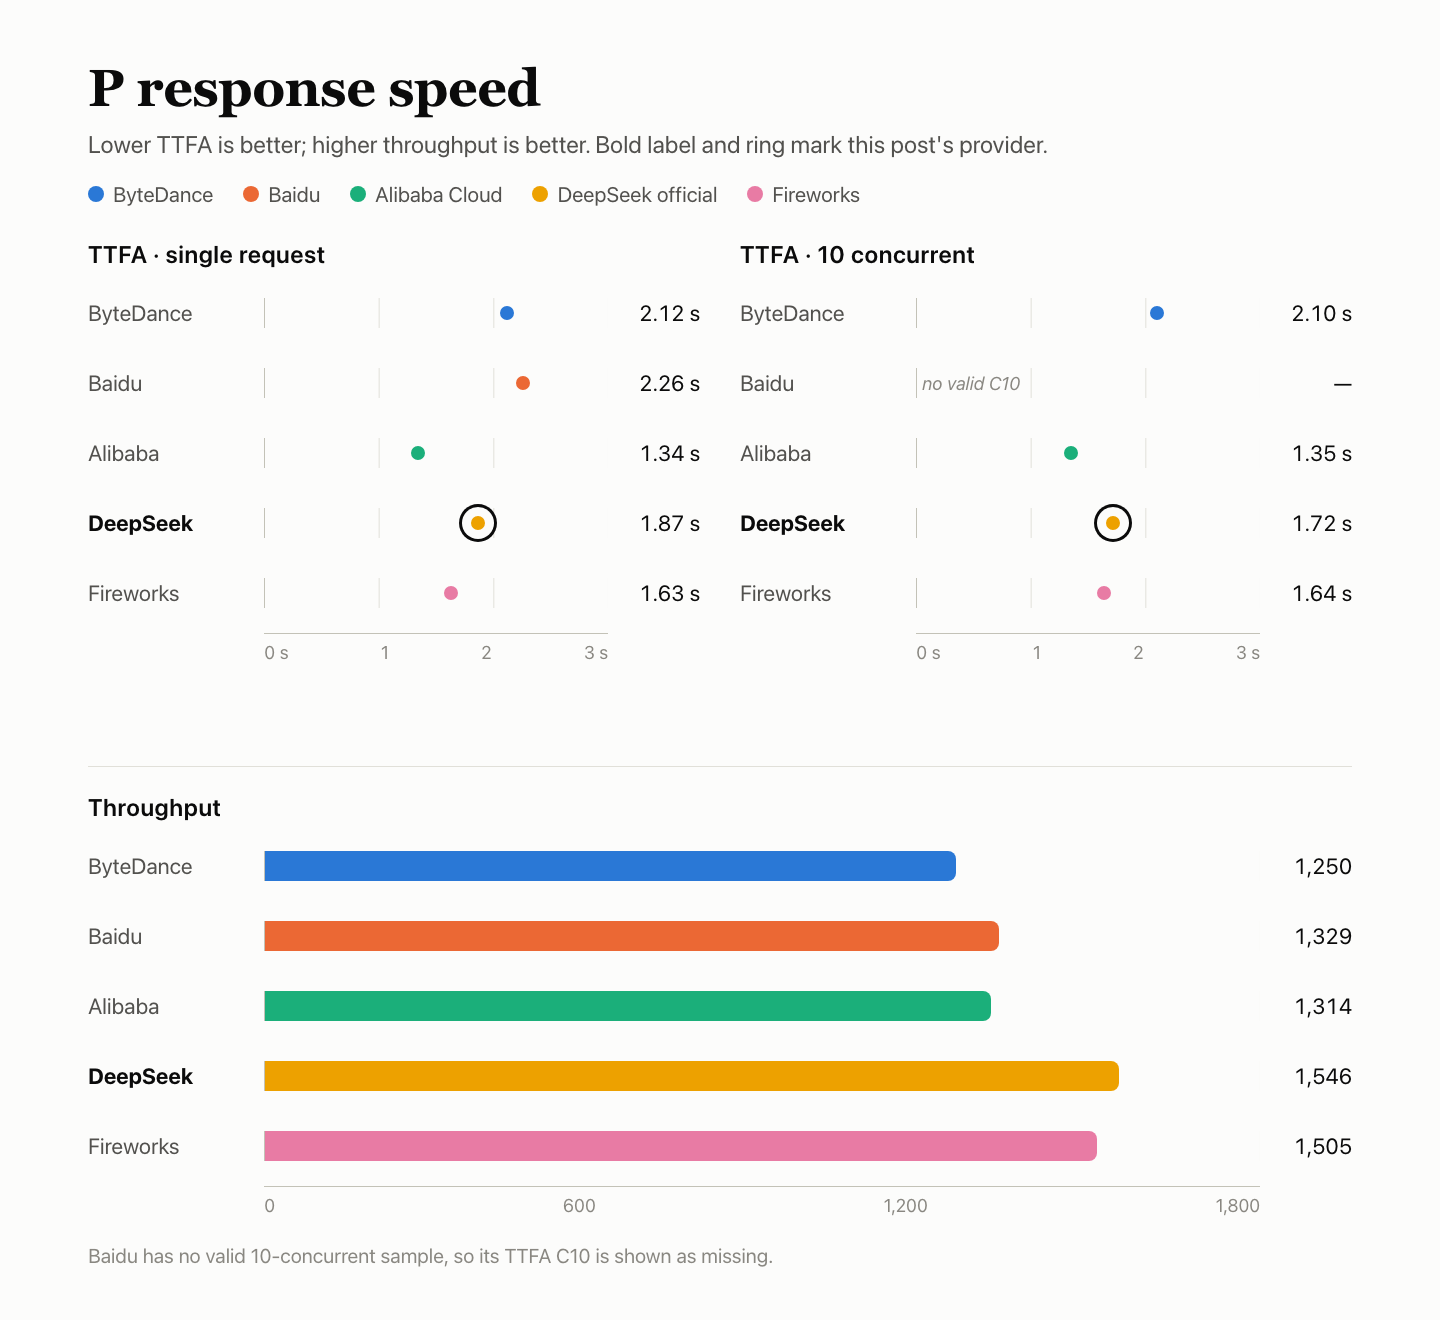
- Скорост на отговора: P 86.14. В първия прозорец при паралелност 1 имаше 15 невалидни заявки от 30 (12 × 503, 2 × изтичане на крайния срок, 1 × изтичане на времето за четене), отчетени с безкрайно време; медианата за първи токен е 1.87 s (1.72 s само за валидните заявки); при паралелност 10 — 1.72 s; TPOT — 2.84 ms.
- Кеш: K 98.38. И 18-те заявки към кеша при 8k и 32k попаднаха в кеша; контролните заявки без кеш не прочетоха нищо от кеша.
- Стабилност на услугата: R 100. Всичките 300 отделни заявки успяха от първия опит.
Настройка на теста
Заявките преминаха през AIHubMix, като беше избран маршрутът към официалния доставчик на DeepSeek; ръководството за бърз старт описва конфигурирането на достъпа.
| Показател | Подробности |
|---|---|
| Модел | DeepSeek V4.1 Flash 1017 |
| Заявен ID на модела | deepseek-flash |
| Върнато име на модела | deepseek-flash |
| Маршрут за достъп | Маршрутът на AIHubMix към официалния доставчик на DeepSeek; не е директна връзка с API на DeepSeek |
| Параметри | Режим без мислене, temperature 1.0, max_tokens 16,384, timeout 300 s, без автоматични повторни опити |
| Мисленето е изключено | Във всички заявки беше зададено reasoning_effort=none |
| Време | 2026-11-03 18:07 – 11-04 16:33 UTC+8; петте доставчика използваха общи Mac mini, мрежа и акаунт |
| Извадки | Качество на отговорите: 4,250 опита (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); случаи за функции: 60 × 3 прозореца; скорост: 90 при паралелност 1 и 90 при паралелност 10; стабилност: 300; кеш: 30 (по три групи с префикси от 8k и 32k) |
Q — качество на отговорите: 42.45
Пакетът обединява BFCL с 500 въпроса × 3 изпълнения, HLE с 250 × 10 и AA-LCR с 25 × 10. BFCL се оценява чрез автоматични правила; HLE и AA-LCR се оценяват от модел-съдията deepseek-flash. И петте доставчика получиха едни и същи въпроси. Десет отговора не можаха да бъдат оценени и бяха премахнати, така че останаха 4,240 оценени опита.
| Бенчмарк | Въпроси | Верни | Точност | Неуспехи |
|---|---|---|---|---|
| Извиквания на инструменти във BFCL | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| Трудни въпроси и отговори в HLE | 250 × 10 | 375/2,490 | 15.06% | 7 |
| Разсъждение по дълги документи в AA-LCR | 25 × 10 | 133/250 | 53.20% | 0 |
| Общо · 95% ДИ 40.08%–44.73% | 4,240 оценени | 1,800/4,240 | 42.45% | 7 |
Неуспехите на услугата — неуспешна заявка или отрязан изход — остават в знаменателя и се броят за грешни. В този случай това са седем изхода от HLE, достигнали лимита max_tokens. BFCL се оценява автоматично; HLE и AA-LCR — от модел-съдия.
Знаменателите за BFCL са общите стойности от трите изпълнения.
| Категория във BFCL | Преминали | Дял на успешно преминалите |
|---|---|---|
| simple_python — една функция, правилно извикване и аргументи | 334/360 | 92.78% |
| multiple — избор на правилната от няколко функции | 268/300 | 89.33% |
| parallel — паралелно извикване на една и съща функция няколко пъти | 271/300 | 90.33% |
| parallel_multiple — паралелно извикване на няколко различни функции | 207/240 | 86.25% |
| irrelevance — няма подходяща функция и не трябва да се извиква нито една | 113/150 | 75.33% |
| ahm_multi_turn — верига от инструменти в три етапа | 99/150 | 66.00% |
Сравнение с останалите четири
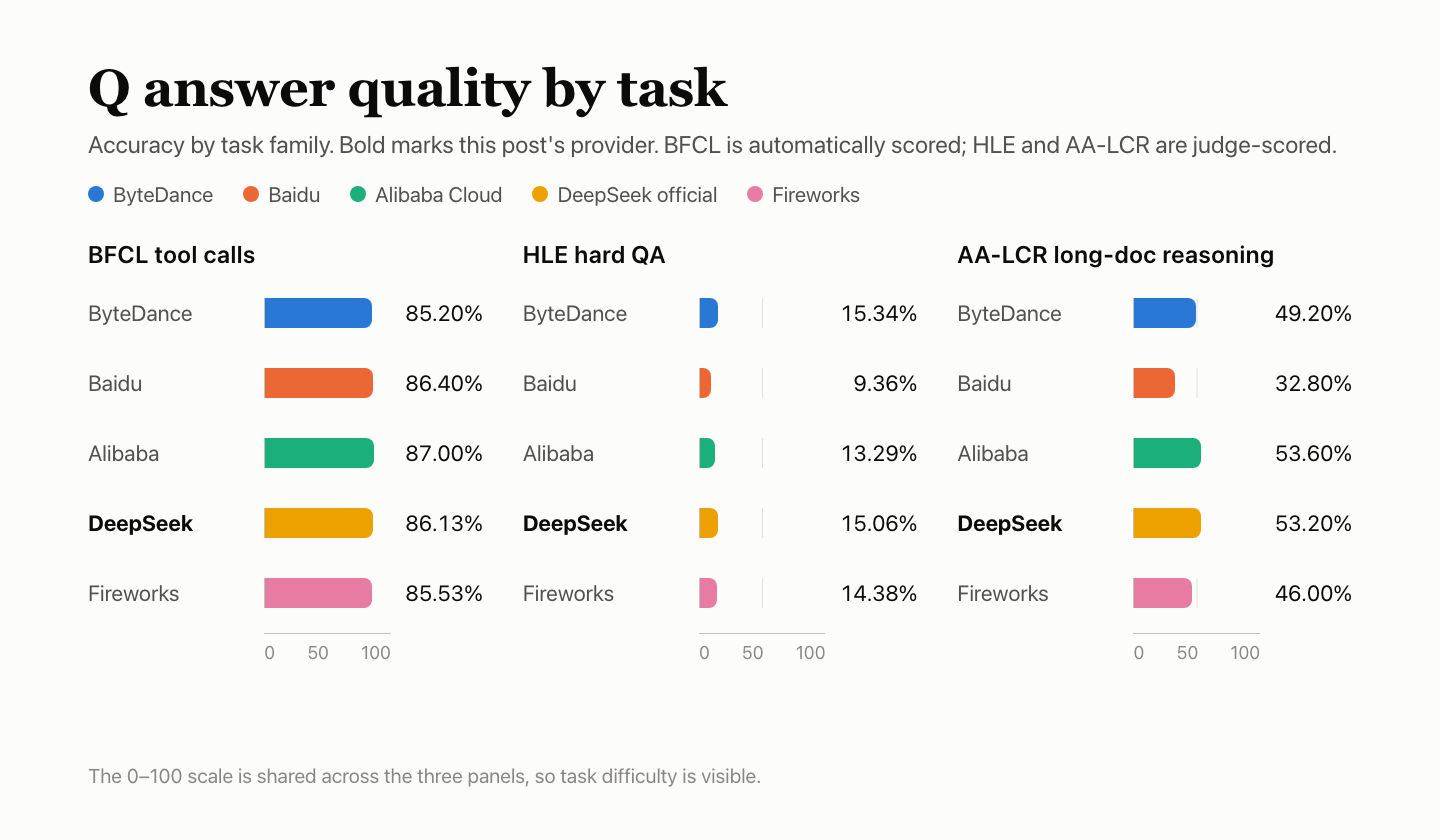
Всяка разлика е в процентни пунктове спрямо тази базова стойност; мустачките показват 95% интервал. Ако интервалът пресича 0, резултатите не могат да бъдат разграничени. Моделът-съдия е от същото семейство DeepSeek като тествания модел и не е калибриран, затова оценяването на HLE и AA-LCR може да е по-благосклонно.
F — поддръжка на функции: 94.00
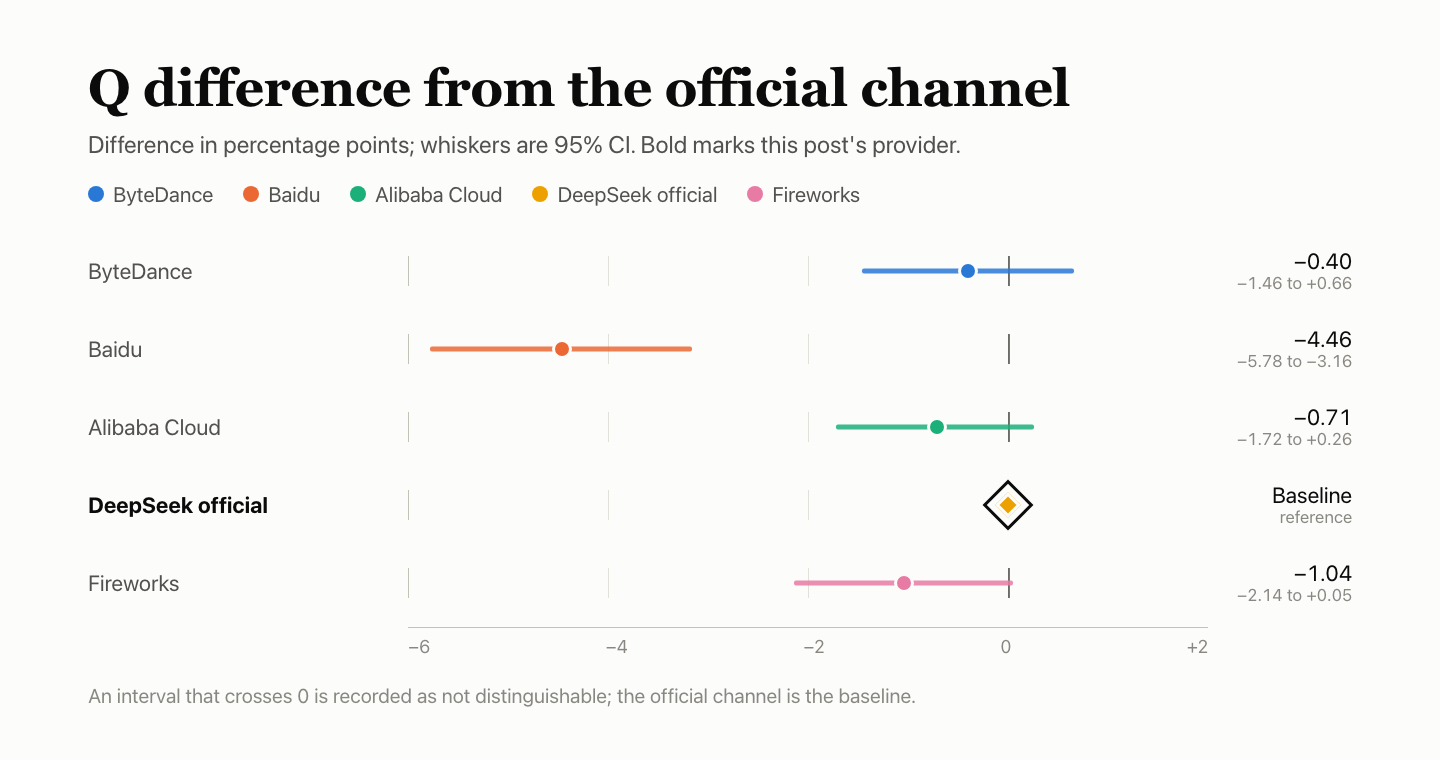
Случаите за функции проверяват поведението на протокола, а не качеството на отговорите. По 60 случая в шест групи бяха изпълнени във всеки от три прозореца — общо 180 проверки — и оценени спрямо формата, посочен в документацията на всеки доставчик. Неприложимите, невалидните и ненаблюдаваните проверки не се включват в знаменателя. Този канал премина 137 от 147 отчетени проверки, с претеглен резултат 94.00; претегленият резултат не е просто 137/147.
| Група | Тегло | Преминали | Изключени | Резултат за групата |
|---|---|---|---|---|
| Поточно предаване и протокол за съобщения | 20% | 27/27 | 3 | 100.00 |
| Интерфейс за инструменти | 20% | 30/30 | — | 100.00 |
| Ограничения на изхода и параметри | 20% | 30/30 | — | 100.00 |
| Контекст и състояние | 15% | 14/15 | 15 | 93.33 |
| Грешки и възстановяване | 15% | 24/30 | — | 80.00 |
| Отчитане и протокол на кеша | 10% | 12/15 | 15 | 80.00 |
| Общо · претеглено | — | 137/147 | 33 | 94.00 |
Претегленият резултат следва теглата на групите; той не е броят на преминалите проверки, разделен на 147.
| Неуспешен случай | Неуспешни прозорци | Причина |
|---|---|---|
| Неправилно форматирани съобщения (Грешки и възстановяване) | 3/3 | Върнат е код 400, но тялото е празно и не съдържа структурирано описание на грешката |
| Неправилно форматиран stream_options (Грешки и възстановяване) | 3/3 | Върнат е код 400, но тялото е празно и не съдържа структурирано описание на грешката |
| Отчитане на токените за мислене (Отчитане и протокол на кеша) | 3/3 | Не е върнат брой токени за мислене |
| Изолиране на заявките (Контекст и състояние) | 1/3 | Първата стъпка не отговори само със STORED, както се изисква, затова проверката за изолиране не можа да продължи |
Изключените проверки не се броят нито като преминали, нито като неуспешни.
| Състояние | Случай | Брой | Причина |
|---|---|---|---|
| Ненаблюдаван | Последователност за спиране на поточно предаване | 3 | Заявката за тази стъпка не беше изпратена след предходната стъпка, затова случаят не можеше да бъде оценен |
| Невалиден | Дълъг вход от 10k; в рамките на контекстовия лимит; дълъг вход от 32k; дълъг вход от 100k; над контекстовия лимит; брой входни токени според нативния отчет; дефинициите на инструментите се броят към входа; броят входни токени е еднакъв преди и след кеширане; броят входни токени при поточно предаване и без него е еднакъв | 27 | Шаблонът за фиксиран нативен брой токени от страната на теста не съответстваше на използването, отчетено от този канал, затова проверките, зависещи от точния брой, бяха обявени за невалидни и изключени от знаменателя |
| Неприложим | Изричен cache_control | 3 | Предварително регистрирано като неподдържано от този интерфейс |
27-те невалидни проверки са случаите в списъка за дълъг вход, контекстов лимит, нативен брой и съгласуваност на кеша. Тъй като фиксираният шаблон не съответстваше на отчетеното използване от този канал, всички проверки, зависещи от точен брой, бяха изключени, вместо да бъдат оценени.
Два случая се провалиха при всичките пет доставчика: неправилно форматирани messages и неправилно форматиран stream_options. И в двата случая беше върнат код 400 с празно тяло, така че клиентът не получи структурирано описание на грешката. Общият модел насочва по-скоро към слоя на шлюза на AIHubMix, който изисква отделно разследване. Отчитането на токените за мислене също се провали при всичките пет доставчика, но по различни причини: ByteDance и Fireworks продължиха да отчитат токени за мислене след изключването му, докато останалите три не върнаха брой токени за мислене.
Сравнение с останалите четири
P — скорост на отговора: 86.14
Всяка заявка съдържаше около 10,000 входни токена и изискваше около 1,100 изходни токена. Във всеки от три прозореца бяха изпратени по 30 заявки при паралелност 1 и 30 при паралелност 10 — общо 180.
| Показател | Стойност |
|---|---|
| TTFA за първия токен | Паралелност 1: медиана 1.87 s (медиана 1.72 s за валидните заявки). Паралелност 10: медиана 1.72 s |
| TPOT | Паралелност 1: 2.84 ms/токен. Паралелност 10: 2.67 ms/токен |
| Валидна пропускателна способност (goodput) | Паралелност 10: 1,546.0 токена/с |
| Валидни заявки | Паралелност 1: 75/90 (прозорец 1: 15/30); паралелност 10: 90/90. Невалидни: 12 × 503 service_unavailable_error, 2 × достигнат краен срок, 1 × изтичане на времето за четене |
| Компонентни резултати | TTFA 51.65, TPOT 100.00, пропускателна способност 100.00; за TTFA и TPOT се взема по-ниската от двете нива, с тегла 35% / 35% / 30%; резултат за отговор 83.08 |
| Състав на P | Резултатът за отговор 83.08 с тегло 80%, кешът K 98.38 с тегло 20%; P 86.14 |
Всичките 15 невалидни заявки бяха в първия прозорец при паралелност 1: 12 върнаха 503, 2 достигнаха крайния срок, а 1 изтече времето за четене. Невалидните заявки се отчитат с безкрайно време, затова отчетената медиана е 1.87 s. Само за валидните заявки медианата е 1.72 s. При паралелност 10 медианата също е 1.72 s. TPOT е 2.84 ms/токен при паралелност 1 и 2.67 ms/токен при паралелност 10.
Сравнение с останалите четири
Петте доставчика използваха общи Mac mini, мрежа и акаунт. Трите прозореца бяха планирани по доставчици, така че периодите на събиране на данни не се припокриват напълно; не бива да се правят прекалено категорични изводи от малките разлики.
K — кеш: 98.38
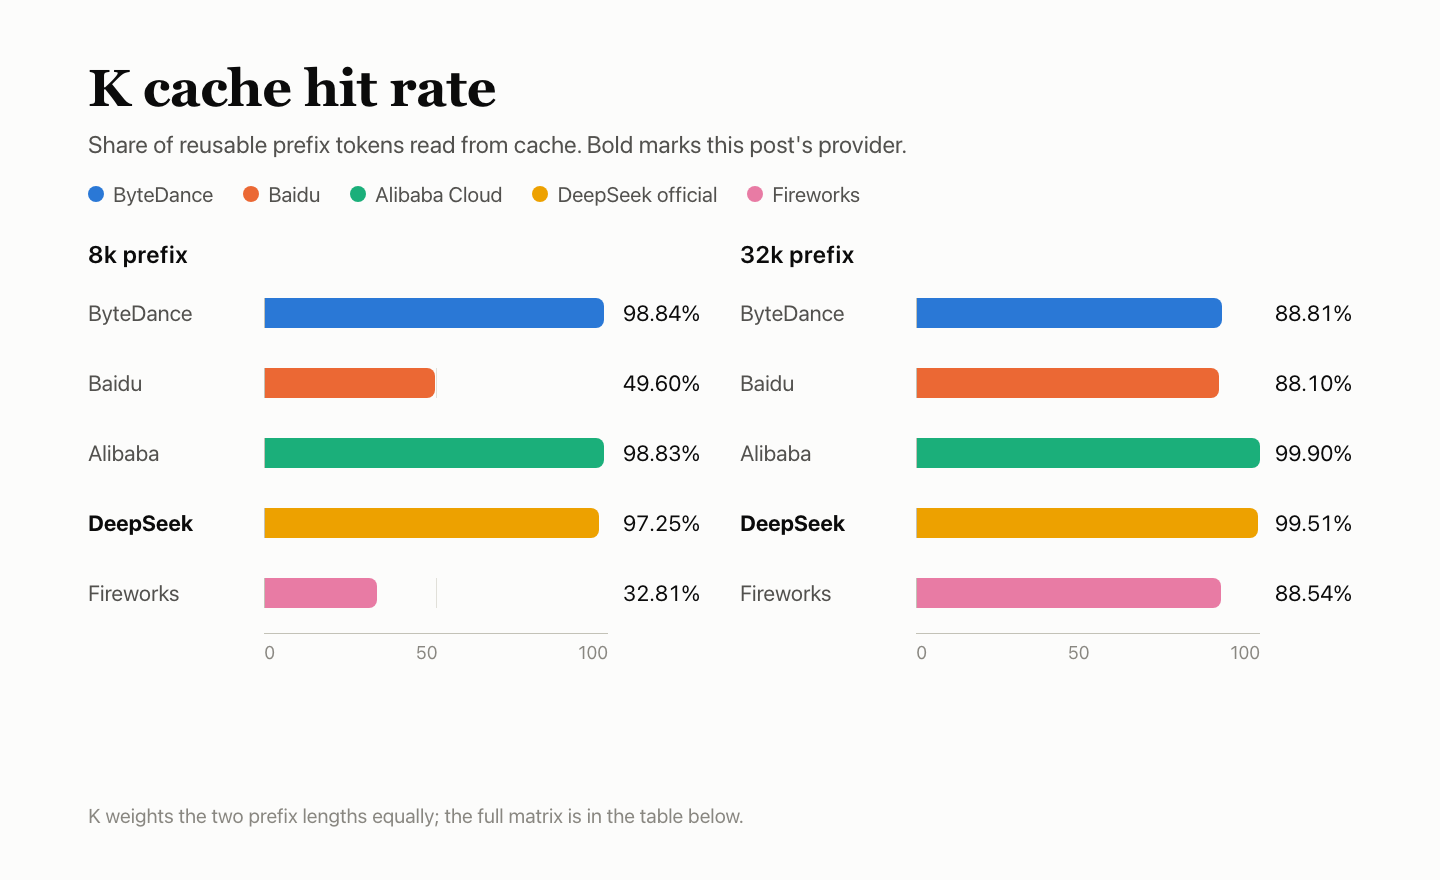
Всяка група изпраща пет заявки. Първата задава фиксиран префикс от 8k или 32k. При заявки от втора до четвърта префиксът се запазва и се променя само последният въпрос — след 5, 30 и 120 секунди. Петата използва нов префикс като контролна заявка без кеш. Три прозореца × две дължини дават 30 заявки. K е отношението между прочетените токени от кеша при заявките към кеша и токените, които би трябвало да могат да се използват повторно; всяка дължина има тегло 50%. K съставлява 20% от P. В документацията на API на DeepSeek е описано кеширането на контекста.
| Префикс | Прозорец | Начална заявка | +5 s | +30 s | +120 s | Контролна заявка без кеш |
|---|---|---|---|---|---|---|
| 8k | Прозорец 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Прозорец 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Прозорец 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Прозорец 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Прозорец 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Прозорец 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
При заявките към кеша с 8k 9 от 9 попаднаха в кеша и всяка прочете по 7,808 токена: общо бяха прочетени 70,272 от 72,261 токена, които можеха да се използват повторно — резултат 97.25. При заявките с 32k 9 от 9 попаднаха в кеша и всяка прочете по 31,872 токена: 286,848 от 288,270 — резултат 99.51. Контролните заявки не прочетоха нищо от кеша. K е 98.38 за двете дължини общо.
Сравнение с останалите четири
R — стабилност на услугата: 100
300 заявки обхващат кратък текст, дълъг вход от 10k, извиквания на инструменти и история на многоходови разговори; те бяха изпратени при паралелност 1 в три прозореца. Проверяват се само валидността и пълнотата от първия опит, а не правилността на отговорите; няма повторни опити. Неуспехите по качество на отговорите и скорост се отчитат в Q и P, а не отново в R.
| Тип заявка | Успех от първия опит |
|---|---|
| Кратък текст | 120/120 |
| Дълъг вход от 10k | 90/90 |
| Извиквания на инструменти | 60/60 |
| История на многоходов разговор | 30/30 |
| Общо · 95% ДИ 98.78%–100% | 300/300 |
И при 300-те заявки беше върнат валиден и пълен отговор още при първия опит. R 100 обхваща само тези 300 специално заделени заявки; това не означава, че по целия маршрут не е имало неуспешни заявки. При 300 успешни заявки долната граница на 95% интервал е 98.78%, така че данните сочат, че процентът на неуспехи вероятно е под 1.22%.
Сравнение с останалите четири
R обхваща само 300-те специално заделени заявки; неуспехите при качеството на отговорите и скоростта се отчитат съответно в Q и P, а не се броят повторно в R.
| Доставчик | Успех от първия опит | 95% ДИ |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
ЧЗВ
Това директна връзка ли е с API на DeepSeek?
Не. Заявките минават през маршрута на AIHubMix към официалния доставчик на DeepSeek; не се изпращат директно към API на DeepSeek.
Защо официалният канал на DeepSeek е базата за сравнение в Q?
Това е официалният канал на DeepSeek за същия модел, затова резултатите за качеството на отговорите от останалите четири доставчика се представят като разлики спрямо него. Ролята му на база за сравнение не предполага класиране по качество на отговорите.
Какво се случи в първия прозорец за измерване на скоростта при единична конкурентност?
Петнадесет от 30 заявки бяха невалидни: 12 върнаха 503, 2 достигнаха крайния срок, а 1 засече изчакване при четене. Те се отчитат като безкрайни, затова медианата е 1.87 s; само при валидните заявки тя е 1.72 s.
Какви са 27-те невалидни проверки на функциите?
Те зависят от точния брой токени: дълги входове, ограничения на контекста, брой токени за входа, отчетен от модела, и съгласуваност на входа в кеша. Фиксираният шаблон от теста за броя токени, отчетен от модела, не съвпадна с употребата, отчетена от този канал, затова проверките бяха изключени от знаменателя, вместо да бъдат отчетени като неуспешни.
Защо R 100 не гарантира, че по маршрута няма неуспешни заявки?
R обхваща само 300-те специално заделени заявки за проверка на стабилността. Неуспехите при тестовете за качество на отговорите и скорост се отчитат в Q и P. При 300 успешни от 300 заявки долната граница на 95% интервал е 98.78%, така че процентът на неуспехи вероятно е под 1.22% — но това не доказва, че е нулев.
Как тестът на кеша разделя четенията от кеша и студените четения?
Във всяка група се подготвя префикс от 8k или 32k, който се изпраща отново след 5, 30 и 120 секунди с нов последен въпрос, а след това се изпраща нов префикс като контролна заявка за студено четене. При двете дължини попаденията в кеша са 9 от 9 при горещите заявки, а всяка контролна заявка за студено четене върна нула кеширани токени.
Продължете с поредицата за DeepSeek V4.1 Flash
- Q на ByteDance е с 0.40 точки от тази базова стойност, но резултатите му за поддръжката на функции и кеша са различни: DeepSeek V4.1 Flash на ByteDance: извикванията на инструменти съвпадат, таксуването — не.
- Baidu загуби заявки заради
no_available_channel, което се отразява както в Q, така и в P: DeepSeek V4.1 Flash на Baidu: липсата на наличен канал влияе на Q и P. - Общият резултат на Alibaba Cloud се различава с 0.37 и няма статистически значима разлика: DeepSeek V4.1 Flash на Alibaba Cloud: първи токен за 1.34s, кеш 99.37.
- При Fireworks попаденията в кеша са 3 от 9 при горещите заявки с 8k, срещу 9 от 9 тук: DeepSeek V4.1 Flash на Fireworks: празни отговори при stop, 3/9 попадения в кеша.


