

На 2026-11-03/04 DeepSeek V4.1 Flash 1017 беше тестван при пет доставчика чрез AIHubMix със suite набора APB Full: едни и същи въпроси, параметри и скриптове за заявки всеки път. Този APB профил обхваща само теста през Baidu и представя резултатите раздел по раздел.
Посочените по-долу числа са само резултати, а не класация или препоръка за доставчик. Първо са дадени Q 38.00, F 88.39, P 37.77, K 68.85 и R 100; общият резултат 56.48 е обобщаващ индекс без интервал на доверие. Използвани са правилата за оценяване от AIHubMix Provider Benchmark Standard v2.0.
Резултати при пет доставчика
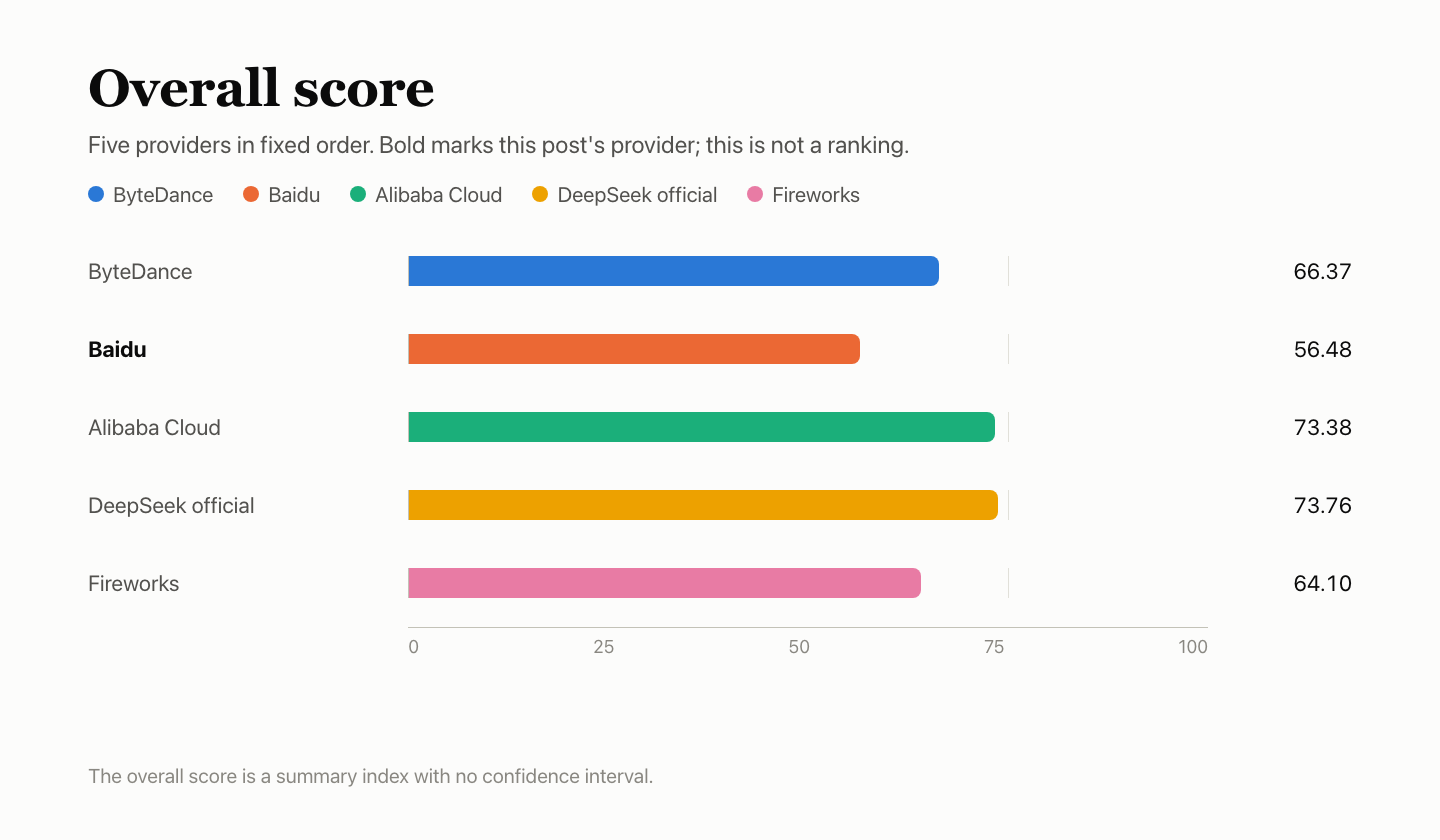
С удебелен шрифт е обозначен доставчикът в тази публикация. Доставчиците са подредени във фиксиран ред, а не според класиране. K е подрезултат на P с дял 20%. Общият резултат е обобщаващ индекс без интервал на доверие. Разликата от 0.37 между официалния канал и Alibaba Cloud не може да се различи статистически.
Накратко
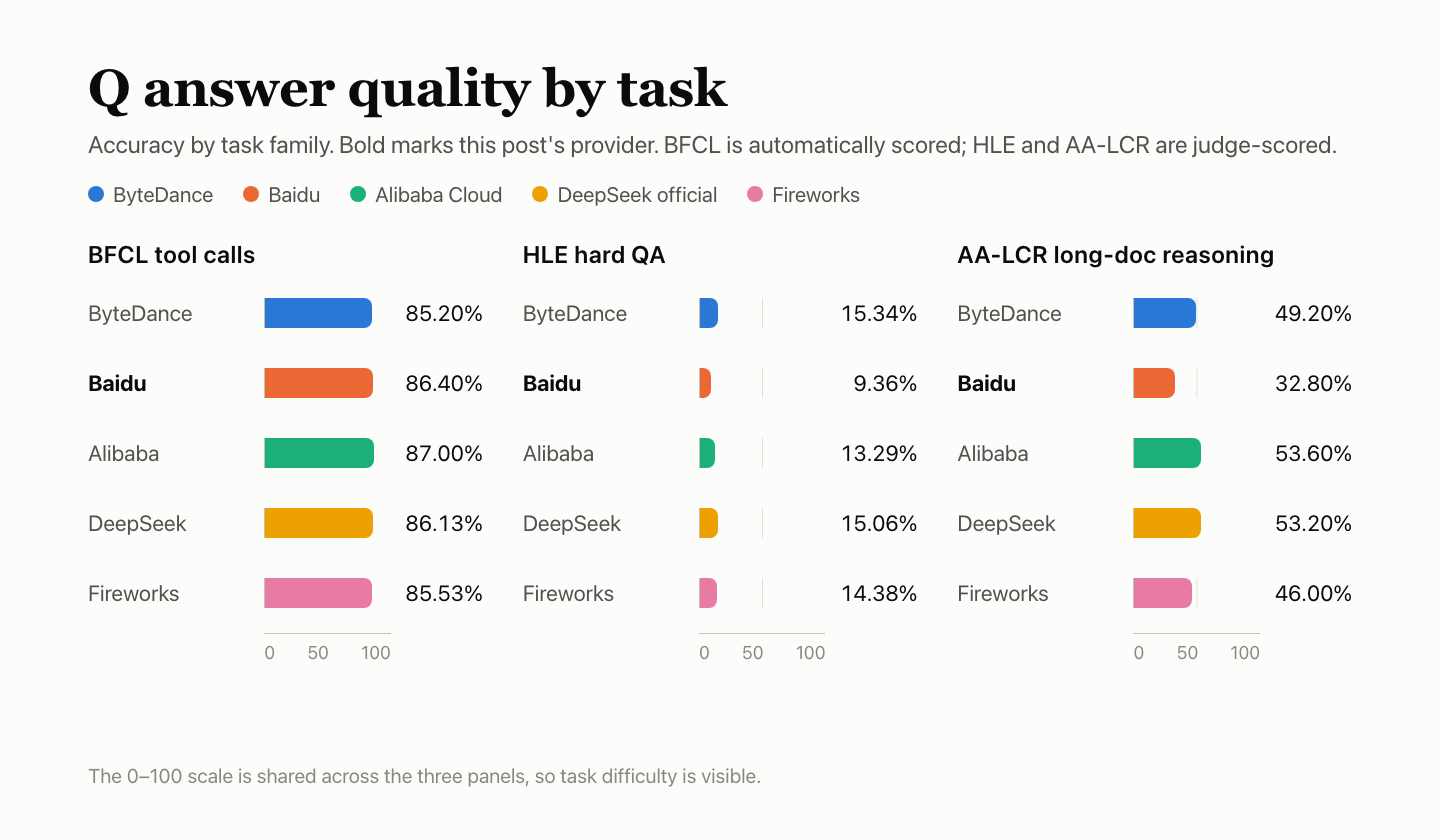
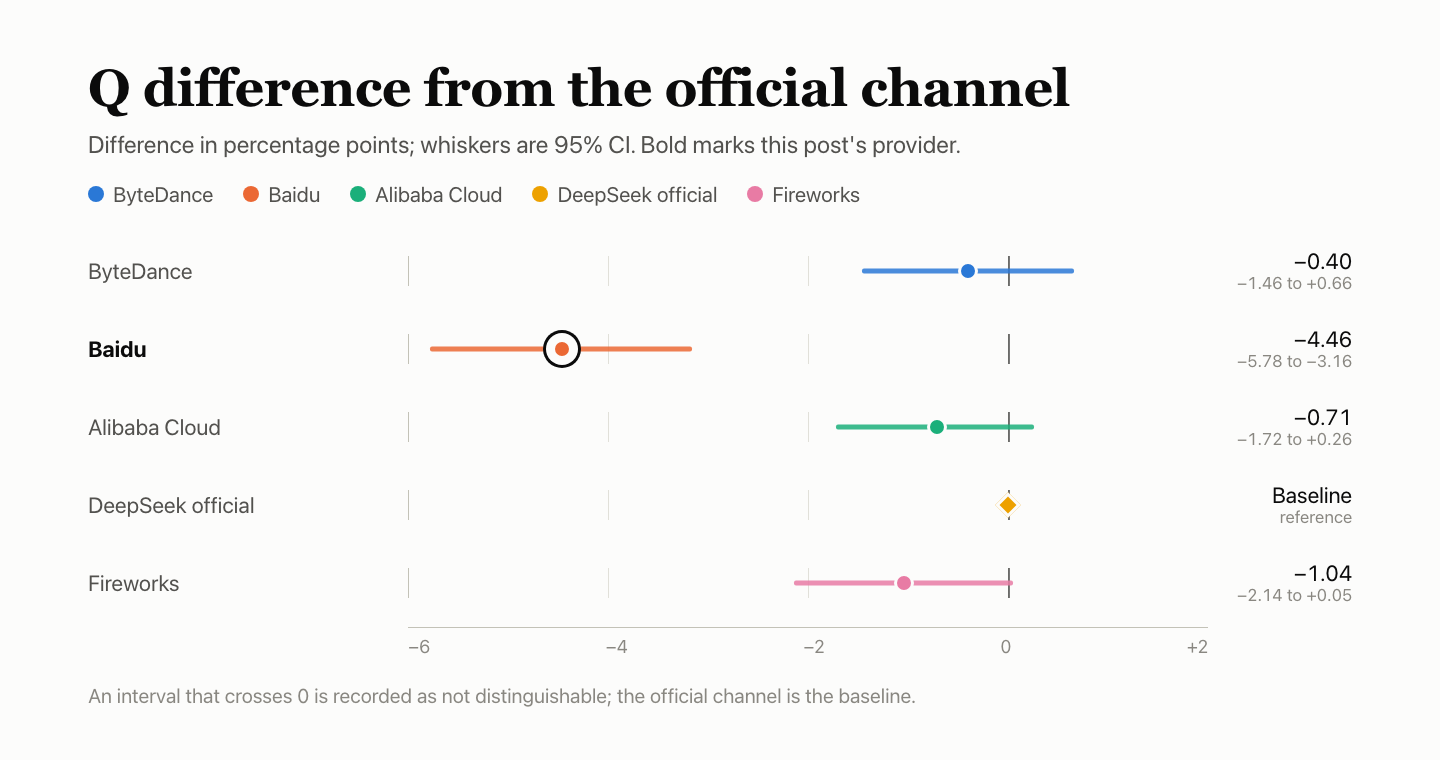
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. Комбинираният резултат е с 4.46 пункта под този на официалния канал; 95% интервалът е от −5.78 до −3.16 и не включва 0. При HLE са регистрирани 864 неуспешни заявки, а при AA-LCR — 100; почти всички са били в първия прозорец и са отчетени като грешни отговори.
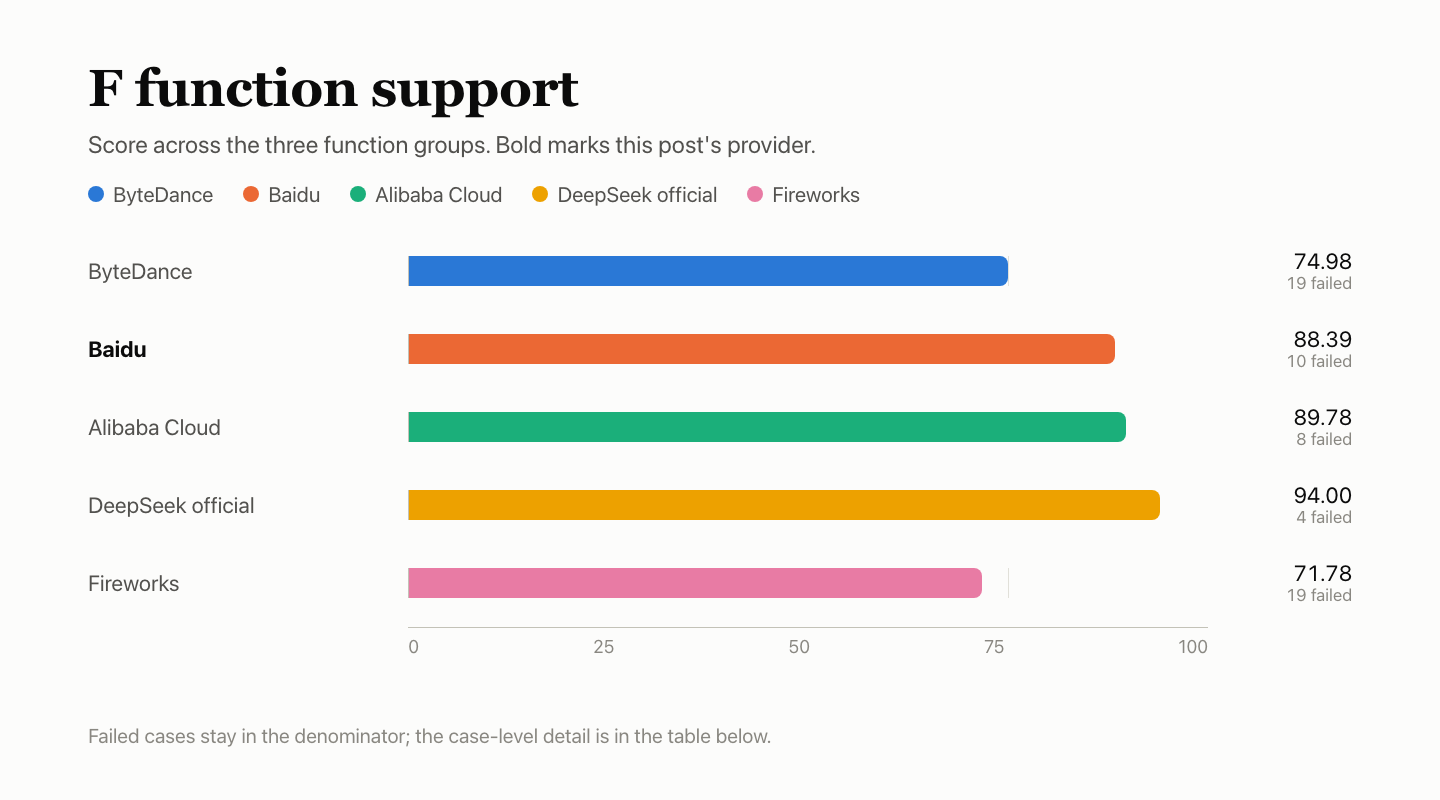
- F: 88.39. От 174 проверки 148 бяха успешни. Полето за прочитане от кеша и броят токени за разсъждение не бяха върнати; случаите с превишен контекст и сирачешки резултат от инструмент върнаха 200.
- P: 37.77. 50 от 90 теста при 10 едновременни заявки върнаха
no_available_channel, така че над половината бяха невалидни, а TTFA и TPOT получиха наказателните си стойности. Тестовете с една едновременна заявка бяха валидни в 78 от 90 случая. - K: 68.85. Заявките с 8k топъл кеш попаднаха в кеша 5 от 9 пъти, а 3 заявки се провалиха; за префикса 32k имаше 8 попадения от 9. Попаденията се отчитат на блокове от 1,024 токена: 7,168 токена за 8k и 31,744 за 32k.
- R: 100. Всичките 300 отделни заявки успяха от първия опит. Неуспешните заявки за канал по време на тестовете с отговори и скорост се отчитат съответно при Q и P.
Настройка на теста
Заявките използваха маршрута quick start на AIHubMix с конкретен за доставчика ID, а параметрите следваха документацията за API на DeepSeek; ID-тата на моделите при другите доставчици са посочени на страницата с модели. Това не е директна връзка към собствен акаунт в Baidu.
| Поле | Стойност |
|---|---|
| Модел | DeepSeek V4.1 Flash 1017 |
| Заявен ID на модела | baidu-deepseek-v4.1-flash-1017 |
| Върнато име на модела | deepseek-v4.1-flash-1017 |
| Маршрут за достъп | Чрез AIHubMix с ID на модела, специфичен за доставчика; не е директна връзка към собствен акаунт на доставчика |
| Параметри | Режим без разсъждение, temperature 1.0, max_tokens 16,384, timeout 300 s, без автоматични повторни опити |
| Разсъждението е изключено | За всяка заявка беше зададено reasoning_effort=none |
| Време | 2026-11-03 18:07 – 11-04 16:33 UTC+8; и петте доставчика използваха един и същ Mac mini, мрежа и акаунт |
| Извадки | 4,250 опита за отговор (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 функционални случая × 3 прозореца; 90 теста за скорост с една едновременна заявка и 90 с десет едновременни заявки; 300 заявки за стабилност; 30 теста за кеша (по три групи за префиксите 8k и 32k) |
Q — качество на отговорите: 38.00
Качеството на отговорите се оценява чрез три типа задачи: 500 BFCL задачи, всяка с три отговора; 250 HLE задачи, всяка с десет отговора; и 25 AA-LCR задачи, всяка с десет отговора. BFCL се оценява по автоматични правила; моделът-оценител deepseek-flash определя дали отговорите на HLE и AA-LCR са правилни или грешни. И петте доставчика получиха един и същ набор от задачи, а резултатите от трите типа се обединяват в един показател за точност. Десет отговора бяха премахнати, защото задачата не можеше да бъде оценена, и останаха 4,240 оценени опита.
| Задача | Брой | Правилни | Точност | Неуспехи |
|---|---|---|---|---|
| Извиквания на инструменти BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Трудни въпроси HLE, оценени от модел-оценител | 250 × 10 | 233/2,490 | 9.36% | 875 |
| AA-LCR разсъждение по дълги документи | 25 × 10 | 82/250 | 32.80% | 100 |
| Общо · 95% интервал 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Неуспехите на услугата — независимо дали става дума за неуспешна заявка или съкратен изход — остават в знаменателя и се броят като грешни отговори. При HLE имаше 864 неуспешни заявки (863 в първия прозорец, 1 във втория) и 11 изхода, съкратени заради достигане на лимита max_tokens. При AA-LCR имаше 100 неуспешни заявки, всички в първия прозорец.
В BFCL на всяка задача се отговаря три пъти; таблицата обединява резултатите от трите кръга.
| Категория BFCL | Успешни | Процент на успех |
|---|---|---|
| simple_python: една функция, правилно извикване и аргументи | 336/360 | 93.33% |
| multiple: избор на правилната функция измежду няколко | 269/300 | 89.67% |
| parallel: паралелно извикване на една функция няколко пъти | 268/300 | 89.33% |
| parallel_multiple: паралелно извикване на няколко различни функции | 206/240 | 85.83% |
| irrelevance: не се прилага нито една функция — да не се извиква | 113/150 | 75.33% |
| ahm_multi_turn: верига от инструменти в три стъпки | 104/150 | 69.33% |
Сравнение с останалите четири
Разликата е посочена в процентни пунктове спрямо официалния канал, а интервалът от 95% е показан с мустаци. Интервал, който пресича 0, се счита за неразличим. Моделът-оценител за HLE и AA-LCR, deepseek-flash, принадлежи към същото семейство DeepSeek като тествания модел и не е калибриран, затова оценките му може да са снизходителни.
F — поддръжка на функции: 88.39
Функционалните случаи проверяват дали интерфейсът се държи според спецификацията на протокола, а не дали моделът отговаря добре. Шестдесет случая в шест групи бяха изпълнени по веднъж във всеки от трите прозореца — общо 180 проверки, оценени спрямо формата, документиран от доставчика. Проверките, които не са приложими, са невалидни или не са наблюдавани, се изключват от знаменателя. За Baidu бяха отчетени 174 проверки, от които 148 бяха успешни, което дава претеглен резултат 88.39.
Резултатът за групата се претегля според нейния дял, а не се изчислява просто като 148/174.
| Група случаи | Тегло | Успешни | Изключени | Резултат за групата |
|---|---|---|---|---|
| Поточно предаване и протокол на съобщенията | 20% | 27/27 | 3 | 100.00 |
| Интерфейс за инструменти | 20% | 30/30 | — | 100.00 |
| Ограничения на изхода и параметри | 20% | 29/30 | — | 96.67 |
| Контекст и състояние | 15% | 26/30 | — | 86.67 |
| Грешки и възстановяване | 15% | 21/30 | — | 70.00 |
| Отчитане и протокол на кеша | 10% | 15/27 | 3 | 55.56 |
| Общо, претеглено | 100% | 148/174 | 6 | 88.39 |
| Неуспешен случай | Прозорци с неуспех | Причина |
|---|---|---|
| Превишен контекст (контекст и състояние) | 3/3 | Трябва да върне грешка в параметрите; върна 200 |
| Неправилно форматирани съобщения (грешки и възстановяване) | 3/3 | Върна 400 с празно тяло, без структурирана грешка |
| Сирачешки резултат от инструмент (грешки и възстановяване) | 3/3 | Трябва да върне грешка в параметрите; върна 200 |
| Неправилно форматиран stream_options (грешки и възстановяване) | 3/3 | Върна 400 с празно тяло, без структурирана грешка |
| Поле за прочитане от кеша (отчитане и протокол на кеша) | 3/3 | Не беше върнато поле за прочитане от кеша; прочитането не може да бъде потвърдено |
| Отчитане на токените за разсъждение (отчитане и протокол на кеша) | 3/3 | Не беше върнат броят токени за разсъждение |
| Дефинициите на инструментите се отчитат във входа (отчитане и протокол на кеша) | 3/3 | При наличие на дефиниции на инструменти отчетеният брой входни токени не беше по-висок |
| Последователен брой входни токени преди и след кеширане (отчитане и протокол на кеша) | 3/3 | Не беше върнато поле за прочитане от кеша; прочитането не може да бъде потвърдено |
| Разнообразие на извадките (ограничения на изхода и параметри) | 1/3 | Повтаряните изходи при temperature 0 и 1 се различаваха твърде малко и не покриха предварително зададения критерий |
| Изолиране между заявките (контекст и състояние) | 1/3 | Първата стъпка не отговори само с STORED, както се изискваше, затова проверката за изолиране не можа да продължи |
Тези проверки се изключват от знаменателя: нито се считат за успешни, нито за неуспешни.
| Статус | Случай | Брой | Причина |
|---|---|---|---|
| Не е наблюдаван | Последователност за спиране на поточното предаване | 3 | Заявката за тази стъпка не беше изпратена след предходната, затова не може да бъде оценена |
| Неприложимо | Изричен cache_control | 3 | Предварително зададено като неподдържано от този интерфейс |
Неправилно форматираните messages и неправилно форматираният stream_options се провалиха при всичките пет доставчика: и двата върнаха 400 с празно тяло, без структурирана грешка за клиента. Неуспех, общ за всичките пет, вероятно е в слоя на шлюза на AIHubMix и изисква отделно разследване. Отчитането на токените за разсъждение също се провали и при петте, но по различни причини: ByteDance и Fireworks отчетоха токени за разсъждение дори когато разсъждението беше изключено, а останалите три не върнаха броя токени за разсъждение.
Сравнение с останалите четири
P — скорост на отговора: 37.77
Всяка заявка съдържаше около 10,000 входни токена и изискваше тяло с около 1,100 изходни токена. Във всеки от трите прозореца бяха изпратени 30 теста с една едновременна заявка и 30 с десет едновременни заявки — общо 180 заявки.
| Показател | Резултат |
|---|---|
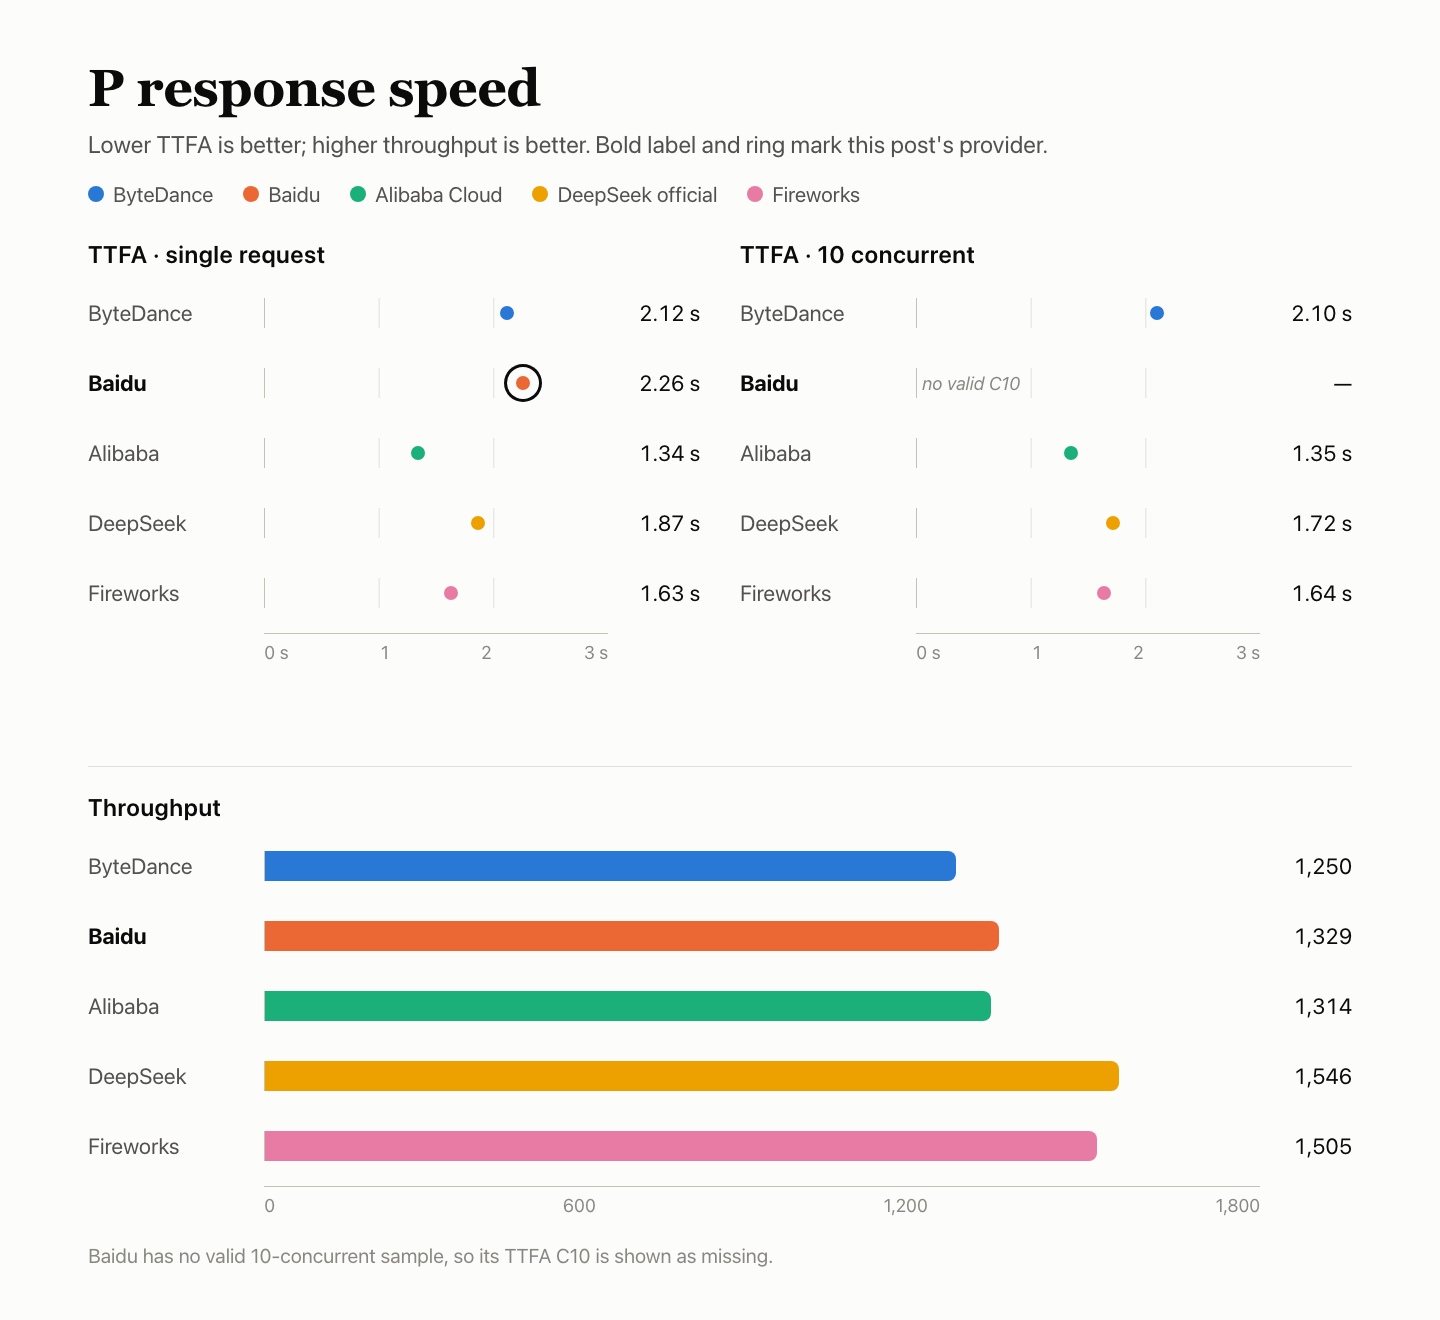
| TTFA за първия токен | Една едновременна заявка: медиана 2.26 s (медиана за валидните заявки 2.05 s); десет едновременни заявки: над половината невалидни, отчетената медиана е безкрайност (медиана за валидните заявки 1.86 s) |
| Скорост на генериране TPOT | Една едновременна заявка: 3.48 ms/токен; десет едновременни заявки: 50.00 ms/токен (над половината невалидни, наказателна стойност) |
| Добра пропускателна способност (валиден пропускателен капацитет) | Десет едновременни заявки: 1,329.2 токена/s |
| Валидни заявки | Една едновременна заявка: 78/90 (първи прозорец 18/30); десет едновременни заявки: 40/90 (първи прозорец 0/30, трети прозорец 10/30) |
| Причина за невалидност | 62 теста върнаха 400 no_available_channel |
| Резултат по компонент | TTFA 0.00, TPOT 0.00, пропускателна способност 100.00; резултат за отговор 30.00 |
| Състав на P | Резултат за отговор 30.00 с тегло 80%, кеш K 68.85 с тегло 20%, общо 37.77 |
TPOT се изчислява от частите на поточно предавания отговор, а не се измерва за всеки токен на хардуера. Добрата пропускателна способност е броят валидни изходни токени при натоварване с десет едновременни заявки, разделен на времето за изпълнение на партидата.
При натоварването с десет едновременни заявки 50 от 90 теста върнаха no_available_channel. Тъй като над половината са невалидни, медианното време до първия токен се счита за безкрайност, а TTFA и TPOT получават наказателните си стойности. При натоварването с една едновременна заявка 78 от 90 теста останаха валидни.
И петте доставчика използваха една и съща машина, мрежа и акаунт. Трите прозореца бяха насрочени поотделно за всеки доставчик, така че периодите на събиране на данни не се припокриват напълно; не бива да се правят прекалено категорични изводи от малките разлики.
K — кеш: 68.85
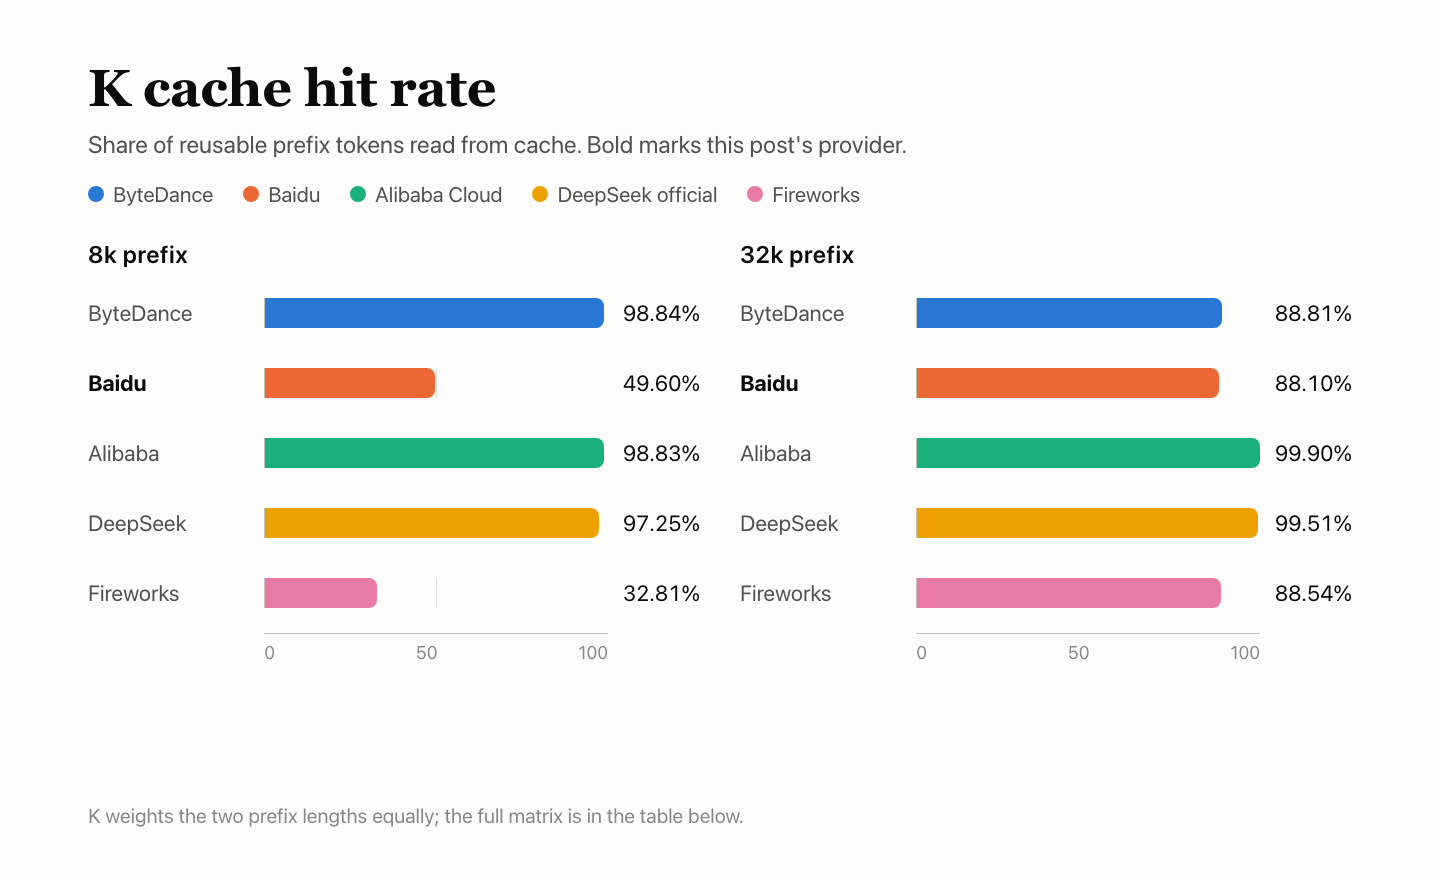
Всяка група изпраща пет заявки. Първата съдържа фиксиран префикс от около 8k или 32k токена и го зарежда в кеша. При заявки 2–4 префиксът остава същият, като се променя само въпросът в края, а интервалите между заявките са 5 s, 30 s и 120 s. Петата използва нов префикс като контролен случай без предварително загряване. Три прозореца × две дължини правят общо 30 заявки. K е броят токени, прочетени от кеша при топлите заявки, разделен на броя токени, които според правилата би трябвало да могат да се използват повторно; двете дължини имат еднакво тегло. K съставлява 20% от P.
Таблицата показва броя токени за прочитане от кеша, отчетен от сървъра; „не е върнато“ означава, че полето липсва в отговора.
| Префикс | Прозорец | Начално зареждане | +5 s | +30 s | +120 s | Контрол без кеш |
|---|---|---|---|---|---|---|
| 8k | 1 | Неуспешно | Неуспешно | Неуспешно | Не е върнато | Не е върнато |
| 8k | 2 | Не е върнато | 7,168 | 7,168 | Неуспешно | Неуспешно |
| 8k | 3 | Не е върнато | 7,168 | 7,168 | 7,168 | Не е върнато |
| 32k | 1 | Не е върнато | Не е върнато | 31,744 | 31,744 | Не е върнато |
| 32k | 2 | Не е върнато | 31,744 | 31,744 | 31,744 | Не е върнато |
| 32k | 3 | Не е върнато | 31,744 | 31,744 | 31,744 | Не е върнато |
Префиксът 8k отчете попадение при 5 от 9 горещи заявки, като прочете 35,840 от 72,252 токена, които е трябвало да могат да се използват повторно, за резултат 49.60. Префиксът 32k отчете попадение при 8 от 9, като прочете 253,952 от 288,261 токена, за резултат 88.10. K е 68.85, като двете дължини имат еднаква тежест. Общо пет заявки 8k се провалиха: seed заявката, заявките след 5 s и 30 s в прозорец 1 и заявките след 120 s и за контрол при студен кеш в прозорец 2 — всички с no_available_channel. Така в категорията 8k остават три неуспешни горещи заявки.
При попадение отчетеното прочитане се брои на блокове от 1,024 токена: 7,168 токена за префикса 8k и 31,744 за префикса 32k. При пропуск в кеша блокът за потреблението не включва prompt_tokens_details; в таблицата е отбелязано „не е върнато“, а стойността се брои като 0.
Сравнение с останалите четири
R — стабилност на услугата: 100
300-те заявки са от четири типа: кратък текст, дълъг вход, извикване на инструмент и история от няколко хода. Изпратени са с паралелност 1 в три прозореца. Проверява се само дали първият отговор е валиден и пълен; отговорите не се оценяват и нищо не се изпраща повторно. Неуспехите при генерирането на отговори и измерванията на скоростта се отчитат съответно в Q и P, а не отново в R.
| Тип заявка | Успех от първия опит |
|---|---|
| Кратък текст | 120/120 |
| Дълъг вход от 10k | 90/90 |
| Извикване на инструмент | 60/60 |
| История от няколко хода | 30/30 |
| Общо | 300/300, 95% ДИ 98.78%–100% |
И 300-те заявки върнаха валиден и пълен отговор от първия опит. R 100 обхваща само тези 300 специално подбрани заявки; това не означава, че по целия път не е имало неуспехи. При 300 успешни от 300 долната граница на 95% интервал е 98.78%, така че вероятно процентът на неуспехите е под 1.22%.
Сравнение с останалите четири
R обхваща само тези 300 специално подбрани заявки; неуспехите при генерирането на отговори и измерванията на скоростта се отчитат съответно в Q и P, а не отново в R.
| Доставчик | Успех от първия опит | 95% интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Официален DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Често задавани въпроси
Какво показва общият резултат?
Това е обобщаващ индекс без доверителен интервал, а не сертификат. В тази публикация са представени Q, F, P, K и R, без да се препоръчва доставчик.
Защо половината от тестовете с паралелност 10 се провалиха?
50 от 90 върнаха no_available_channel. Тъй като повече от половината са невалидни, медианното време до първия токен се приема за безкрайност, а TTFA и TPOT получават стойностите за наказание.
Означава ли R 100, че не е имало откази на канала?
Не. R обхваща 300 специално подбрани заявки, всички успешни от първия опит. 62-та отговора no_available_channel при теста за скорост и неуспехите при теста за генериране на отговори се отчитат съответно в P и Q.
Защо K е 68.85, след като префиксът 32k отчете попадение при 8 от 9 заявки?
Двете дължини имат еднаква тежест. При префикса 8k е отчетено попадение при 5 от 9 горещи заявки и резултатът е 49.60, докато при 32k има попадение при 8 от 9 и резултатът е 88.10; средната стойност е 68.85.
Различава ли се качеството на отговорите на Baidu от това на официалния канал?
Да. Общата разлика в Q е −4.46 процентни пункта, с 95% интервал от −5.78 до −3.16, който не включва 0. Това е единственият резултат на доставчик под този на официалния канал, чийто интервал не включва 0.
Кои проверки бяха изключени от F?
Шест: три проверки на стоп последователности при поточно предаване, които така и не бяха наблюдавани, защото заявката за предходната стъпка не беше изпратена, и три изрични проверки на cache_control, предварително регистрирани като неподдържани от този интерфейс.
Продължете с поредицата за DeepSeek V4.1 Flash
- Точността на Baidu по BFCL беше близка до тази на официалния канал; публикацията за ByteDance проследява същия набор тестове, като разглежда резултатите от извикванията на инструменти и отчитането на потреблението: DeepSeek V4.1 Flash в ByteDance: извикванията на инструменти съвпадат, отчитането — не
- TTFA на Baidu при паралелност 1 е 2.26 s — резултат, който се отличава от тест с време 1.34 s: DeepSeek V4.1 Flash в Alibaba Cloud: 1.34s до първия токен, кеш 99.37
- F на Baidu от 88.39 се сравнява с референтен тест с резултат 94.00 и 15 невалидни тестови заявки: DeepSeek V4.1 Flash в официалния канал: F 94.00, 15 невалидни тестови заявки
- Попаденията в кеша на Baidu при 8k са 5/9, в сравнение с тест с 3/9 и празни отговори при стоп: DeepSeek V4.1 Flash във Fireworks: празни отговори при стоп, 3/9 попадения в кеша


