

На 2026-11-03/04 наборът APB Full беше изпълнен с DeepSeek V4.1 Flash 1017 при пет доставчика чрез AIHubMix. За всеки доставчик бяха използвани един и същ модел, въпроси, параметри и скриптове за заявки; моделът е посочен на страницата на модела в AIHubMix, а записите за петте доставчика са на страницата с модели. Този APB профил обхваща само Alibaba Cloud: какво измерва всеки раздел и какви са резултатите.
Тази публикация представя резултати, без да класира доставчиците или да препоръчва някой от тях. Първо са Q, F, P, K и R; K е подоценка на P. Общата оценка е обобщаващ индекс, а не сертификация, и няма доверителен интервал. Правилата за оценяване са определени в AIHubMix Provider Benchmark Standard v2.0.
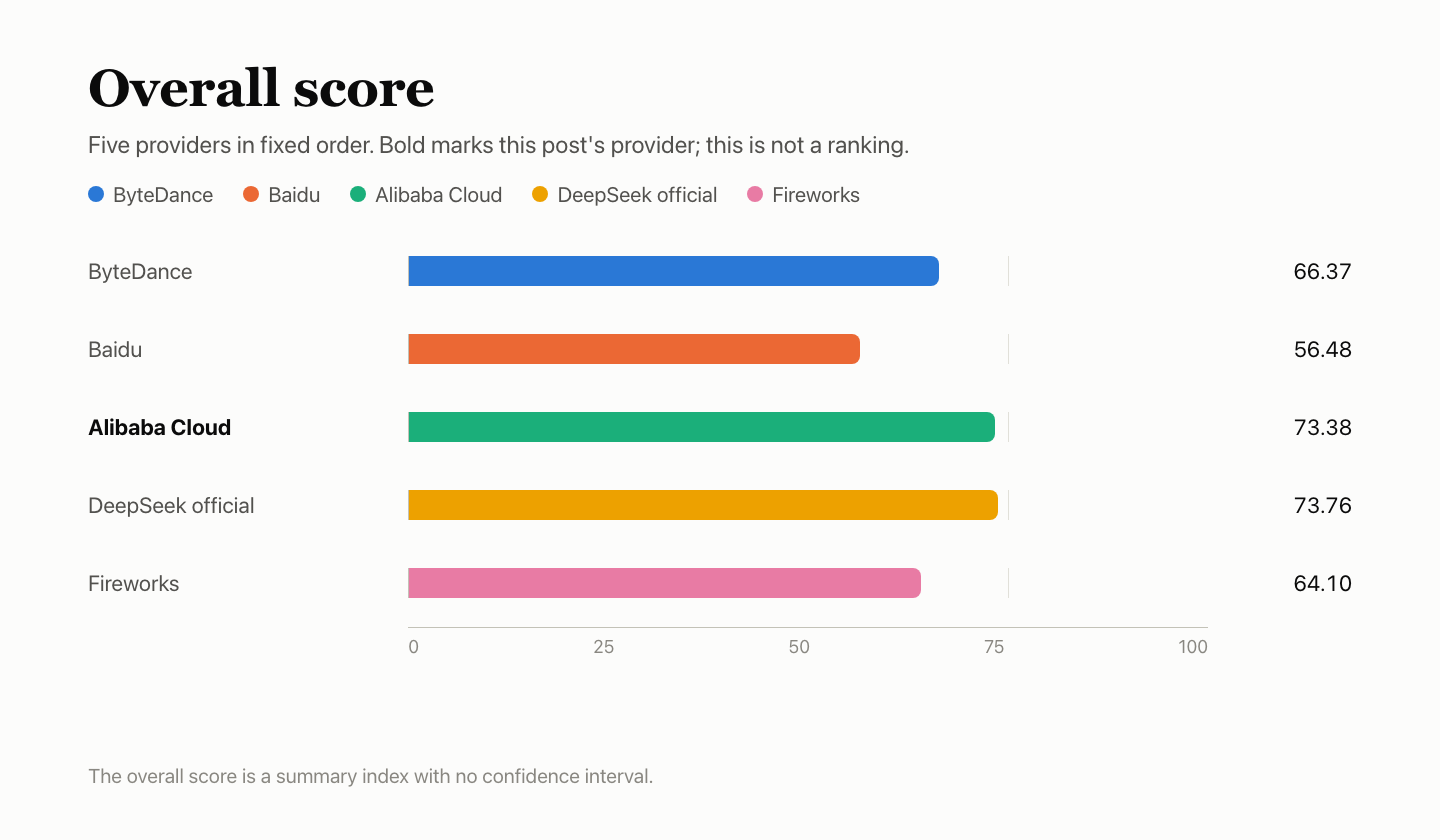
Оценки за петте доставчика
Удебеленият текст обозначава доставчика, разглеждан в тази публикация. Доставчиците са в фиксиран ред, а не в класация. K е подоценка на P с тегло 20% и е показана отделно за справка. Общата оценка е обобщаващ индекс без доверителен интервал. Разликата между официалния канал на DeepSeek и Alibaba Cloud е 0.37 точки и не е статистически различима.
Накратко
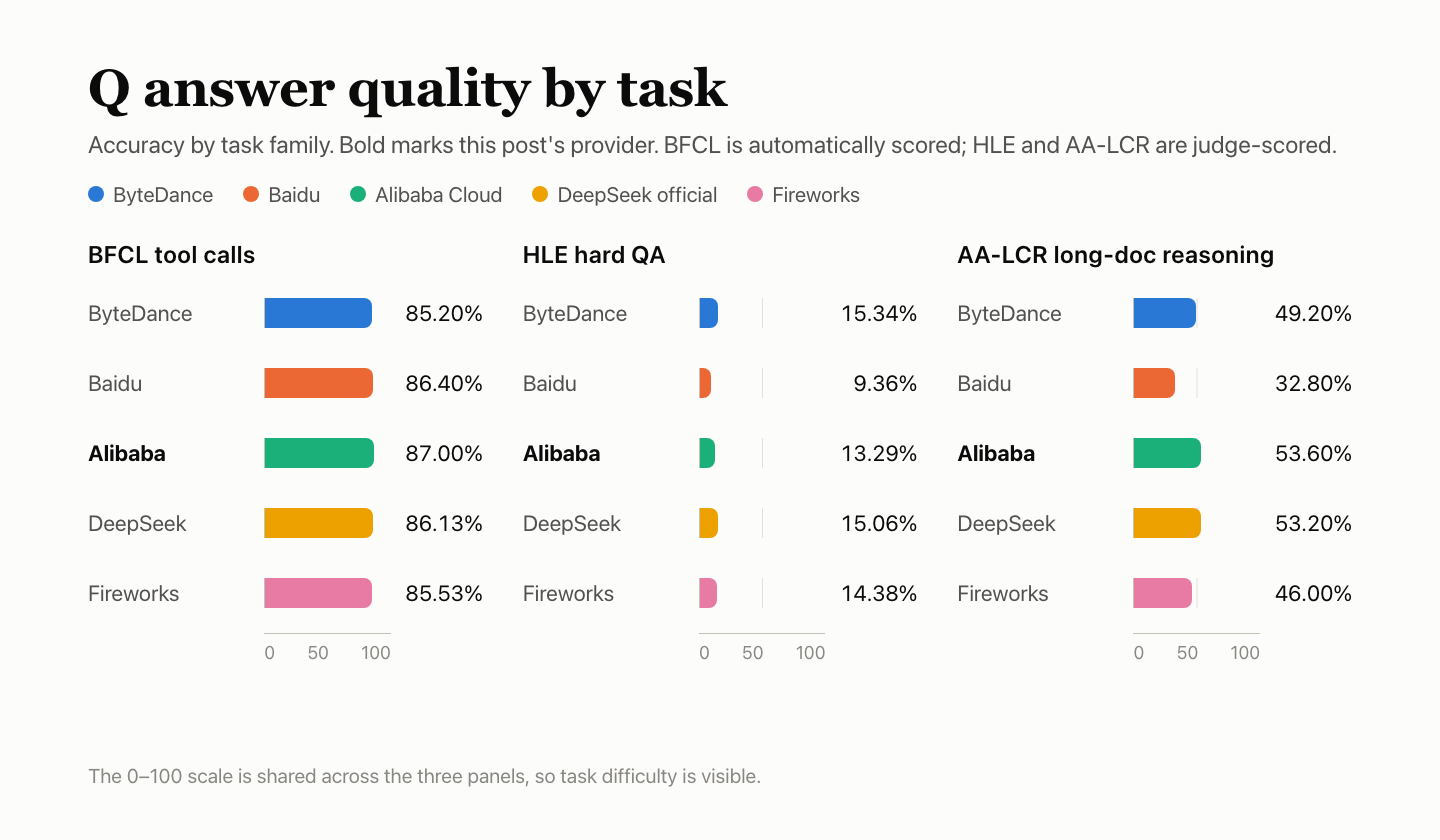
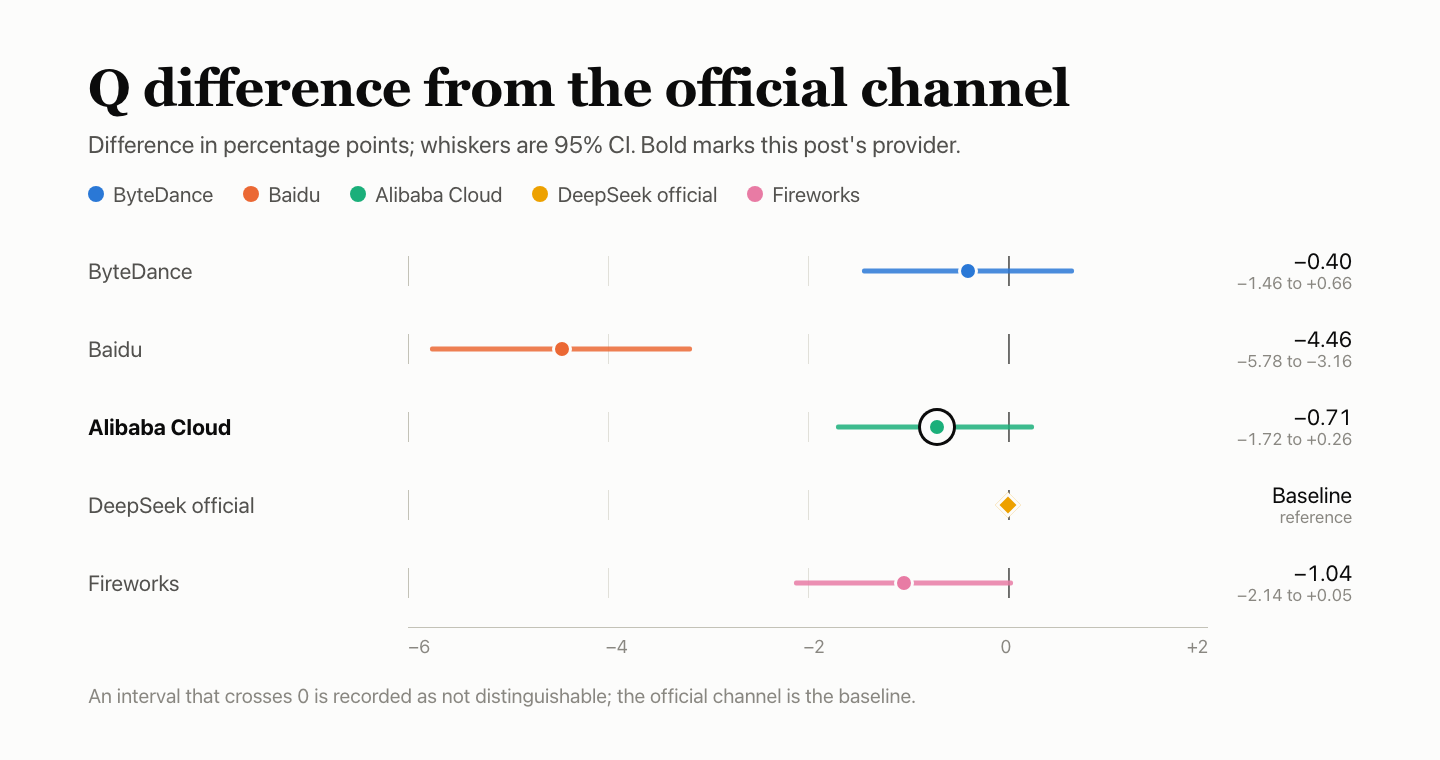
- Качество на отговорите: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. Спрямо официалния канал разликата е −0.71 процентни пункта, с 95% интервал от −1.72 до +0.26, така че резултатите на двата канала не са различими.
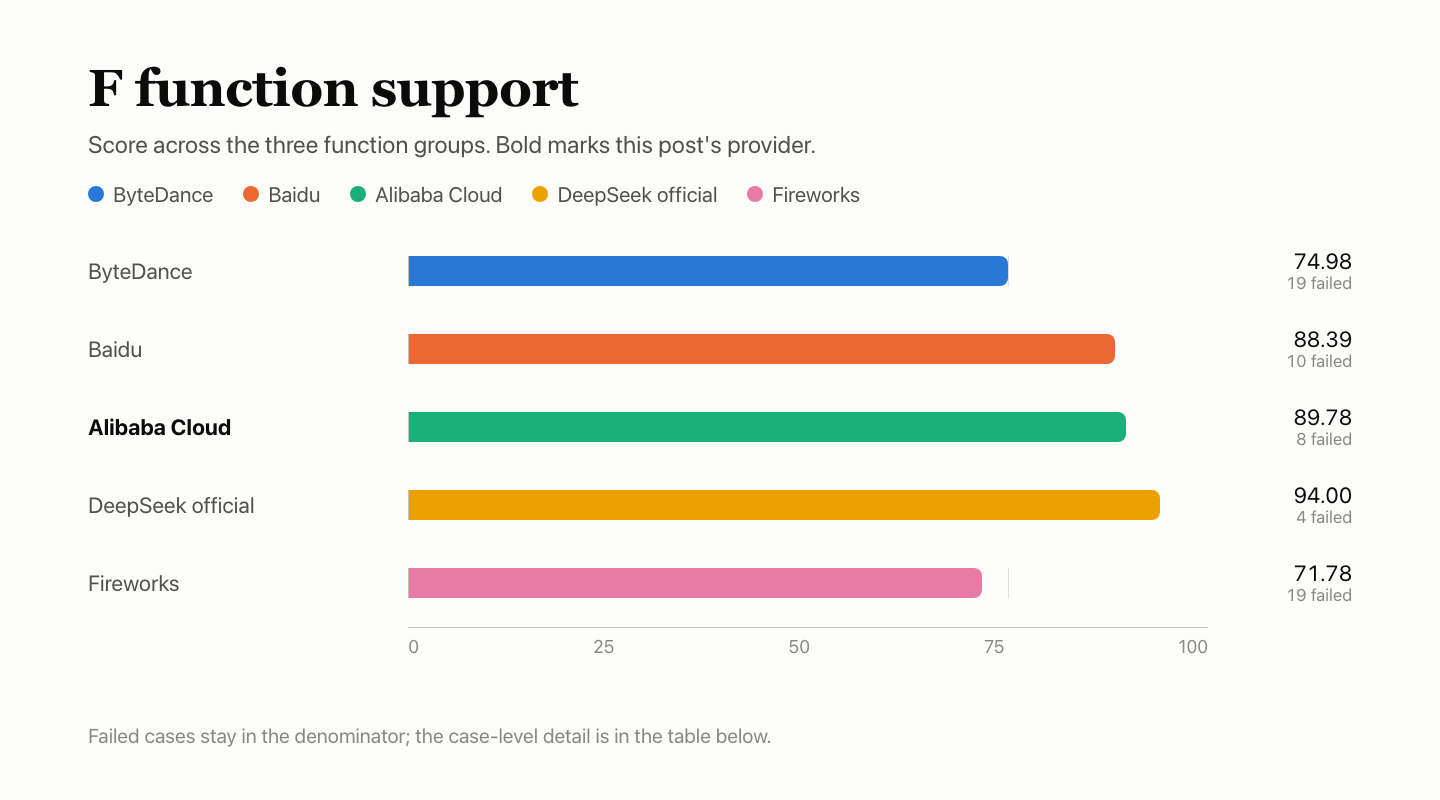
- Поддръжка на функции: F 89.78. Успешно преминаха 155 от 177-те проверки в знаменателя. Невалидна схема на инструмент върна 503 вместо грешка в параметрите, при препълване на контекста не беше върнат документираният тип грешка, а изолиран резултат от инструмент върна 200.
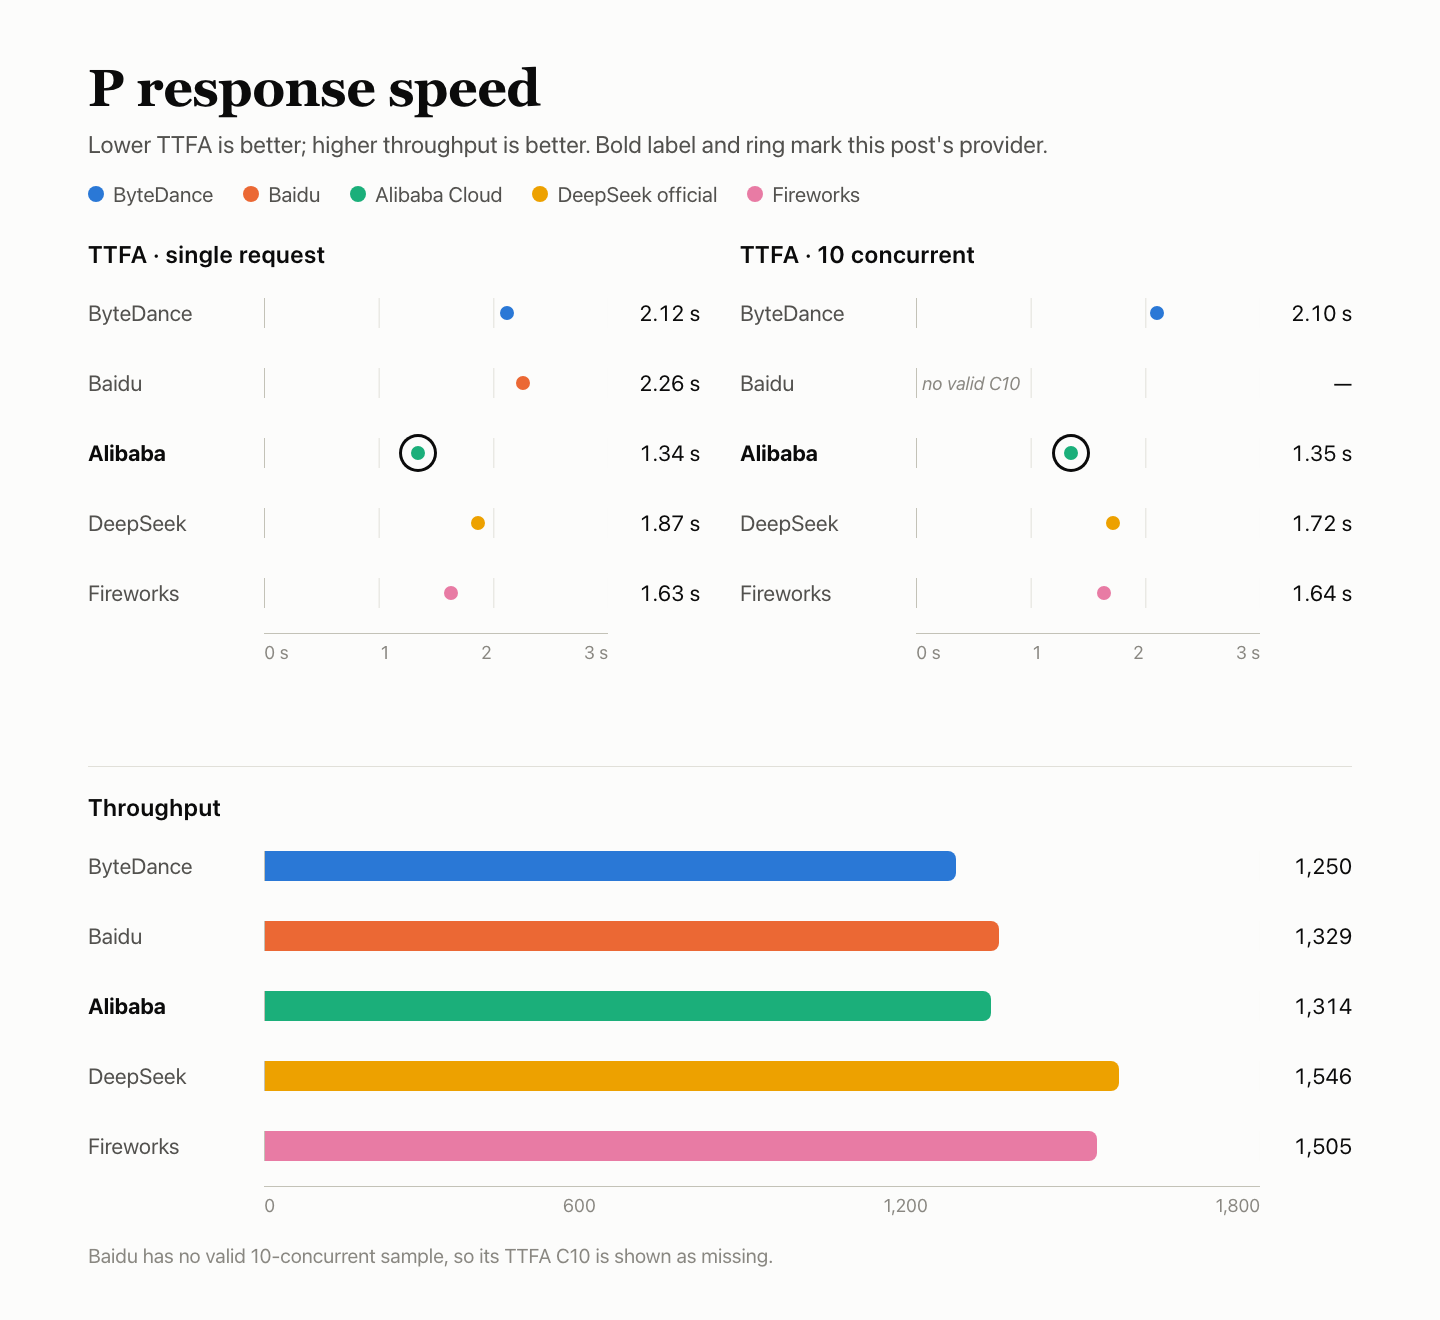
- Скорост на отговор: P 88.58. Медианата за получаване на първия токен със съдържание беше 1.34 s при едновременност 1 и 1.35 s при едновременност 10, TPOT беше 4.69 ms, а всичките 180 заявки за скорост бяха валидни.
- Кеш: K 99.37. Всичките 18 горещи заявки с префикси 8k и 32k попаднаха в кеша, а нито една контролна заявка със студен префикс не прочете кеша.
- Стабилност на услугата: R 100. И 300-те специално предназначени заявки успяха от първия опит.
Настройка на теста
Изпълнението премина през AIHubMix, като беше избран идентификаторът на модела при доставчика; маршрутът е описан в ръководството за бърз старт. На страницата с цените на DeepSeek са посочени публикуваните тарифи за модела.
| Елемент | Подробности |
|---|---|
| Модел | DeepSeek V4.1 Flash 1017 |
| Заявен идентификатор на модела | alicloud-deepseek-v4.1-flash-1017 |
| Върнато име на модела | deepseek-v4.1-flash-1017 |
| Маршрут за достъп | Чрез AIHubMix с избор на идентификатора на модела при доставчика, а не чрез свързване със собствен акаунт на доставчика |
| Параметри | Режим без разсъждение, temperature 1.0, max_tokens 16,384, изчакване 300 s, без автоматични повторни опити |
| Разсъждението е изключено | За всички заявки беше използвано reasoning_effort=none |
| Време | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Петте доставчика използваха един и същ Mac mini, мрежа и акаунт. |
| Извадки | Качество на отговорите — 4,250 изпълнения на въпроси (BFCL 500 × 3 рунда, HLE 250 × 10, AA-LCR 25 × 10); случаи за функции — 60 × 3 прозореца; скорост — 90 при едновременност 1 и 90 при едновременност 10; стабилност — 300; кеш — 30 (префикси 8k и 32k, по 3 групи за всеки) |
Q — качество на отговорите: 41.75
Качеството на отговорите беше измерено с три набора въпроси: 500 въпроса от BFCL с по 3 рунда, 250 въпроса от HLE с по 10 рунда и 25 въпроса от AA-LCR с по 10 рунда. BFCL беше оценен по автоматични правила, а HLE и AA-LCR — от модел-съдия deepseek-flash. И петте доставчика получиха едни и същи въпроси, а резултатите от трите набора бяха обединени в една оценка за точност. Десет отговора бяха изключени, тъй като въпросите не можеха да бъдат оценени, с което останаха 4,240 оценени изпълнения на въпроси.
| Задача | Въпроси | Верни | Точност | Грешки |
|---|---|---|---|---|
| Извиквания на инструменти във BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Трудни въпроси и отговори в HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Разсъждение по дълги документи в AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Общо · 95% интервал 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Грешките на услугата (неуспешни заявки или отрязан изход) остават в знаменателя и се броят за неверни; не се изключват. При Alibaba Cloud изходът за HLE достигна лимита max_tokens и беше отрязан 8 пъти.
Във BFCL на всеки въпрос се отговаря в 3 рунда; таблицата показва общия резултат от трите рунда.
| Категория във BFCL | Успешно преминали | Процент на успешно преминаване |
|---|---|---|
| simple_python: една функция, правилно извикване и аргументи | 332/360 | 92.22% |
| multiple: избор на правилната функция измежду няколко | 270/300 | 90.00% |
| parallel: няколко паралелни извиквания на една и съща функция | 273/300 | 91.00% |
| parallel_multiple: паралелни извиквания на няколко различни функции | 212/240 | 88.33% |
| irrelevance: няма подходяща функция и не трябва да се извиква нито една | 113/150 | 75.33% |
| ahm_multi_turn: верига от инструменти в три етапа | 105/150 | 70.00% |
Сравнение с останалите четири
Спрямо официалния канал: разликата в точността в процентни пунктове, като 95% интервалът е показан с мустачки; ако интервалът пресича 0, разликата се смята за незначима. Моделът-съдия deepseek-flash за HLE и AA-LCR е от същото семейство DeepSeek като тествания модел и не е калибриран, затова оценяването му може да е благосклонно.
F — поддръжка на функции: 89.78
Случаите за функции проверяват дали поведението на интерфейса следва протокола, а не дали моделът дава добри отговори. 60-те случая са разделени в шест групи, като всяка е изпълнена в три прозореца — общо 180 проверки, оценени спрямо формата, документиран от съответния доставчик. Проверките, които не са приложими, са невалидни или не са наблюдавани, се изключват от знаменателя. Alibaba Cloud премина 155 от 177-те проверки в знаменателя; претеглянето на групите дава 89.78.
Претеглената оценка се изчислява по теглата на групите, а не като обикновен брой успешни проверки от общо 177.
| Група | Тегло | Успешно преминали | Изключени | Оценка за групата |
|---|---|---|---|---|
| Поточно предаване и протокол на съобщенията | 20% | 30/30 | — | 100.00 |
| Интерфейс за инструменти | 20% | 30/30 | — | 100.00 |
| Ограничения на изхода и параметри | 20% | 30/30 | — | 100.00 |
| Контекст и състояние | 15% | 26/30 | — | 86.67 |
| Грешки и възстановяване | 15% | 18/30 | — | 60.00 |
| Отчитане на потреблението и протокол на кеша | 10% | 21/27 | 3 | 77.78 |
| Общо · претеглена оценка | — | 155/177 | 3 | 89.78 |
Брой прозорци 3/3 означава, че случаят е бил неуспешен и в трите прозореца.
| Неуспешен случай | Неуспешни прозорци | Причина |
|---|---|---|
| Препълване на контекста (контекст и състояние) | 3/3 | Върната беше грешка, но не документираната грешка за дължината на контекста |
| Грешка във формата на messages (грешки и възстановяване) | 3/3 | Върнат беше код 400 с празен текст на отговора и без структурирано описание на грешката |
| Невалидна схема на инструмент (грешки и възстановяване) | 3/3 | Трябваше да върне грешка в параметрите; върнат беше 503 |
| Изолиран резултат от инструмент (грешки и възстановяване) | 3/3 | Трябваше да върне грешка в параметрите; върнат беше 200 |
| Грешка във формата на stream_options (грешки и възстановяване) | 3/3 | Върнат беше код 400 с празен текст на отговора и без структурирано описание на грешката |
| Отчитане на токени за разсъждение (отчитане на потреблението и протокол на кеша) | 3/3 | Не беше върнат брой токени за разсъждение |
| Дефинициите на инструменти се отчитат като вход (отчитане на потреблението и протокол на кеша) | 3/3 | При наличие на дефиниции на инструменти отчетеният брой входни токени не беше по-висок, отколкото без тях |
| Изолиране на заявки (контекст и състояние) | 1/3 | Първата стъпка не отговори само с изискваното STORED, затова проверката за изолиране не можа да продължи |
Тези проверки се изключват от знаменателя и не се броят нито като успешни, нито като неуспешни.
| Статус | Случай | Брой | Причина |
|---|---|---|---|
| Неприложимо | Изричен cache_control | 3 | Предварително е регистрирано, че този интерфейс не го поддържа |
Случаите с грешка във формата на messages и грешка във формата на stream_options се провалиха при всичките пет доставчика: всеки върна 400 с празен текст на отговора, така че клиентът не получи структурирано описание на грешката. Тъй като и петте показват едно и също поведение, по-вероятно е причината да е в слоя на шлюза на AIHubMix и да изисква отделно проучване. Отчитането на токени за разсъждение също се провали при всичките пет, но по различни причини: ByteDance и Fireworks отчетоха токени за разсъждение дори при изключено разсъждение, докато останалите три не върнаха брой токени за разсъждение.
Сравнение с останалите четири
P — скорост на отговор: 88.58
Всяка заявка съдържаше около 10,000 входни токена и изискваше около 1,100 изходни токена. В три прозореца бяха изпратени по 30 заявки при едновременност 1 и 30 при едновременност 10 — общо 180. Времето до първия токен със съдържание (TTFA) се измерва за всяка валидна заявка, а в таблицата са посочени медианите. TPOT се оценява въз основа на времевите отметки на части от потока, а не чрез измерване на хардуера за всеки токен; пропускателната способност е броят валидни изходни токени при едновременност 10, разделен на общото време на изпълнение на пакета.
| Показател | Резултат |
|---|---|
| TTFA — до първия токен със съдържание | Медиана при едновременност 1: 1.34 s; медиана при едновременност 10: 1.35 s |
| Скорост на генериране TPOT | При едновременност 1: 4.63 ms/токен; при едновременност 10: 4.69 ms/токен |
| Ефективна пропускателна способност (goodput) | При едновременност 10: 1,313.6 токена/s |
| Валидни заявки | При едновременност 1: 90/90; при едновременност 10: 90/90 |
| Компонентни оценки | TTFA 59.65, TPOT 100.00, пропускателна способност 100.00; за TTFA и TPOT се взема по-ниската от двете стойности при различните нива, с тегла съответно 35% / 35% / 30%; оценка за скоростта на отговор 85.88 |
| Оценка P | Оценка за скоростта на отговор 85.88 с тегло 80%, кеш K 99.37 с тегло 20%, общо 88.58 |
Сравнение с останалите четири
И петте доставчика използваха една и съща машина, мрежа и акаунт. Трите прозореца бяха насрочени един доставчик след друг, така че периодите на събиране на данни не съвпадат напълно и не бива да се отдава прекомерно значение на малките разлики.
K — кеш: 99.37
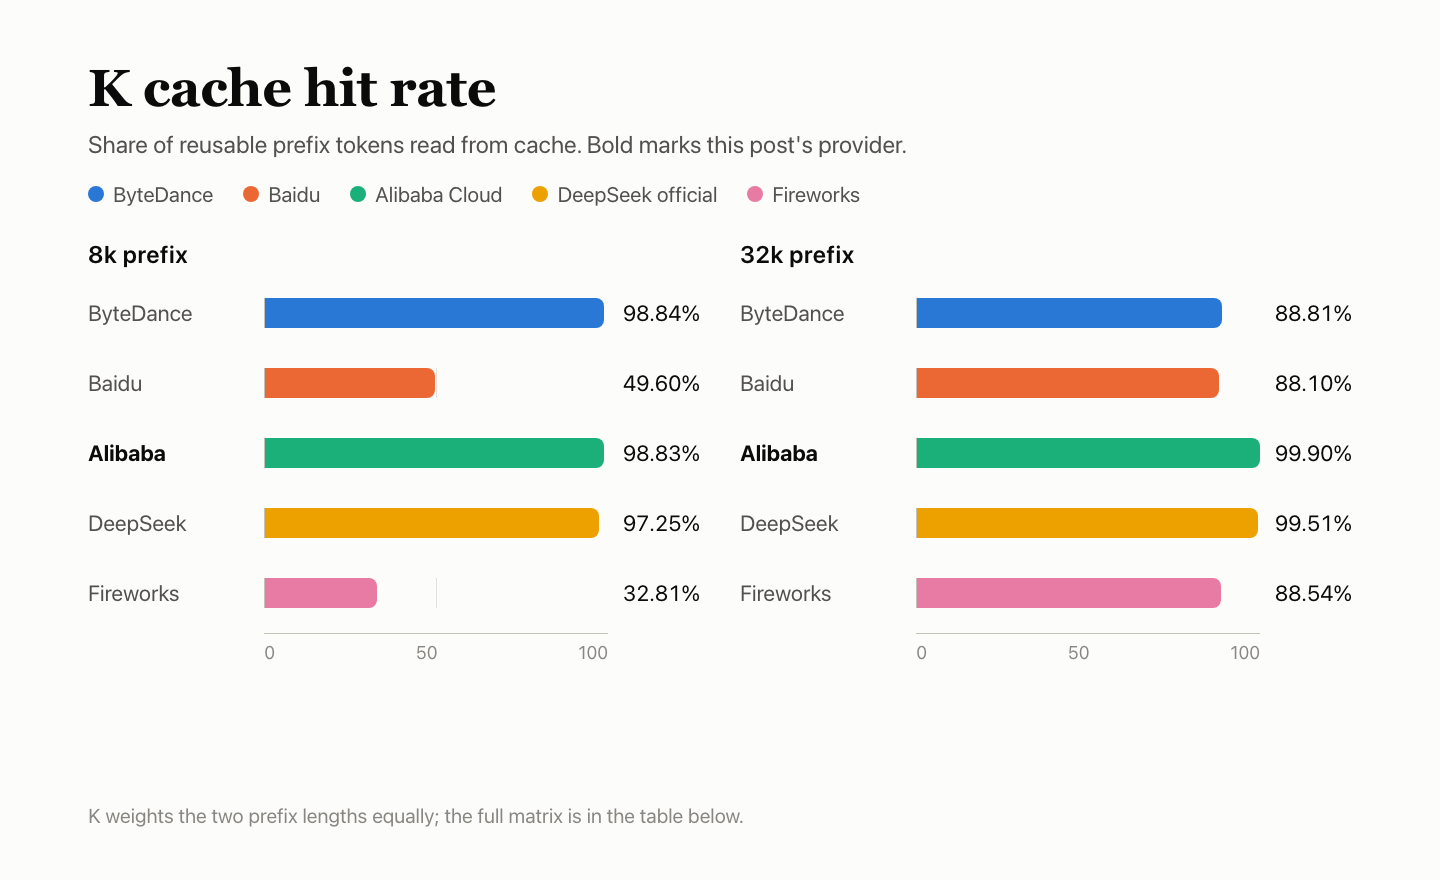
Всяка група се състои от пет заявки: първата съдържа фиксиран префикс от около 8k или 32k токена и подготвя кеша; заявки 2–4 запазват префикса и променят само въпроса в края, съответно след 5, 30 и 120 секунди; петата използва нов префикс като контролна заявка със студен кеш. Три прозореца × две дължини правят общо 30 заявки. K е отношението между прочетените от кеша токени в горещите заявки и токените, които би трябвало да могат да се използват повторно според правилото, като всяка дължина има тегло 50%; K съставлява 20% от P. Матрицата показва отчетените от сървъра прочитания на токени от кеша.
| Префикс | Прозорец | Подготовка на кеша (заявка 1) | Гореща след 5 s | Гореща след 30 s | Гореща след 120 s | Контролна със студен кеш (заявка 5) |
|---|---|---|---|---|---|---|
| 8k | Прозорец 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Прозорец 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Прозорец 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Прозорец 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Прозорец 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Прозорец 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Префикс | Попадения в кеша | Прочетени токени | Токени, които би трябвало да могат да се използват повторно | Оценка |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k и 32k, с по 50% тегло) | 99.37 |
И деветте горещи заявки с префикс 8k попаднаха в кеша и прочетоха по 7,936 токена; и деветте горещи заявки с префикс 32k попаднаха в кеша и прочетоха по 32,000 токена. Заявката за подготовка и контролната заявка не прочетоха кеша, така че горещите и студените заявки се разграничават ясно.
Сравнение с останалите четири
R — стабилност на услугата: 100
Трите прозореца включваха 300 заявки от четири типа — кратък текст, дълъг вход от 10k, извиквания на инструменти и многоходова история — изпратени при едновременност 1. Проверяваше се само първият отговор — за валидност и пълнота; точността на отговора не се оценяваше и не се правеха повторни опити. Грешките в разделите за качество на отговорите и скорост се отчитат съответно в Q и P, а не повторно в R.
| Тип заявка | Успех от първия опит |
|---|---|
| Кратък текст | 120/120 |
| Дълъг вход от 10k | 90/90 |
| Извиквания на инструменти | 60/60 |
| Многоходова история | 30/30 |
| Общо · 95% интервал 98.78%–100% | 300/300 |
И 300-те заявки върнаха валиден и пълен отговор още при първия опит. R 100 обхваща само тези 300 специално изпратени заявки и не означава, че по цялата верига не е имало откази. Долната граница на 95% интервал е 98.78%: дори при 300/300 вероятността за отказ е под 1.22%.
В сравнение с останалите четири
R обхваща само тези 300 специално изпратени заявки; отказите, свързани с качеството и скоростта на отговорите, се отчитат съответно в Q и P, а не се броят повторно в R.
| Доставчик | Успех при първия опит | 95% интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Често задавани въпроси
Значима ли е общата разлика от 0.37 между Alibaba Cloud и официалния канал?
Не. В този тест двата варианта не могат да бъдат разграничени: разликата в Q е −0.71 процентни пункта, а 95% интервалът е от −1.72 до +0.26 и включва 0. Общият резултат е обобщаващ индекс без доверителен интервал.
Какво включва резултатът Q?
Три набора: 500 въпроса BFCL × 3 рунда, оценени автоматично; HLE 250 × 10 и AA-LCR 25 × 10, оценени от съдийския модел deepseek-flash. Общата точност е 41.75% при 4,240 оценени изпълнения на въпросите.
Защо F е 89.78, след като 155 от 177 проверки са преминали?
Резултатът е претеглен по групи, а не представлява просто съотношение на преминалите проверки. Групите за грешки и възстановяване получиха 60.00, а тези за отчитане на използването и протокола за кеширане — 77.78, докато трите протоколни групи получиха 100.00.
Защо R отчита 100, ако в други секции е имало неуспешни заявки?
R обхваща само 300-те специални заявки за стабилност. Неуспешните заявки, свързани с качеството и скоростта на отговорите, се отчитат в Q и P и не се броят повторно в R.
K 99.37 процент на попаденията в кеш ли е?
Това е съотношението между кешираните токени, прочетени при заявки с вече загрят кеш, и токените, които би трябвало да могат да се използват повторно, като 8k и 32k имат еднаква тежест. Префиксът 8k получи 98.83, а префиксът 32k — 99.90.
Означава ли, че при латентност от 1.34 s до първия токен целият отговор пристига за 1.34 s?
Не. Това е времето за изчакване до първия съдържателен токен. Всяка заявка изискваше около 1,100 изходни токена, а TPOT при паралелност 10 беше 4.69 ms на токен.
Още материали: поредицата за DeepSeek V4.1 Flash
- Комбинираният резултат Q на Alibaba Cloud се различава от официалната базова стойност с 0.71 процентни пункта — разлика в интервал, който включва 0. Профилът на ByteDance продължава сравнението със същите условия и при отчитането на извикванията на инструменти: DeepSeek V4.1 Flash в ByteDance: извикванията на инструменти съвпадат, отчитането — не.
- Alibaba Cloud върна валидни резултати и за 180-те заявки за скорост; профилът на Baidu използва същия тестов набор, при който нито един наличен канал не повлия на Q и P: DeepSeek V4.1 Flash в Baidu: няма наличен канал, който да повлияе на Q и P.
- Официалният канал е базовата стойност за сравнението на качеството на отговорите в тази публикация; профилът му разглежда F 94.00 и 15 невалидни проверки при паралелност 1: DeepSeek V4.1 Flash в официалния канал: F 94.00, 15 невалидни проверки.
- Alibaba Cloud постигна 9/9 попадения при заявки с вече загрят кеш и при двете дължини на префикса; профилът на Fireworks разглежда празни отговори при спиране и 3/9 попадения в кеш при 8k: DeepSeek V4.1 Flash във Fireworks: празни отговори при спиране, 3/9 попадения в кеш.


