
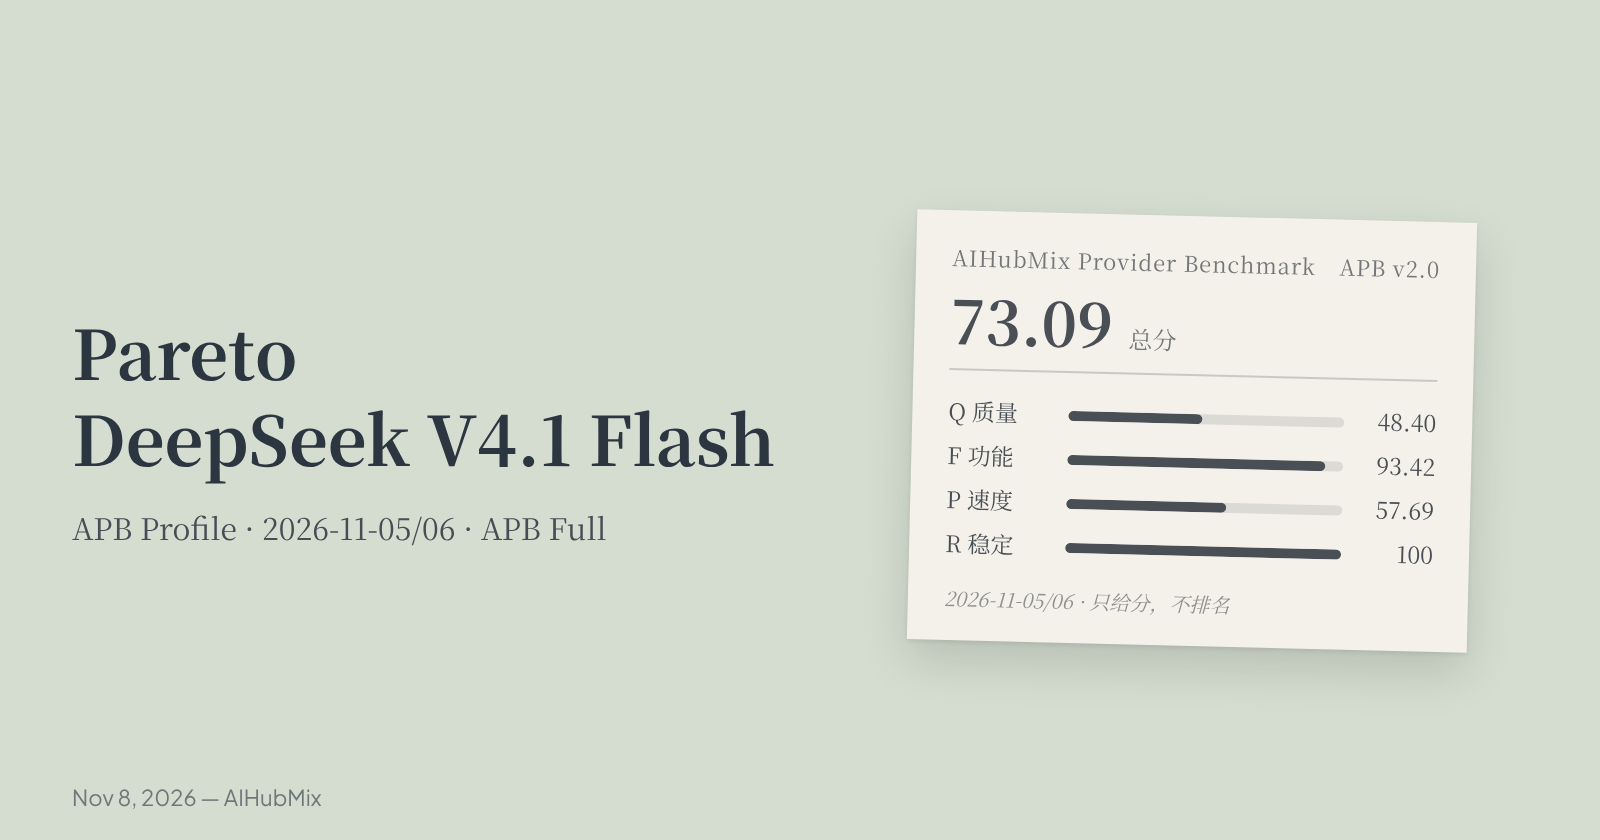
На 2026-11-05/06 DeepSeek V4.1 Flash 1017 беше тестван в пълния набор на AIHubMix Provider Benchmark (APB) през Pareto. Резултатите са Q 48.40, F 93.42, P 57.69, K 27.58 и R 100; общият индекс е 73.09. Този APB профил обхваща само Pareto. Моделът е посочен като DeepSeek V4.1 Flash 1017.
Тази публикация представя само резултати, без класация или препоръка за доставчик. Първо са Q, F, P, K и R; общият индекс е обобщена стойност без доверителен интервал. Използван е стандартът AIHubMix Provider Benchmark Standard v2.0.
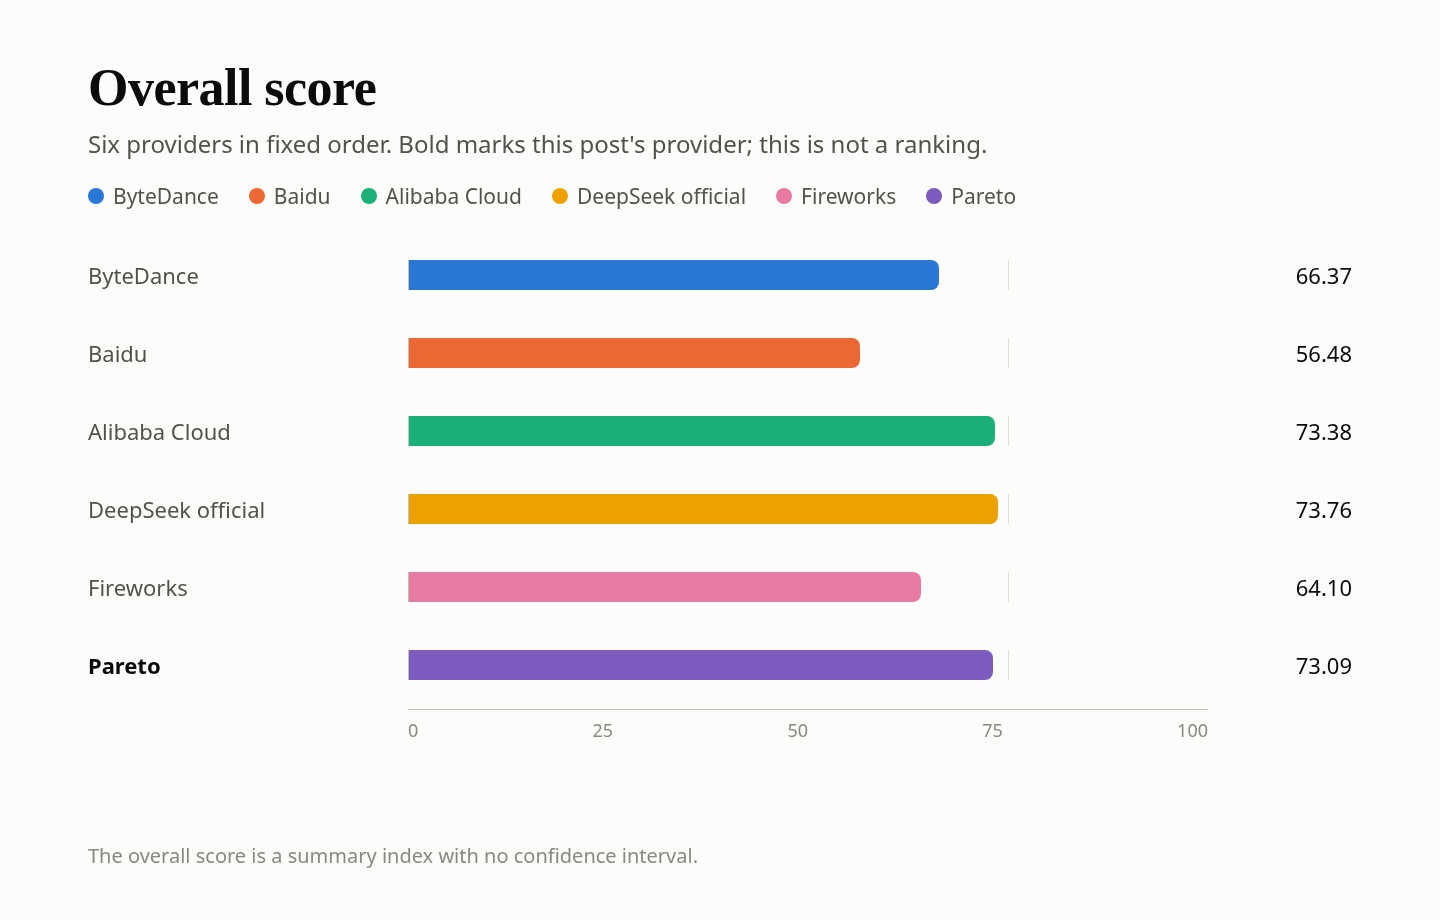
Резултати при шест доставчика
С удебелен шрифт е отбелязан доставчикът в тази публикация. Фиксиран ред на доставчиците, а не класация. K е подрезултат на P с тежест 20%. Общият индекс е обобщена стойност без доверителен интервал. Разликата между официалния канал на DeepSeek и Alibaba Cloud е 0.37 и не може да бъде разграничена статистически.
Накратко
- Q — качество на отговорите: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. Спрямо официалния канал: +5.94 процентни пункта, 95% ДИ от +3.54 до +8.36. При HLE имаше 996 неуспешни заявки, повечето отрязани, защото мисленето изчерпа бюджета за дължина на изхода; те се броят като грешни.
- F — поддръжка на функции: 93.42. Успешни бяха 29 от 33 отчетени проверки (поточно предаване 23/27, грешки 3/3, таксуване 3/3). 147 проверки не бяха включени в знаменателя. От 4-те неуспеха 3 бяха празни тела при заявки със stop sequence, а 1 текстова фикстура за поточно предаване не съвпадна точно.
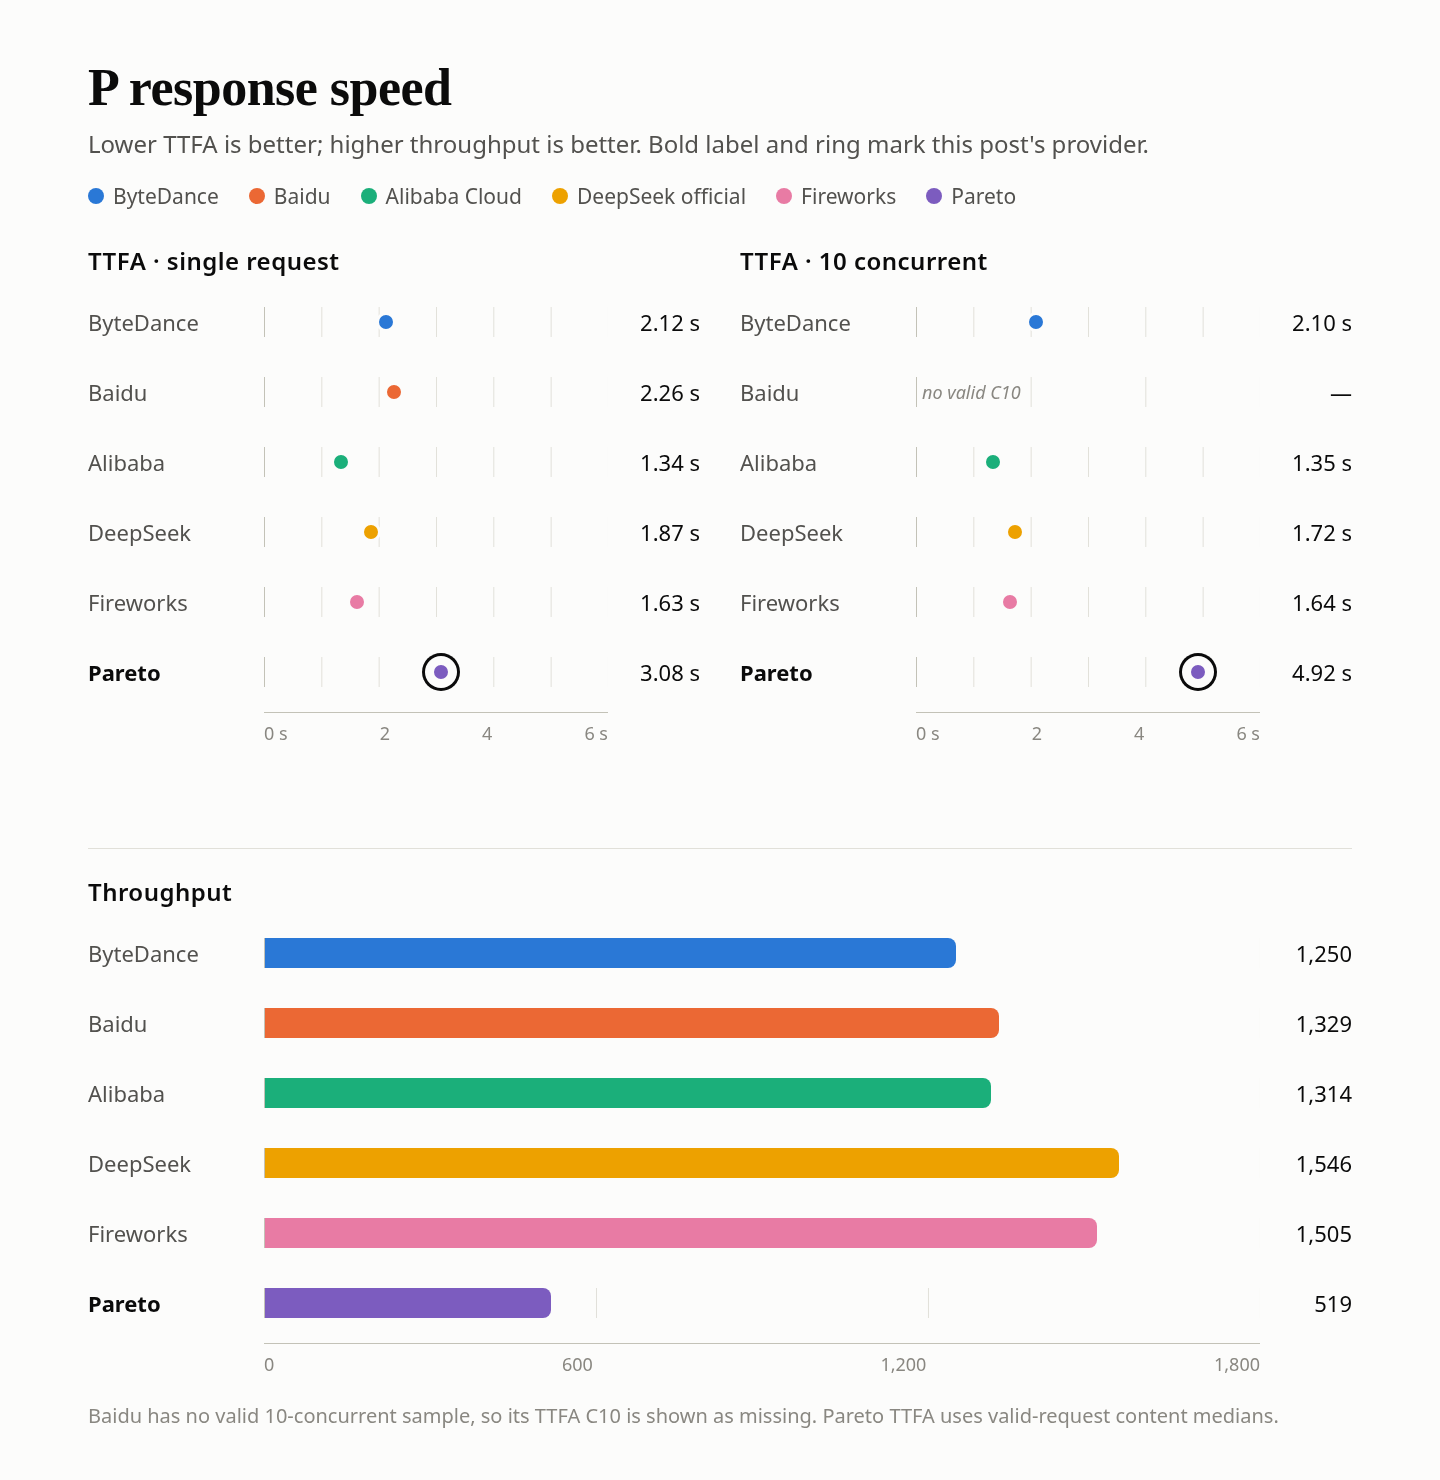
- P — скорост на отговор: 57.69. Резултат за отговора 65.22, кеш K с тежест 20%. Медианите на TTFA при валидни заявки са 3.08 s при единична конкурентност и 4.92 s при конкурентност 10; медианите за оценяване, включително невалидните заявки, са 5.85 s и 6.13 s. Валидни бяха 110 от 180 проби; 70 бяха невалидни, защото мисленето изчерпа бюджета за изход при теста на скоростта.
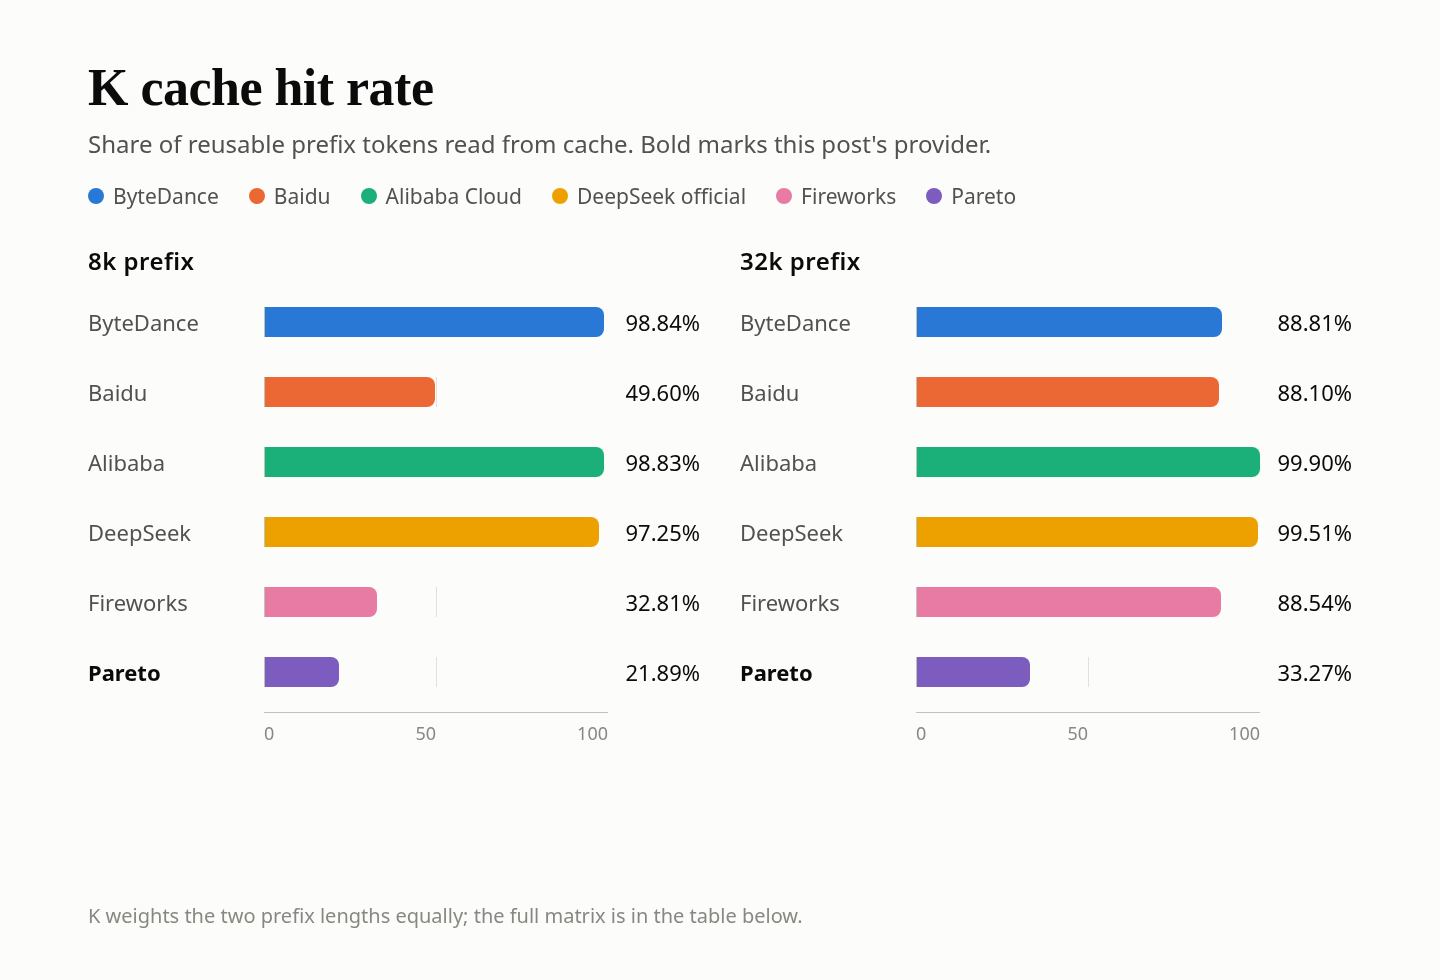
- K — кеш: 27.58. 8k hot 2/9 (прочетени 15,872 / повторно използваеми 72,504); 32k hot 3/9 (прочетени 96,000 / повторно използваеми 288,513). Оценено при конфигурацията по подразбиране.
- R — стабилност на услугата: 100. Успешни при първия опит бяха 300/300 специално изпратени заявки.
Настройка на теста
| Показател | Настройка |
|---|---|
| Модел | DeepSeek V4.1 Flash 1017 |
| Заявен идентификатор на модела | deepseek/deepseek-v4.1-flash |
| Маршрут за достъп | Pareto, с горния идентификатор на модела |
| Параметри | temperature 1.0, max_tokens 16,384, изчакване 300 s; само заявки с поточно предаване |
| Мислене | Активирано мислене с висока интензивност |
| Време | 2026-11-05/06 UTC+8; кешът е повторен тест от 2026-11-06 с конфигурацията по подразбиране |
| Извадки | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Бележки | В този тест мисленето беше с висока интензивност; при останалите пет доставчика в поредицата то не беше използвано. Поддръжката на функции се оценява върху подмножеството, което поддържа поточно предаване; за кеша се използва конфигурацията по подразбиране. |
Заявките използваха ръководството за бърз старт на AIHubMix; идентификаторите на моделите са на страницата с моделите.
Q — качество на отговорите: 48.40
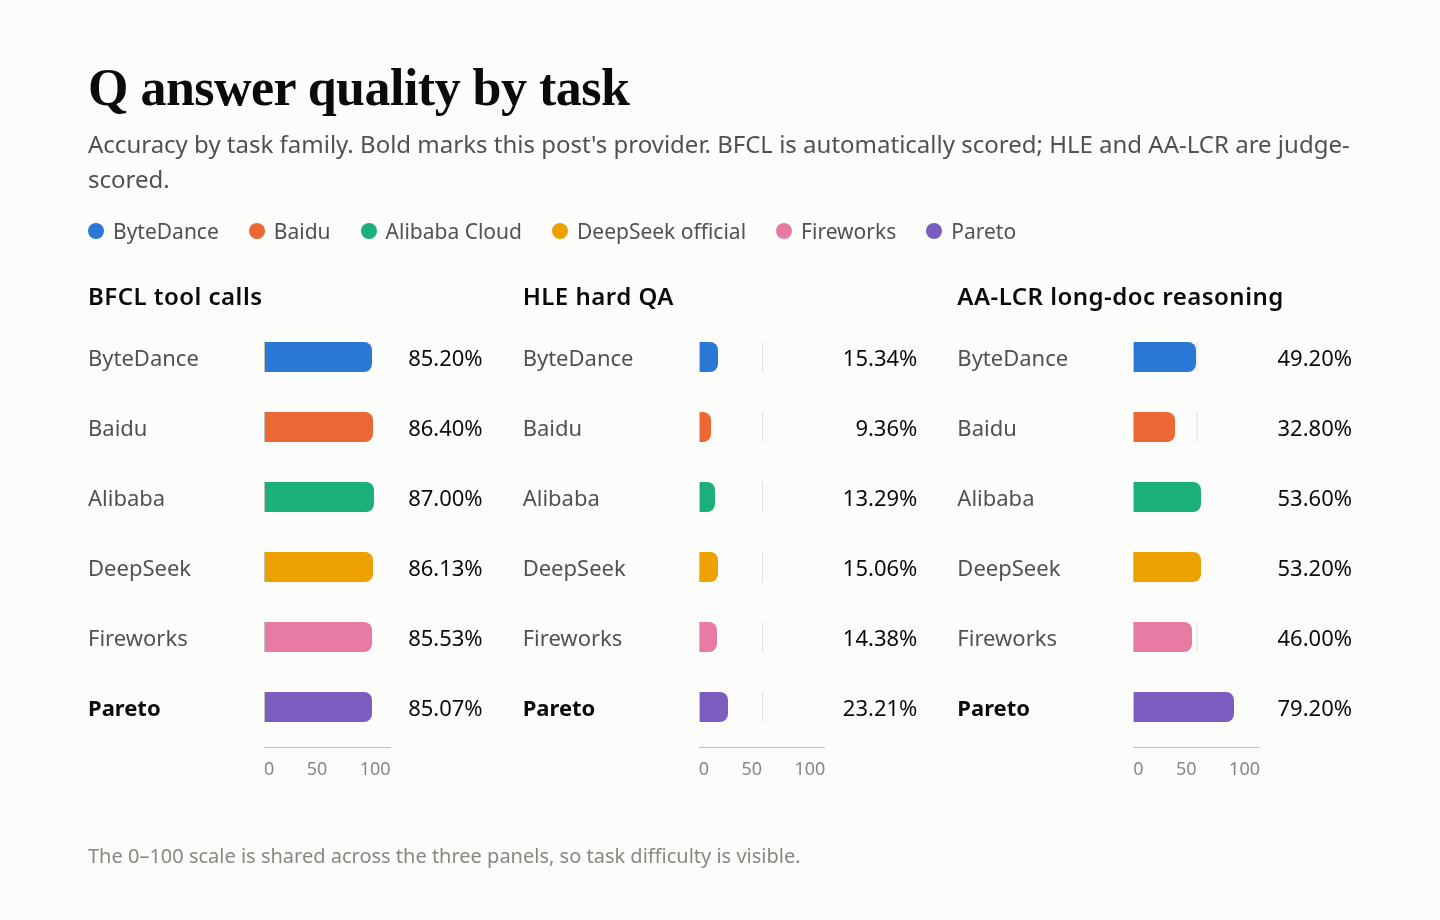
Наборът включваше 500 въпроса от BFCL × 3 рунда, 250 от HLE × 10 и 25 от AA-LCR × 10. BFCL беше оценен автоматично; HLE и AA-LCR бяха оценени от deepseek-flash. И трите групи използват същите задачи като при останалите доставчици. Десет отговора, които не можеха да бъдат оценени, бяха изключени, така че останаха 4,240 оценени опита.
| Задача | Въпроси | Верни | Точност | Неуспехи |
|---|---|---|---|---|
| Извиквания на инструменти BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| Сложни въпроси и отговори HLE | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Разсъждения по дълги документи AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Общо · 95% ДИ 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Неуспехите остават в знаменателя и се броят като грешни: 996 отговора на HLE бяха отрязани, когато мисленето изчерпа бюджета за дължина на изхода. От 1,494-те опита по HLE с пълен отговор 578 бяха верни (около 38.7%).
| Категория BFCL | Успешни | Процент на успешно преминаване |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python премина успешно при 333/360 (92.50%), multiple — при 269/300 (89.67%), ahm_multi_turn — при 102/150 (68.00%), а irrelevance — при 104/150 (69.33%).
Сравнение с останалите пет
Разлика в процентни пунктове спрямо официалния канал; 95% интервалът е показан с мустачки. Ако пресича 0, разликата не може да бъде разграничена статистически. Оценяващият deepseek-flash е от същото семейство и не е калибриран, така че може да е снизходителен.
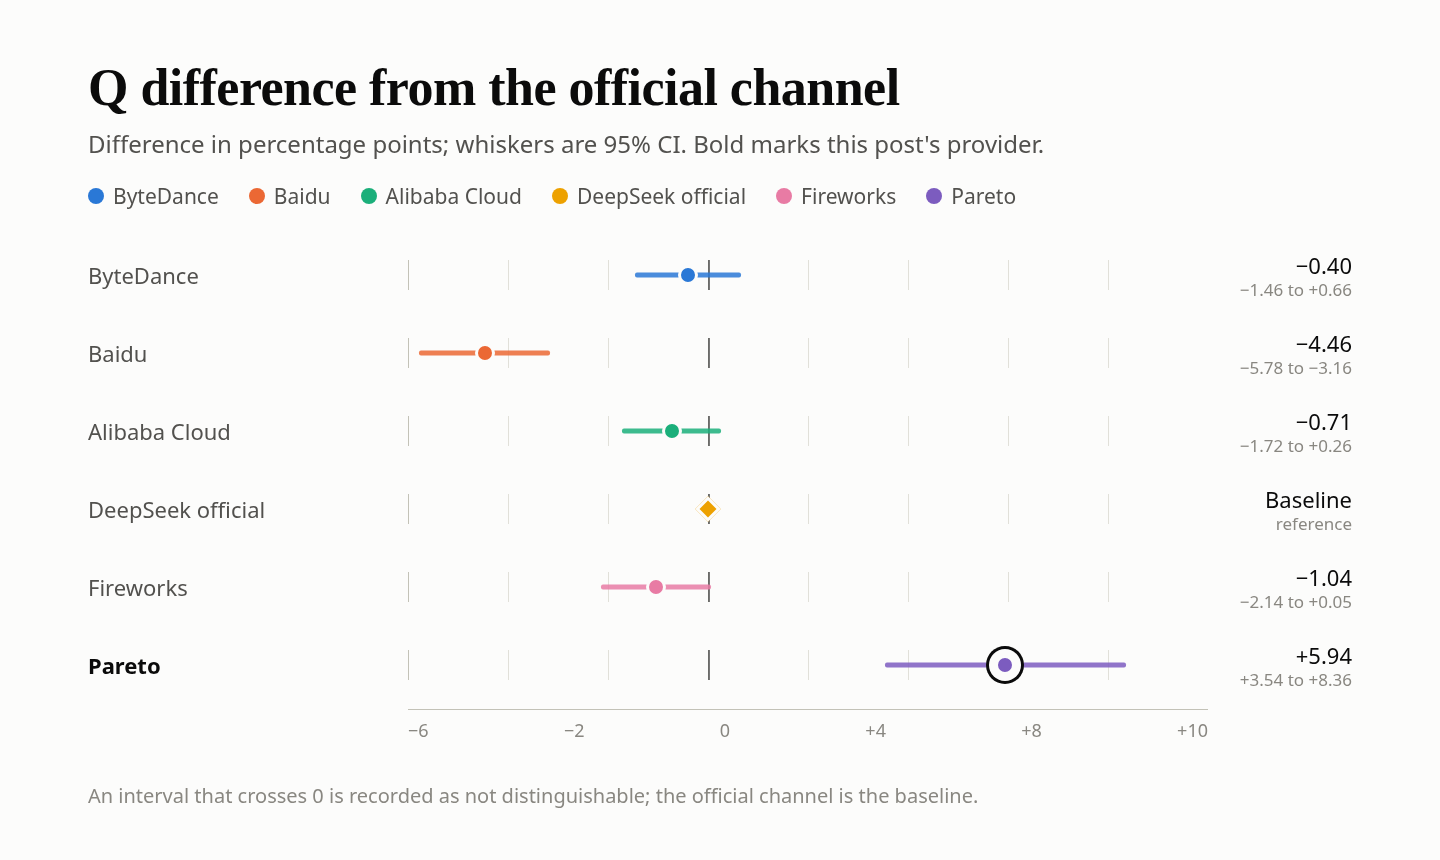
Спрямо официалния канал числената разлика е +5.94 (+3.54 до +8.36).
F — поддръжка на функции: 93.42
Отчетени бяха 33 проверки, от които 29 успешни; 147 не бяха включени. Стойността 93.42 преизчислява първоначалните тегла на групите, като ги нормализира спрямо наблюдаваните групи (поточно предаване 20%, грешки 15%, таксуване 10%; общо 45%). Обикновеният процент на успешно преминаване 29/33 е 87.88%. Инструментите, ограниченията и контекстът изобщо не бяха включени в оценяването.
| Група случаи | Тегло | Успешни | Изключени | Резултат за групата |
|---|---|---|---|---|
| Поточно предаване и съобщения | 20% | 23/27 | 3 | 85.19 |
| Интерфейс на инструментите | 20% | — | 30 | — |
| Ограничения на изхода | 20% | — | 30 | — |
| Контекст и състояние | 15% | — | 30 | — |
| Грешки и възстановяване | 15% | 3/3 | 27 | 100.00 |
| Таксуване и кеш | 10% | 3/3 | 27 | 100.00 |
| Наблюдавани / претеглени | — | 29/33 | 147 | 93.42 |
„Неуспешни прозорци“ отчита трите прозореца, в които случаят не премина успешно.
| Неуспешен случай | Неуспешни прозорци | Причина |
|---|---|---|
| Stop при поточно предаване | 3/3 | Празно тяло при stop |
| Текст при поточно предаване | 1/3 | Излишна точка в края на тялото спрямо фикстурата |
Сравнение с останалите пет
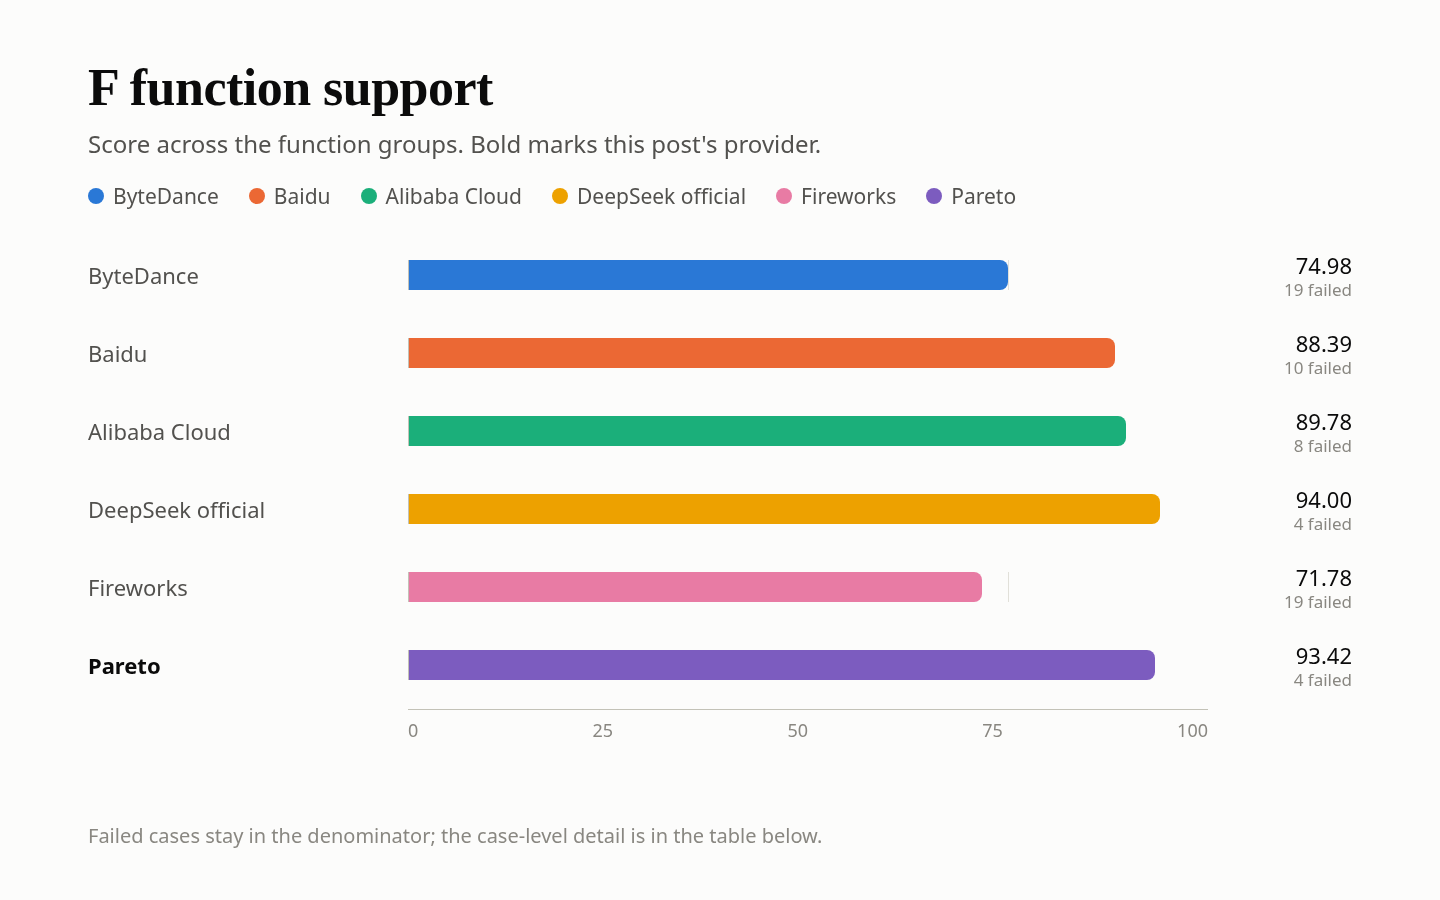
P — скорост на отговор: 57.69
Оценяването използва времето до първия токен със съдържание, а не времето до първия токен от какъвто и да е вид. Когато мисленето е включено, моделът генерира съдържание за мислене преди видимия текст на отговора, затова изчакването на съдържанието е по-дълго от изчакването на първия пакет. Във всеки от трите прозореца бяха изпратени 30 заявки при единична конкурентност и 30 при конкурентност 10, общо 180.
| Показател | Резултат |
|---|---|
| TTFA до съдържанието | Медиани за оценяване: 5.85 s (c=1) и 6.13 s (c=10); медиани при валидни заявки: 3.08 s и 4.92 s |
| Първи токен от какъвто и да е вид | Медиани при валидни заявки: 1.46 s и 1.76 s |
| TPOT | По-бавният диапазон за оценяване: 4.87 ms/токен |
| Полезна пропускателна способност | 519 токена/s при конкурентност 10 |
| Валидни | 53/90 при c=1 и 57/90 при c=10, общо 110/180; 70 невалидни, защото мисленето изчерпа бюджета за изход при теста на скоростта (около 2,048 токена) |
| Компоненти | TTFA 24.59, TPOT 100.00, полезна пропускателна способност 72.05; резултат за отговора 65.22 |
| Състав на P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Токените за мислене не се включват в числителя на полезната пропускателна способност.
K — кеш: 27.58
Обобщени данни за прочитането от повторния тест на 2026-11-06 с конфигурацията по подразбиране. Матриците на кеша за отделните заявки не са включени (суровите трасета не бяха мигрирани). Двете дължини на префикса имат еднаква тежест за K; K е 20% от P.
| Префикс | Попадения при hot | Прочетени / повторно използваеми | Сегмент |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (еднаква тежест) | 27.58 |
Проверките за студен кеш преминаха успешно — 6/6 при всяка дължина.
R — стабилност на услугата: 100
300 заявки обхванаха кратък текст, дълъг вход, извикване на инструменти и история с няколко хода при единична конкурентност. Проверени бяха единствено валидността и пълнотата на първия отговор; отговорите не бяха оценявани и нищо не беше изпращано повторно. Неуспехите от Q и P не се броят отново тук.
| Тип заявка | Успех при първия опит |
|---|---|
| Кратък текст | 120/120 |
| Дълъг вход 10k | 90/90 |
| Извикване на инструменти | 60/60 |
| История с няколко хода | 30/30 |
| Общо · 95% ДИ 98.78%–100% | 300/300 |
ЧЗВ
Какво обхваща Q 48.40?
BFCL, HLE и AA-LCR върху 4,240 оценени опита: 2,052 верни, 48.40%, 95% ДИ 45.39%–51.26%. Спрямо официалния канал числената разлика е +5.94 (+3.54 до +8.36).
Защо имаше 996 неуспешни заявки при HLE?
Повечето бяха отрязани, защото мисленето изчерпа бюджета за дължина на изхода; те остават в знаменателя и се броят като грешни.
Защо F е 93.42, след като 147 проверки са изключени?
Отчитано е само подмножеството, което поддържа поточно предаване. Теглата на групите се нормализират спрямо наблюдаваните групи; инструментите, ограниченията и контекстът изобщо не се включват в оценяването.
Защо случаите със stop се провалиха?
Заявките със stop sequence върнаха празно тяло и в трите прозореца.
Защо 70 от 180-те проби за скорост бяха невалидни?
Мисленето изчерпа бюджета за изход при теста на скоростта (около 2,048 токена).
Какво обхваща R 100?
300 специално изпратени заявки, всички валидни при първия опит; долната граница на 95% ДИ е 98.78%. Неуспехите от Q и P не се броят в R.
Продължете с поредицата за DeepSeek V4.1 Flash
- ByteDance отчете токени за мислене, след като то беше изключено: DeepSeek V4.1 Flash в ByteDance: извикванията на инструменти съвпадат, таксуването — не
- Baidu отчете Q 38.00 и P 37.77: DeepSeek V4.1 Flash в Baidu: няма наличен канал с високи резултати по Q и P
- Alibaba Cloud отчете първи токен за 1.34 s и кеш 99.37: DeepSeek V4.1 Flash в Alibaba Cloud: първи токен за 1.34s, кеш 99.37
- Официалният канал е базовата линия за Q, с F 94.00: DeepSeek V4.1 Flash в официалния канал: F 94.00, 15 невалидни проби
- Fireworks върна празни отговори при stop и 3/9 попадения в кеш при 8k: DeepSeek V4.1 Flash в Fireworks: празни отговори при stop, 3/9 попадения в кеш


