

При пълния цикъл APB от 2026-11-03/04 четирите резултата на Pareto са Q 44.58, F 93.42, P 57.69 и R 100, а общият резултат е 68.72. При топлите заявки 8k има 2 попадения от 9, а при 32k — 3 от 9.
На 2026-11-03/04 DeepSeek V4.1 Flash 1017 беше тестван при шест доставчика чрез AIHubMix с набора APB Full, като за всеки бяха използвани едни и същи въпроси, параметри и скриптове за заявки. Този профил APB обхваща само Pareto: какво измерваше всеки раздел и какви бяха резултатите.
Числата по-долу са резултати, а не класация или препоръка за доставчик. Първо са четирите резултата Q, F, P и R; общият резултат е обобщаващ индекс, а не сертификат, и няма доверителен интервал. Правилата за оценяване са определени в AIHubMix Provider Benchmark Standard v2.0.
Резултати на шестте доставчика
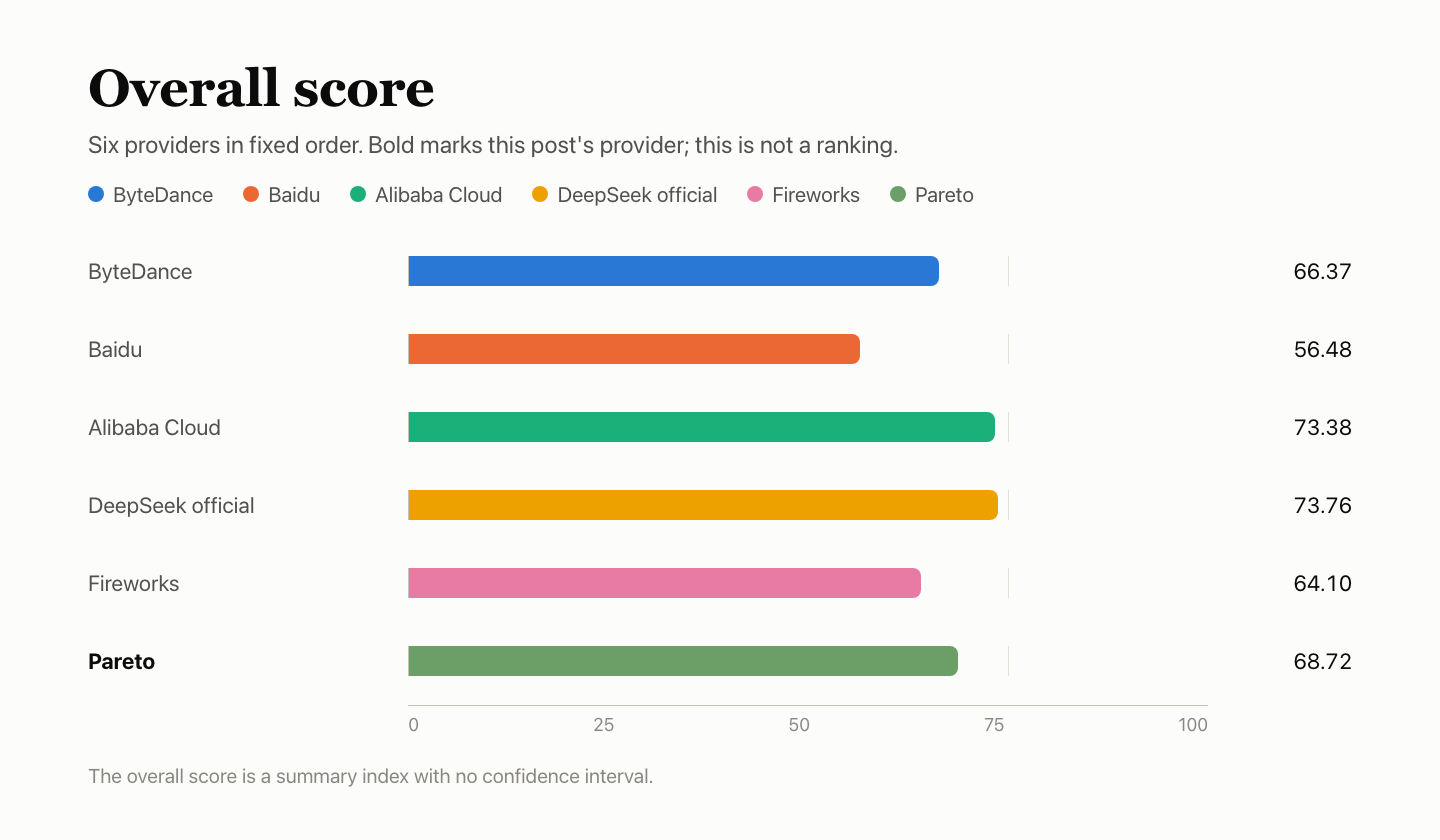
| Доставчик | Q качество | F функционалност | P скорост | K кеш | R стабилност | Общ резултат |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Официален канал на DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (тази публикация) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Доставчиците са посочени във фиксиран ред, а не като класация. K е подрезултат на P, представляващ 20% от него, и е посочен отделно за справка. Общият резултат се изчислява според правилата за съставяне на AIHubMix Provider Benchmark Standard, които отчитат и сравнението с официалния канал, и пълнотата на доказателствата; той не е пряко претеглена комбинация от четирите резултата в таблицата. Това е обобщаващ индекс без доверителен интервал. Разликата в общия резултат между официалния канал на DeepSeek и Alibaba Cloud е само 0.37, което не представлява различима разлика.
Накратко
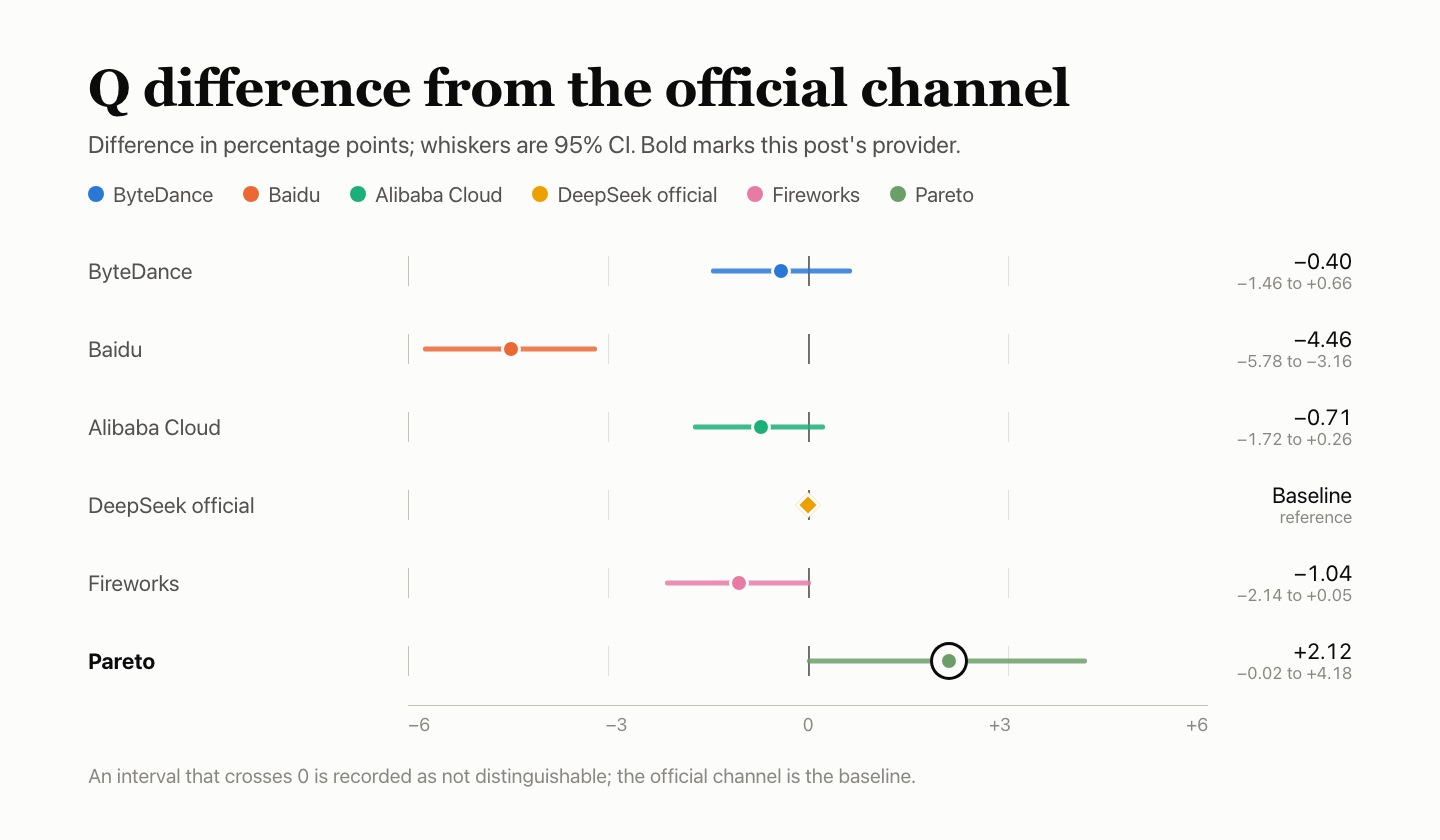
- Качество на отговорите: Q 44.58, с BFCL 85.27%, HLE 19.32% и AA-LCR 52.00%. Разликата спрямо официалния канал е +2.12 процентни пункта, с 95% интервал от −0.02 до +4.18: не е различима.
- Поддръжка на функции: F 93.42, като 29 от 33-те първоначално оценявани проверки са преминати. Извикванията на инструменти и двупосочният обмен с резултатите им, паралелните и именуваните извиквания, режимът JSON и историята на разговора имат и допълнителни успешни записи при поточно предаване; резултатите запазват първоначалните си стойности.
- Скорост на отговор: P 57.69. Медианата до първия токен в тялото е 5.85 s при единична паралелност и 6.13 s при 10 паралелни заявки, TPOT е 4.63 ms; 110 от 180-те заявки за измерване на скоростта бяха валидни.
- Кеш: K 27.58. При топлите заявки 8k има 2 попадения от 9, а при 32k — 3 от 9; нито една проверка със студени заявки не прочете кеша.
- Стабилност на услугата: R 100. Всичките 300 специално предназначени заявки бяха успешни от първия опит.
Настройка на теста
| Елемент | Подробности |
|---|---|
| Модел | DeepSeek V4.1 Flash 1017 |
| Заявен идентификатор на модела | deepseek/deepseek-v4.1-flash |
| Върнато име на модела | deepseek/deepseek-v4.1-flash |
| Маршрут за достъп | Чрез AIHubMix с идентификатор на модел, специфичен за доставчика, а не чрез пряка връзка към акаунта на доставчика |
| Параметри | Фиксиран профил на заявките APB v2, temperature 1.0, max_tokens 16,384, изчакване 300 s, без автоматично повторение |
| Период | 2026-11-03 18:07 – 11-04 16:33; заявки за кеша: 11-05 19:31 – 11-06 10:35; всички часове са UTC+8. И шестте доставчика използваха един и същ Mac mini, една мрежа и един акаунт. |
| Извадки | Q 4,250 екземпляра на въпроси; F 180 проверки; P 180 заявки; R 300; K 30 |
Заявките използваха маршрута AIHubMix за бърз старт с идентификатор на модел, специфичен за доставчика; идентификаторите на останалите доставчици са посочени на страницата с модели. Параметрите на самия модел са описани в документацията на API на DeepSeek.
Q — качество на отговорите: 44.58
Качеството на отговорите се оценява с три набора: 500 въпроса BFCL, на всеки от които е отговорено по 3 пъти; 250 въпроса HLE, на всеки от които е отговорено по 10 пъти; и 25 въпроса AA-LCR, на всеки от които е отговорено по 10 пъти. BFCL се оценява по автоматични правила; за HLE и AA-LCR съдийският модел deepseek-flash определя дали отговорът е верен или грешен. И шестте доставчика получиха едни и същи въпроси, а резултатите от трите набора бяха обединени в една точност. Десет отговора бяха изключени, тъй като въпросът не можеше да бъде оценен, така че останаха 4,240 оценени екземпляра на въпроси.
| Набор | Въпроси × повторения | Верни | Точност | Откази на услугата |
|---|---|---|---|---|
| Извиквания на инструменти BFCL, оценявани автоматично | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE — трудни въпроси и отговори, оценявани от съдийски модел | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR — разсъждения по дълги документи, оценявани от съдийски модел | 25 × 10 | 130/250 | 52.00% | 0 |
| Общо · 95% интервал 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
За всеки екземпляр на въпрос беше получен пълен отговор; откази на услугата нямаше.
| Категория BFCL | Преминати | Дял на преминаване |
|---|---|---|
| simple_python: една функция, правилно извикване и аргументи | 333/360 | 92.50% |
| multiple: избор на правилната функция измежду няколко | 269/300 | 89.67% |
| parallel: няколко едновременни извиквания на една функция | 265/300 | 88.33% |
| parallel_multiple: едновременни извиквания на няколко функции | 203/240 | 84.58% |
| irrelevance: няма подходяща функция, затова не се прави извикване | 109/150 | 72.67% |
| ahm_multi_turn: верига от инструменти в три етапа | 100/150 | 66.67% |
На всеки въпрос BFCL беше отговорено по 3 пъти; таблицата обобщава и трите повторения.
Сравнение с останалите пет
| Доставчик | BFCL | HLE | AA-LCR | Комбинирано | Спрямо официалния |
|---|---|---|---|---|---|
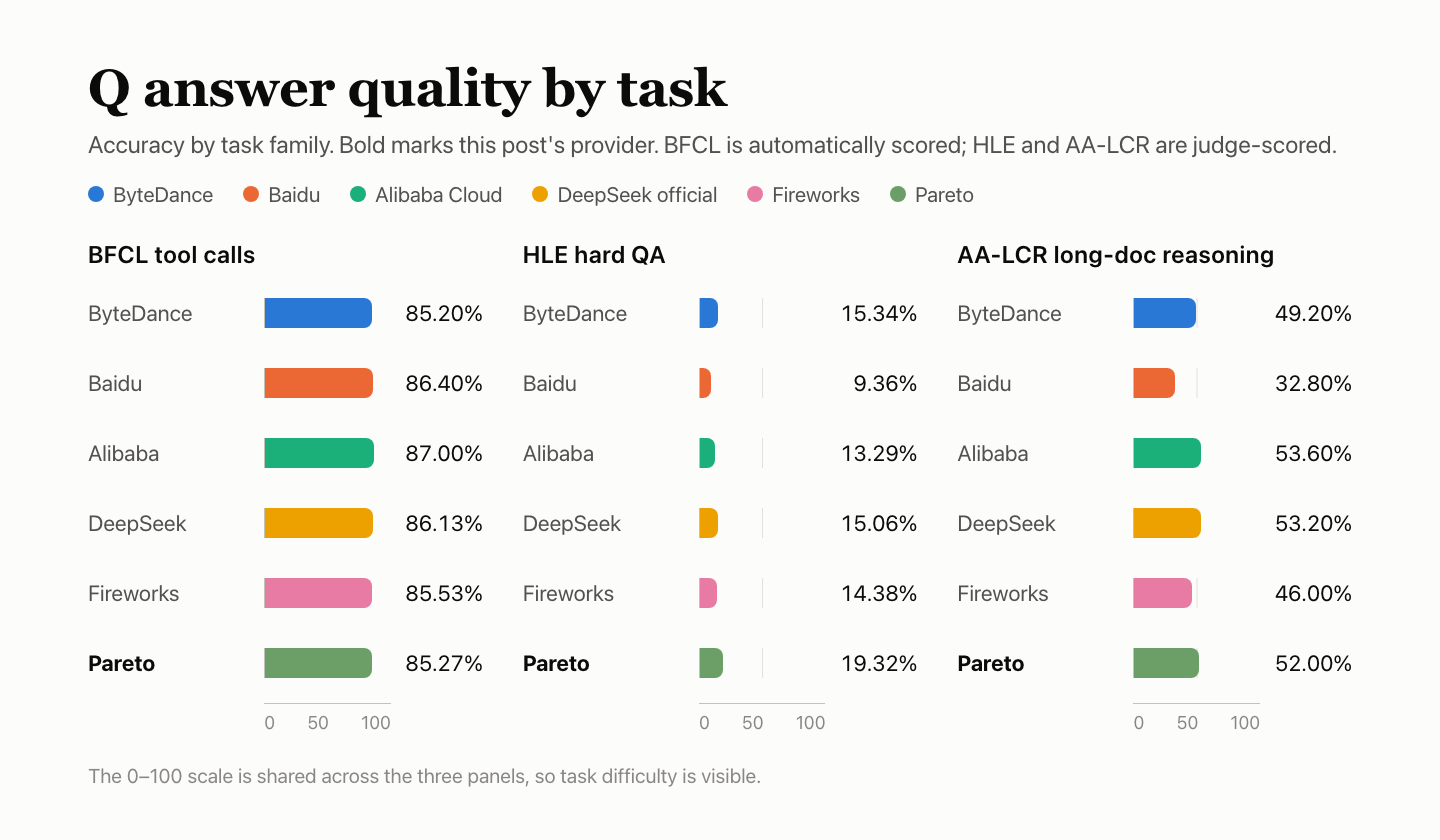
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 до +0.66), не е различима |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 до −3.16), под официалния |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 до +0.26), не е различима |
| Официален канал на DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Базова стойност |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 до +0.05), не е различима |
| Pareto (тази публикация) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 до +4.18), не е различима |
Спрямо официалния: разликата в точността в процентни пунктове, с 95% интервала в скоби; ако интервалът обхваща 0, резултатът се отбелязва като неразличим. Съдийският модел за HLE и AA-LCR, deepseek-flash, принадлежи към същото семейство DeepSeek като тествания модел и не е калибриран, затова оценките му може да са снизходителни.
F — поддръжка на функции: 93.42
Проверките на функциите установяват дали поведението на интерфейса съответства на протокола. F 93.42 се основава на 33-те отчетени проверки (29 преминати), след пренормализиране на наблюдаваните тегла на групите; останалите 147 планирани места за проверки в първоначалния набор бяха изключени от оценяването.
| Група случаи | Тегло | Преминати / наблюдения при поточно предаване | Изключени | Резултат за групата |
|---|---|---|---|---|
| Поточно предаване и протокол на съобщенията | 20% | 23/27 | 3 | 85.19 |
| Интерфейс на инструмент Извиквания на инструменти, двупосочен обмен с резултатите им, паралелни и именувани извиквания | 20% | Наблюдавани успешни проверки при поточно предаване* | 30 | — |
| Ограничения на изхода и параметри Режим JSON и изключено мислене | 20% | Наблюдавани успешни проверки при поточно предаване* | 30 | — |
| Контекст и състояние История на разговора и системни инструкции | 15% | Наблюдавани успешни проверки при поточно предаване* | 30 | — |
| Грешки и възстановяване | 15% | 3/3 | 27 | 100.00 |
| Протокол за измерване и кеш | 10% | 3/3 | 27 | 100.00 |
| Общо · претеглен резултат | 29/33 | 147 | 93.42 | |
- За изброените функции има записи за успешна работа при поточно предаване; това не означава пълен брой точки за цялата група. В оценяването не се добавят проверки. F 93.42 и общият резултат 68.72 запазват първоначалните си стойности.
| Неуспешен случай | Прозорци | Причина |
|---|---|---|
| Последователност за спиране при поточно предаване Поточно предаване и протокол на съобщенията | 3/3 | Празно тяло с последователност за спиране; същият вход без последователност за спиране работеше |
| Точен текстов изход Поточно предаване и протокол на съобщенията | 1/3 | Допълнителната точка в края наруши съвпадението с точния текст |
„Прозорци“ показва в колко от 3-те прозореца проверката е била неуспешна.
При случаите с невалидни съобщения и невалидни опции за потока няколко доставчика върнаха 400 с празно тяло на отговора. Отчитането на токените за разсъждение се различаваше при отделните доставчици.
Сравнение с останалите пет
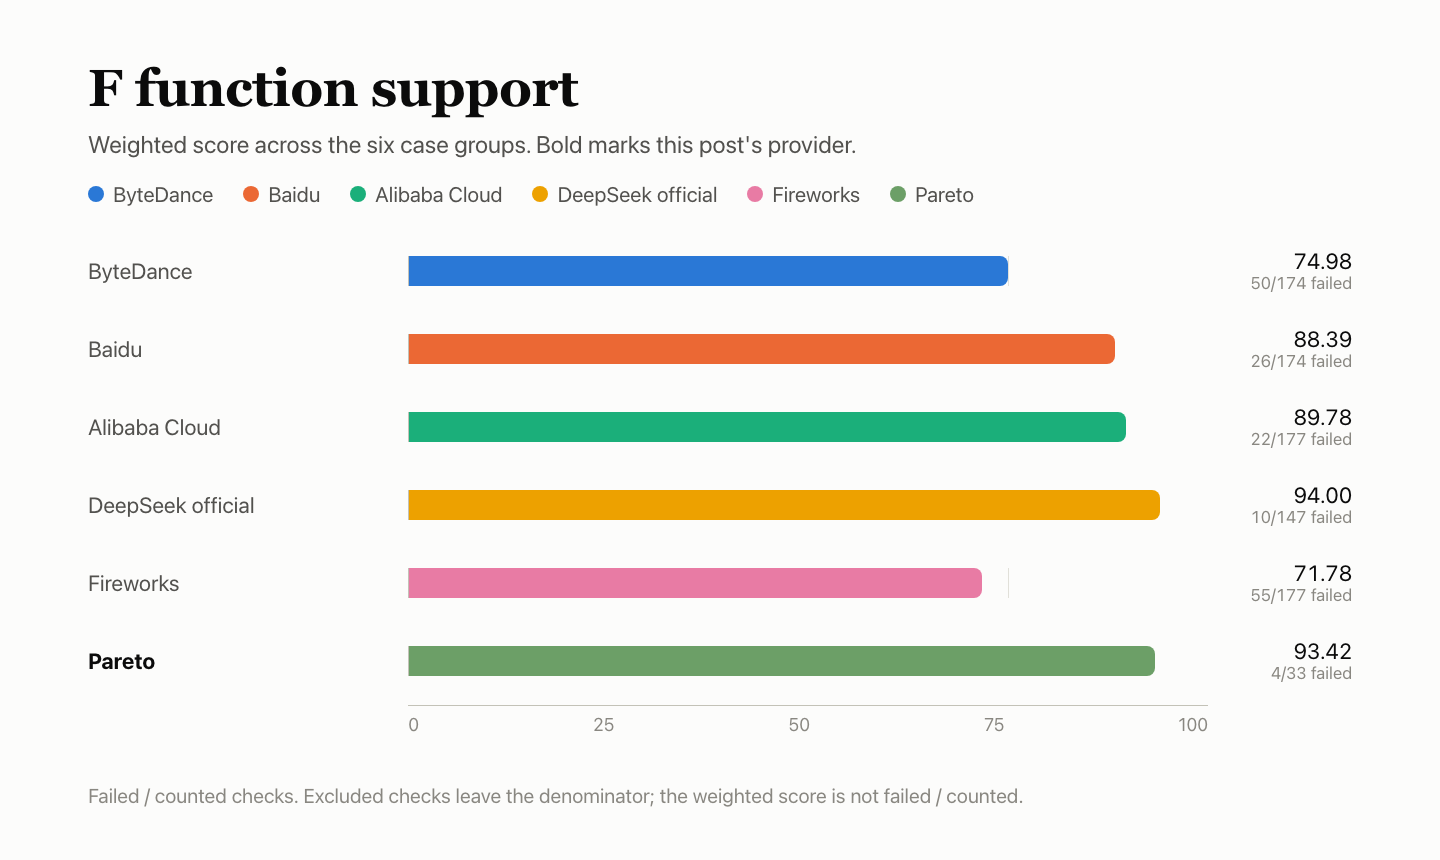
| Доставчик | Преминати | Неуспешни | Изключени | Претеглен резултат |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Официален канал на DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (тази публикация) | 29 | 4 | 147 | 93.42 |
P — скорост на отговор: 57.69
Всяка заявка съдържаше около 10,000 входни токена и изискваше около 1,100 изходни токена текст в тялото. Във всеки от трите прозореца бяха изпратени 30 заявки при единична паралелност и 30 при паралелност 10: общо 180 заявки.
| Елемент | Подробности |
|---|---|
| Първи токен в тялото (TTFA) | Медиана 5.85 s при единична паралелност (3.08 s само за валидните), 6.13 s при паралелност 10 (4.92 s само за валидните) |
| Скорост на генериране (TPOT) | 4.42 ms/токен при единична паралелност, 4.63 ms/токен при паралелност 10 |
| Ефективна пропускателна способност | 519.4 токена/s при паралелност 10 |
| Валидни заявки | 53/90 при единична паралелност (прозорци 1–3: 15/30, 18/30, 20/30), 57/90 при паралелност 10 (23/30, 16/30, 18/30); невалидни: 70 върнаха 200 с None |
| Подрезултати | TTFA 24.59, TPOT 100.00, пропускателна способност 72.05; TTFA и TPOT са оценени по по-ниската скала, с тегла съответно 35% / 35% / 30%: резултат за скоростта на отговор 65.22 |
| Резултат P | Резултат за скоростта на отговор 65.22 × 80% + кеш K 27.58 × 20% = 57.69 |
Невалидните заявки се оценяват като безкрайни, затова медианите в таблицата може да са по-високи от медианите само за валидните заявки. TPOT се изчислява от парчетата на потока, а не се измерва за всеки токен на хардуера. Пропускателната способност е броят валидни изходни токени при паралелност 10, разделен на продължителността на пакета по часовник.
Сравнение с останалите пет
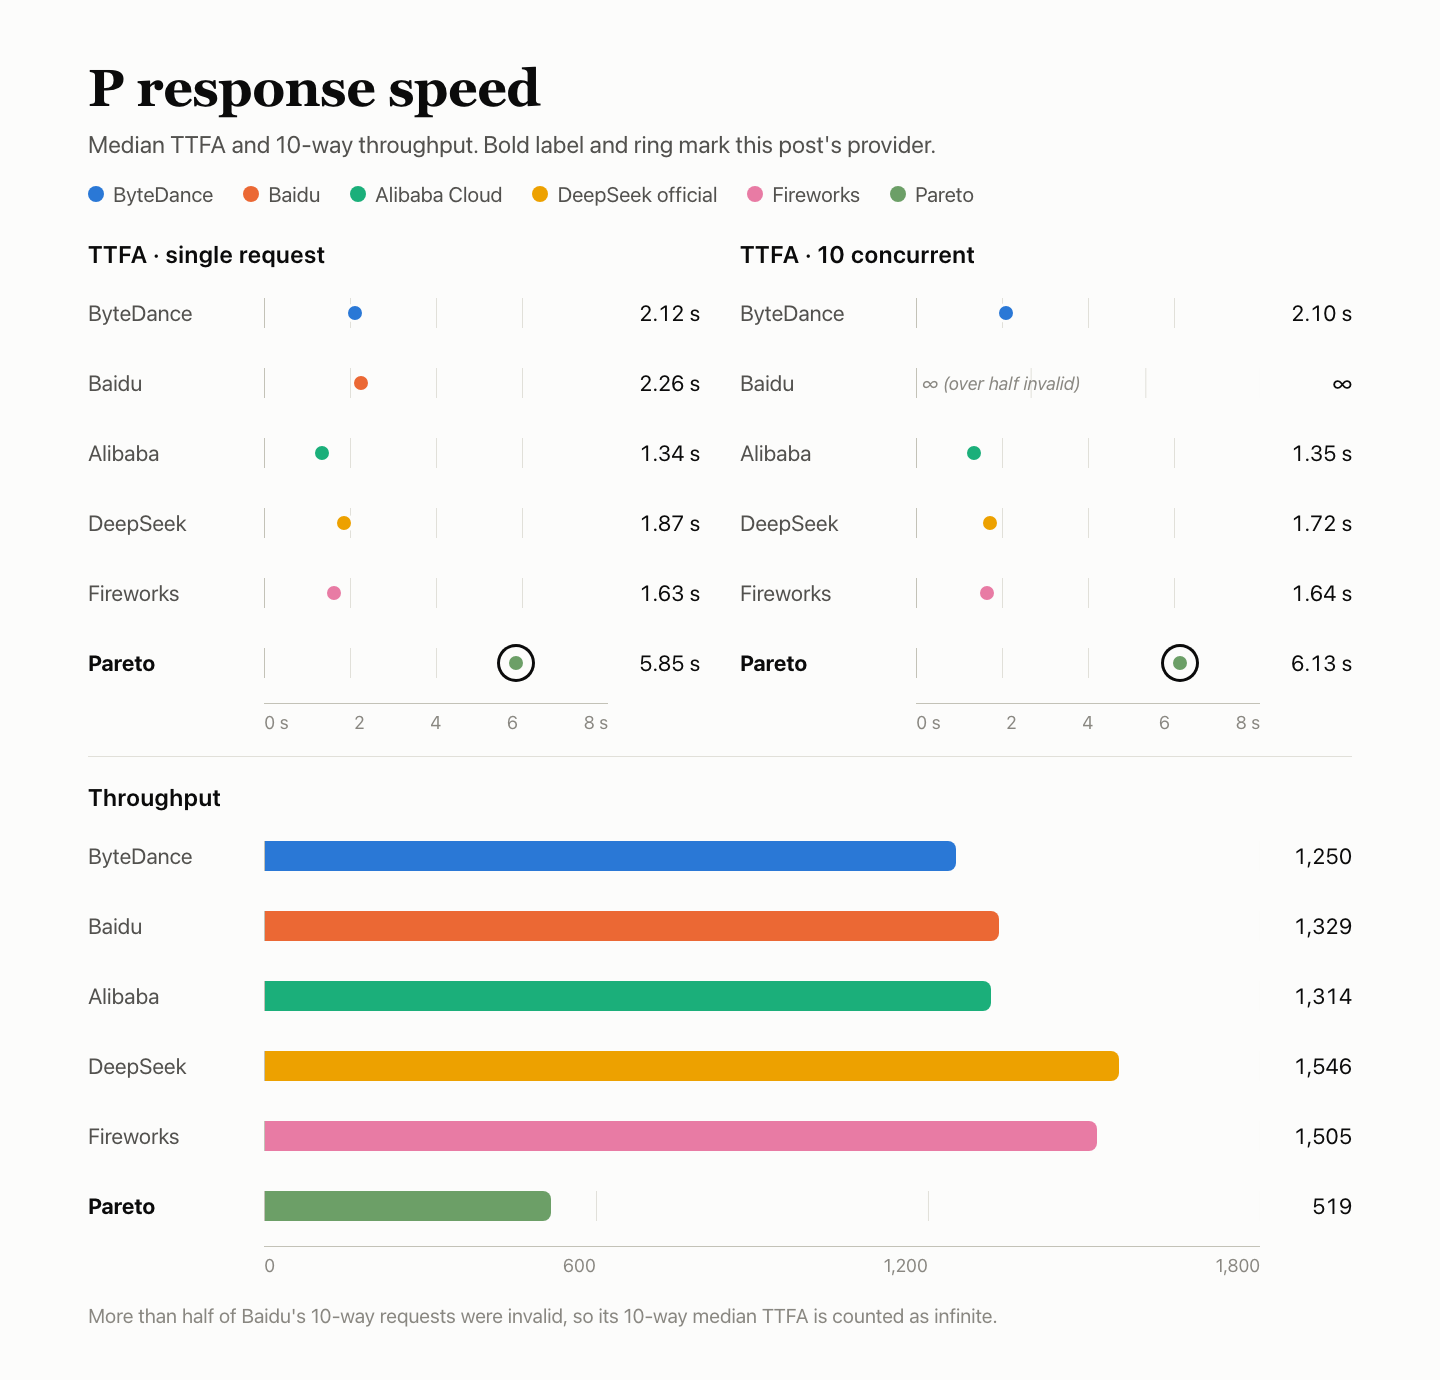
| Доставчик | Валидни заявки | TTFA при единична паралелност | TTFA при паралелност 10 | TPOT (по-бавно) | Пропускателна способност ток/с | Отговор |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Официален канал на DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (тази публикация) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
И шестте споделяха една и съща машина, мрежа и акаунт. Трите прозореца бяха планирани по доставчик, затова периодите на събиране не се припокриват напълно; не бива да се преувеличава значението на малките разлики. ∞ означава, че повече от половината заявки са невалидни, затова медианата се приема за безкрайна.
K — кеш: 27.58
Всяка група изпраща пет заявки. Първата съдържа фиксиран префикс от около 8k или 32k токена и зарежда кеша. При заявки 2–4 префиксът остава същият, а се променя само последният въпрос; интервалите са 5 s, 30 s и 120 s. Петата използва нов префикс като контролна заявка без кеш. Трите прозореца × двете дължини правят общо 30 заявки. K представлява броя токени от кеша, прочетени от заявките с горещ кеш, разделен на броя токени, които според правилата е трябвало да могат да се използват повторно; двете дължини имат еднаква тежест. K е 20% от P.
| Прозорец | 1 · зареждане | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · без кеш |
|---|---|---|---|---|---|
| Префикс 8k · попадения при горещите заявки 2/9 · прочетени са 15,872 от 72,504 токена за повторна употреба · 21.89 | — | — | — | — | — |
| Прозорец 1 | 0 | 0 | 7,936 | 0 | 0 |
| Прозорец 2 | 0 | 0 | 0 | 0 | 0 |
| Прозорец 3 | 0 | 0 | 7,936 | 0 | 0 |
| Префикс 32k · попадения при горещите заявки 3/9 · прочетени са 96,000 от 288,513 токена за повторна употреба · 33.27 | — | — | — | — | — |
| Прозорец 1 | 0 | 0 | 32,000 | 0 | 0 |
| Прозорец 2 | 0 | 0 | 0 | 0 | 0 |
| Прозорец 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k и 32k с еднаква тежест) | — | — | — | — | 27.58 |
Стойностите са зачетените от сървъра токени от кеша; „Not returned“ означава, че полето липсва в отговора.
При горещите заявки с префикс 8k има 2 попадения от 9, като при всяко попадение са прочетени 7,936 токена; при тези с префикс 32k има 3 попадения от 9, като при всяко са прочетени 32,000 токена. Заявките без кеш не прочитат кеша, така че горещите и студените заявки се разграничават ясно.
Сравнение с останалите пет
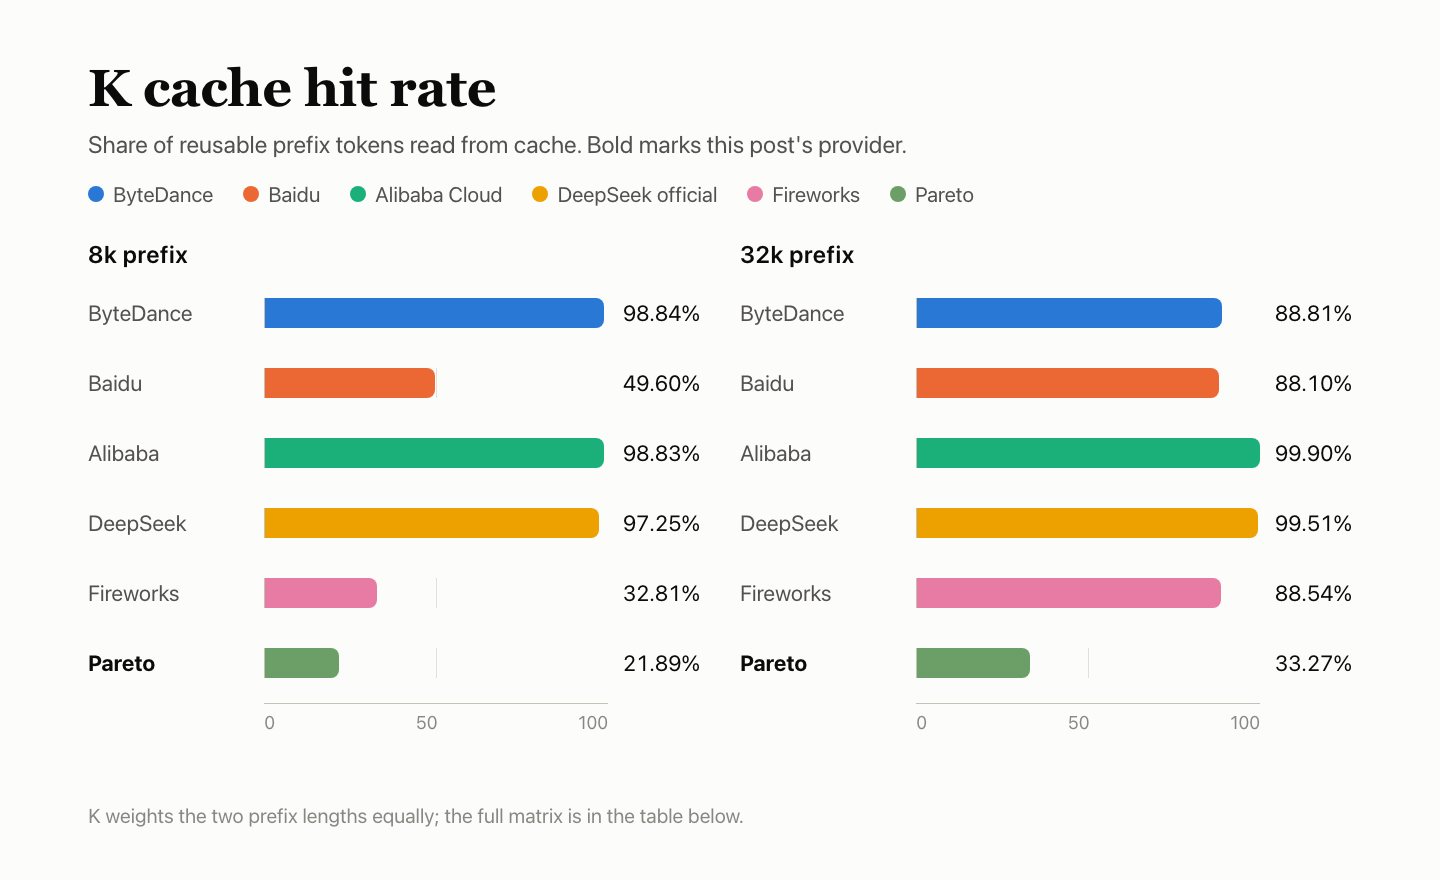
| Доставчик | Попадения при 8k | 8k | Попадения при 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Официален канал на DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (тази публикация) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — стабилност на услугата: 100
300-те заявки са разделени в четири типа: кратък текст, дълъг вход, извиквания на инструменти и многоходова история. Те бяха изпълнени с паралелност 1 в три прозореца. Проверява се само дали първият опит е върнал валиден и пълен отговор; отговорите не се оценяват и заявките не се повтарят. Неуспехите в разделите за качество на отговорите и скорост се отчитат съответно в Q и P, а не отново в R.
| Тип заявка | Успех от първия опит |
|---|---|
| Кратък текст | 120/120 |
| Дълъг вход 10k | 90/90 |
| Извиквания на инструменти | 60/60 |
| Многоходова история | 30/30 |
| Общо · 95% интервал 98.78%–100% | 300/300 |
И 300-те заявки върнаха валиден и пълен отговор от първия опит. R = 100 описва само тези 300 специално подготвени заявки; това не означава, че цялата поредица не е имала неуспехи. Долната граница на 95% интервал е 98.78%: 300 успешни от 300 означава само, че вероятно делът на неуспешните заявки е под 1.22%.
Сравнение с останалите пет
| Доставчик | Успех от първия опит | 95% интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Официален канал на DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (тази публикация) | 300/300 | 98.78%–100% |
R обхваща само тези 300 специално подготвени заявки; неуспехите в разделите за качество на отговорите и скорост се отчитат в Q и P и не се броят повторно в R.
Често задавани въпроси
Защо F е 93.42, след като са отбелязани само 33 проверки?
Първоначално преброените проверки включват 29 успешни от 33, което дава F 93.42 след преизчисляване на теглата на наблюдаваните групи; останалите 147 планирани места за проверки бяха изключени от оценяването. Записите за поточно предаване описват конкретни работещи функции и не добавят проверки към оценката. Показаната обща оценка остава 68.72.
Защо P е 57.69, след като TPOT получи 100.00?
Само 110 от 180 заявки за скорост бяха валидни; 70 върнаха 200 с None. Невалидните заявки се считат за безкрайни, затова медианата на времето до първия токен в тялото на отговора е 5.85 s при паралелност 1 и 6.13 s при паралелност 10 (3.08 s и 4.92 s само за валидните заявки). TTFA получи 24.59, а пропускателната способност — 72.05, което прави оценката за отговора 65.22; с K за кеша 27.58, чиято тежест е 20%, P е 57.69.
Защо K е само 27.58?
При префикс 8k има 2 попадения от 9 (21.89), а при 32k — 3 от 9 (33.27); двете дължини имат еднаква тежест. Когато е имало попадение, са прочетени 7,936 или 32,000 токена, а нито една контролна заявка без кеш не е прочела кеша.
По-високо ли е качеството на отговорите на Pareto от това на официалния канал?
Разликата не е статистически различима. Комбинираната точност е 44.58% спрямо 42.45%, разлика от +2.12 пункта, но 95% интервалът е от −0.02 до +4.18 и включва 0. Оценителят на HLE и AA-LCR, deepseek-flash, не е калибриран и може да е склонен да дава по-благоприятни оценки.
Кои случаи във F се провалиха?
Два. При поточно предаване последователността за спиране връщаше празно тяло и в трите прозореца, докато същият вход без стоп работеше. При точния текстов изход в един от трите прозореца имаше допълнителна точка в края.
Продължете с поредицата за DeepSeek V4.1 Flash
- Разликата на Pareto по Q от +2.12 е измерена спрямо официалния канал; базовото измерване на официалния канал е в Официален канал на DeepSeek — преглед на DeepSeek V4.1 Flash: сравнителна база, 15 невалидни заявки при паралелност 1.
- Fireworks също връщаше празни тела при заявки със стоп и имаше попадение при 3 от 9 заявки с 8k: Преглед на DeepSeek V4.1 Flash в Fireworks: заявките със стоп връщат празно тяло, 3 от 9 горещи заявки с 8k попадат в кеша.
- Горещите заявки на Alibaba Cloud имаха попадение при 18 от 18 спрямо 5 от 18 при Pareto: Преглед на DeepSeek V4.1 Flash в Alibaba Cloud: 1.34s до първия токен в тялото, попадение в кеша при всичките 18 горещи заявки, отговори, неразличими от официалните.
- Всички заявки за скорост на ByteDance бяха валидни, а времето до първия токен в тялото беше 2.12 s: Преглед на DeepSeek V4.1 Flash в ByteDance: отговори, неразличими от официалните, броят на входните токени не съвпада.
- При Baidu също отпаднаха много заявки за скорост заради no_available_channel: Преглед на DeepSeek V4.1 Flash в Baidu: извикването на инструменти е на нивото на официалния канал, честите no-available-channel свалят качеството на отговорите и скоростта.
Източници
- Страница на модела DeepSeek V4.1 Flash 1017 (AIHubMix)
- Стандарт за бенчмаркове на доставчиците на AIHubMix v2.0 (документация на AIHubMix)
- Бърз старт (документация на AIHubMix)
- Модели (AIHubMix)
- Документация за DeepSeek API (DeepSeek)


