Anthropic 於 2026 年 11 月 9 日推出 Claude Fable 5.2。Google 則在隔天讓 Gemini 4 Carbon 正式上市。Anthropic 自家的發布基準測試表納入了 Carbon 欄位,因此很適合用來比較兩者處理相同長時程程式設計工作的表現。
這兩款模型的定位相同:長時程 Agentic Coding。Agent 會讀取程式碼儲存庫、編輯多個檔案、執行指令、讀取測試輸出,並在沒有真人介入的情況下持續工作 15 到 45 分鐘。本文評測的就是這項任務。聊天、自動補全和短篇腳本則是不同的測試。
簡短結論
Fable 5.2 在列出的高難度程式碼基準測試中領先,同等推理強度下速度也較快,包辦 AA 前三名,領先排名第 4 的 Carbon High。Carbon 在列出的 Terminal-Bench 4.0 和 AutomationBench-AA 項目得分較高;在 Google 的優惠價格於 11 月 30 日結束前,每項任務的成本也較低。Medium 推理強度下,Fable 價格更低、速度快得多,而 Carbon 的 AA 指數較高。
高難度程式碼推理選 Fable,終端機執行與自動化選 Carbon;使用任一款之前,請先確認輸入、資料保留和輸出限制。
同一套測試框架的結果
Artificial Analysis 使用相同的測試框架和任務執行所有模型;其 Carbon 和 Fable 頁面列有各項評測結果。數據取自 2026 年 11 月 11 日的快照;AA 採用標準牌價,未計入 Google 的優惠價格。
| 模型 | AA 指數 | 美元/任務 | 分鐘/任務 | 首 token 時間 |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
注意:AA Intelligence Index 與每項任務成本採標準價格,快照時間為 2026-11-11T05:23Z。Fable Max、Xhigh 和 High 分別排名第 1 至第 3;Carbon High 排名第 4;Opus 5.5 Max 排名第 5;Carbon Medium 排名第 6。首 token 時間是生成第一個回答 token 所需的時間。
High 推理強度下,Fable 領先 1.79 分,每項任務成本高出 17.0%($9.08 對 $7.76),完成時間為 17.3 分鐘,而非 25.6 分鐘;首 token 時間為 30.4 秒,而非 67.1 秒。Max 每項任務成本為 $26.54,是 Carbon High 的 3.4 倍,等待時間則為 233.9 秒。
Medium 推理強度下,排名則有所不同:Fable 得分 56.41,低於 Carbon 的 58.26,差距為 1.85 分;但 Fable 成本為 $3.80,Carbon 則為 $6.59,完成時間分別是 7.8 分鐘和 23.3 分鐘。Carbon 較低的 token 價格在此並未讓每項任務更便宜,因為它消耗的 token 更多。
| 基準測試 | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| 未產生幻覺 % | 88.58 | 42.02 | 40.73 | 49.66 |
| 準確率 % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
注意:Artificial Analysis 使用相同的測試框架和快照。未產生幻覺率是 Omniscience 回答中沒有捏造說法的比例;準確率是另一項獨立分數。所有項目都是越高越好。為了讓表格更易讀,省略 Fable Xhigh;其 FrontierCode 2.0 分數為 47.58。
High 推理強度下,哪款模型在各項測試中領先?下方的差距以 Carbon 減去 Fable 計算,讓勝負方向一目了然;上表則保留實際分數。
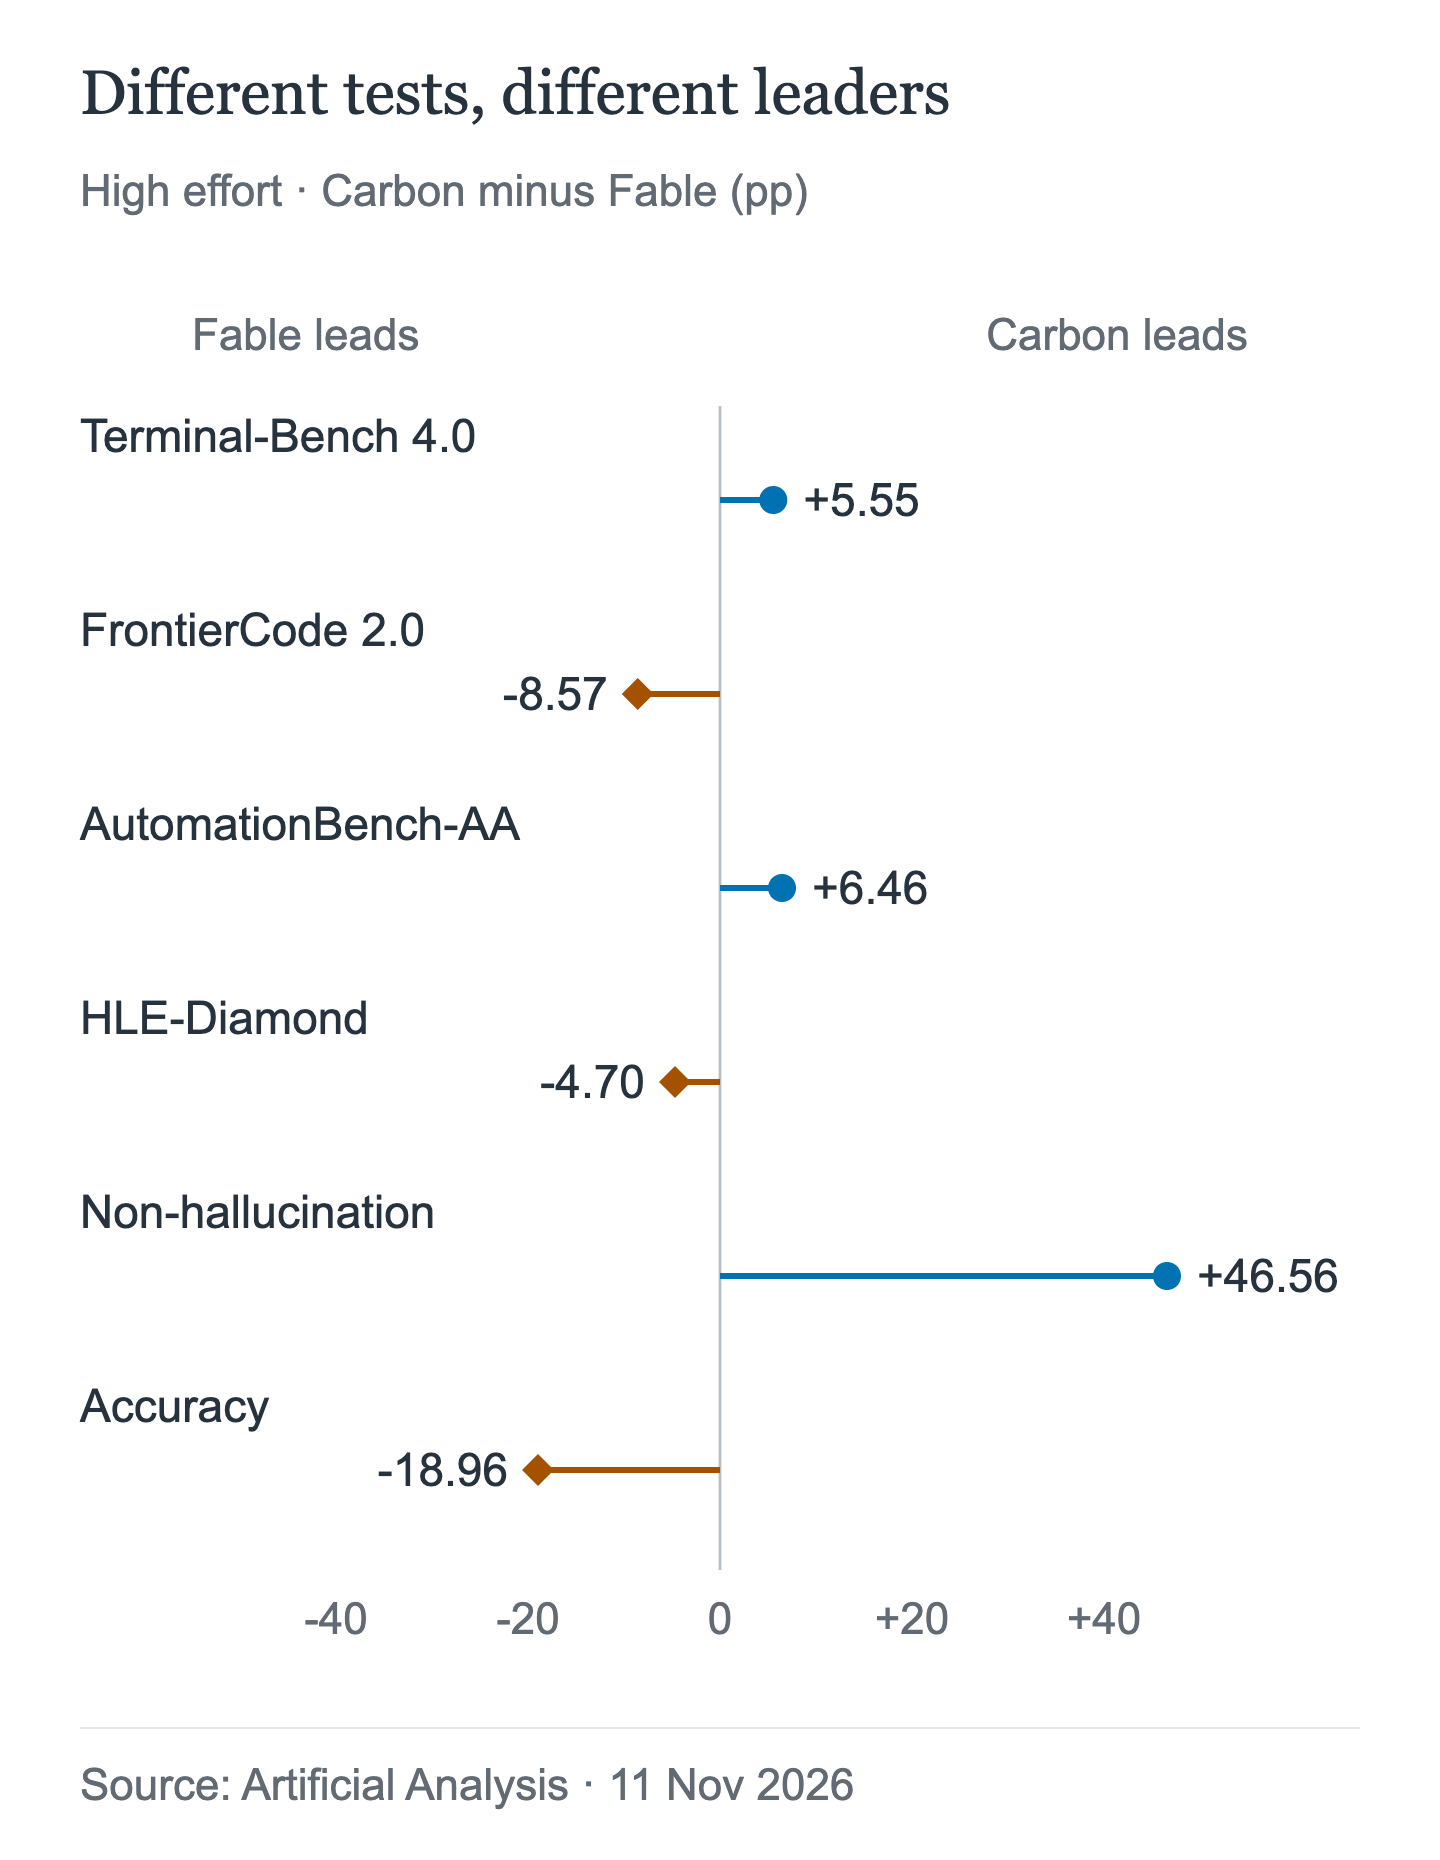
這些是各項獨立測試的百分點差距,不是綜合品質分數。某項基準測試的差距較大,不代表整體能力提升更多。尤其是未產生幻覺率和準確率,衡量的是不同結果。
High 推理強度下,Fable 在 FrontierCode 2.0 領先 8.57 分,在 HLE-Diamond 領先 4.7 分;Briefcase Elo 為 1677.4,Carbon 則為 1610.6。FrontierCode 最接近測試困難的多檔案程式碼變更。Carbon 在 Terminal-Bench 4.0 領先 5.55 分,在 AutomationBench 領先 6.46 分;這兩項測試著重於命令列執行、復原和自動化。
未產生幻覺率的差距是表中最大的一項:High 推理強度下,Carbon 為 88.58%,Fable 為 42.02%。準確率則相反,分別為 58.27% 和 77.23%。Carbon 較不容易捏造資訊,但答對的機率也較低。對不能虛構 API 的 Agent 來說,這可能值得取捨;對必須給出正確答案的 Agent,Fable 的準確率則是更好的參考指標。
推理強度提高並不一定全面帶來更好表現:Fable Max 的 FrontierCode 分數為 48.76,略低於 High 的 49.13;Terminal-Bench 則維持在 59.6。
Anthropic 自家的表格
Anthropic 的發布頁面公布了一份納入 Carbon 的跨供應商比較表。其設定與 AA 不同:Fable 使用 Xhigh,也就是其公布的最高推理強度;Carbon 則使用 Medium。請只在這份表格內進行比較。
| 基準測試 | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
注意:數據由 Anthropic 自行提供。Fable 使用 Xhigh,也就是可用的最高推理強度;Carbon 使用 Medium。Anthropic 的 AutomationBench 評分尺度與 AA 不同(51.4/53.9 對 71.36/77.82),因此請在這份表格內比較。Carbon 的 FrontierCode 分數 41.1 是 Medium 推理強度下的結果;AA 的 40.56 則是在不同測試框架下以 High 推理強度測得。
整體趨勢與 AA 相同:Fable 在 FrontierCode、FrontierSWE、OSWorld 和 TB-Science 領先;Carbon 在 AutomationBench 領先 2.5 分,雖然比 AA 的 6.5 分差距小,但勝負方向相同。這份表格支持「Carbon 在自動化方面具競爭力」,但不支持「Carbon 是更優秀的高難度程式碼模型」。
Anthropic 自家的建議讓「Fable 是升級版」這種說法變得更複雜:「對大多數程式設計和知識工作,我們建議使用者先從 Claude Opus 5.5 開始。」Anthropic 表示,在 High 推理強度下,Fable 的分數與 Opus 5.5 的最佳成績大致相同(45.3% 對 45.5%),但每項任務的成本約為一半。
token 的成本
| 模型 | 輸入 | 輸出 | 快取讀取 |
|---|---|---|---|
| Carbon,至 11 月 30 日 | $2 | $10 | $0.10 |
| Carbon,12 月 1 日起 | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
注意:每 1M tokens 的美元價格,採官方價格。Fable 快取寫入:$10(5 分鐘)或 $16(1 小時);Batch 享 50% 折扣。Carbon 的快取價格是讀取價格;Opus 5.5 的官方快取讀取價格為 $0.20。
Fable 的 token 價格是 Carbon 標準價格的兩倍,是其優惠價格的四倍。這個比率很簡單,但每項任務的帳單並非如此。AA 測得 Carbon High 在 $4/$20 價格下,每項任務成本為 $7.76;Fable High 則為 $9.08,相差 17.0%。以 Google 的 $2/$10 價格計算,同樣的使用量約需 $3.88,這是推算值。直到 11 月 30 日,Fable High 每項任務的成本約為 Carbon 的 2.3 倍;12 月 1 日起,差距將回到 17.0%。
按標準價格計算,Fable Medium 每項任務成本為 $3.80,Carbon 則為 $6.59;即使 token 價格高出一倍,Fable 仍便宜 42%。Carbon 需要 23.3 分鐘且消耗更多 token;Fable 則需 7.8 分鐘。按優惠價格計算,Carbon Medium 約需 $3.30,同樣是推算值,與 Fable 相近;這項優勢將在 12 月 1 日消失。
Max 每項任務成本為 $26.54,是 Carbon High 的 3.4 倍,耗時 45.2 分鐘。花更多錢不代表一定能得到更好的程式設計 Agent:Max 的 FrontierCode 分數略低於 High。
AIHubMix 以 Google 的優惠價格提供 Carbon。本文列出的 Fable 價格為 Anthropic 官方價格。
影響部署決策的行為差異
| 面向 | Carbon | Fable 5.2 |
|---|---|---|
| 最大輸出 | 65,536;原生上限 ≤1,048,576−輸入* | 128,000 |
| 上下文 | 1,048,576(Google 原生) | 1M |
| 思考模式 | low / medium / high;預設為 medium | 自適應;預設為 high |
| 強制工具呼叫 | 文件說明為 auto* | any/tool 會回傳 400 |
| 取樣 | 忽略;請移除 | 部分值會回傳 400 |
| 資料保留 | 未列明限制 | 30 天;不支援 ZDR |
| 輸入 | AIHubMix 上為文字 | 文字、圖片、PDF† |
| 知識截止日期 | 2026 年 3 月 | 2026 年 6 月 |
注意:*Carbon 較高的上限屬於 Google 原生的長輸出能力;AIHubMix 目前僅記載支援文字輸入和 Chat Completions,因此尚無法確認閘道是否支援。†Fable 支援的輸入模態來源為 AIHubMix 模型索引。*AIHubMix 文件記載 tool_choice="auto",但尚無法確認 Carbon 是否支援。Fable 的 128,000 輸出上限為文件所載的模型限制。ZDR 指零資料保留。
強制工具呼叫是 Fable 的重大限制:「強制工具呼叫(tool_choice 類型為 any 和 tool)會回傳 400 錯誤。」若 Agent 每一輪都必須呼叫特定工具,就無法直接使用 Fable。Google 的 Carbon 指南建議逐輪執行工具;AIHubMix 的 Gemini 指南記載 tool_choice="auto",但 Carbon 在此閘道上的工具支援情況仍未確認。
資料保留政策是 Fable 的一項限制,其概覽指出:「需要保留資料 30 天;除非經 Anthropic 明確授權,否則不支援零資料保留。」本文查閱的 Carbon 文件並未提及這類限制,但這不代表保證沒有此限制。受法規規範的團隊應在部署前確認兩款模型的政策。
Carbon 標準的 65,536-token 上限足以應付大多數編輯工作,但產生整個檔案時可能會觸及上限。Google 原生背景模式最多可達 1,048,576 減去輸入 token,會按區段跳轉計費,而且即使仍會收費,也可能回傳 incomplete,並附上空白文字。AIHubMix 尚未記載這項功能。Fable 則可在單次回應中輸出 128,000。
兩款模型都無法停用思考模式。Carbon 提供 low、medium 和 high,預設為 medium,並會忽略取樣參數。Fable 的「自適應思考模式一律開啟,無法關閉」,預設為 high,部分取樣值則會回傳 400。
Google 在 GA 前透過 Fairwind 計畫向防禦方推出 Carbon。Fable 的分類器會封鎖滲透測試和漏洞利用相關請求,並在處理網路安全與生物學工作時改用其他模型。進行安全測試時,拒答行為比基準測試中的一項分數更重要。
作為參考欄位的 Opus 5.5
Opus 5.5 並非競爭對手,但它是 Anthropic 自家的參考模型。按 $4/$20 計算,Opus 5.5 在 AA 得分 59.11,每項任務成本為 $10.04,耗時 25.0 分鐘,首 token 等待時間為 356.4 秒,是表中最慢的模型(AA 列出的結果為 Max 推理強度;預設值為 medium)。它在 Briefcase Elo 以 1800.6 領先,但 FrontierCode 分數落後 Fable High,Terminal-Bench 分數則落後 Carbon High。Anthropic 仍建議大多數程式設計工作從 Opus 5.5 開始。
該選哪一款
如果工作以高難度程式碼變更為主,而且你想要 FrontierCode 和 HLE 的最佳實測成績,請選 Fable 5.2。Medium 推理強度下,它更便宜、速度也更快:成本為 $3.80、耗時 7.8 分鐘;Carbon 則為 $6.59、耗時 23.3 分鐘,但 Carbon 的 AA 指數較高。若需要圖片輸入、知識截止日期為 2026 年 6 月,或能接受 30 天資料保留且不需要強制工具呼叫,也可以選擇 Fable。
若工作以終端機操作為主,請選 Carbon:測試與修正循環、Shell 自動化、多步驟操作。它在列出的 Terminal-Bench 4.0 和 AutomationBench-AA 項目中得分較高,而且在 11 月 30 日前以 High 推理強度使用更便宜。AIHubMix 尚未確認 Carbon 是否支援 Google 原生上下文和長輸出上限;確認 Carbon 支援工具後,再以純文字模式搭配 tool_choice="auto" 部署。它的非幻覺分數較高,但準確度較低。
若要採用 Anthropic 建議的起點並取得均衡的表現,請選 Opus 5.5;但要接受 Max 推理強度下較慢的首個 token。
若重視互動延遲,兩者都別選:Fable 在 High 推理強度下的首個 token 需 30.4 秒,Carbon 則需 67.1 秒;即使是 Carbon Medium 的 23.2 秒,也離聊天速度差得遠。
透過 AIHubMix 執行兩款模型
AIHubMix 讓兩款模型共用一把金鑰和同一個 Chat Completions 端點。Carbon 的 ID 是 gemini-4-carbon;模型頁面列出 Chat Completions、文字輸入和 Google 的推出優惠價格。Fable 5.2 的 ID 是 claude-fable-5-2;AIHubMix 列出 Chat Completions、Responses 和 Anthropic Messages,並提供 1M 上下文與 128K 最大輸出。Carbon 文件記載的功能較少:支援 Chat Completions,不支援原生 Gemini API。此閘道也會重試次佳供應商,因此行為可能與單一供應商部署不同。
快速入門說明了驗證方式和基礎 URL。可以執行冒煙測試,確認兩個 ID 是否都能透過同一把金鑰解析;本文初稿未執行即時測試:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
這只能確認路由,不能驗證功能:沒有工具,也沒有長輸出。若要真正比較,請對兩個 ID 執行相同的 Agent 執行軌跡,並記錄任務時間、token 用量和失敗情況。比較頁面並列呈現上下文、通訊協定和價格。
常見問題
Gemini 4 Carbon 比 Fable 5.2 更適合 Agentic Coding 嗎?
兩者都無法在工作的每個面向勝出。Fable 5.2 在 High 推理強度下,FrontierCode 2.0 和整體指數的表現領先;Carbon 則在 Terminal-Bench 4.0 和 AutomationBench 領先。請根據 Agent 實際執行的工作負載來選擇。
為什麼 Fable 5.2 的價格是 Carbon 的四倍?
以官方價格計算,Fable 每百萬 token 收費 $8/$40,而 Carbon 推出優惠價為 $2/$10,因此輸入和輸出價格都是四倍。若與 Carbon 自 12 月 1 日起的標準價格 $4/$20 相比,則是兩倍。
Fable 5.2 在 Medium 推理強度下,每項任務的成本真的比較低嗎?
以標準價格計算,是的:Fable 為 $3.80,Carbon Medium 則為 $6.59;耗時分別為 7.8 分鐘和 23.3 分鐘。Carbon 的推出優惠 token 價格會縮小差距;標準價格的比較才具有長期參考價值。
Fable 5.2 能強制呼叫工具嗎?
不行。Anthropic 文件指出,tool_choice 設為 any 或 tool 都會回傳 400 錯誤。需要強制呼叫工具的 Agent 必須採用不同的迴圈或改用其他模型。
Carbon 比較不容易對 Fable 5.2 產生幻覺嗎?
以 AA 的 Omniscience 非幻覺指標來看,是的:High 推理強度下,Carbon 為 88.58%,Fable 為 42.02%。但 Carbon 的準確度較低,為 58.27%,Fable 則為 77.23%,所以 Carbon 給出正確答案的可能性也比較低。
兩款模型都能透過 AIHubMix 使用同一把金鑰執行嗎?
可以。使用 gemini-4-carbon 和 claude-fable-5-2,搭配相同的金鑰和基礎 URL 即可。AIHubMix 為 Carbon 提供 Chat Completions;Fable 則支援 Chat Completions、Responses 和 Messages。
繼續閱讀:Gemini 4 Carbon 系列
- 選擇競品之前,先釐清同系列型號的差異:Gemini 4 Carbon vs Argon:價格相同,Carbon 何時值得選?
- 將 Carbon 納入工作流程後,最初遇到的 400 錯誤和逾時通常是設定問題,而非模型問題:Gemini 4 Carbon API 遷移:400 錯誤、逾時和輸出限制
資料來源
- Gemini 4 Carbon 現已推出 — Google,2026 年 11 月 10 日。
- Claude Fable 5.2 — Anthropic,2026 年 11 月 9 日。
- Claude Fable 5.2 概覽 — Anthropic 文件。
- Gemini 4 Carbon 和 Claude Fable 5.2 — Artificial Analysis,2026 年 11 月 11 日快照。
- AIHubMix 上的 Gemini 4 Carbon — 模型頁面與定價。