Gemini 4 Carbon不是全新的模型系列,而是每回合會進行更多思考的Gemini 4 Argon,每 token 售價相同:每百萬個輸入 token $2、每百萬個輸出 token $10,優惠價格適用至 2026 年 11 月 30 日;自 12 月 1 日起,價格將調整為 $4 和 $20。問題不在於哪個模型的 token 單價較低,因為兩者完全相同。真正的問題是,每項已完成任務所帶來的額外思考效益,是否足以讓人接受較慢的首次回應。
Artificial Analysis 的即時數據,對一種工作給出了明確答案,也對另一種工作提出明確警告。Carbon High 在 AA Intelligence Index 的 104 個模型中排名第 4,得分 60.03;Argon High 則為 50.41。Carbon 每項任務花費 $7.76,低於 Argon 的 $9.95;完成時間為 25.6 分鐘,也短於 Argon 的 29.0 分鐘。但 Carbon 首個回答 token 的等待時間為 67.1 秒,Argon 則是 40.1 秒。Carbon 更適合排入佇列的工作;Argon 更適合對話。
這個差異就是本文的核心。以下將說明有哪些變化、數據反映了什麼、Google 的模型卡補充了哪些資訊、價格在 12 月 1 日如何變動,以及哪些工作負載應繼續使用 Argon。
Argon 有哪些變化
Google 的模型卡明確說明兩者的關係:「Gemini 4 Carbon 是以 Gemini 4 Argon 為基礎打造。」模型 ID 為 gemini-4-carbon,在 AIHubMix 上也相同。Google 記載的上下文視窗為 1,048,576 個 token。思考強度分為 low、medium 和 high,預設為 medium。標準輸出上限為 65,536 個 token;Google 原生的長解碼路徑最多可輸出 1,048,576 個 token 減去輸入 token 數,並以 131,072 和 262,144 為例。AIHubMix 目前只記載 Chat Completions,因此在有更高上限的路徑文件之前,請將閘道請求限制在 65,536 以下。知識截止日期為 2026 年 3 月。Google 不提供免費額度。
這項變化在Google 的 AI Studio 說明中有清楚描述:「Carbon 每回合會使用更多思考 token,徹底探索並驗證結果,因此相較 Argon,每回合的 token 使用量和延遲都會增加。」這句話幾乎解釋了本文後續提到的所有差異。更多思考能提高處理困難任務的上限,也會增加每回合費用,以及等待首個 token 的時間。
遷移刻意保持簡單。「從 Argon 升級不需要變更請求結構。」在 API 層級只要替換模型字串即可。Google 的操作建議是:「除非工作負載需要 high,否則請將 thinking_level 維持在 medium(預設值),並確認 max_output_tokens 和 HTTP 逾時設定足以容納較長的推理過程。」
實際取捨:思考更多,每項任務花費更少
以下數據來自Artificial Analysis 的即時測量,資料查詢時間為 2026-11-11T05:23Z(模型頁面於 06:01Z 再次確認,數據未變),採用標準價格:每百萬個輸入 token $4、每百萬個輸出 token $20。
值得關注的比較方式,是品質與已完成任務成本之間的關係:Carbon 能否以較低費用提升指數?圖表將四種模型設定分開呈現。
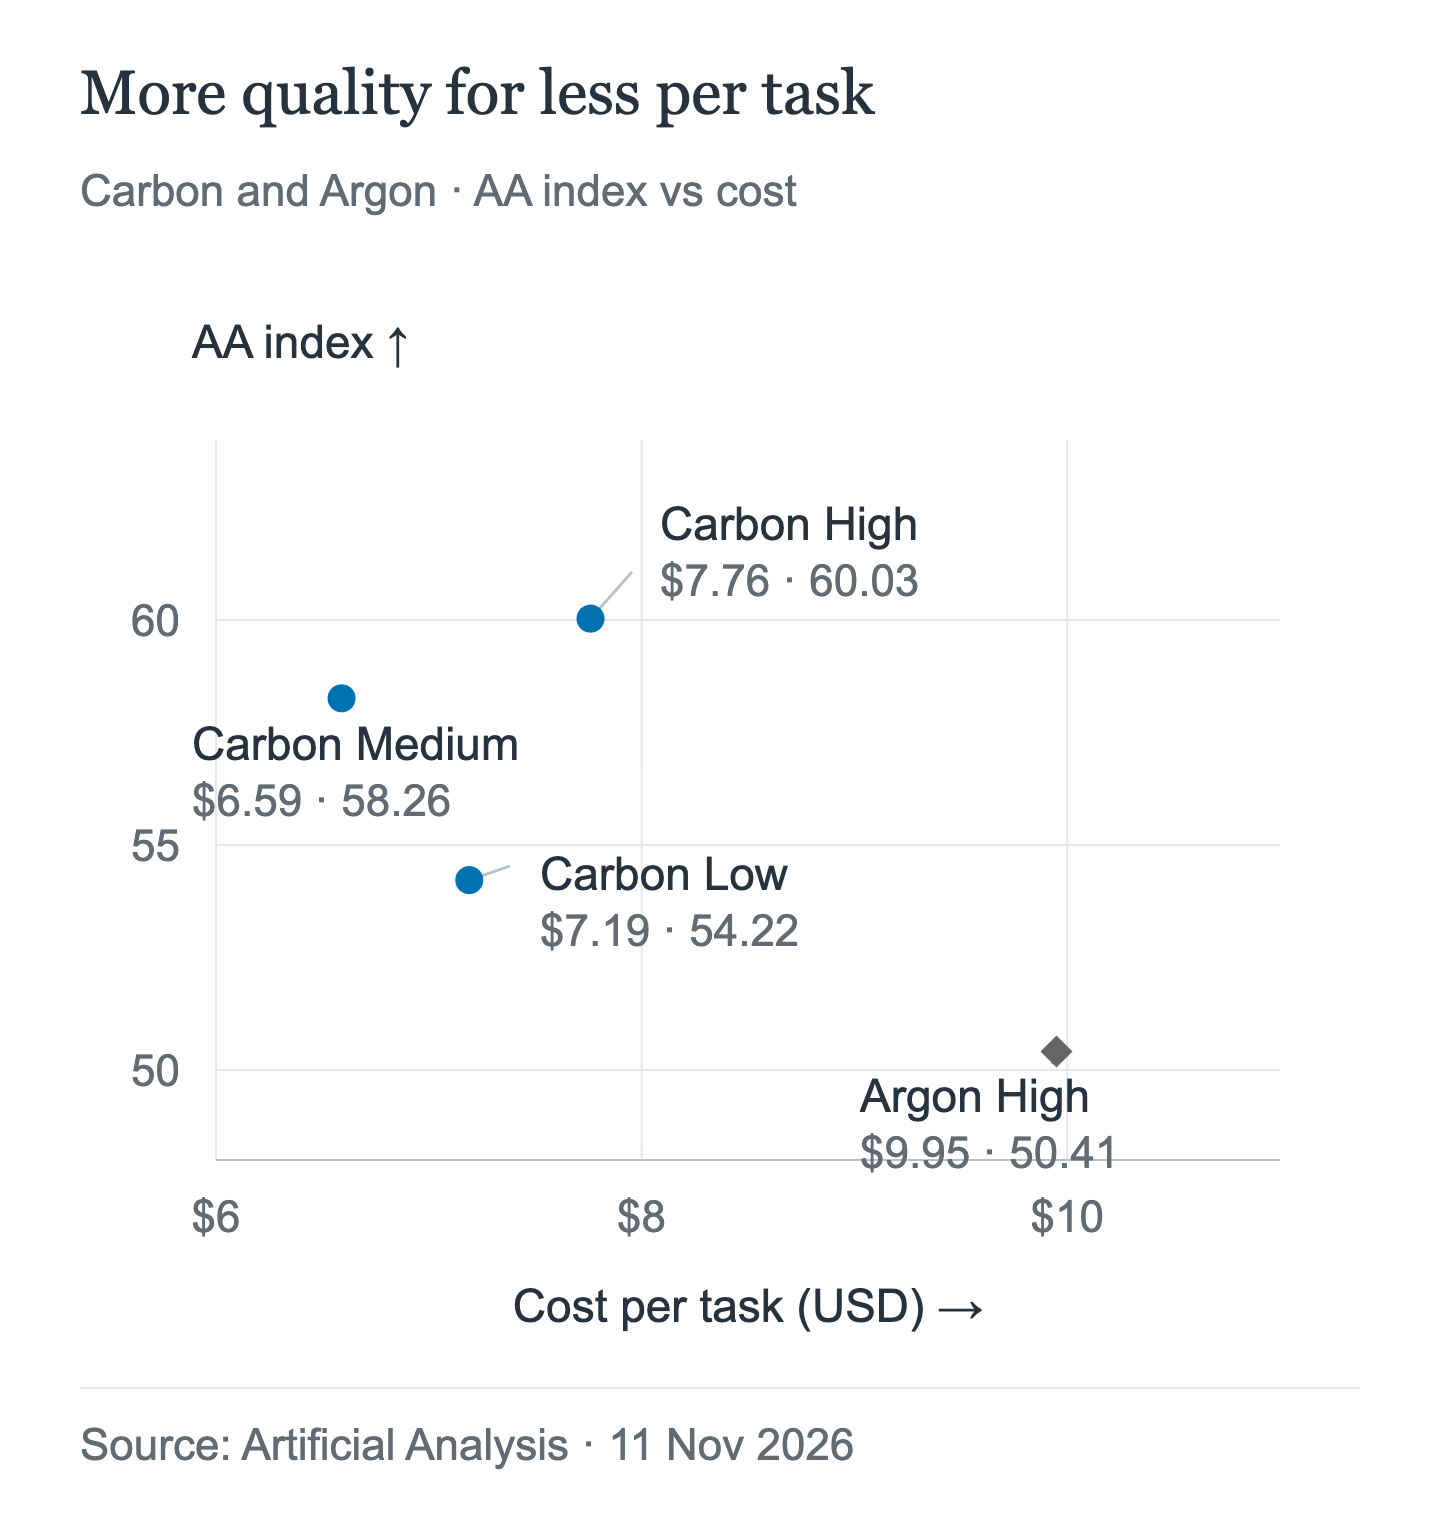
Carbon High 的位置在 Argon High 的左上方。這次測試中,Medium 是 Carbon 成本最低的設定;Low 是為了降低延遲而選的設定,不是成本最低的選擇。這些是依標準價格計算的 AA 任務成本,不是 AIHubMix 的請求費用。
| 模型 | AA 指數 | 美元/任務 | 分鐘/任務 | 首個 token | 輸出 token/秒 |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High、Medium 和 Low 在 104 個模型中分別排名第 4、第 6 和第 14;Argon High 排名則低於這三者。Carbon High 之前的三個項目全都是 Claude Fable 5.2 的設定。「首個 token」指的是首個回答 token 的等待時間。Carbon High 與 Argon High 相比:指數高出 9.62 分,每項任務便宜 22.0%,完成時間為 25.6 分鐘而非 29.0 分鐘,但首個回答 token 的等待時間是 67.1 秒而非 40.1 秒。
指數差距大到足以改變排行榜名次;延遲差距也大到足以影響使用者是否願意等待。這兩個結論來自同一列數據。
Artificial Analysis 將 Carbon 描述為「每項任務速度明顯偏慢,而且輸出非常冗長」,並指出執行該指數測試時,Carbon 產生了 205 million 個 token,Argon 則為 113 million,所有受測模型的中位數為 72.8 million。在這次 AA 測試中,輸出量大幅增加的同時,每項任務成本反而更低:單價相同、token 多出許多,總體任務成本卻較低。
有一個反常之處值得特別指出。Carbon Low 每項任務花費 $7.19,比 Medium 的 $6.59 還高,儘管它的思考量較少。不論原因為何,Low 的表現更像是降低延遲的設定,而不是省錢的設定,因此在將大量流量導向它之前,請先測量每項任務的成本。
從程式碼 Agent 的角度來看
Intelligence Index 是許多任務的平均值。Coding Agent Index v2更接近 API 客戶實際執行的情境:使用工具的程式碼 Agent,透過相同測試架構進行端對端測量。Carbon High 排名第 4;Argon High 排名第 11。
| 排名 | Agent + 模型 | 指數 | 美元/任務 | 分鐘/任務 | 快取命中 |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
兩者使用相同的 Agent 和測試架構,只更換模型,因此比較結果反映的是模型差異,而非周邊架構。Carbon 每項任務便宜 34.0%,指數高出 6.2 分,快 4.9 分鐘,而且每項任務的輸出量幾乎相同:109,031 個 token,Argon 則為 109,236 個。Carbon 的快取命中率更高,為 0.95,Argon 則為 0.87;輸入 token 使用量也較少,為 12.44 million,Argon 則為 13.76 million。
有兩點需要留意。Carbon 在此指數中排名第 4:Claude Code 搭配 Opus 5.5 Max 以 61.7 分居首,接著是 Devin Fusion CLI 和 GitHub Copilot Fusion。而 Fable 5.2 完全未列入此指數,因此這張表無法解答 Carbon 和 Fable 之間的比較問題。
Google 的模型卡補充了什麼,以及沒有補充什麼
Google 的模型卡是供應商文件:數據截至 2026 年 10 月,由 Google 自行回報,與上述即時數據來自不同時間點。下列各項中,Google 列出的 Carbon 數值每次都較高。
| 基準測試 | Carbon | Argon |
|---|---|---|
| AA Index v5.0(供應商數據) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
AA 這一列是 Google 四捨五入後的 59,並非前表即時數據中的 60.03;兩個數值來自不同時間點,不應混為一談。模型卡中的外部比較對象是 Fable 5.1,而不是 Fable 5.2。
有參考價值的是結果的一致性:Carbon 的優勢不只出現在一項基準測試上。其限制也很明顯:供應商模型卡不會計算每項任務的價格、不會測量首個 token 延遲,也不會告訴你 Agent 需要執行多少回合。它能支持「平均而言,Carbon 是更強的模型」這個結論,但無法支持「Carbon 更適合你的工作流程」這個結論。
價格:費率表相同,12 月 1 日也同樣調整
Carbon 和 Argon 的費率逐項相同。兩者都適用優惠價格至 2026 年 11 月 30 日,並於 12 月 1 日調漲一倍。
| 模型 | 輸入 | 輸出 | 快取讀取 |
|---|---|---|---|
| Carbon,優惠價格(至 11 月 30 日) | $2.00 | $10.00 | $0.10 |
| Carbon,自 12 月 1 日起 | $4.00 | $20.00 | $0.20 |
| Argon,優惠價格(至 11 月 30 日) | $2.00 | $10.00 | $0.10 |
| Argon,自 12 月 1 日起 | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview(≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
官方價格,單位為每百萬個 token 的美元價格,資料日期為 2026 年 11 月 11 日。Gemini 3.1 Pro Preview 在提示詞 token 超過 200k 時,價格為 $4/$18/$0.40,另加每百萬個 token 每小時 $4.50 的儲存費。Fable 5.2 的快取寫入費用為五分鐘 $10、一小時 $16;批次處理可享 50% 折扣。Carbon 和 Argon 的優惠價格將於 11 月 30 日結束;兩者所有費率都會在 12 月 1 日調漲一倍。
AIHubMix 列出的 Carbon 價格為 $2/$10/$0.10,與 Google 的優惠價格相同。本文不假設閘道在 11 月 30 日之後會收取什麼費用;請查看模型頁面確認目前價格。
將 Artificial Analysis 測得的 token 數量按優惠價格重新計算後,每項任務的粗略估算費用為:Carbon High $3.88、Medium $3.30、Low $3.60,Argon High $4.98。這些是計算出的估算值,不是 AA 的實測值:計算假設每項任務的 token 組成不變,而你的提示詞和快取命中率會影響結果。
以 token 單價來看,Fable 5.2 在標準價格下是 Carbon 的兩倍,在優惠價格下則是四倍。這是價格差距,不代表品質高低;系列第三篇文章會比較兩者。
Carbon 不適合的情境
不選 Carbon 的理由不是它比較差,而是它帶來的優勢,也就是每回合進行更多思考,正是互動式產品無法承受的成本。
首個 token 要等很久。Carbon High 要等 67.1 秒才會回傳首個回答 token;Argon High 則是 40.1 秒。Medium 可將等待時間縮短至 23.2 秒,Low 則縮短至 12.9 秒,但兩者的指數分數也會降低。若聊天介面停頓一分鐘,不論最後的回答如何,使用者早已錯過這一輪互動。
Google 建議為了速度繼續使用 Argon。Argon 的定位是適用於「需要更快回應和更低每回合 token 用量」的「互動式程式設計、日常功能開發和快速的正式環境工作流程」。遷移說明中的指示很直接:「在速度至關重要的情境中,請繼續使用 Argon。」Google 的公告文章也再次強調:「對大多數軟體工程和知識工作而言,Argon 仍是理想選擇。」
即使每項任務的成本較低,每回合的花費仍較高。token 單價相同,但 Carbon 每回合會使用更多思考 token。若團隊關注每回合的 token 花費,或必須節省 token 配額,Carbon 用起來就會比較貴。指數測試中 Carbon 使用 205-million 個 token,而 Argon 使用 113 million,正是這種效應的極端例子。
Low 並不是便宜的選擇。Carbon Low 每項任務花費 $7.19,比 Medium 的 $6.59 還高。如果路由依據是每項已完成任務的成本,Low 就不符合條件。
基準測試的勝利無法追回等待時間。在 Google 的表格中,OSWorld-2.1 和 FrontierSWE 2 都顯示 Carbon 較佳,但這些結果由供應商回報,而且都不會改變首個 token 的等待時間。基準測試衡量的是最終結果;使用者感受到的則是開始時的等待。
哪些人現在應該切換,哪些人應繼續使用 Argon
如果你執行供應商原生的批次或背景 Agent 工作(AIHubMix 尚未公開 Carbon 支援這些流程的文件),品質不佳造成的代價高於實際執行時間、請求可以接受較長的逾時時間和較大的輸出預算,或你已經在為 Carbon 可能避免的重試付費,現在就改用 Carbon。
如果你開發聊天、自動完成,或任何有人等待回應的流程;預算或配額是按每次互動計算;或產品要求延遲低於約 30 秒,請繼續使用 Argon。
如果你處於兩者之間,請先進行測試。將相同的 20 到 50 個實際請求分別送到兩個模型,記錄首個 token 的時間,以及每項已完成任務的成本,並據此選擇模型,而不是只看排行榜。AIHubMix 比較頁面會並列顯示這兩個模型的頁面。
如何透過 AIHubMix 呼叫
Carbon 在 AIHubMix 上使用相同的模型 ID 格式,以及文件列出的 chat completions 端點。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
端點為 POST /v1/chat/completions;這是 AIHubMix 唯一有文件說明的此模型路徑。列出的輸入模態為文字。AIHubMix 尚未公開 Carbon 支援圖片和 PDF 輸入、Responses API、Anthropic Messages 及 Gemini 原生端點的文件,因此請將這些功能視為尚未確認。reasoning_effort 的對應方式也一樣:請勿假設閘道會傳遞思考層級參數。請將 max_tokens 設在 65,536 的標準輸出上限內;較高的上限需要 Google 的背景模式,在 AIHubMix 上尚未確認。本文未進行即時測試,因此範例呈現的是請求格式,而非經驗證的回應。
常見問題
Carbon 和 Argon 的價格相同嗎?
是。Google 官方費率完全相同:每百萬個輸入 token 收費 $2,每百萬個輸出 token 收費 $10,適用至 2026 年 11 月 30 日;之後分別為 $4 和 $20。快取讀取費率則分別為 $0.10 和 $0.20。
Carbon 比 Argon 好嗎?
就品質和每項已完成任務的成本而言,根據 Artificial Analysis 的測量結果,是的:Intelligence Index 分別為 60.03 和 50.41,每項任務的成本分別為 $7.76 和 $9.95。但在回應速度方面則不是:Carbon 需要 67.1 秒才產生第一個回應 token,Argon 則為 40.1 秒。
為什麼 Carbon 完成任務較快,回應卻較慢?
它會等待較久才開始回應,但完成整項任務所需時間較短:25.6 分鐘,相較於 29.0 分鐘。等待第一個 token 的時間和完成任務的總時間是不同的測量指標,兩者呈現的趨勢正好相反。
需要修改請求嗎?
不需要。Google 表示,從 Argon 升級不必變更結構描述;只要將模型字串改為 gemini-4-carbon。請調高輸出上限和 HTTP 逾時時間,以因應較長的思考時間。
為什麼 Carbon Low 的每項任務成本比 Medium 高?
Artificial Analysis 測得 Low 每項任務的成本為 $7.19,Medium 則為 $6.59。請將 Low 視為延遲設定,而非折扣設定;透過它處理大量請求前,先測量每項任務的成本。
Carbon 在 Artificial Analysis 上排名第幾?
它在 Intelligence Index 中排名第 4,排在三種 Claude Fable 5.2 設定之後。Google 的模型卡顯示同一指標的四捨五入數值為 59;即時數據為 60.03,兩者不應混為一談。
Carbon 有免費額度嗎?
沒有。Google 不提供 Gemini 4 Carbon 免費額度,因此須透過付費 API 費率或 AIHubMix 這類閘道使用。
繼續閱讀:Gemini 4 Carbon 系列
- 如果本文讓你想試試 Carbon,但第一次請求就失敗,遷移指南涵蓋了較長思考過程所涉及的 400 錯誤、逾時設定和輸出上限變更:Gemini 4 Carbon API 遷移:400 錯誤、逾時與輸出上限。
- 如果你想知道 Carbon 是否足以應付 Agent 式程式開發,或 Fable 5.2 的高階定價是否物有所值,第三篇文章會將相同的實測數據與 Fable 5.2 並列比較:Gemini 4 Carbon vs Fable 5.2:Agent 式程式開發該選哪個?。
資料來源
- Google AI Studio,Gemini 4 Carbon:最新功能
- Google DeepMind,Gemini 4 Carbon 模型卡
- Google AI Studio,Gemini API 定價
- Artificial Analysis,Gemini 4 Carbon
- AIHubMix,Gemini 4 Carbon