連接 LLM 就足以讓應用程式生成文字,但不足以讓 AI Agent 完成真實世界的任務。
如果要求模型摘要已在其上下文中的文件,模型層就足以勝任。但若要求它比較今天的競爭對手價格、補充公司資料、檢查社群帳號,或為陌生的工作挑選最合適的 API,缺少的另一半就顯而易見:Agent 需要可靠的方式來連接外部系統。
因此,正式環境中的 Agent 會做出兩項不同的決策:
- 這個步驟應由哪個模型處理?
- 應呼叫哪個工具或 API 來提供資料或執行動作?
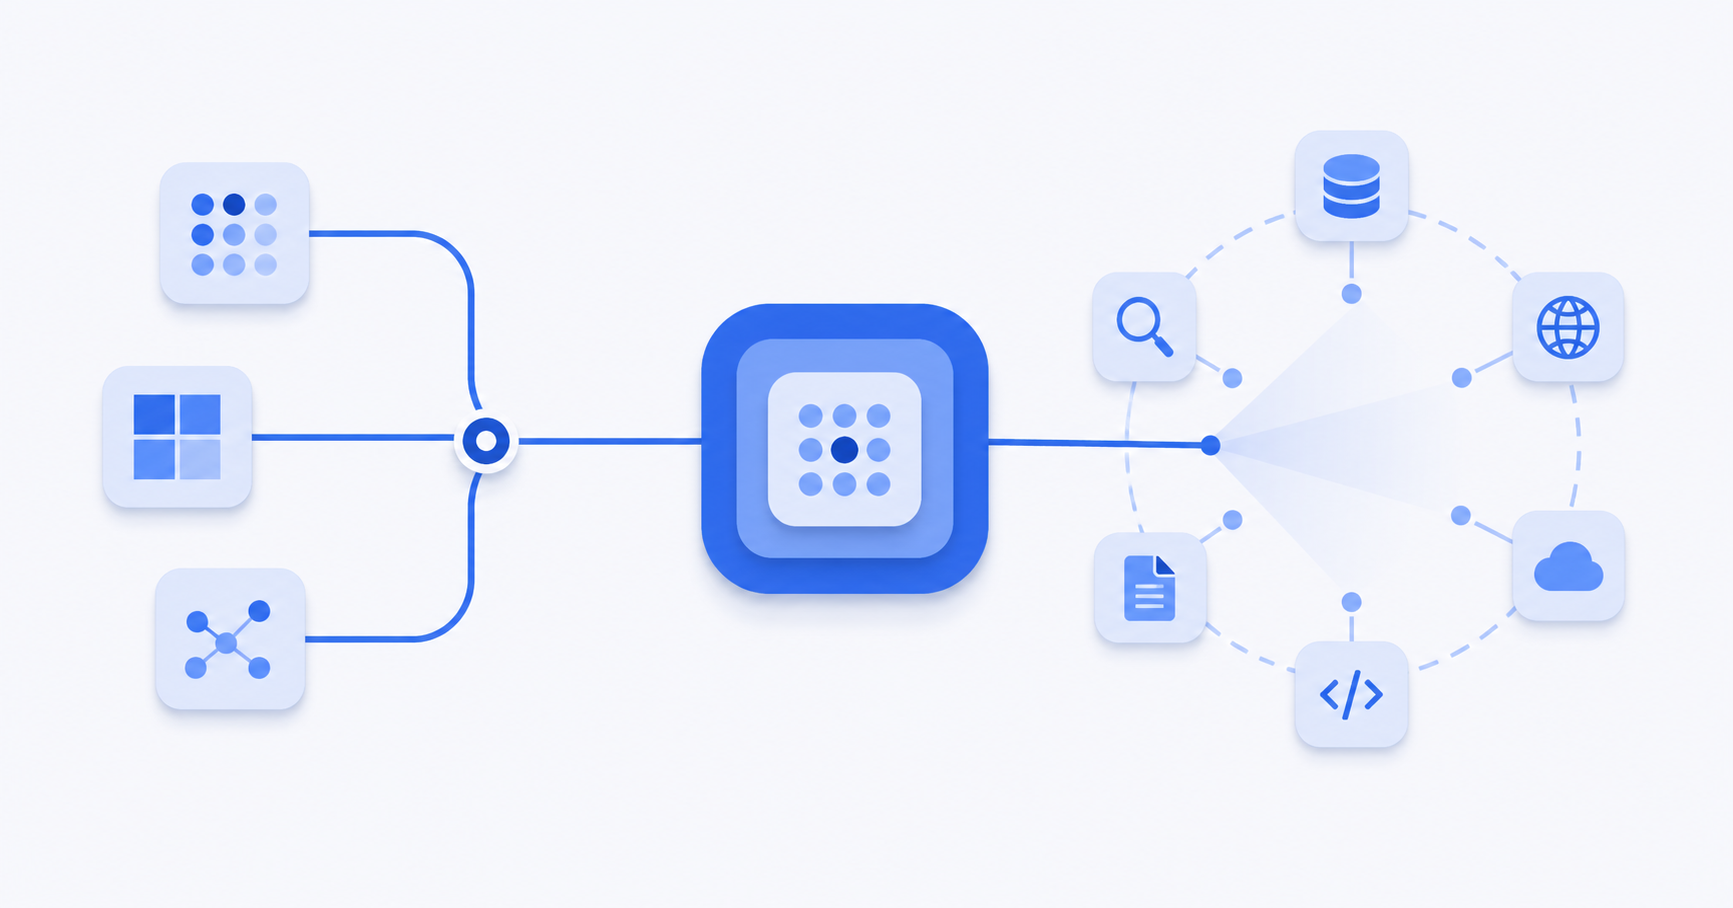
AIHubMix 透過統一的模型存取方式,以及在提出請求時進行模型路由,解決第一項決策。Monid 則透過執行階段的工具探索、結構描述檢視和按次付費執行,解決第二項決策。這兩項產品位於同一架構的不同層。
揭露:本文是與 Monid 合作撰寫的內容。下文討論的模型平台是 AIHubMix,工具平台則是 Monid。兩者都可以獨立使用。
AI Agent 內的兩種路由問題
Agent 的執行過程很少只包含一種模型呼叫。研究型 Agent 可能需要分類請求、搜尋最新資訊、擷取結構化事實、比較結果,並撰寫最終答案。這些步驟需要不同的能力。
模型之外也是如此。公司研究任務今天可能需要搜尋 API,明天需要公司資料補充端點,下週則需要瀏覽器自動化工具。如果每個模型和工具都在建置時寫死,每增加一項任務就會變成一個整合專案。
這兩個層面彼此平行:
| 模型層 | 工具層 | |
|---|---|---|
| 核心決策 | 應由哪個模型回答? | 應呼叫哪個 API? |
| 選擇時機 | 每次請求 | 每項任務,在執行階段 |
| 輸入 | 提示詞、模態、品質與延遲需求 | 目標、所需資料或動作、結構描述與價格 |
| 輸出 | 模型生成結果 | 外部資料或已執行的動作 |
| 範例 | AIHubMix | Monid |
這種區分很重要。更好的模型無法讓你取得即時資料,而更大的工具目錄也無法推理工具傳回的資料。Agent 需要這兩種能力,且兩者之間必須有明確的協作契約。
Monid 在為什麼 AI Agent 需要兩種整合一文中,從工具端說明互補的觀點。從模型端來看,架構上的原則也相同:讓模型選擇和工具選擇彼此獨立,再依各自的用途最佳化每個層面。
為什麼在 Agent 循環中固定使用單一模型會增加成本
所有地方都使用同一個模型,看似簡單;但實際上,這會迫使每個步驟都接受相同的能力、延遲和價格取捨。
以市場研究 Agent 為例:
- 意圖分類簡短且流程化。
- 工具選擇需要可靠地遵循指示。
- 從回傳的 JSON 擷取欄位,大多只是資料轉換。
- 最終報告可能需要更強的推理能力和更好的寫作表現。
把這四個步驟全都交給能力最強的模型,會讓例行工作徒增成本;全都交給最便宜的模型,則可能降低使用者唯一會閱讀的輸出品質。隨著 Agent 循環擴大,這種取捨會在每次呼叫中一再重演。
AIHubMix 提供相容於 OpenAI 的端點,涵蓋廣泛的模型目錄。現有的 OpenAI SDK 整合只要變更 API 金鑰和 base_url,就能改用 AIHubMix:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
將 model 設為 auto,即可在請求路徑中進行模型選擇。路由器會分析任務並選擇合適的模型。加上政策後綴,則能明確指定最佳化目標:
| 路由器值 | 優先考量 | 常見的 Agent 步驟 |
|---|---|---|
auto |
優先考量成本 | 批次工作與例行資料轉換 |
auto:balanced |
能力、成本與延遲 | 通用 Agent 工作 |
auto:quality_first |
優先考量能力 | 複雜推理與最終交付內容 |
auto:latency_critical |
優先考量速度 | 互動式循環與輕量規劃 |
路由不會額外收費。請求費用依實際處理該請求的模型牌價計算。回應中會公開解析出的模型和路由詳細資訊,包括 X-Aihubmix-Router-Resolved-Model 標頭,讓這項決策可供觀察,而非成為黑箱。
完整的行為說明、支援的端點、政策及目前限制,請參閱AIHubMix LLM Router 指南。
模型路由不會讓 Agent 取得即時資料
設定模型路由後,Agent 就能為每個步驟挑選更合適的大腦。但除非有工具提供相關能力,否則它仍無法得知模型訓練資料之後發生的變化、存取私人商業系統,或在其他應用程式中執行動作。
許多 Agent 專案就在這裡累積了脆弱的程式碼。團隊先串接一個搜尋 API,再加上一個爬取 API,接著又新增一個資料補充 API。每項整合都會帶來另一個帳戶、憑證、請求格式、錯誤處理方式和計費關係。工具說明往往被複製到系統提示詞中,久而久之就會過時。
這種失敗模式很危險,因為它看起來可能像是成功了。模型可能依據過時的結構描述產生看似合理的呼叫,收到不完整的回應後,仍繼續執行並假設任務已成功。與其要求模型從訓練資料或舊提示詞中記住 API 契約,不如在執行階段檢視結構描述,這樣更安全。
因此,工具層應在執行前回答三個問題:
- 哪些工具能達成這個目標?
- 目前適用的結構描述和價格為何?
- 這次呼叫實際回傳了什麼結果?
工具探索是第二層路由
Monid 將工具存取流程化為探索、檢視和執行。Agent 不必仰賴開發者預先推測可能需要哪些 API,而是可以用自然語言搜尋目錄、檢視候選工具的契約,並執行選定的端點。
基本流程如下:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
透過探索與檢視,Agent 可以在花費任何費用前比較選項。執行費用則依選定端點的計價模式計算。開發者只需維護一項整合,Agent 就能使用多家供應商提供的工具。
對於能讀取設定指示的 Agent 執行環境,Monid 也提供機器可讀的 skill:
Set up https://monid.ai/SKILL.md
Monid 工作流程文件更詳細說明了目錄、檢視和執行階段。
兩個層面如何協同運作
模型閘道和工具層應維持為獨立元件,並透過簡潔明確的交接流程協作:
- Agent 接收使用者目標。
- AIHubMix 將規劃呼叫路由至合適的模型。
- 計畫指出缺少的資訊或需要執行的外部動作。
- Monid 探索候選工具,並提供其結構描述和價格。
- Agent 在權限與預算範圍內選擇並執行工具。
- 工具回傳事實資料或動作結果。
- AIHubMix 依所需的品質、成本或延遲,將綜整呼叫路由至適當的模型。
- Agent 根據工具結果產生答案。
以下是簡化版 Python 範例;模型端的呼叫維持不變,只要將工具結果加入上下文即可:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
重要的不是程式碼有幾行,而是兩種選擇都不需要永久寫死在應用程式邏輯中。模型可以隨著提示詞改變,工具也可以隨著任務改變。
兩個層面都需要成本控管
模型和工具採用不同的計價單位,因此應分開衡量。
在模型層,解析出的模型會決定 token 費用。AIHubMix 讓這項決策可追蹤,並允許開發者選擇路由政策,或限制 API 金鑰可使用的模型。例行步驟可以優先考量成本或延遲,面向使用者的輸出則可以優先考量品質。
在工具層,端點可能按次呼叫或按結果收費。Monid 會在檢視階段、執行之前提供價格。Agent 可以拒絕超出預算的端點、優先選擇經過驗證的選項,或在執行異常昂貴的操作前要求核准。
實用的正式環境控管措施包括:
- 為每個 API 金鑰設定模型允許清單或價格上限。
- 為每項任務設定工具呼叫次數上限。
- 針對受法規規範的資料設定供應商或端點允許清單。
- 建立能串連模型路由決策、工具呼叫和最終答案的記錄。
- 在執行不可逆或敏感操作前明確要求確認。
- 驗證輸出,將工具資料視為不受信任的輸入,而非指示。
這種劃分也能簡化成本除錯。如果一次執行變得昂貴,token 記錄會顯示 Agent 是否推理過多,工具記錄則會顯示它是否擷取過多資料。兩者的解決方式不同,架構應保留這種區別。
可靠性仰賴最新的契約與可見的決策
動態選擇不代表行為不可預測。
在模型端,AIHubMix 會回報每次請求解析出的模型和路由政策。工作階段黏著性可以在多輪工作中維持模型一致性,並享有提示詞快取的效益;必要時,備援機制也能在模型狀況不佳時切換至其他模型。
在工具端,Agent 會在付費呼叫前檢視目前的端點結構描述。探索結果包含比較候選工具所需的資訊,而實際呼叫的結果則是傳入最終生成內容的唯一外部證據。
結合這些控管措施,就能建立實用的稽核軌跡:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
相較於單純取得許多模型或 API 的存取權,這類稽核軌跡更有價值。它能說明 Agent 為何做出每項選擇,以及答案是由哪些證據支持。
不需要同時使用兩個層面的情況
並非每種工作流程都適合動態選擇。
如果應用程式會將同一個穩定的提示詞傳送給一個經過基準測試的模型,直接指定該模型會比路由更簡單、也更具確定性。如果排程流程總是呼叫同一個已知 API,直接整合該 API 也可能比加入探索層更清楚。
當工作負載本身就包含多樣性時,雙層架構才真正派得上用場:
- 不同提示詞之間的差異夠大,因此每個步驟最適合的模型也會不同。
- Agent 會發出多次模型呼叫,因此需要控管累計成本或延遲。
- 在建置時,無法完全預測所需的工具。
- 外部資料必須保持最新,且來源必須清楚可見。
- 團隊希望新增功能時,不必為每項功能都整合一個新的供應商。
依照應用程式實際需要做出的決策,使用模型層、工具層,或同時使用兩者。
以決策為核心建構 Agent,而非依賴項目
生產環境中的 AI Agent,並不是以它能呼叫多少模型或 API 來定義,而是看它能否為目前步驟選擇合適的能力、在預算範圍內運作,並說明發生了什麼事。
AIHubMix 為 Agent 提供統一的模型端點,並能依成本、品質與延遲優先順序在請求時進行路由。Monid 則為它提供執行階段工具探索、最新的結構描述、明確的定價,以及跨外部供應商的執行能力。
一個層面決定 Agent 如何思考;另一個層面決定它如何取得資訊並採取行動。將這些決策分開,能讓 Agent 更容易擴充、觀察與控管。
先參閱 AIHubMix 快速入門,再透過 Monid 串接工具層。
常見問題
什麼是 AI Agent 的模型路由?
模型路由會根據任務類型、能力、成本與延遲等因素,為每項請求選擇模型。在 AIHubMix 中,將 model 設為 auto,或設定如 auto:quality_first 的政策,即可在維持 OpenAI 相容 API 的同時,於請求時選擇模型。
如果 LLM 已經具備知識,為什麼 AI Agent 還需要工具?
LLM 會根據收到的上下文及訓練期間學到的內容生成答案。若未連接工具,它就無法可靠地掌握最新價格、查詢私人資料庫,或執行外部動作。工具提供即時資料與執行能力;模型則負責規劃並解讀結果。
模型閘道與 MCP 伺服器或工具平台是一樣的嗎?
不是。模型閘道會將推論請求路由至模型;MCP 伺服器與工具平台則會向 Agent 提供外部能力。兩者解決的是互補的整合需求,也可以搭配使用。
AIHubMix 和 Monid 可以分開使用嗎?
可以。如果應用程式不需要動態工具,AIHubMix 可用來路由模型呼叫。使用其他模型供應商或閘道的 Agent,也能透過 Monid 探索工具。當 Agent 需要在兩個層面都能於執行階段做選擇時,同時使用兩者會很有幫助。
如何確保自動路由可供稽核?
記錄每項任務的解析後模型、路由政策、工具候選項目、查閱的價格、選定的端點,以及傳回的結果。AIHubMix 會在回應中提供模型路由詳細資訊;Monid 則將探索和檢視與執行分開,讓工具決策能在付費呼叫前記錄下來。