2026 年 8 月 4 日,DeepSeek 官方狀態頁記錄了兩起 API 效能降級事件。
第一起事件持續 1 小時 18 分鐘,從 02:02 到 03:20 UTC,影響 DeepSeek V4 Flash、V4 Pro 和 Expert Mode。第二起事件持續 36 分鐘,從 03:43 到 04:20 UTC,影響 DeepSeek V4 Flash API。
兩起事件目前都已排除。OpenCode 也回報 DeepSeek Flash 因需求空前高漲而面臨容量問題。不過,DeepSeek 官方狀態頁僅確認效能降級,並未公布根本原因。
重點摘要
- DeepSeek 官方狀態頁記錄了 2026 年 8 月 4 日兩起影響 V4 Flash 的效能降級事件。
- 即使同一模型也能透過其他管道取得,直接整合單一供應商仍會形成單點故障。
- 當上游路由回傳可重試錯誤時,AIHubMix 可透過多個供應商通道,重試同一模型。
- 如果主要模型的所有供應商通道都失敗,API 金鑰層級的模型備援功能便可將請求切換至已設定的備用模型。
- 多供應商路由可降低對單一端點的依賴,但無法消除關聯性故障或閘道層級的風險。
這類事件突顯了一項重要的基礎架構原則:
如果透過單一供應商端點存取,再可靠的模型也不夠。
一個模型,不必只對應一家供應商
當應用程式直接連接單一供應商時,該端點就會成為單點故障。
如果供應商發生服務中斷、達到速率限制,或延遲暴增,應用程式就沒有其他地方可傳送請求。即使同一模型仍可透過其他基礎架構供應商使用,使用者還是會遇到逾時和錯誤。
AIHubMix 將模型與提供模型服務的供應商分開。
例如,DeepSeek V4 Flash 可透過 AIHubMix 上的多家供應商使用,包括 DeepSeek、Baidu、DeepInfra 和 Alibaba Cloud。應用程式繼續使用單一 OpenAI 相容 API 端點,而 AIHubMix 則管理可用的上游路由。
這形成兩個不同的可靠性層級。
第一層:供應商故障轉移
供應商故障轉移會維持請求的模型不變,同時切換背後的基礎架構供應商。
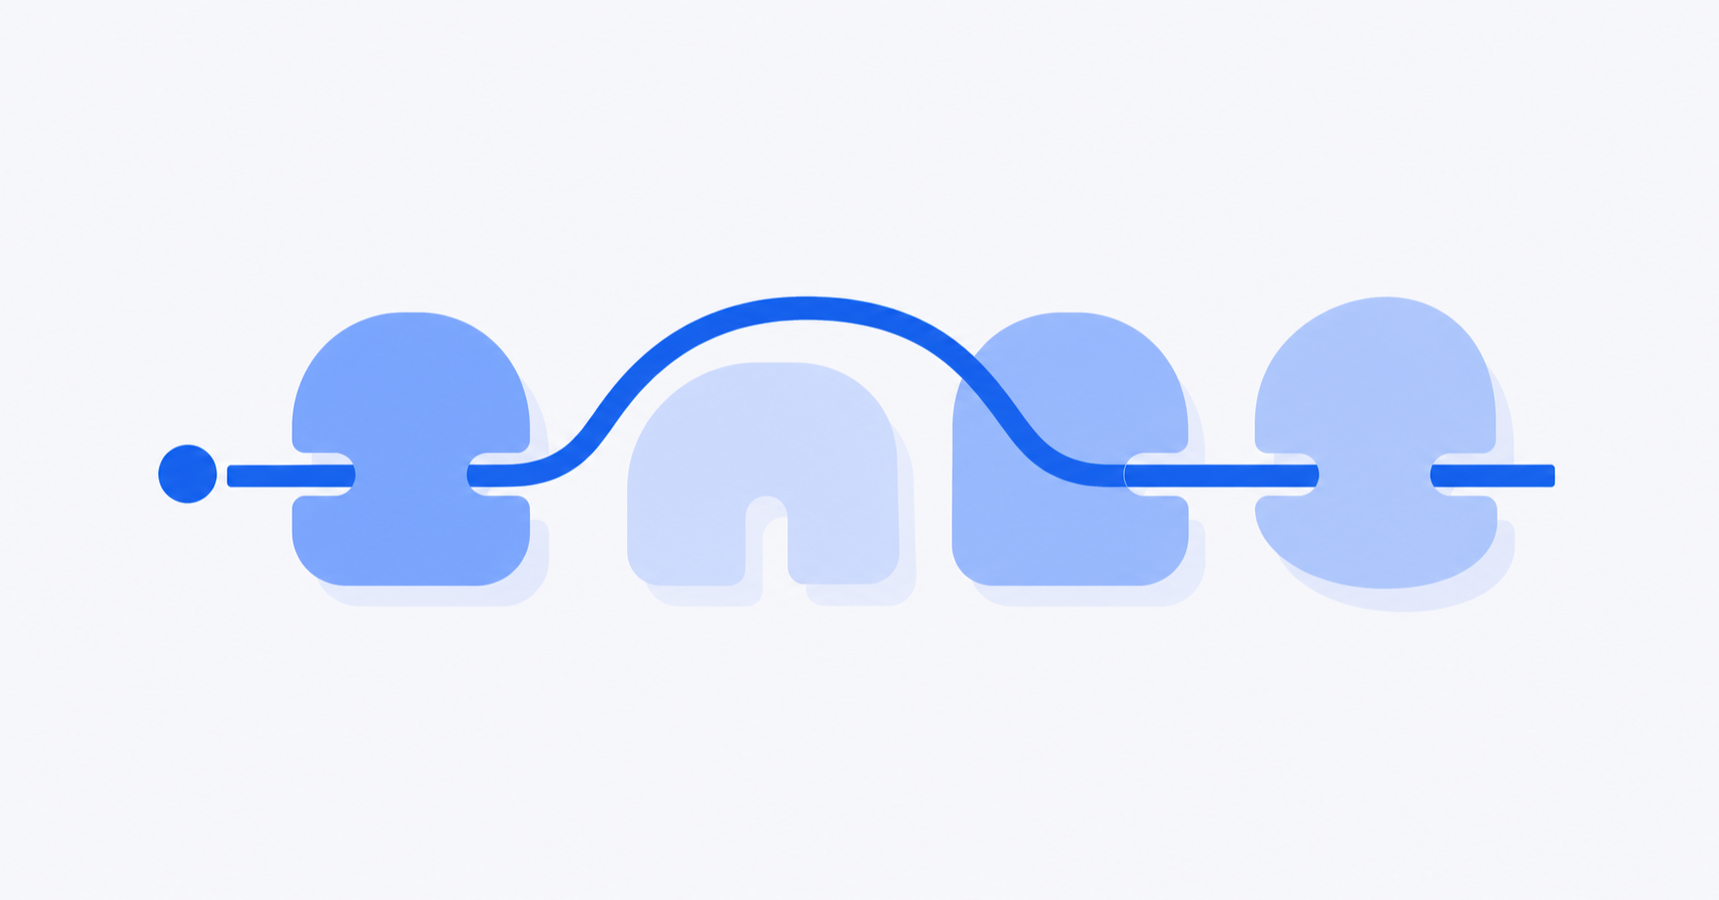
當 DeepSeek V4 Flash 的請求送達 AIHubMix 時,閘道會選擇一個符合條件的供應商通道。如果該通道在回應開始前回傳可重試錯誤,AIHubMix 就能改試同一模型的其他可用通道。
請求路徑可能如下所示:
- 透過供應商 A 嘗試使用 DeepSeek V4 Flash。
- 供應商 A 回傳逾時、5xx 錯誤或可重試的容量錯誤。
- 改透過供應商 B 嘗試使用同一個 DeepSeek V4 Flash 模型。
- 持續嘗試,直到請求成功或所有符合條件的通道都用盡為止。
用戶端不需要整合多家供應商的 SDK、管理不同的 API 金鑰,也不必自行實作重試邏輯。
這就是供應商層級的故障轉移:供應商會切換,但請求的模型維持不變。
第二層:模型備援
如果主要模型的所有可用供應商都無法使用,供應商故障轉移就無從發揮作用。
因此,AIHubMix 支援第二層可靠性機制:模型備援。
使用者可以為每個 API 金鑰設定有順序的備用模型清單。主要模型的所有符合條件通道都回傳可重試錯誤後,AIHubMix 就會切換至備援清單中的下一個模型。
例如:
- 主要模型:
deepseek-v4-flash - 第一個備援模型:
gpt-5.4 - 第二個備援模型:
gemini-3.1-pro-preview
備援會在 AIHubMix 閘道內執行。既有應用程式不需要傳送額外的路由參數,也不必變更用戶端程式碼。
費用依據最終成功回應所使用的模型計算。開發者可以透過回應標頭確認備援行為:
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
完整設定方式和觸發條件請參閱AIHubMix 模型映射與備援文件。
自動故障轉移能處理哪些問題
供應商故障轉移旨在因應下列上游基礎架構問題:
- 供應商逾時
- 連線失敗
- 可重試的 5xx 回應
- 供應商速率限制和容量錯誤
- 上游通道暫時無法使用
如果這些故障發生在回應開始前,AIHubMix 就能自動改試其他路由。
故障轉移無法解決哪些問題
多供應商路由能提升可用性,但無法讓閘道永不故障。
以下情況不會觸發備援:
- 使用者的 AIHubMix API 金鑰無效、已過期或額度不足
- 請求本身無效
- 用戶端中斷連線或達到自身的逾時限制
- 串流回應已開始
- 明確選取了特定供應商通道
- 故障影響所有供應商或閘道本身
供應商故障也可能彼此相關。多家供應商可能仰賴相同的底層基礎架構、模型版本或區域網路。因此,多供應商可用性應以實際流量衡量,而不應只根據供應商數量推定。
為何聚合服務可能比直接連接端點更可靠
直接呼叫官方 API,只會為應用程式提供一條通往模型的路由。
多供應商閘道則能提供多條路由。
如果這些供應商路由的故障彼此獨立,閘道就能繞過效能降級的端點,且不會讓應用程式察覺故障。這能降低對任何單一供應商的依賴,並可能比直接整合單一供應商提供更高的可用性。
兩者的差異在於架構:
- 直接使用 API:一個模型、一家供應商、一個故障範圍
- AIHubMix:一個模型、多家供應商、自動故障轉移
- AIHubMix 搭配模型備援:多家供應商加上備用模型
目標不是預測下一個會故障的供應商,而是將上游事件轉化為內部路由事件,而非客戶可見的服務中斷。
為下一次供應商事件做好準備
DeepSeek V4 Flash 已恢復正常,但暫時性的容量限制、速率限制和上游服務中斷,都是生產環境 AI 基礎架構中常見的狀況。
每當供應商不穩定時,應用程式都不應被迫修改程式碼。
透過 AIHubMix,開發者可使用單一 API 存取多家供應商、自動透過可用通道重試同一模型,並設定備用模型,增添另一層防護。
前往 aihubmix.com/models 探索可用模型與供應商。
常見問題
什麼是多供應商故障轉移?
當目前路由回傳可重試錯誤時,自動透過另一家符合條件的供應商重試同一模型。
模型備援有何不同?
供應商故障轉移會維持模型不變。只有當主要模型的所有符合條件通道都失敗時,模型備援才會切換至已設定的備用模型。
哪些故障會觸發故障轉移?
常見觸發條件包括逾時、連線失敗、可重試的 5xx 回應、速率限制,以及回應開始前發生的暫時性容量錯誤。
故障轉移能保證零停機時間嗎?
不能。供應商間的關聯性故障、閘道層級事件、不可重試錯誤,以及串流開始後發生的故障,仍可能影響用戶端。
我需要修改應用程式程式碼嗎?
不需要額外的路由邏輯。應用程式繼續使用 AIHubMix 的 OpenAI 相容端點,而備用模型則可在 API 金鑰層級進行設定。