Anthropic phát hành Claude Fable 5.2 vào ngày 9 tháng 11 năm 2026. Google đưa Gemini 4 Carbon lên trạng thái khả dụng rộng rãi chỉ một ngày sau đó. Bảng benchmark ra mắt của chính Anthropic có một cột Carbon, nhờ vậy đây là phép so sánh hữu ích cho cùng một khối lượng công việc lập trình kéo dài.
Cả hai model đều được cung cấp cho cùng một nhiệm vụ: lập trình agent kéo dài. Agent đọc một kho mã, chỉnh sửa nhiều tệp, chạy lệnh, đọc kết quả kiểm thử rồi tiếp tục trong 15 đến 45 phút mà không cần con người can thiệp. Đây là tác vụ được chấm điểm ở đây. Trò chuyện, tự động hoàn thành và các tập lệnh ngắn là những bài kiểm tra khác.
Tóm tắt nhanh
Fable 5.2 dẫn đầu các benchmark lập trình khó được liệt kê và nhanh hơn khi cùng mức độ xử lý, chiếm ba vị trí AA đầu tiên, trước Carbon High ở hạng #4. Carbon đạt điểm cao hơn ở các dòng Terminal-Bench 4.0 và AutomationBench-AA được liệt kê, đồng thời có chi phí mỗi tác vụ thấp hơn ở mức High cho đến khi giá ưu đãi ban đầu của Google kết thúc vào ngày 30 tháng 11. Ở mức Medium, Fable rẻ hơn và nhanh hơn nhiều, còn Carbon đạt điểm cao hơn trên chỉ số AA.
Chọn Fable để suy luận mã khó, Carbon để thực thi trên terminal và tự động hóa; hãy kiểm tra giới hạn đầu vào, lưu giữ dữ liệu và đầu ra trước khi dùng một trong hai.
Kết quả từ cùng một bộ kiểm thử
Artificial Analysis chạy mọi model trên cùng một bộ kiểm thử và các tác vụ; trang Carbon và Fable của họ cung cấp kết quả theo từng bài đánh giá. Số liệu lấy từ ảnh chụp ngày 11 tháng 11 năm 2026; AA sử dụng giá niêm yết tiêu chuẩn, không phải giá ưu đãi ban đầu của Google.
| Model | Chỉ số AA | USD/tác vụ | Phút/tác vụ | Token đầu tiên |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Lưu ý: Chỉ số Intelligence Index của AA và chi phí mỗi tác vụ theo giá tiêu chuẩn, ảnh chụp lúc 2026-11-11T05:23Z. Fable Max, Xhigh và High lần lượt xếp hạng #1 đến #3; Carbon High ở hạng #4; Opus 5.5 Max ở hạng #5; Carbon Medium ở hạng #6. Token đầu tiên là thời gian chờ đến token đầu tiên của câu trả lời.
Ở mức High, Fable dẫn trước 1.79 điểm, có chi phí mỗi tác vụ cao hơn 17.0% ($9.08 so với $7.76), hoàn tất trong 17.3 phút thay vì 25.6 phút và trả về token đầu tiên sau 30.4 giây thay vì 67.1 giây. Max có chi phí $26.54 mỗi tác vụ, gấp 3.4 lần Carbon High, và mất 233.9 giây chờ.
Ở mức Medium, thứ tự thay đổi: Fable đạt 56.41 điểm so với 58.26 của Carbon, thấp hơn 1.85 điểm, nhưng có chi phí $3.80 so với $6.59 và mất 7.8 phút so với 23.3 phút. Giá token thấp hơn của Carbon không giúp model này rẻ hơn cho mỗi tác vụ ở đây; nó dùng nhiều token hơn.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Không ảo giác % | 88.58 | 42.02 | 40.73 | 49.66 |
| Độ chính xác % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Lưu ý: Artificial Analysis, cùng bộ kiểm thử và cùng ảnh chụp. Tỷ lệ không ảo giác là tỷ lệ câu trả lời Omniscience không chứa thông tin bịa đặt; độ chính xác là một điểm số riêng. Điểm cao hơn là tốt hơn ở mọi dòng. Không đưa Fable Xhigh vào để bảng dễ đọc hơn; điểm FrontierCode 2.0 của model này là 47.58.
Model nào dẫn đầu từng bài kiểm tra ở mức High? Khoảng chênh lệch có dấu bên dưới được tính bằng Carbon trừ Fable; cách này thể hiện chiều chênh lệch, còn bảng phía trên giữ nguyên điểm số tuyệt đối.
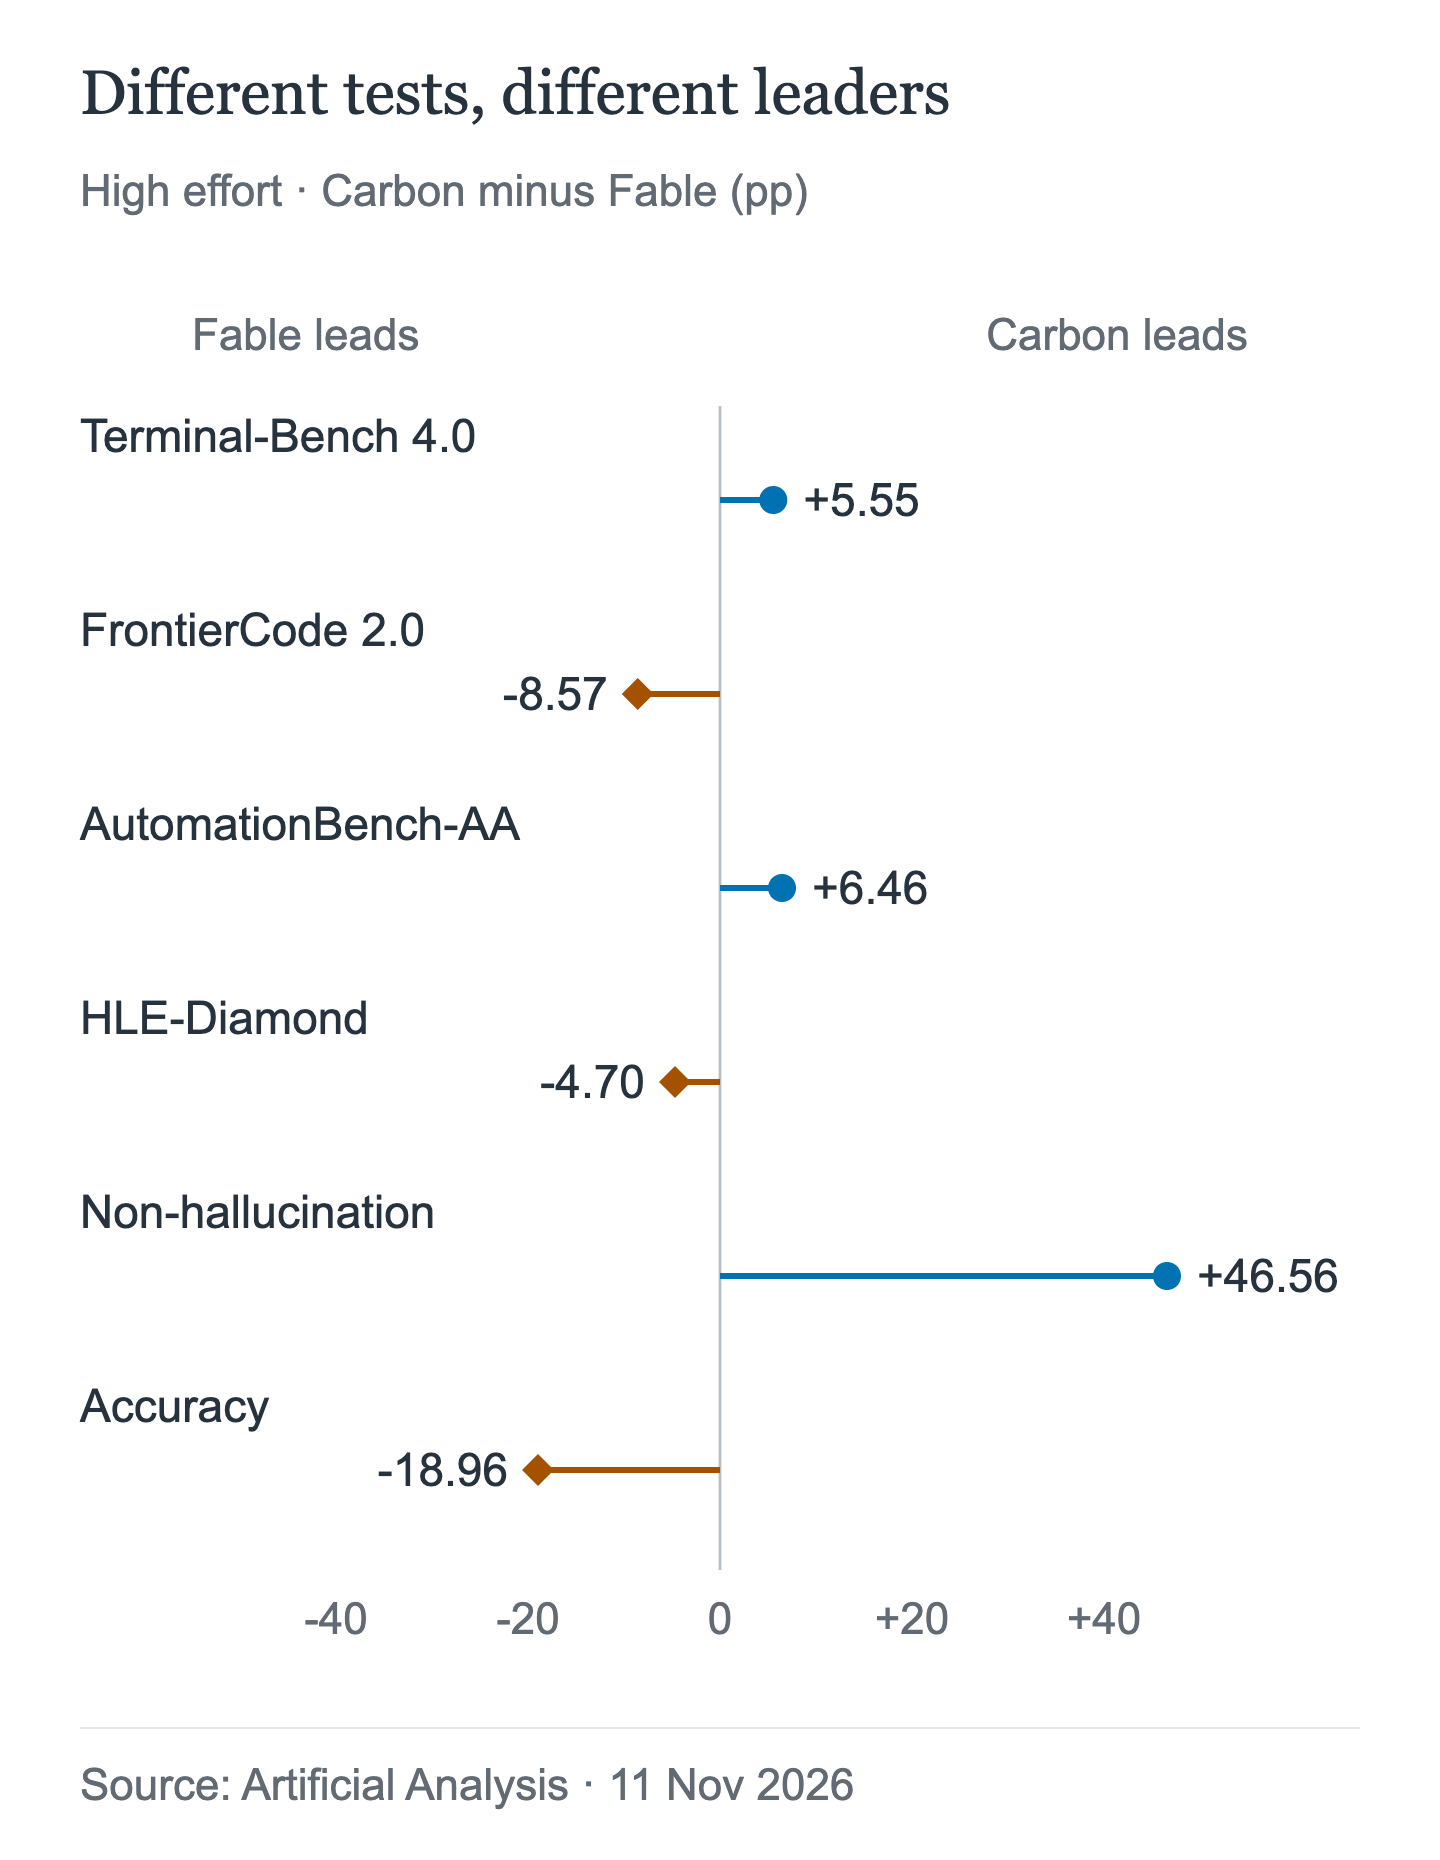
Đây là chênh lệch theo điểm phần trăm giữa các bài kiểm tra độc lập, không phải điểm chất lượng tổng hợp. Chênh lệch lớn hơn ở một benchmark không có nghĩa là năng lực tổng thể được cải thiện nhiều hơn. Đặc biệt, tỷ lệ không ảo giác và độ chính xác đo lường những kết quả khác nhau.
Ở mức High, Fable dẫn FrontierCode 2.0 với 8.57 điểm và HLE-Diamond với 4.7 điểm; Briefcase Elo là 1677.4 so với 1610.6. FrontierCode là benchmark gần nhất với tác vụ thay đổi mã khó trên nhiều tệp. Carbon dẫn Terminal-Bench 4.0 với 5.55 điểm và AutomationBench với 6.46 điểm; các bài này đánh giá khả năng thực thi lệnh, khắc phục sự cố và tự động hóa.
Khoảng chênh lệch về tỷ lệ không ảo giác là lớn nhất trong bảng: Carbon đạt 88.58% so với 42.02% của Fable ở mức High. Độ chính xác lại cho kết quả ngược lại: 58.27% so với 77.23%. Carbon ít có khả năng bịa đặt hơn, nhưng cũng ít có khả năng trả lời đúng hơn. Với agent không được phép tự tạo ra API, điều đó có thể đáng giá; còn với agent cần đưa ra câu trả lời, độ chính xác của Fable là tín hiệu tốt hơn.
Tăng mức độ xử lý không phải lúc nào cũng tốt hơn: điểm FrontierCode của Fable Max là 48.76, thấp hơn đôi chút so với 49.13 của High, còn Terminal-Bench vẫn ở mức 59.6.
Bảng riêng của Anthropic
Trang ra mắt của Anthropic công bố bảng so sánh giữa các nhà cung cấp, có cả Carbon. Thiết lập trong bảng này khác với AA: Fable chạy ở mức Xhigh, mức xử lý cao nhất được báo cáo, còn Carbon chạy ở Medium. Chỉ nên đọc và so sánh các số liệu trong chính bảng này.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Lưu ý: Số liệu do Anthropic tự báo cáo. Fable chạy ở mức Xhigh, mức xử lý cao nhất hiện có; Carbon chạy ở Medium. Thang điểm AutomationBench của Anthropic khác với AA (51.4/53.9 so với 71.36/77.82), vì vậy chỉ so sánh trong bảng này. Điểm FrontierCode 41.1 của Carbon là kết quả chạy ở Medium; mức 40.56 của AA là kết quả ở High trên một bộ kiểm thử khác.
Xu hướng tương đồng với AA: Fable dẫn đầu FrontierCode, FrontierSWE, OSWorld và TB-Science; Carbon dẫn AutomationBench với 2.5 điểm, ít hơn mức 6.5 của AA nhưng cùng chiều. Bảng này ủng hộ nhận định “Carbon có năng lực cạnh tranh trong tự động hóa”, chứ không phải “Carbon là model lập trình khó tốt hơn”.
Khuyến nghị của chính Anthropic khiến nhận định “Fable là bản nâng cấp” trở nên phức tạp hơn: “Với hầu hết tác vụ lập trình và kiến thức, chúng tôi khuyên người dùng bắt đầu với Claude Opus 5.5.” Anthropic cho biết ở mức High, điểm của Fable gần bằng kết quả tốt nhất của Opus 5.5 (45.3% so với 45.5%) với chi phí mỗi tác vụ chỉ bằng khoảng một nửa.
Chi phí token
| Model | Đầu vào | Đầu ra | Đọc bộ nhớ đệm |
|---|---|---|---|
| Carbon, đến 30 tháng 11 | $2 | $10 | $0.10 |
| Carbon, từ ngày 1 tháng 12 | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Lưu ý: USD trên mỗi 1M token, giá chính thức. Ghi bộ nhớ đệm của Fable: $10 (5 phút) hoặc $16 (1 giờ); Batch được giảm giá 50%. Mức giá cho dữ liệu đã được lưu trong bộ nhớ đệm của Carbon là giá đọc; giá đọc bộ nhớ đệm chính thức của Opus 5.5 là $0.20.
Giá token của Fable gấp đôi mức giá tiêu chuẩn của Carbon và gấp bốn lần giá ưu đãi ban đầu. Tỷ lệ này đơn giản, nhưng hóa đơn mỗi tác vụ thì không. AA đo được chi phí $7.76 cho Carbon High ở mức giá $4/$20, so với $9.08 của Fable High, chênh lệch 17.0%. Với mức giá $2/$10 của Google, cùng lượng sử dụng sẽ tốn khoảng $3.88, đây là ước tính tính toán. Đến ngày 30 tháng 11, Fable High có chi phí mỗi tác vụ cao gấp khoảng 2.3 lần; từ ngày 1 tháng 12, chênh lệch trở lại mức 17.0%.
Theo giá tiêu chuẩn, Fable Medium có chi phí $3.80 so với $6.59 của Carbon, thấp hơn 42% dù giá token cao gấp đôi. Carbon mất 23.3 phút và dùng nhiều token hơn; Fable mất 7.8 phút. Theo mức giá ưu đãi ban đầu, Carbon Medium có chi phí khoảng $3.30, tính theo cùng cách, gần bằng Fable; lợi thế này biến mất vào ngày 1 tháng 12.
Chi phí mỗi tác vụ của Max ($26.54) gấp 3.4 lần Carbon High và mất 45.2 phút. Chi nhiều hơn không đồng nghĩa với một agent lập trình tốt hơn trên mọi phương diện: điểm FrontierCode của Max thấp hơn đôi chút so với High.
AIHubMix niêm yết Carbon theo giá ưu đãi ban đầu của Google. Các mức giá Fable ở đây là giá chính thức của Anthropic.
Khác biệt về hành vi ảnh hưởng đến quyết định triển khai
| Khía cạnh | Carbon | Fable 5.2 |
|---|---|---|
| Đầu ra tối đa | 65,536; mức tối đa gốc ≤1,048,576−đầu vào* | 128,000 |
| Ngữ cảnh | 1,048,576 (mức gốc của Google) | 1M |
| Thinking | low / medium / high; mặc định medium | thích ứng; mặc định high |
| Buộc dùng công cụ | có tài liệu về auto* | bất kỳ / công cụ trả về 400 |
| Lấy mẫu | bị bỏ qua; hãy xóa | một số giá trị trả về 400 |
| Lưu giữ dữ liệu | không nêu giới hạn | 30 ngày; không có ZDR |
| Đầu vào | văn bản trên AIHubMix | văn bản, hình ảnh, PDF† |
| Mốc dữ liệu | Tháng 3 năm 2026 | Tháng 6 năm 2026 |
Lưu ý: *Giới hạn cao hơn của Carbon là năng lực giải mã dài gốc của Google; AIHubMix hiện chỉ có tài liệu về đầu vào văn bản và Chat Completions, nên chưa xác nhận hỗ trợ ở cổng trung gian. †Các phương thức đầu vào của Fable lấy từ danh mục model AIHubMix. *AIHubMix có tài liệu về tool_choice="auto", nhưng chưa xác nhận hỗ trợ riêng cho Carbon. Giới hạn đầu ra 128,000 của Fable là giới hạn model được ghi trong tài liệu. ZDR là lưu giữ dữ liệu bằng không.
Buộc gọi công cụ là trở ngại không thể bỏ qua với Fable: “Buộc gọi công cụ (các kiểu tool_choice là any và tool) sẽ trả về lỗi 400.” Agent phải gọi một công cụ cụ thể ở mỗi lượt không thể dùng Fable nguyên trạng. Hướng dẫn Carbon của Google khuyến nghị thực thi công cụ theo các lượt tuần tự; hướng dẫn Gemini của AIHubMix có tài liệu về tool_choice="auto", nhưng hỗ trợ công cụ riêng cho Carbon ở cổng trung gian vẫn chưa được xác nhận.
Lưu giữ dữ liệu là trở ngại về chính sách đối với Fable. Tổng quan của model này cho biết: “yêu cầu lưu giữ dữ liệu trong 30 ngày và không khả dụng với chế độ lưu giữ dữ liệu bằng không, trừ khi được Anthropic cho phép rõ ràng.” Tài liệu về Carbon được tham khảo ở đây không nêu hạn chế như vậy; nhưng điều đó không phải là sự đảm bảo. Các nhóm hoạt động trong lĩnh vực chịu quy định nên xác nhận chính sách của cả hai trước khi triển khai.
Giới hạn tiêu chuẩn 65,536 token của Carbon đáp ứng hầu hết thao tác chỉnh sửa; việc tạo cả tệp có thể chạm giới hạn này. Chế độ nền gốc của Google có thể đạt tối đa 1,048,576 trừ lượng đầu vào, tính phí qua các đoạn chuyển tiếp và có thể trả về incomplete kèm văn bản trống nhưng vẫn tính phí. AIHubMix chưa có tài liệu về cách thức này. Fable trả về 128,000 token trong một phản hồi.
Không model nào cho phép tắt thinking. Carbon có các mức low, medium và high, mặc định là medium, đồng thời bỏ qua các tham số lấy mẫu. “Thinking thích ứng luôn bật và không thể tắt” ở Fable, mặc định là high, và một số giá trị lấy mẫu sẽ trả về lỗi 400.
Google đã cung cấp Carbon cho các nhóm phòng thủ thông qua chương trình Fairwind trước khi model được phát hành rộng rãi. Bộ phân loại của Fable chặn các yêu cầu kiểm thử xâm nhập và khai thác lỗ hổng, đồng thời chuyển sang các model khác cho công việc về an ninh mạng và sinh học. Khi kiểm thử bảo mật, cách model từ chối yêu cầu quan trọng hơn một dòng điểm benchmark.
Opus 5.5 làm cột tham chiếu
Opus 5.5 không phải đối thủ cạnh tranh, nhưng là model tham chiếu do chính Anthropic đưa ra. Với mức giá $4/$20, model đạt 59.11 điểm trên AA, có chi phí $10.04 mỗi tác vụ, mất 25.0 phút và chờ 356.4 giây mới có token đầu tiên — lâu nhất trong bảng (dòng AA là ở mức Max; mặc định là medium). Model dẫn đầu Briefcase Elo với 1800.6 điểm nhưng kém Fable High ở FrontierCode và kém Carbon High ở Terminal-Bench. Anthropic vẫn khuyên dùng Opus 5.5 làm điểm khởi đầu cho hầu hết tác vụ lập trình.
Nên chọn model nào?
Chọn Fable 5.2 khi các thay đổi mã khó là trọng tâm và bạn muốn có kết quả FrontierCode và HLE tốt nhất được đo lường. Ở mức Medium, model này rẻ hơn và nhanh hơn — $3.80 và 7.8 phút so với $6.59 và 23.3 phút của Carbon — trong khi Carbon đạt điểm cao hơn trên chỉ số AA. Chọn Fable nếu bạn cần đầu vào hình ảnh, mốc dữ liệu tháng 6 năm 2026, hoặc chấp nhận lưu giữ dữ liệu trong 30 ngày và không thể buộc gọi công cụ.
Chọn Carbon khi công việc chủ yếu diễn ra trên terminal: các vòng lặp kiểm thử–sửa lỗi, tự động hóa shell và thao tác nhiều bước. Carbon đạt điểm cao hơn ở các mục Terminal-Bench 4.0 và AutomationBench-AA được liệt kê, đồng thời rẻ hơn ở mức nỗ lực High cho đến ngày 30 tháng 11. Ngữ cảnh gốc của Google và giới hạn đầu ra dài chưa được xác nhận qua AIHubMix; chỉ triển khai ở chế độ văn bản với tool_choice="auto" sau khi xác nhận Carbon hỗ trợ công cụ. Điểm không ảo giác của Carbon cao hơn, còn độ chính xác thấp hơn.
Chọn Opus 5.5 nếu muốn bắt đầu với lựa chọn Anthropic khuyến nghị và một hồ sơ cân bằng; hãy chấp nhận token đầu tiên ở mức nỗ lực Max xuất hiện chậm.
Đừng chọn model nào trong hai model này nếu cần độ trễ tương tác: token đầu tiên ở mức nỗ lực High mất 30.4 giây với Fable và 67.1 giây với Carbon; ngay cả 23.2 giây ở mức Medium của Carbon vẫn còn rất xa tốc độ trò chuyện.
Chạy cả hai qua AIHubMix
AIHubMix cung cấp cả hai model qua một khóa và endpoint chat completions dùng chung. ID của Carbon là gemini-4-carbon; trang model ghi rõ chat completions, đầu vào văn bản và mức giá mở bán của Google. ID của Fable 5.2 là claude-fable-5-2; AIHubMix liệt kê Chat Completions, Responses và Anthropic Messages, với cửa sổ ngữ cảnh 1M và đầu ra tối đa 128K. Phạm vi được ghi rõ của Carbon hẹp hơn: chat completions, không phải API Gemini gốc. Gateway cũng thử lại qua nhà cung cấp tốt thứ hai, vì vậy hành vi có thể khác với triển khai chỉ dùng một nhà cung cấp.
Hướng dẫn bắt đầu nhanh trình bày cách xác thực và URL cơ sở. Có thể chạy kiểm tra nhanh để xem cả hai ID có hoạt động với cùng một khóa hay không; bản nháp này chưa chạy thử trực tiếp:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Phép kiểm tra này xác minh định tuyến, không phải khả năng: không dùng công cụ và không tạo đầu ra dài. Để so sánh thực tế, hãy chạy cùng một dấu vết agent qua cả hai ID và ghi lại thời gian hoàn thành tác vụ, lượng token sử dụng và lỗi. Trang so sánh đặt cửa sổ ngữ cảnh, giao thức và giá cả cạnh nhau.
Câu hỏi thường gặp
Gemini 4 Carbon có tốt hơn Fable 5.2 cho lập trình hướng agent không?
Không model nào thắng ở mọi khía cạnh công việc. Fable 5.2 dẫn đầu FrontierCode 2.0 và chỉ số tổng thể ở mức nỗ lực High; Carbon dẫn đầu Terminal-Bench 4.0 và AutomationBench. Hãy chọn theo khối lượng công việc mà agent thực sự xử lý.
Vì sao Fable 5.2 có giá cao gấp bốn lần Carbon?
Theo mức giá chính thức, Fable có giá $8/$40 cho mỗi triệu token, so với mức giá mở bán $2/$10 của Carbon, tức gấp bốn lần cho cả token đầu vào lẫn đầu ra. So với mức giá tiêu chuẩn $4/$20 của Carbon kể từ ngày 1 tháng 12, giá của Fable cao gấp đôi.
Fable 5.2 thực sự có chi phí thấp hơn cho mỗi tác vụ ở mức Medium không?
Theo giá tiêu chuẩn thì đúng: $3.80 so với $6.59 ở mức Medium của Carbon, và mất 7.8 phút so với 23.3 phút. Mức giá token mở bán của Carbon thu hẹp chênh lệch; phép so sánh theo giá tiêu chuẩn mới là mốc ổn định lâu dài.
Fable 5.2 có thể buộc thực hiện một lần gọi công cụ không?
Không. Anthropic ghi rõ các giá trị any và tool của tool_choice sẽ trả về lỗi 400. Agent cần buộc thực hiện một lần gọi phải dùng vòng lặp khác hoặc model khác.
Carbon ít có khả năng ảo giác hơn Fable 5.2 không?
Theo thước đo không ảo giác Omniscience của AA thì có: 88.58% so với 42.02% ở mức High. Tuy nhiên, độ chính xác của Carbon thấp hơn, 58.27% so với 77.23%, nên khả năng đưa ra câu trả lời đúng cũng thấp hơn.
Có thể chạy cả hai model qua AIHubMix bằng một khóa không?
Có. Dùng gemini-4-carbon và claude-fable-5-2 với cùng một khóa và URL cơ sở. AIHubMix ghi rõ Carbon hỗ trợ chat completions, còn Fable hỗ trợ chat completions, Responses và Messages.
Đọc tiếp: loạt bài Gemini 4 Carbon
- Trước khi chọn đối thủ, hãy giải đáp câu hỏi về model cùng dòng: Gemini 4 Carbon so với Argon: Cùng giá, khi nào nên chọn Carbon?
- Khi đã đưa Carbon vào vòng lặp, những lỗi 400 đầu tiên và các lần hết thời gian chờ thường là do cấu hình, không phải model: Di chuyển API Gemini 4 Carbon: Lỗi 400, hết thời gian chờ và giới hạn đầu ra
Nguồn
- Gemini 4 Carbon hiện đã ra mắt — Google, ngày 10 tháng 11 năm 2026.
- Claude Fable 5.2 — Anthropic, ngày 9 tháng 11 năm 2026.
- Tổng quan về Claude Fable 5.2 — Tài liệu Anthropic.
- Gemini 4 Carbon và Claude Fable 5.2 — Artificial Analysis, dữ liệu chụp nhanh ngày 11 tháng 11 năm 2026.
- Gemini 4 Carbon trên AIHubMix — Trang model và giá.