Gemini 4 Carbon không phải một dòng model mới. Đây là Gemini 4 Argon với lượng suy luận mỗi lượt nhiều hơn, nhưng cùng giá trên mỗi token: $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra theo mức giá ưu đãi đến hết November 30, 2026; từ December 1, giá lần lượt là $4 và $20. Câu hỏi không phải model nào rẻ hơn trên mỗi token. Hai model có giá giống hệt nhau. Câu hỏi là liệu phần suy luận tăng thêm có mang lại đủ giá trị cho mỗi tác vụ hoàn thành để xứng đáng với phản hồi đầu tiên chậm hơn hay không.
Số liệu trực tiếp của Artificial Analysis đưa ra câu trả lời rõ ràng cho một kiểu công việc và lời cảnh báo cũng rõ ràng cho kiểu khác. Carbon High đứng thứ #4 trong 104 model trên AA Intelligence Index với điểm 60.03, so với 50.41 của Argon High. Chi phí mỗi tác vụ là $7.76, so với $9.95, và thời gian hoàn thành là 25.6 phút, so với 29.0 phút. Nhưng thời gian đến token trả lời đầu tiên của Carbon là 67.1 giây, so với 40.1 giây của Argon. Carbon là model tốt hơn cho hàng đợi. Argon là model tốt hơn cho hội thoại.
Sự khác biệt đó chính là trọng tâm của bài viết. Bên dưới: những gì đã thay đổi, số liệu cho thấy điều gì, model card của Google bổ sung thông tin gì, giá thay đổi ra sao vào December 1 và những khối lượng công việc nào nên tiếp tục dùng Argon.
Những thay đổi so với Argon
Model card của Google nêu rõ mối quan hệ này: “Gemini 4 Carbon được xây dựng dựa trên Gemini 4 Argon.” ID model là gemini-4-carbon, tương tự trên AIHubMix. Google ghi rõ cửa sổ ngữ cảnh 1,048,576 token. Các mức suy luận gồm low, medium và high; mặc định là medium. Đầu ra thông thường là 65,536 token; đường giải mã dài nguyên bản của Google có thể đạt tối đa 1,048,576 token trừ đi phần đầu vào, trong đó 131,072 và 262,144 là các ví dụ. Hiện AIHubMix chỉ ghi rõ Chat Completions, vì vậy hãy giữ các yêu cầu gửi qua gateway ở mức 65,536 token trở xuống cho đến khi có tài liệu về đường xử lý lớn hơn. Mốc kiến thức là March 2026. Google không cung cấp model này trong gói miễn phí.
Thay đổi được mô tả trong ghi chú AI Studio của Google: “Carbon dùng nhiều token suy luận hơn mỗi lượt để xem xét kỹ lưỡng và kiểm chứng kết quả, làm tăng lượng token sử dụng và độ trễ mỗi lượt so với Argon.” Câu đó giải thích gần như mọi khác biệt được đề cập sau đây. Suy luận nhiều hơn nâng mức tối đa trên các tác vụ khó, tăng chi phí mỗi lượt và kéo dài thời gian chờ trước token đầu tiên.
Việc di chuyển được thiết kế đơn giản hết mức. “Nâng cấp từ Argon không đòi hỏi thay đổi schema của yêu cầu.” Ở cấp API, chỉ cần đổi chuỗi model. Lời khuyên vận hành của Google là “giữ thinking_level ở mức medium (mặc định), trừ khi khối lượng công việc cần high, đồng thời đảm bảo max_output_tokens và thời gian chờ HTTP đủ dài cho các lượt suy luận lâu hơn.”
Đánh đổi theo số liệu: suy luận nhiều hơn, chi phí mỗi tác vụ thấp hơn
Các số liệu bên dưới là kết quả đo trực tiếp của Artificial Analysis, được truy cập lúc 2026-11-11T05:23Z (các trang model được kiểm tra lại lúc 06:01Z, không thay đổi), theo giá thông thường là $4 cho mỗi triệu token đầu vào và $20 cho mỗi triệu token đầu ra.
Phép so sánh hữu ích là chất lượng so với chi phí hoàn thành tác vụ: Carbon có đạt chỉ số cao hơn với hóa đơn thấp hơn không? Biểu đồ tách riêng bốn cấu hình model.
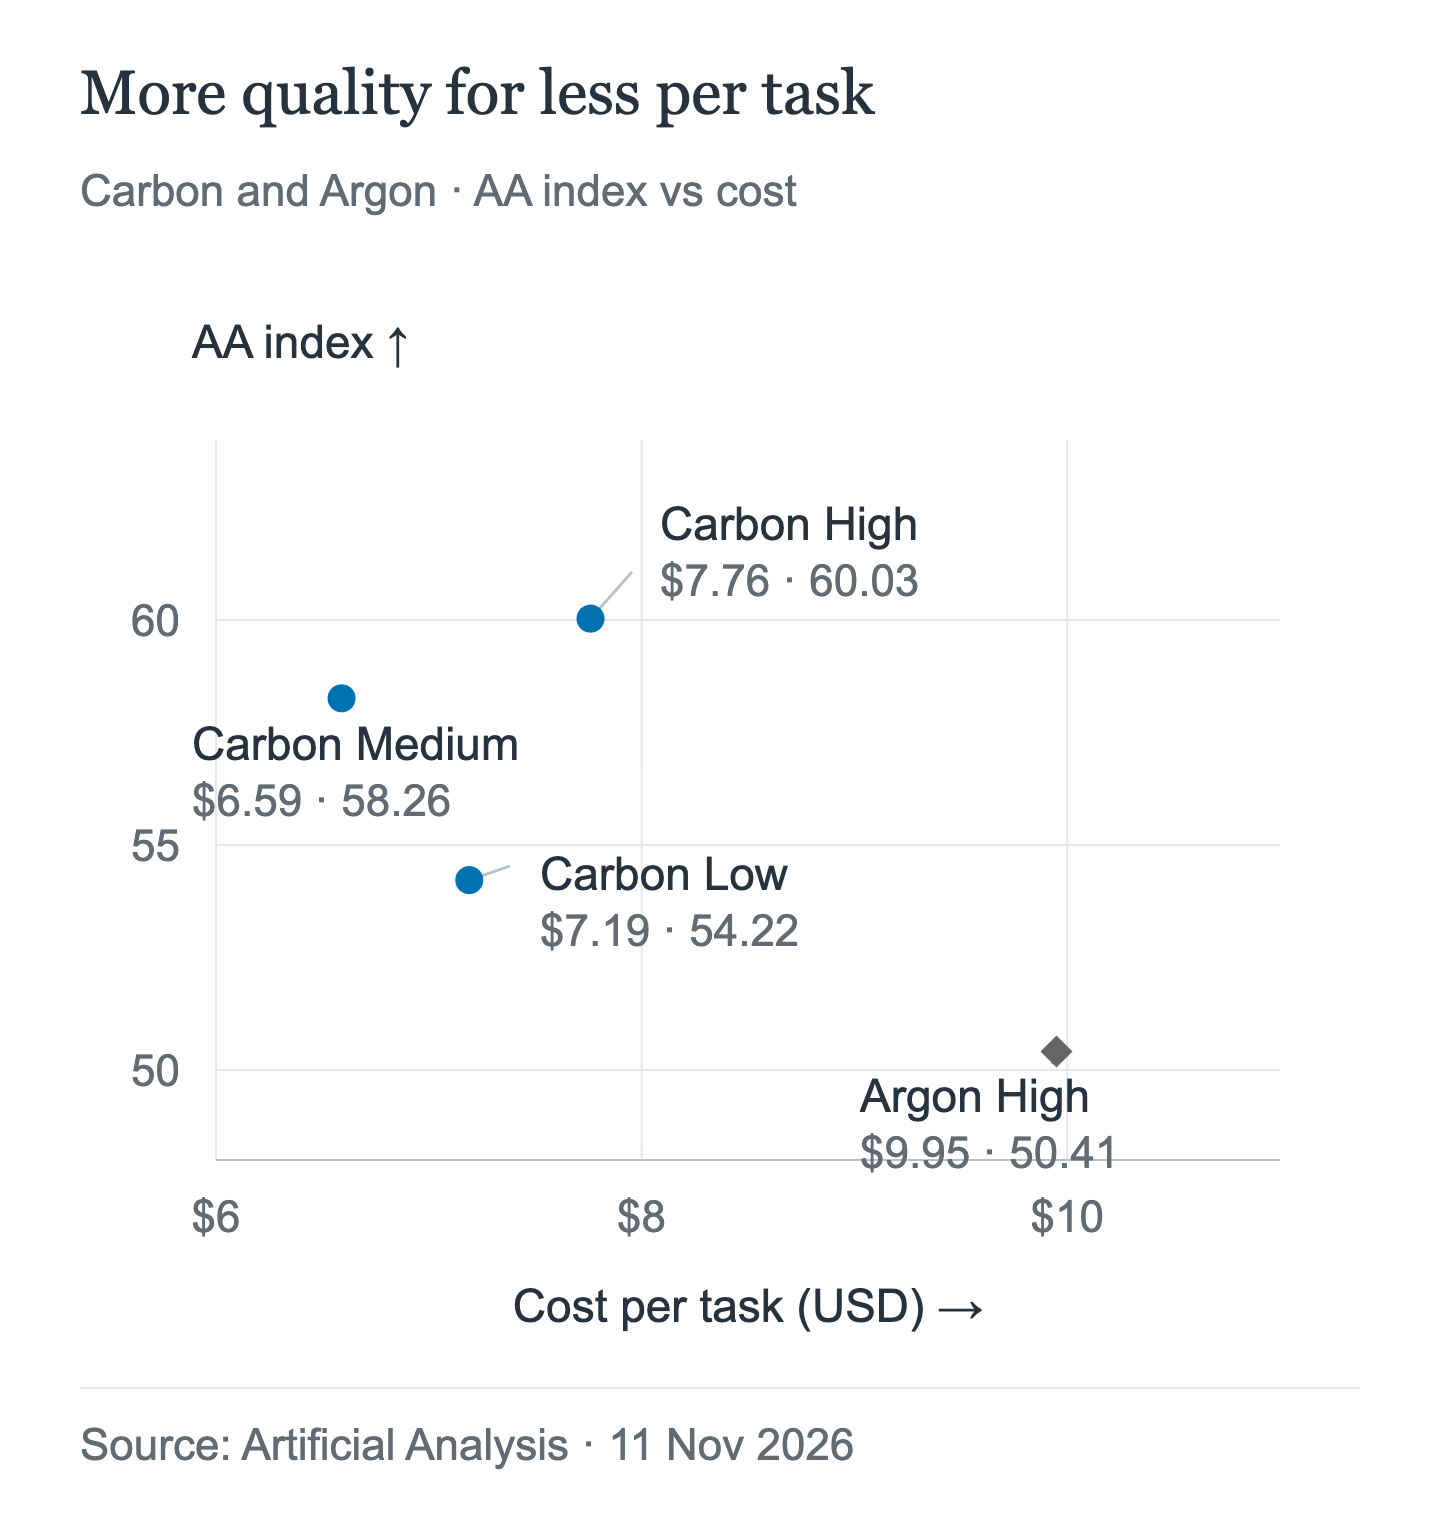
Carbon High nằm cao hơn và lệch về bên trái so với Argon High. Trong lần chạy này, Medium là thiết lập Carbon rẻ nhất; Low là lựa chọn ưu tiên độ trễ, chứ không phải lựa chọn có chi phí thấp nhất. Đây là chi phí tác vụ AA theo giá thông thường, không phải hóa đơn yêu cầu trên AIHubMix.
| Model | Chỉ số AA | $/tác vụ | Phút/tác vụ | Token đầu tiên | Token đầu ra/giây |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium và Low lần lượt xếp thứ #4, #6 và #14 trong 104 model; Argon High đứng sau cả ba. Ba cấu hình đứng trên Carbon High đều thuộc Claude Fable 5.2. “Token đầu tiên” là thời gian đến token trả lời đầu tiên. So sánh Carbon High với Argon High: cao hơn 9.62 điểm chỉ số, chi phí mỗi tác vụ thấp hơn 22.0%, thời gian lần lượt là 25.6 và 29.0 phút, nhưng thời gian đến token trả lời đầu tiên lần lượt là 67.1 và 40.1 giây.
Khoảng cách về chỉ số đủ lớn để làm thay đổi thứ hạng trên bảng xếp hạng. Chênh lệch độ trễ đủ lớn để ảnh hưởng đến việc người dùng có phải chờ hay không. Cả hai điều đều thể hiện trong cùng một hàng.
Artificial Analysis nhận xét Carbon “đặc biệt chậm trên mỗi tác vụ và tạo đầu ra rất dài”, đồng thời cho biết model đã tạo 205 triệu token để chạy chỉ số, so với 113 triệu của Argon và mức trung vị 72.8 triệu của các model được đo. Trong lần chạy AA này, chi phí mỗi tác vụ thấp hơn dù lượng đầu ra lớn hơn nhiều: cùng mức giá niêm yết, nhiều token hơn đáng kể nhưng tổng chi phí tác vụ thấp hơn.
Có một điểm bất thường cần được nêu riêng. Carbon Low tốn $7.19 mỗi tác vụ, cao hơn Medium ở mức $6.59, dù suy luận ít hơn. Dù nguyên nhân là gì, Low hoạt động như một thiết lập ưu tiên độ trễ chứ không phải giảm chi phí, vì vậy hãy đo chi phí trên mỗi tác vụ trước khi chuyển lưu lượng sang dùng nó.
Góc nhìn từ coding agent
Intelligence Index lấy trung bình kết quả của nhiều tác vụ. Coding Agent Index v2 gần với những gì khách hàng API thực sự chạy hơn: một coding agent có công cụ, được đo đầu-cuối trên cùng bộ kiểm thử. Carbon High xếp thứ #4; Argon High xếp thứ #11.
| Thứ hạng | Agent + model | Chỉ số | $/tác vụ | Phút/tác vụ | Trúng bộ nhớ đệm |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Cùng agent, cùng bộ kiểm thử, khác model, nên phép so sánh cô lập yếu tố model thay vì bộ khung. Carbon có chi phí mỗi tác vụ thấp hơn 34.0%, cao hơn 6.2 điểm chỉ số, nhanh hơn 4.9 phút và tạo ra lượng đầu ra gần như tương đương mỗi tác vụ: 109,031 token so với 109,236. Tỷ lệ trúng bộ nhớ đệm cao hơn, 0.95 so với 0.87, và lượng đầu vào sử dụng thấp hơn, 12.44 triệu token so với 13.76 triệu.
Có hai điểm cần lưu ý. Carbon xếp thứ #4 trong chỉ số này: Claude Code với Opus 5.5 Max dẫn đầu ở mức 61.7, tiếp theo là Devin Fusion CLI và GitHub Copilot Fusion. Ngoài ra, Fable 5.2 hoàn toàn không có trong chỉ số, nên bảng này không thể kết luận câu hỏi Carbon so với Fable.
Model card của Google bổ sung điều gì và không bổ sung điều gì
Model card của Google là tài liệu do nhà cung cấp công bố: kết quả tính đến October 2026, do Google tự báo cáo và thuộc một đợt chụp dữ liệu khác với số liệu trực tiếp ở trên. Trong các hàng bên dưới, điểm Carbon của Google đều cao hơn.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (nhà cung cấp) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
Hàng AA là điểm 59 đã được Google làm tròn, không phải mức 60.03 trực tiếp ở bảng trước; hai số liệu đến từ các đợt chụp dữ liệu khác nhau và không nên trộn lẫn. Phép so sánh bên ngoài trong model card là với Fable 5.1, không phải Fable 5.2.
Điểm hữu ích là tính nhất quán: mức cải thiện không chỉ xuất hiện ở một benchmark. Giới hạn cũng rất rõ. Model card của nhà cung cấp không định giá một tác vụ, không đo độ trễ token đầu tiên và không cho biết agent của bạn sẽ cần bao nhiêu lượt. Tài liệu này ủng hộ nhận định “nhìn chung Carbon là model mạnh hơn”. Nhưng không chứng minh được rằng “Carbon là model phù hợp hơn cho vòng lặp của bạn”.
Giá: cùng biểu giá, cùng thay đổi vào December 1
Carbon và Argon trùng khớp ở mọi mức giá. Cả hai đều áp dụng giá ưu đãi đến hết November 30, 2026, và giá của cả hai tăng gấp đôi vào December 1.
| Model | Đầu vào | Đầu ra | Đọc từ bộ nhớ đệm |
|---|---|---|---|
| Carbon, giá ưu đãi (đến Nov 30) | $2.00 | $10.00 | $0.10 |
| Carbon, từ Dec 1 | $4.00 | $20.00 | $0.20 |
| Argon, giá ưu đãi (đến Nov 30) | $2.00 | $10.00 | $0.10 |
| Argon, từ Dec 1 | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Giá chính thức bằng USD cho mỗi triệu token, ngày November 11, 2026. Gemini 3.1 Pro Preview có giá $4/$18/$0.40 khi prompt vượt quá 200k token, cộng thêm $4.50 cho mỗi triệu token mỗi giờ lưu trữ. Phí ghi vào bộ nhớ đệm của Fable 5.2 là $10 cho năm phút hoặc $16 cho một giờ; xử lý theo lô được giảm 50%. Giá ưu đãi của Carbon và Argon kết thúc vào November 30; mọi mức giá của Carbon và Argon đều tăng gấp đôi vào December 1.
AIHubMix niêm yết Carbon ở mức $2/$10/$0.10, tương ứng với giá ưu đãi của Google. Bài viết này không giả định mức giá gateway áp dụng sau November 30; hãy kiểm tra trang model để xem giá hiện tại.
Tính lại lượng token đo được của Artificial Analysis theo giá ưu đãi cho ra ước tính sơ bộ chi phí mỗi tác vụ là $3.88 cho Carbon High, $3.30 cho Medium, $3.60 cho Low và $4.98 cho Argon High. Đây là các ước tính đã tính toán, không phải số liệu đo của AA: phép tính giữ nguyên cơ cấu token của mỗi tác vụ, còn prompt và tỷ lệ trúng bộ nhớ đệm của bạn sẽ làm thay đổi kết quả.
Tính trên mỗi token, Fable 5.2 đắt gấp đôi Carbon theo giá thông thường và gấp bốn lần theo giá ưu đãi. Đó là chênh lệch về giá, không phải kết luận về chất lượng; bài viết thứ ba trong loạt bài sẽ đề cập đến phép so sánh này.
Khi Carbon không phải lựa chọn tốt hơn
Lý do không chọn Carbon không phải vì nó kém hơn. Mà là vì thứ nó mang lại — suy luận nhiều hơn mỗi lượt — lại là thứ mà một sản phẩm tương tác không thể đánh đổi.
Token đầu tiên đến muộn. Carbon High chờ 67.1 giây mới đưa ra token trả lời đầu tiên; Argon High chờ 40.1 giây. Medium rút thời gian chờ xuống còn 23.2 giây và Low còn 12.9 giây, nhưng cả hai đều phải đánh đổi bằng điểm chỉ số thấp hơn. Một giao diện trò chuyện tạm dừng cả phút thì lượt tương tác đã thất bại, bất kể câu trả lời khi xuất hiện trông ra sao.
Google khuyên nên giữ Argon để có tốc độ. Argon được định vị là lựa chọn cho “phản hồi nhanh hơn và lượng token dùng mỗi lượt thấp hơn”, phù hợp với “lập trình tương tác, công việc tính năng hằng ngày và các vòng lặp sản xuất nhanh”. Chỉ dẫn trong ghi chú di chuyển rất thẳng thắn: “Hãy giữ Argon ở những nơi tốc độ là yếu tố quan trọng.” Bài đăng thông báo của Google cũng nhắc lại ý này: “Argon vẫn là lựa chọn lý tưởng cho phần lớn công việc kỹ thuật phần mềm và xử lý tri thức.”
Chi phí mỗi lượt cao hơn dù chi phí mỗi tác vụ thấp hơn. Giá trên mỗi token không đổi, nhưng Carbon dùng nhiều token suy luận hơn mỗi lượt. Một nhóm theo dõi lượng token tiêu thụ mỗi lượt hoặc phải phân bổ hạn mức token sẽ thấy Carbon là model đắt hơn. Lần chạy chỉ số dùng 205 triệu token so với 113 triệu của Argon là ví dụ cực đoan cho tác động này.
Low không phải lựa chọn tiết kiệm. Với mức $7.19 mỗi tác vụ, Carbon Low đắt hơn Medium ở mức $6.59. Nếu tiêu chí định tuyến là chi phí cho mỗi tác vụ hoàn thành, Low không đáp ứng được.
Thắng benchmark không thể bù lại thời gian chờ. OSWorld-2.1 và FrontierSWE 2 đều nghiêng về Carbon trong bảng của Google, nhưng đó là số liệu do nhà cung cấp báo cáo và không mục nào thay đổi được thời gian chờ token đầu tiên. Benchmark đo kết quả cuối; người dùng cảm nhận khoảng chờ lúc bắt đầu.
Ai nên chuyển ngay, ai nên tiếp tục dùng Argon
Chuyển sang Carbon ngay nếu bạn chạy các tác vụ batch gốc của nhà cung cấp hoặc tác vụ agent chạy nền (AIHubMix chưa có tài liệu về các cách này cho Carbon), nếu một lần chất lượng không đạt gây tốn kém hơn thời gian thực, nếu yêu cầu của bạn có thể chấp nhận thời gian chờ lâu hơn và ngân sách đầu ra lớn hơn, hoặc nếu bạn đang phải trả phí cho các lần thử lại mà Carbon có thể giúp tránh được.
Tiếp tục dùng Argon nếu bạn xây dựng ứng dụng chat, tự động hoàn thành hoặc bất kỳ vòng lặp nào có người chờ phản hồi; nếu ngân sách hoặc hạn mức của bạn được tính theo lượt; hoặc nếu sản phẩm yêu cầu độ trễ dưới khoảng 30 giây.
Hãy thử nghiệm trước nếu bạn chưa chắc. Gửi cùng 20 đến 50 yêu cầu thực tế qua cả hai model, ghi lại thời gian nhận token đầu tiên và chi phí cho mỗi tác vụ hoàn thành, rồi định tuyến dựa trên các số liệu đó thay vì chỉ số xếp hạng. Trang so sánh của AIHubMix hiển thị trang của hai model cạnh nhau.
Cách gọi model qua AIHubMix
Carbon sử dụng cùng mẫu ID model trên AIHubMix và endpoint chat-completions được ghi trong tài liệu.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Endpoint là POST /v1/chat/completions; đây là tuyến duy nhất AIHubMix có tài liệu cho model này. Văn bản là phương thức đầu vào được liệt kê. AIHubMix chưa có tài liệu về đầu vào hình ảnh và PDF, Responses API, Anthropic Messages và endpoint Gemini gốc cho Carbon, vì vậy hãy xem chúng là chưa được xác nhận. Điều tương tự cũng áp dụng cho ánh xạ reasoning_effort: đừng cho rằng gateway sẽ chuyển tiếp tham số cấp độ suy luận. Hãy giữ max_tokens trong giới hạn đầu ra tiêu chuẩn 65,536; các giới hạn lớn hơn cần chế độ nền của Google và chưa được xác nhận trên AIHubMix. Bài viết này không thực hiện kiểm thử trực tiếp, vì vậy ví dụ minh họa cấu trúc yêu cầu chứ không phải phản hồi đã được xác minh.
Câu hỏi thường gặp
Carbon có giá bằng Argon không?
Có. Giá chính thức của Google giống hệt nhau: $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra đến hết ngày 30 tháng 11, 2026, sau đó là $4 và $20. Giá đọc từ bộ nhớ đệm lần lượt là $0.10 và $0.20.
Carbon có tốt hơn Argon không?
Xét về chất lượng và chi phí cho mỗi tác vụ hoàn thành thì có, theo số liệu đo của Artificial Analysis: 60.03 so với 50.41 trên Intelligence Index và $7.76 so với $9.95 cho mỗi tác vụ. Xét về khả năng phản hồi thì không: token trả lời đầu tiên mất 67.1 giây, so với 40.1 giây.
Vì sao Carbon chậm hơn nếu hoàn thành tác vụ nhanh hơn?
Carbon chờ lâu hơn trước khi trả lời, nhưng sau đó hoàn thành toàn bộ tác vụ nhanh hơn: 25.6 phút so với 29.0 phút. Thời gian chờ token đầu tiên và tổng thời gian hoàn thành tác vụ là hai phép đo khác nhau, và chúng cho kết quả trái ngược nhau.
Có cần thay đổi các yêu cầu không?
Không. Google cho biết nâng cấp từ Argon không cần thay đổi schema; chuỗi model đổi thành gemini-4-carbon. Hãy tăng giới hạn đầu ra và thời gian chờ HTTP để đáp ứng quá trình suy luận lâu hơn.
Vì sao Carbon Low có chi phí mỗi tác vụ cao hơn Medium?
Artificial Analysis đo được $7.19 cho Low so với $6.59 cho Medium. Hãy xem Low là thiết lập độ trễ, không phải thiết lập giảm giá, và đo chi phí mỗi tác vụ trước khi gửi lượng lớn yêu cầu qua đó.
Carbon xếp hạng ở đâu trên Artificial Analysis?
Model đứng #4 trên Intelligence Index, sau ba cấu hình Claude Fable 5.2. Thẻ model của Google hiển thị điểm làm tròn là 59 cho cùng chỉ số; con số hiện tại là 60.03, và không nên đánh đồng hai số liệu này.
Carbon có trong gói miễn phí không?
Không. Google không cung cấp Gemini 4 Carbon trong gói miễn phí, vì vậy bạn cần dùng API trả phí hoặc một gateway như AIHubMix để truy cập.
Đọc tiếp: loạt bài Gemini 4 Carbon
- Nếu bài viết này thuyết phục bạn thử Carbon nhưng yêu cầu đầu tiên bị lỗi, hướng dẫn di chuyển sẽ đề cập đến lỗi 400, cài đặt thời gian chờ và giới hạn đầu ra thay đổi khi các lượt suy luận kéo dài hơn: Di chuyển API Gemini 4 Carbon: Lỗi 400, thời gian chờ và giới hạn đầu ra.
- Nếu bạn đang băn khoăn liệu Carbon có đủ mạnh cho lập trình bằng agent hay mức giá cao hơn của Fable 5.2 có đáng hay không, bài viết thứ ba đặt các số liệu đo tương tự cạnh Fable 5.2: Gemini 4 Carbon so với Fable 5.2: Model nào phù hợp cho lập trình bằng agent?.
Nguồn
- Google AI Studio, Gemini 4 Carbon: điểm mới
- Google DeepMind, Thẻ model Gemini 4 Carbon
- Google AI Studio, Giá Gemini API
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon