
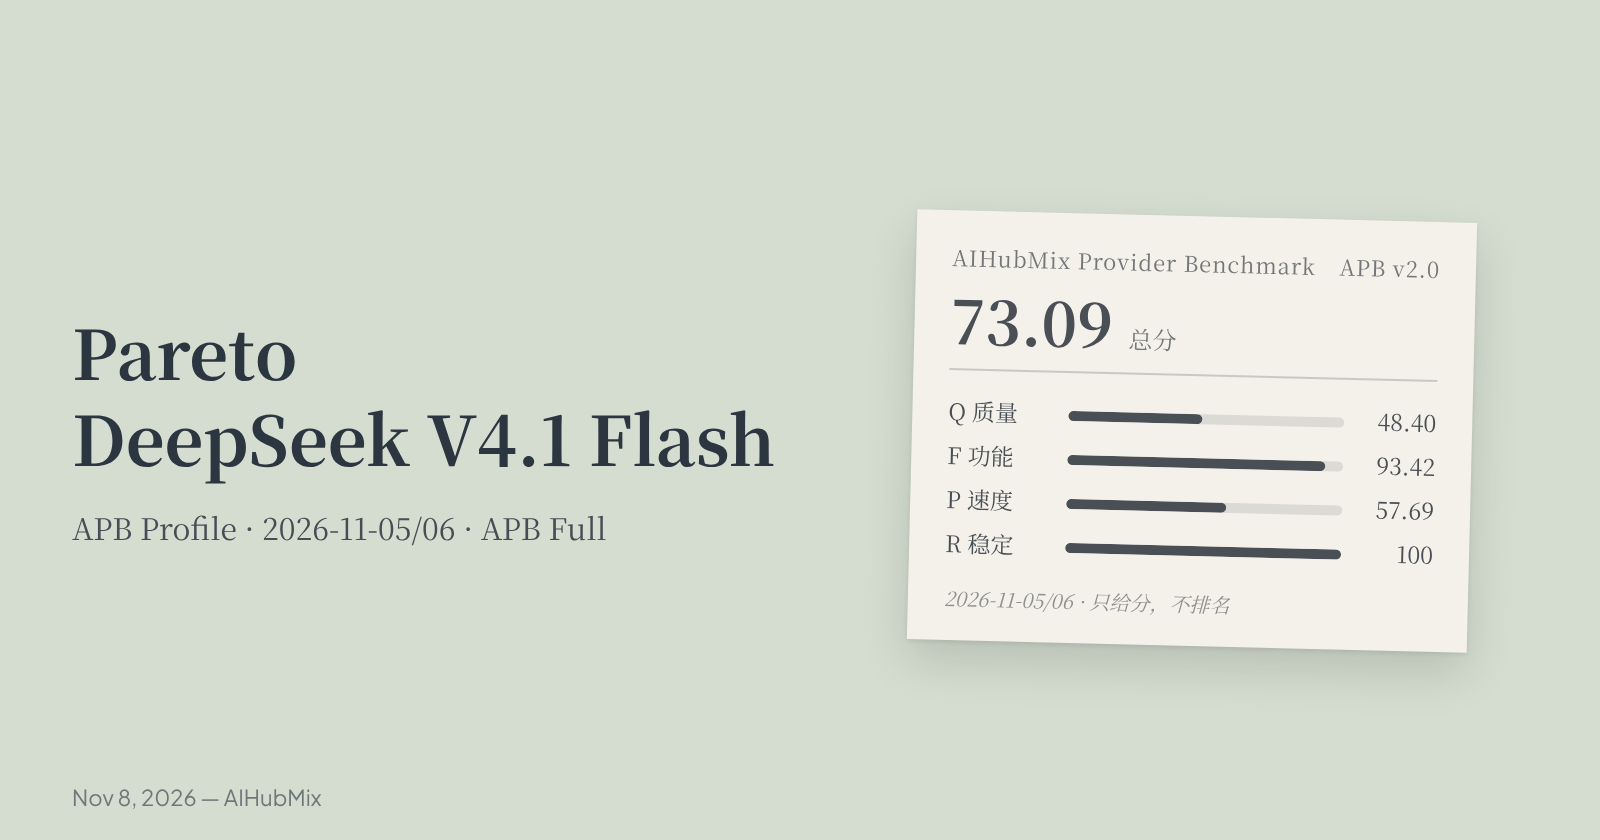
Trong ngày 2026-11-05/06, DeepSeek V4.1 Flash 1017 được chạy qua bộ đầy đủ AIHubMix Provider Benchmark (APB) trên Pareto. Điểm số là Q 48.40, F 93.42, P 57.69, K 27.58 và R 100; chỉ số tổng thể là 73.09. APB Profile này chỉ bao gồm Pareto. Model được liệt kê là DeepSeek V4.1 Flash 1017.
Bài viết này chỉ báo cáo điểm số, không xếp hạng hay đề xuất nhà cung cấp. Q, F, P, K và R được trình bày trước; chỉ số tổng thể là một con số tóm tắt, không có khoảng tin cậy. Tiêu chuẩn được áp dụng là AIHubMix Provider Benchmark Standard v2.0.
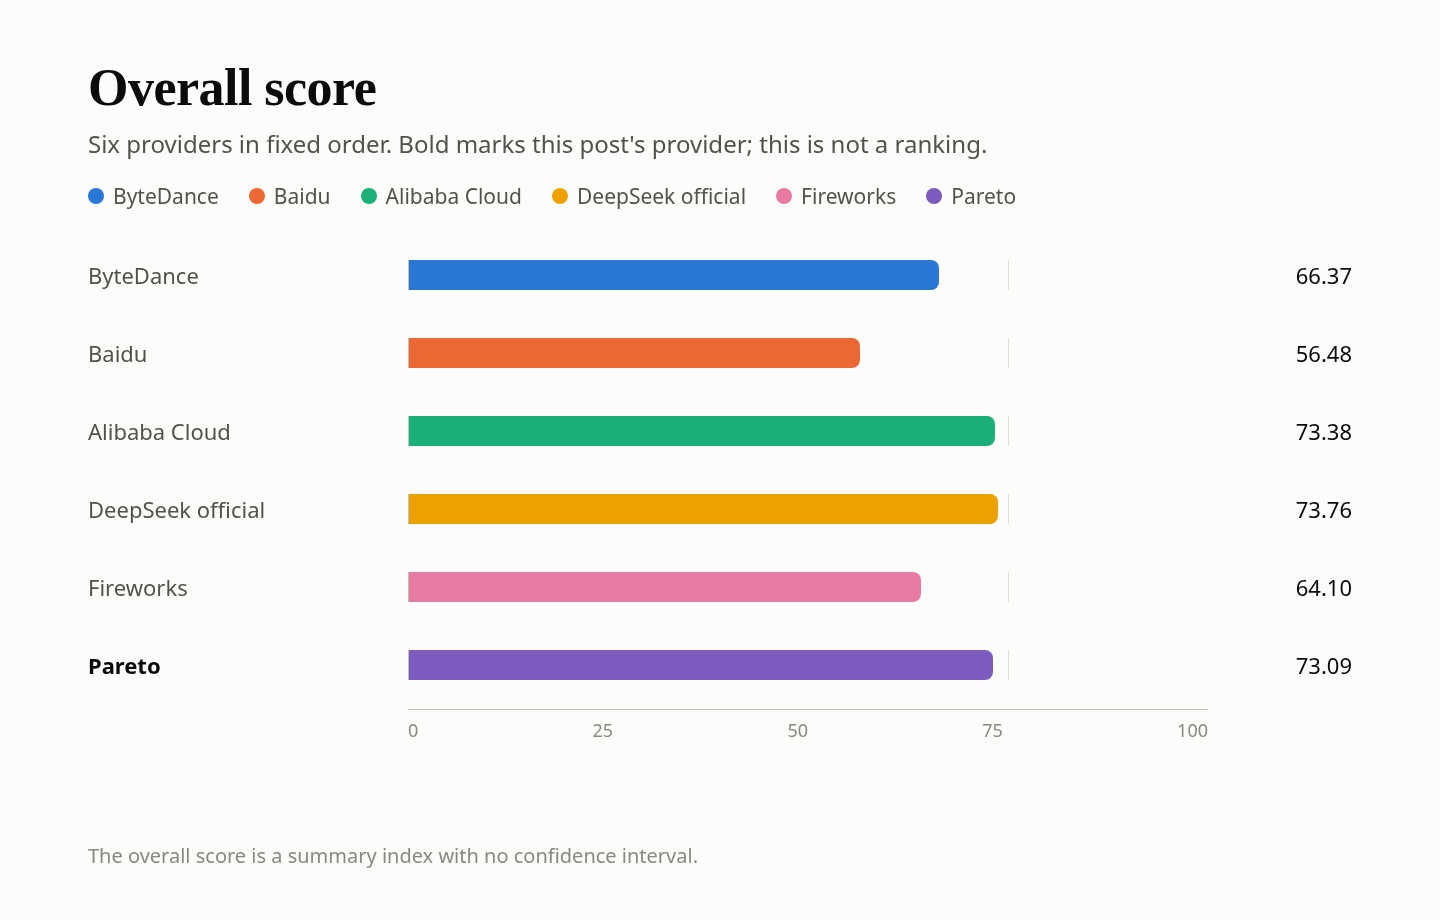
Điểm số trên sáu nhà cung cấp
Chữ đậm đánh dấu nhà cung cấp trong bài viết này. Thứ tự nhà cung cấp cố định, không phải xếp hạng. K là điểm thành phần của P, chiếm 20%. Chỉ số tổng thể là một con số tóm tắt, không có khoảng tin cậy. DeepSeek official channel và Alibaba Cloud chênh nhau 0.37 điểm và không thể phân biệt được.
Tổng quan nhanh
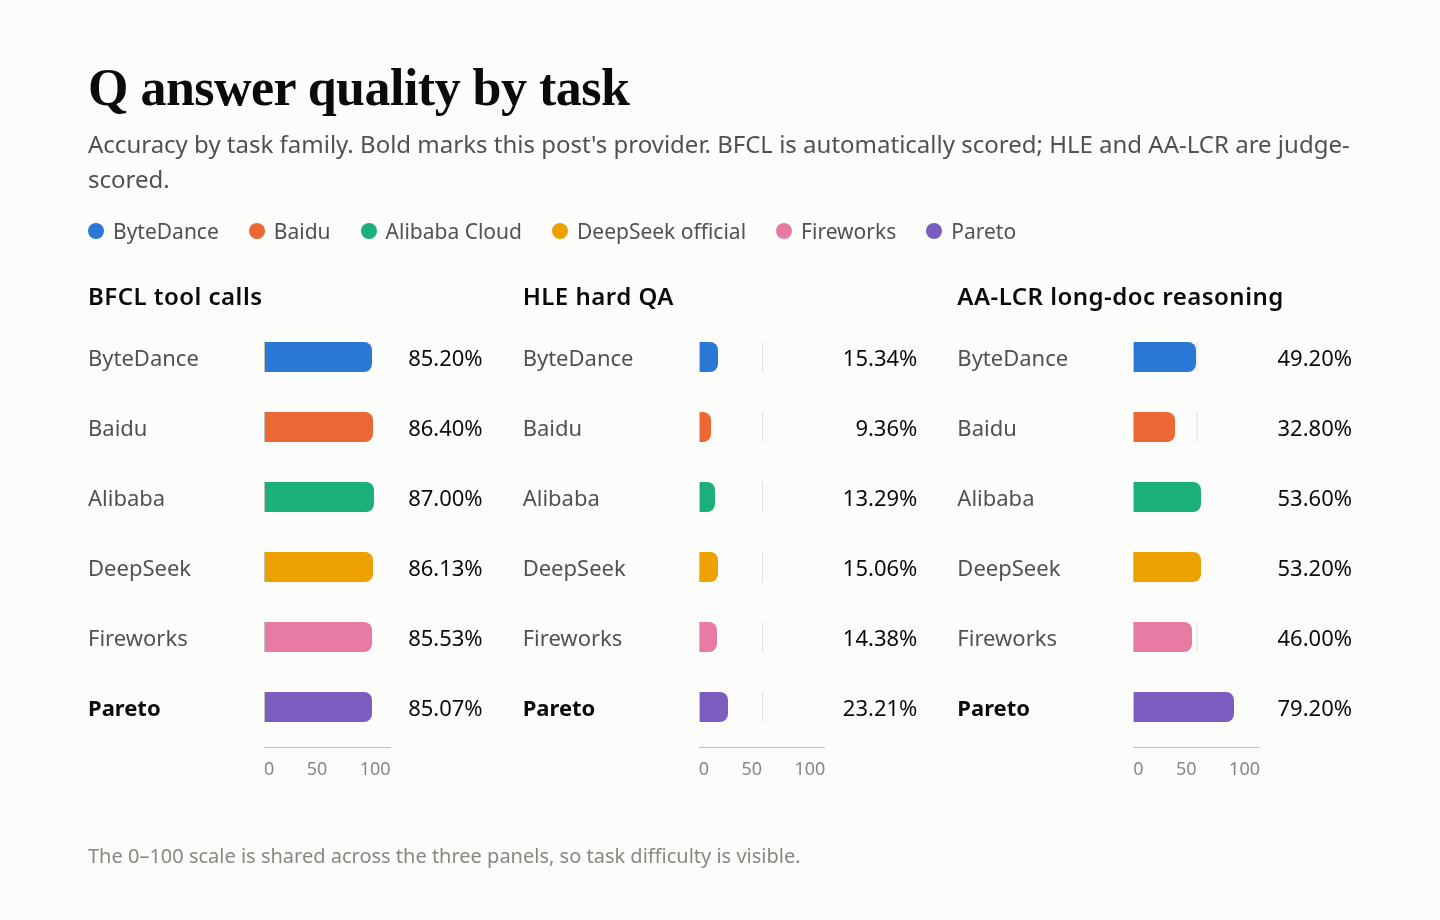
- Q — chất lượng câu trả lời: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. So với kênh chính thức: +5.94 điểm phần trăm, CI 95% từ +3.54 đến +8.36. HLE có 996 lỗi dịch vụ, phần lớn bị cắt cụt vì quá trình suy luận tiêu tốn ngân sách độ dài đầu ra; các trường hợp này được tính là sai.
- F — hỗ trợ chức năng: 93.42. Đạt 29/33 lượt kiểm tra được tính (truyền phát 23/27, lỗi 3/3, đo lường 3/3). 147 lượt kiểm tra không nằm trong mẫu số. Trong 4 trường hợp lỗi, 3 trường hợp có nội dung phản hồi rỗng với yêu cầu có stop sequence, và 1 bộ dữ liệu mẫu văn bản truyền phát không khớp hoàn toàn.
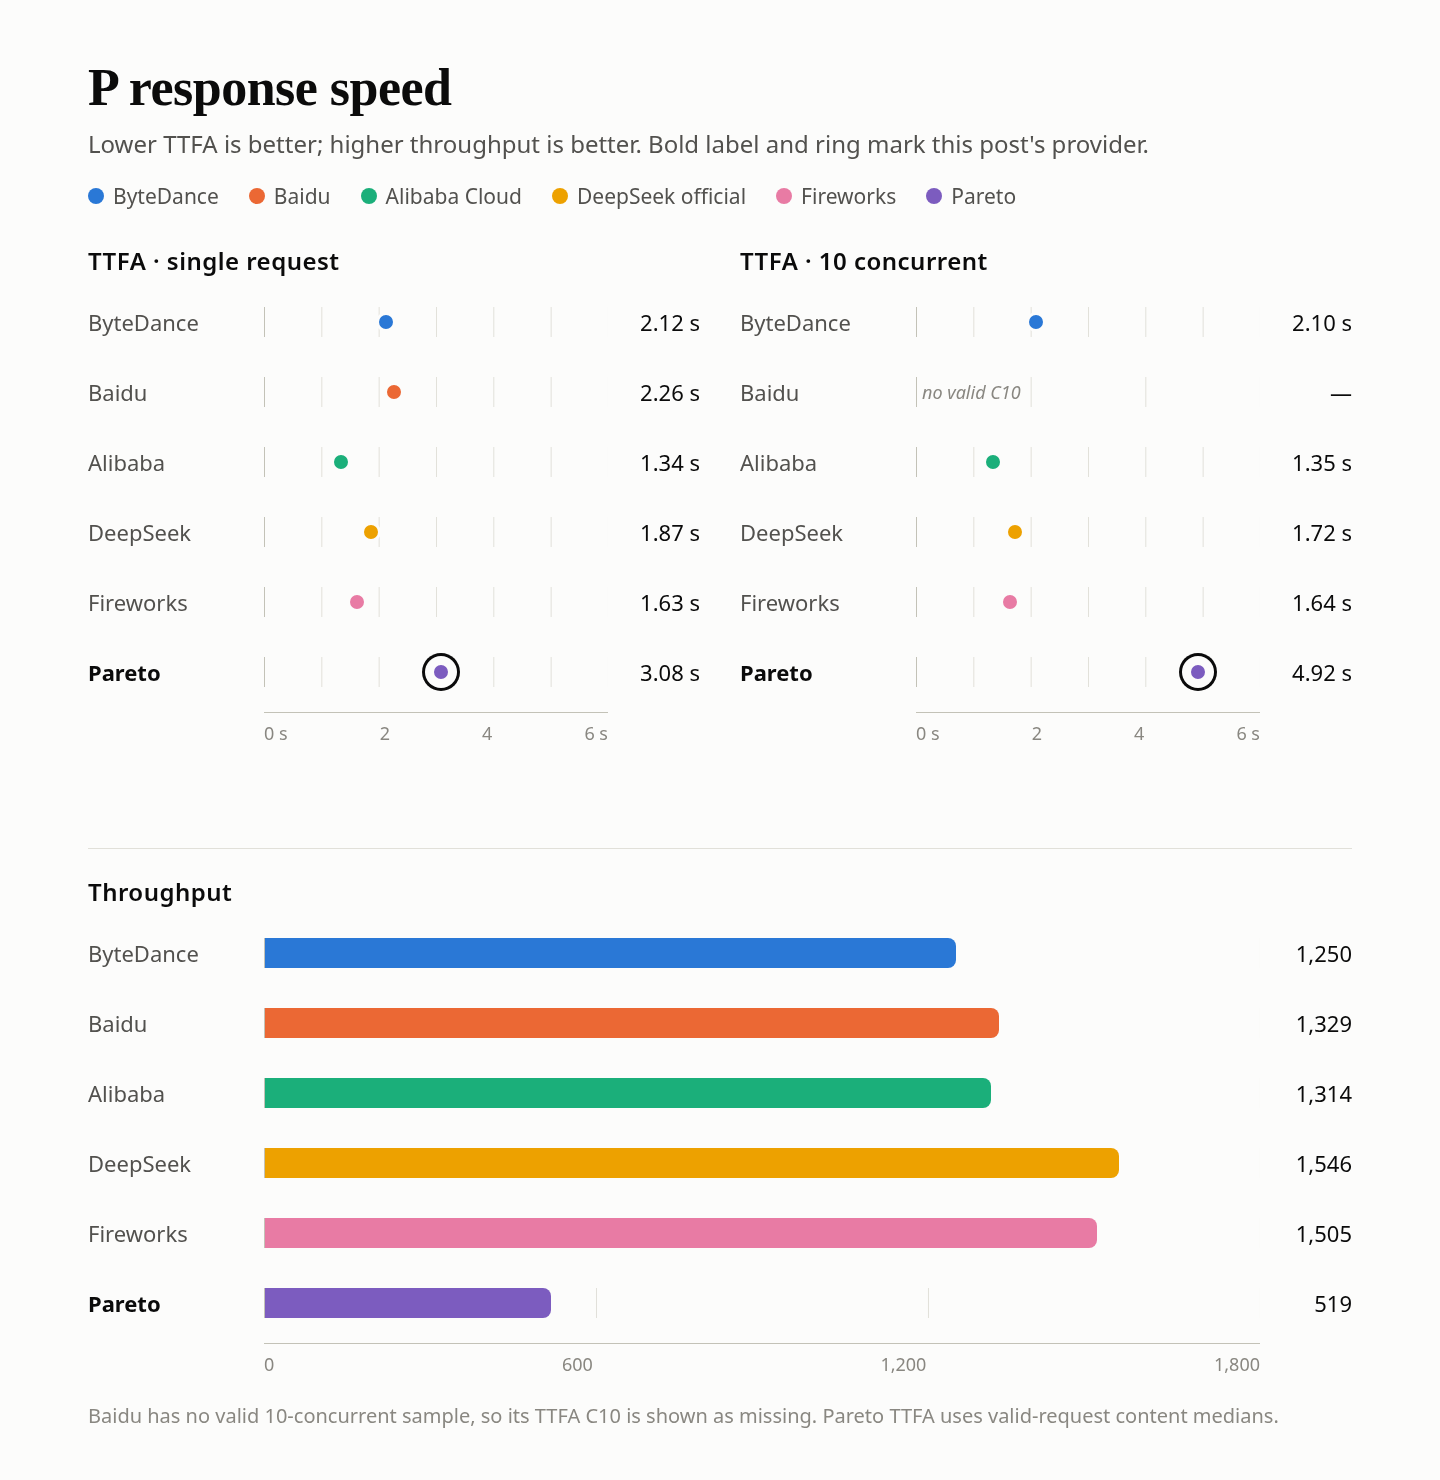
- P — tốc độ phản hồi: 57.69. Điểm phản hồi 65.22, cache K chiếm 20%. Trung vị TTFA của yêu cầu hợp lệ là 3.08 s khi chạy đơn và 4.92 s ở mức đồng thời 10; trung vị dùng để chấm điểm, bao gồm cả yêu cầu không hợp lệ, là 5.85 s và 6.13 s. Có 110/180 lượt thăm dò hợp lệ; 70 lượt không hợp lệ vì quá trình suy luận đã tiêu tốn ngân sách đầu ra của bài kiểm tra tốc độ.
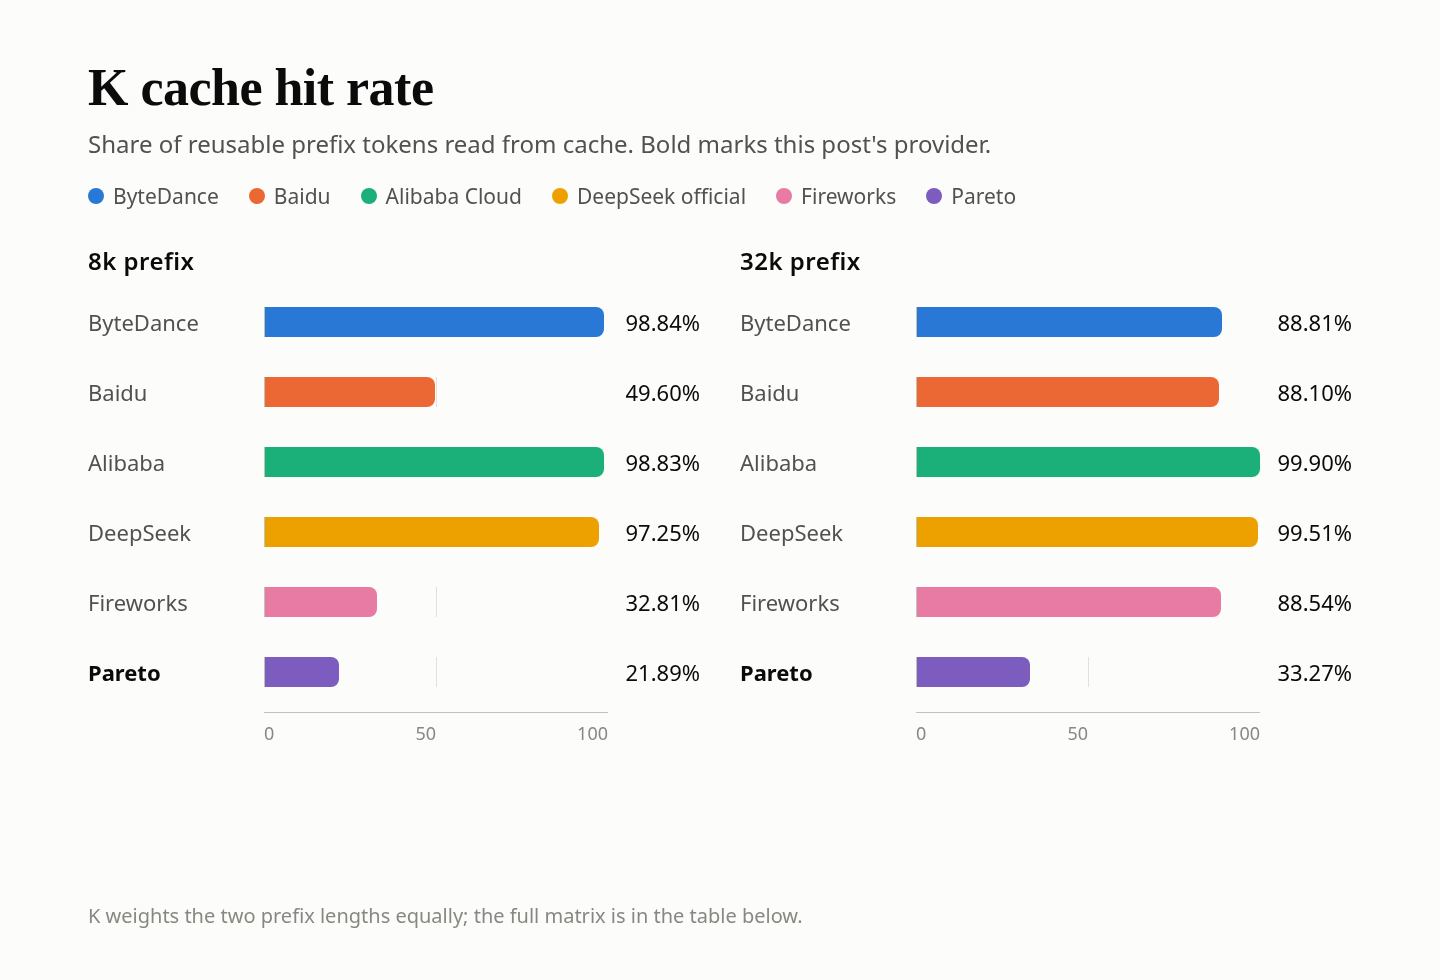
- K — cache: 27.58. 8k nóng 2/9 (đọc 15,872 / có thể tái sử dụng 72,504); 32k nóng 3/9 (đọc 96,000 / có thể tái sử dụng 288,513). Chấm điểm theo cấu hình mặc định.
- R — độ ổn định dịch vụ: 100. Cả 300/300 yêu cầu chuyên biệt đều thành công ngay lần thử đầu tiên.
Thiết lập kiểm tra
| Mục | Thiết lập |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| ID model được yêu cầu | deepseek/deepseek-v4.1-flash |
| Tuyến truy cập | Pareto, sử dụng ID model ở trên |
| Tham số | temperature 1.0, max_tokens 16,384, timeout 300 s; chỉ gửi yêu cầu truyền phát |
| Suy luận | Đã bật chế độ suy luận cường độ cao |
| Thời gian | 2026-11-05/06 UTC+8; cache là kết quả kiểm tra lại cấu hình mặc định vào 2026-11-06 |
| Mẫu | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Ghi chú | Lần chạy này bật chế độ suy luận cường độ cao; năm nhà cung cấp còn lại trong loạt thử nghiệm không dùng chế độ này. Hỗ trợ tính năng được chấm điểm trên tập con có hỗ trợ truyền phát; cache sử dụng cấu hình mặc định. |
Các yêu cầu sử dụng hướng dẫn bắt đầu nhanh của AIHubMix; ID model có trên trang model.
Q — chất lượng câu trả lời: 48.40
Bộ kiểm tra chạy 500 câu hỏi BFCL × 3 vòng, 250 HLE × 10 và 25 AA-LCR × 10. BFCL được chấm tự động; HLE và AA-LCR được đánh giá bởi deepseek-flash. Cả ba nhóm sử dụng cùng các mục kiểm tra như ở những nhà cung cấp khác. Mười câu trả lời không thể chấm được đã bị loại, còn lại 4,240 mẫu được chấm điểm.
| Tác vụ | Câu hỏi | Đúng | Độ chính xác | Lỗi |
|---|---|---|---|---|
| Gọi công cụ BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE hỏi đáp khó | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Lập luận trên tài liệu dài AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Tổng · CI 95% 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Các lỗi vẫn nằm trong mẫu số và được tính là sai: 996 câu HLE bị cắt cụt khi quá trình suy luận tiêu tốn ngân sách độ dài đầu ra. Trong số 1,494 lượt thử HLE trả về câu trả lời hoàn chỉnh, có 578 câu đúng (khoảng 38.7%).
| Danh mục BFCL | Đạt | Tỷ lệ đạt |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python đạt 333/360 (92.50%), multiple đạt 269/300 (89.67%), ahm_multi_turn đạt 102/150 (68.00%) và irrelevance đạt 104/150 (69.33%).
So với năm nhà cung cấp còn lại
Chênh lệch điểm phần trăm so với kênh chính thức; khoảng 95% được thể hiện bằng các thanh sai số. Nếu khoảng cắt qua 0, hai kết quả không thể phân biệt được. Bộ đánh giá deepseek-flash cùng họ model và chưa được hiệu chuẩn, nên có thể chấm dễ dãi.
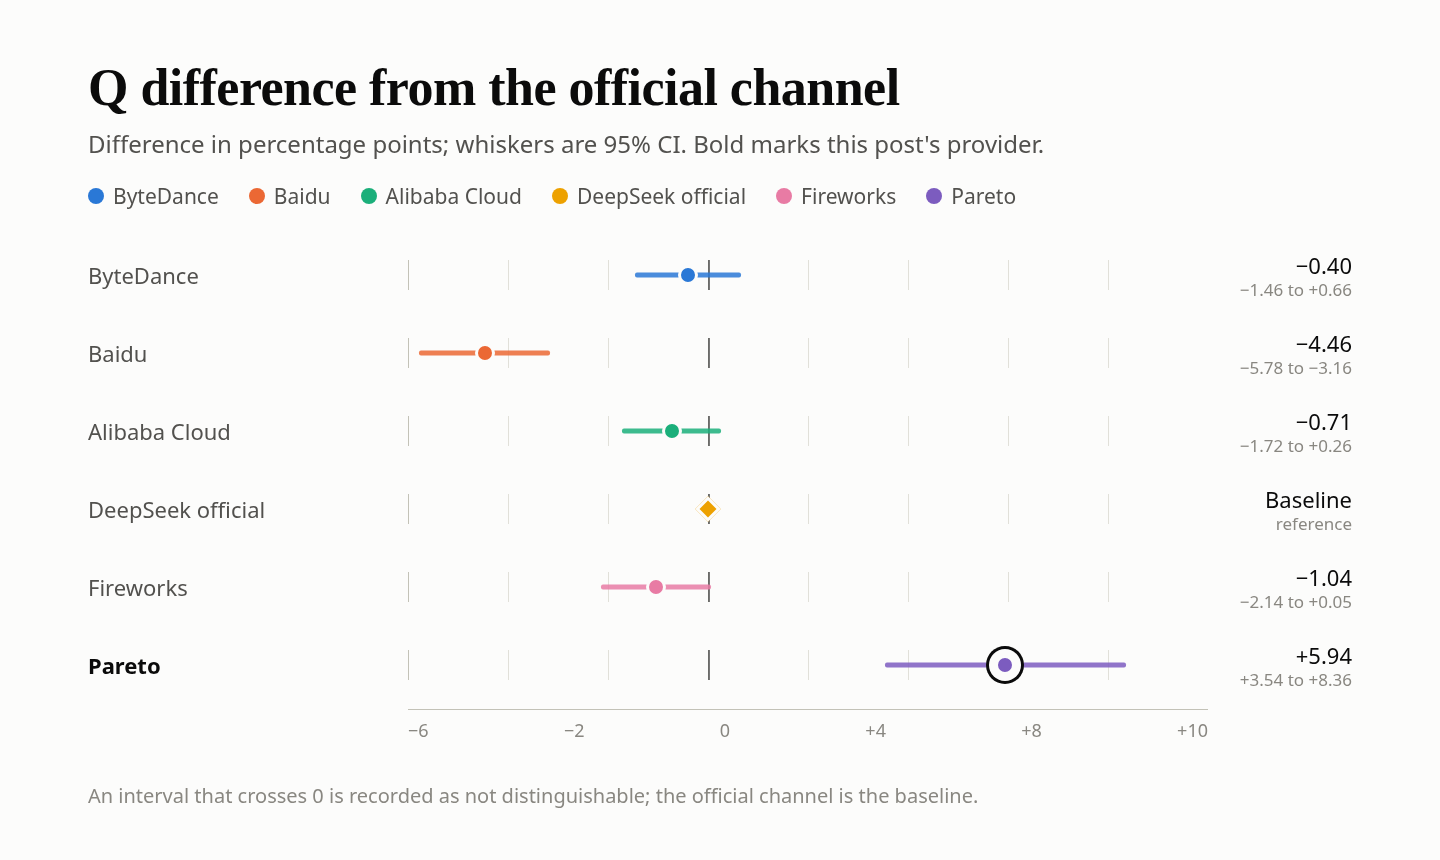
So với kênh chính thức, chênh lệch số học là +5.94 (+3.54 đến +8.36).
F — hỗ trợ chức năng: 93.42
Có 33 lượt kiểm tra được tính, 29 lượt đạt; 147 lượt không được tính. Điểm 93.42 được chuẩn hóa lại theo tổng trọng số ban đầu của các nhóm được quan sát (truyền phát 20%, lỗi 15%, đo lường 10%; tổng 45%). Tỷ lệ đạt đơn giản 29/33 là 87.88%. Công cụ, ràng buộc và ngữ cảnh hoàn toàn không được tính.
| Nhóm trường hợp | Trọng số | Đạt | Loại trừ | Điểm nhóm |
|---|---|---|---|---|
| Truyền phát và nhắn tin | 20% | 23/27 | 3 | 85.19 |
| Giao diện công cụ | 20% | — | 30 | — |
| Ràng buộc đầu ra | 20% | — | 30 | — |
| Ngữ cảnh và trạng thái | 15% | — | 30 | — |
| Lỗi và khôi phục | 15% | 3/3 | 27 | 100.00 |
| Đo lường và cache | 10% | 3/3 | 27 | 100.00 |
| Được quan sát / có trọng số | — | 29/33 | 147 | 93.42 |
“Windows failed” là số cửa sổ trong đó trường hợp kiểm tra không đạt.
| Trường hợp lỗi | Số cửa sổ bị lỗi | Lý do |
|---|---|---|
| Stop khi truyền phát | 3/3 | Nội dung rỗng khi có stop |
| Văn bản truyền phát | 1/3 | Có thêm dấu chấm ở cuối nội dung so với bộ dữ liệu mẫu |
So với năm nhà cung cấp còn lại
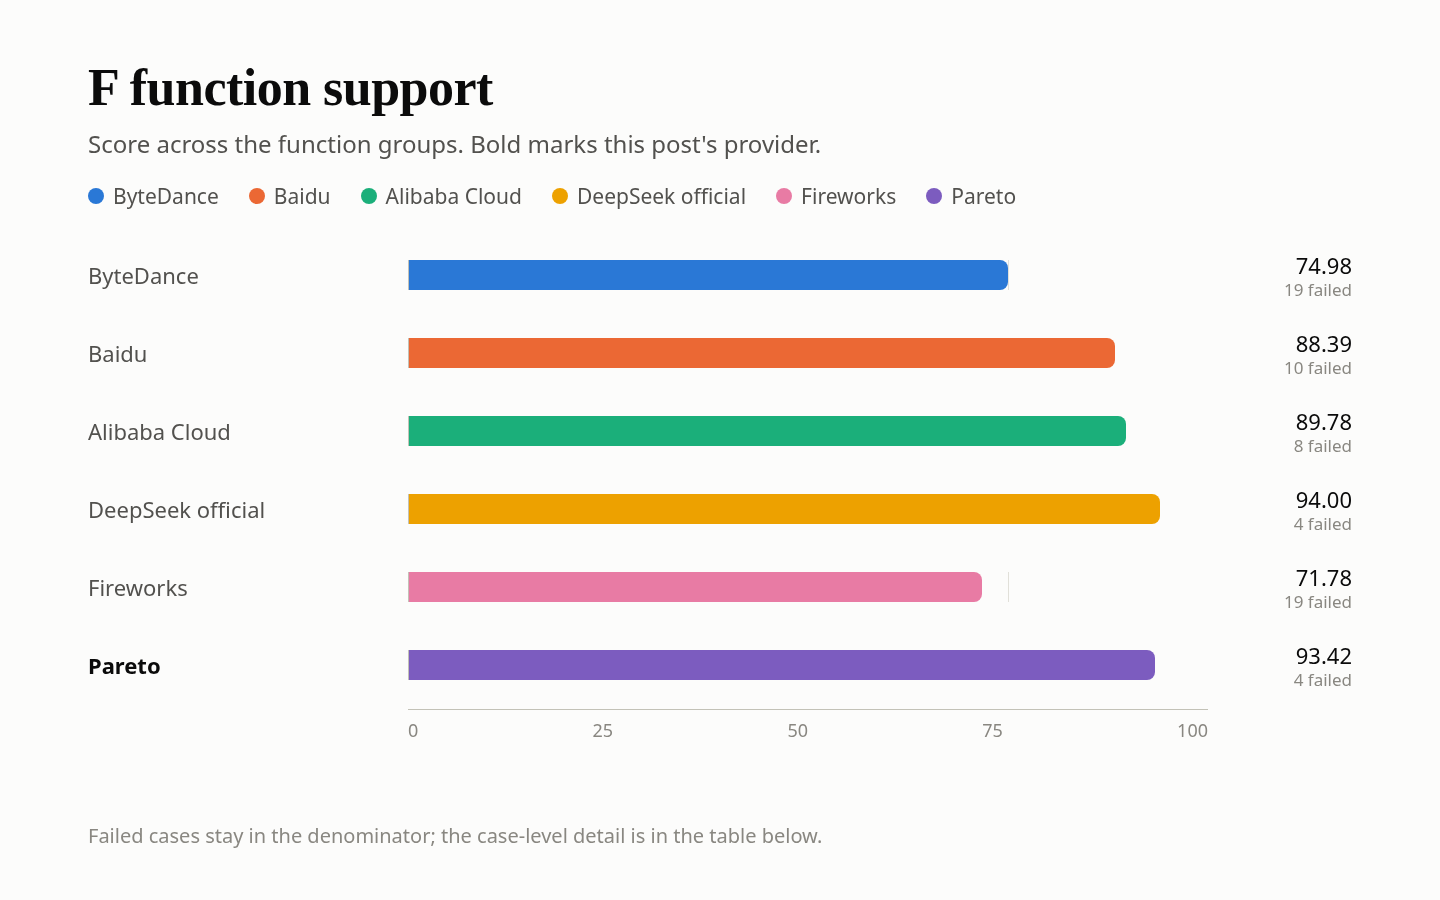
P — tốc độ phản hồi: 57.69
Chấm điểm dựa trên thời gian đến token nội dung đầu tiên, không phải thời gian đến bất kỳ token nào đầu tiên. Khi bật suy luận, model tạo nội dung suy luận trước khi hiển thị câu trả lời, nên thời gian chờ nội dung dài hơn thời gian chờ gói dữ liệu đầu tiên. Trong mỗi cửa sổ trong ba cửa sổ, 30 yêu cầu được gửi với mức đồng thời 1 và 30 yêu cầu với mức đồng thời 10, tổng cộng 180 yêu cầu.
| Chỉ số | Kết quả |
|---|---|
| TTFA nội dung | Trung vị dùng để chấm điểm: 5.85 s (c=1) và 6.13 s (c=10); trung vị của yêu cầu hợp lệ: 3.08 s và 4.92 s |
| Token bất kỳ đầu tiên | Trung vị của yêu cầu hợp lệ: 1.46 s và 1.76 s |
| TPOT | Dải tốc độ chấm điểm chậm hơn: 4.87 ms/token |
| Thông lượng hữu ích | 519 token/s ở mức đồng thời 10 |
| Hợp lệ | 53/90 ở c=1 và 57/90 ở c=10, tổng cộng 110/180; 70 lượt không hợp lệ vì quá trình suy luận tiêu tốn ngân sách đầu ra của bài kiểm tra tốc độ (khoảng 2,048 token) |
| Thành phần | TTFA 24.59, TPOT 100.00, thông lượng hữu ích 72.05; điểm phản hồi 65.22 |
| Cấu thành P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Token suy luận không được tính vào tử số thông lượng hữu ích.
K — cache: 27.58
Tổng hợp lượt đọc từ lần kiểm tra lại cấu hình mặc định vào 2026-11-06. Không bao gồm ma trận cache theo từng yêu cầu (dấu vết thô chưa được di chuyển). K chia đều trọng số cho hai độ dài tiền tố; K chiếm 20% của P.
| Tiền tố | Lượt trúng cache nóng | Đọc / có thể tái sử dụng | Phân đoạn |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (trọng số bằng nhau) | 27.58 |
Các lượt kiểm soát cache lạnh đều đạt 6/6 ở mỗi độ dài.
R — độ ổn định dịch vụ: 100
300 yêu cầu bao gồm văn bản ngắn, đầu vào dài, gọi công cụ và lịch sử nhiều lượt ở mức đồng thời 1. Chỉ tính tính hợp lệ và tính đầy đủ của phản hồi đầu tiên; câu trả lời không được chấm điểm và không có yêu cầu nào được thử lại. Các lỗi Q và P không được tính lại ở đây.
| Loại yêu cầu | Thành công ở lần thử đầu |
|---|---|
| Văn bản ngắn | 120/120 |
| Đầu vào dài 10k | 90/90 |
| Gọi công cụ | 60/60 |
| Lịch sử nhiều lượt | 30/30 |
| Tổng · CI 95% 98.78%–100% | 300/300 |
Câu hỏi thường gặp
Q 48.40 bao gồm những gì?
BFCL, HLE và AA-LCR trên 4,240 mẫu được chấm điểm: đúng 2,052, đạt 48.40%, CI 95% 45.39%–51.26%. So với kênh chính thức, chênh lệch số học là +5.94 (+3.54 đến +8.36).
Vì sao có 996 lỗi dịch vụ HLE?
Phần lớn bị cắt cụt vì quá trình suy luận tiêu tốn ngân sách độ dài đầu ra; các trường hợp này vẫn nằm trong mẫu số và được tính là sai.
Vì sao F là 93.42 trong khi 147 lượt kiểm tra bị loại trừ?
Chỉ tính tập con có hỗ trợ truyền phát. Trọng số các nhóm được chuẩn hóa lại dựa trên những nhóm được quan sát; công cụ, ràng buộc và ngữ cảnh hoàn toàn không được tính.
Vì sao các trường hợp stop bị lỗi?
Yêu cầu có stop sequence trả về nội dung rỗng trong cả ba cửa sổ.
Vì sao 70/180 lượt thăm dò tốc độ không hợp lệ?
Quá trình suy luận đã tiêu tốn ngân sách đầu ra của bài kiểm tra tốc độ (khoảng 2,048 token).
R 100 bao gồm những gì?
300 yêu cầu chuyên biệt, tất cả đều hợp lệ ngay lần thử đầu tiên; cận dưới 95% là 98.78%. Các lỗi Q và P không được tính trong R.
Đọc tiếp: loạt bài DeepSeek V4.1 Flash
- ByteDance ghi nhận token suy luận sau khi đã tắt suy luận: DeepSeek V4.1 Flash trên ByteDance: gọi công cụ khớp, đo lường thì không
- Baidu ghi nhận Q 38.00 và P 37.77: DeepSeek V4.1 Flash trên Baidu: không kênh nào khả dụng đạt Q và P
- Alibaba Cloud ghi nhận token đầu tiên sau 1.34 s và cache 99.37: DeepSeek V4.1 Flash trên Alibaba Cloud: token đầu tiên sau 1.34s, cache 99.37
- Kênh chính thức là mốc chuẩn của Q, với F 94.00: DeepSeek V4.1 Flash trên kênh chính thức: F 94.00, 15 lượt thăm dò không hợp lệ
- Fireworks trả về phản hồi stop rỗng và có 3/9 lượt trúng cache ở 8k: DeepSeek V4.1 Flash trên Fireworks: phản hồi stop rỗng, 3/9 lượt trúng cache


