

Vào ngày 2026-11-03/04, DeepSeek V4.1 Flash 1017 được chạy qua bộ kiểm thử APB Full trên năm nhà cung cấp, tất cả đều được truy cập thông qua AIHubMix với cùng câu hỏi, tham số và tập lệnh yêu cầu. Hồ sơ APB này chỉ đề cập đến Fireworks. Tên model được liệt kê là DeepSeek V4.1 Flash 1017.
Điểm số lần lượt là Q 41.42, F 71.78, P 79.51, K 60.68 và R 100; chỉ số tổng thể là 64.10. Bài viết này chỉ báo cáo điểm số, không xếp hạng hay đề xuất nhà cung cấp. Q, F, P, K và R được trình bày trước; chỉ số tổng thể là một con số tóm tắt, không có khoảng tin cậy. Tiêu chuẩn áp dụng là AIHubMix Provider Benchmark Standard v2.0.
Điểm số của năm nhà cung cấp
In đậm là nhà cung cấp được đề cập trong bài viết này. Thứ tự nhà cung cấp cố định, không phải thứ hạng. K là điểm thành phần của P, chiếm 20%. Chỉ số tổng thể là một con số tóm tắt, không có khoảng tin cậy. DeepSeek official channel và Alibaba Cloud chênh nhau 0.37 và không thể phân biệt.
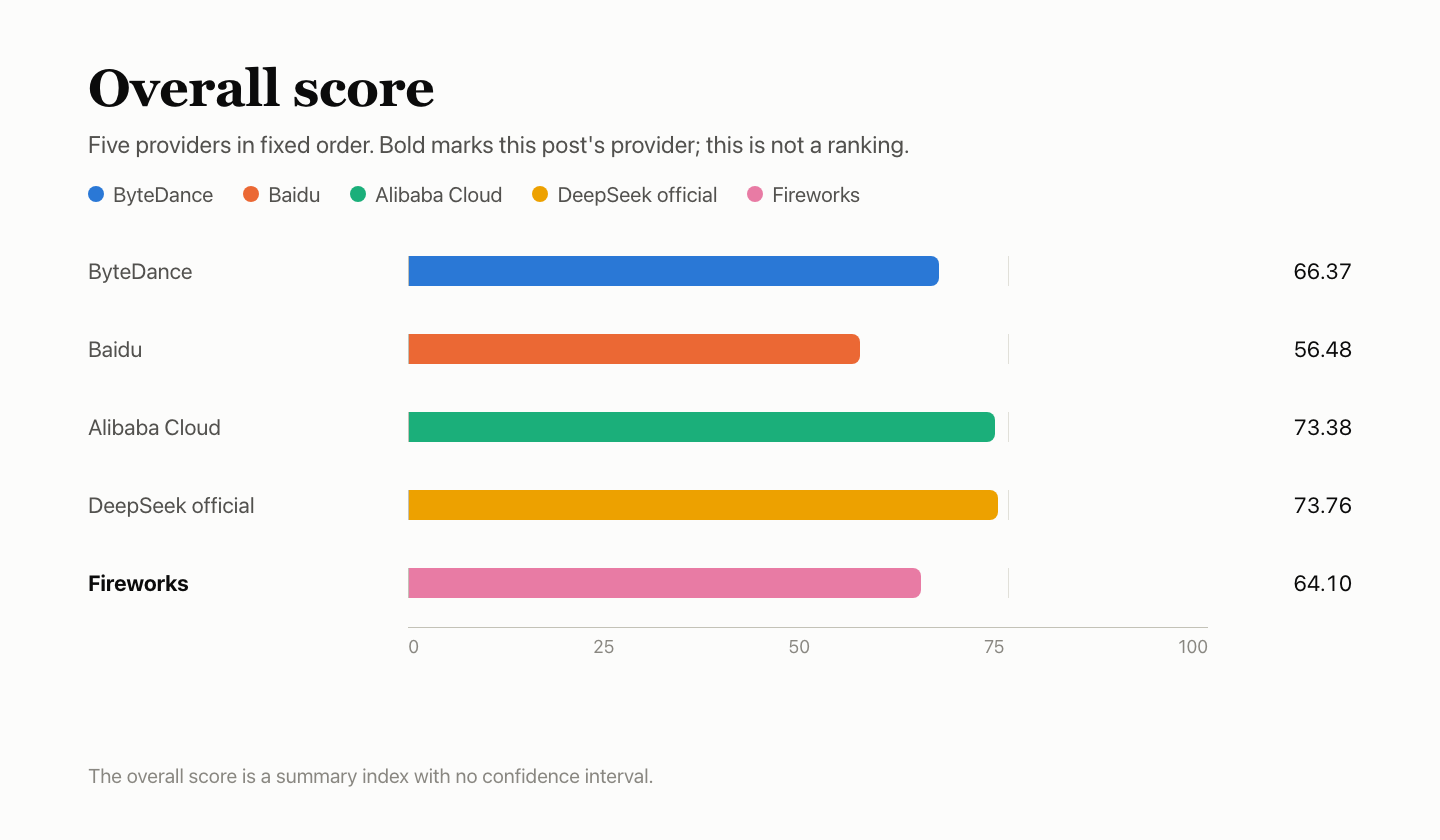
Tổng quan nhanh
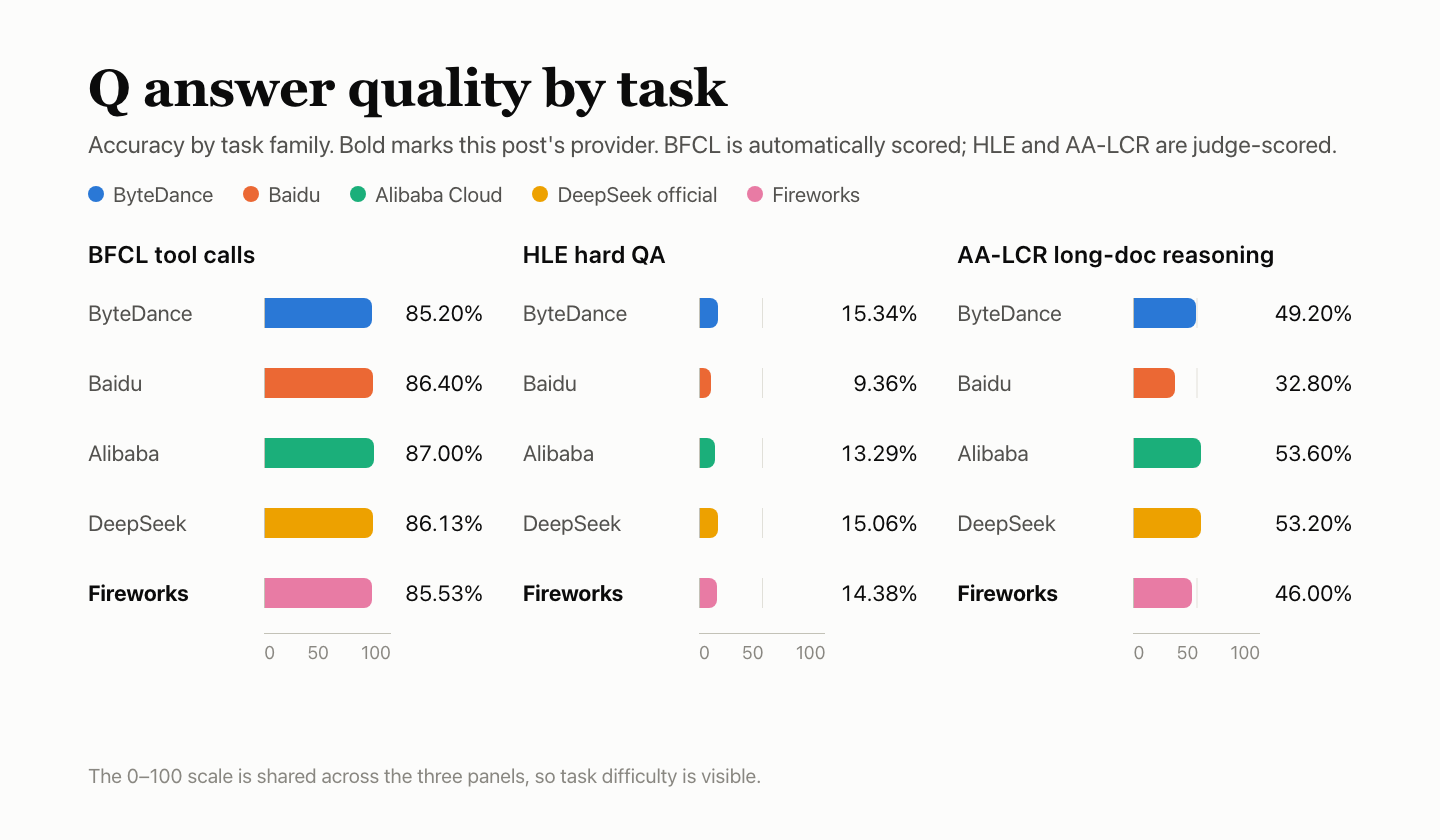
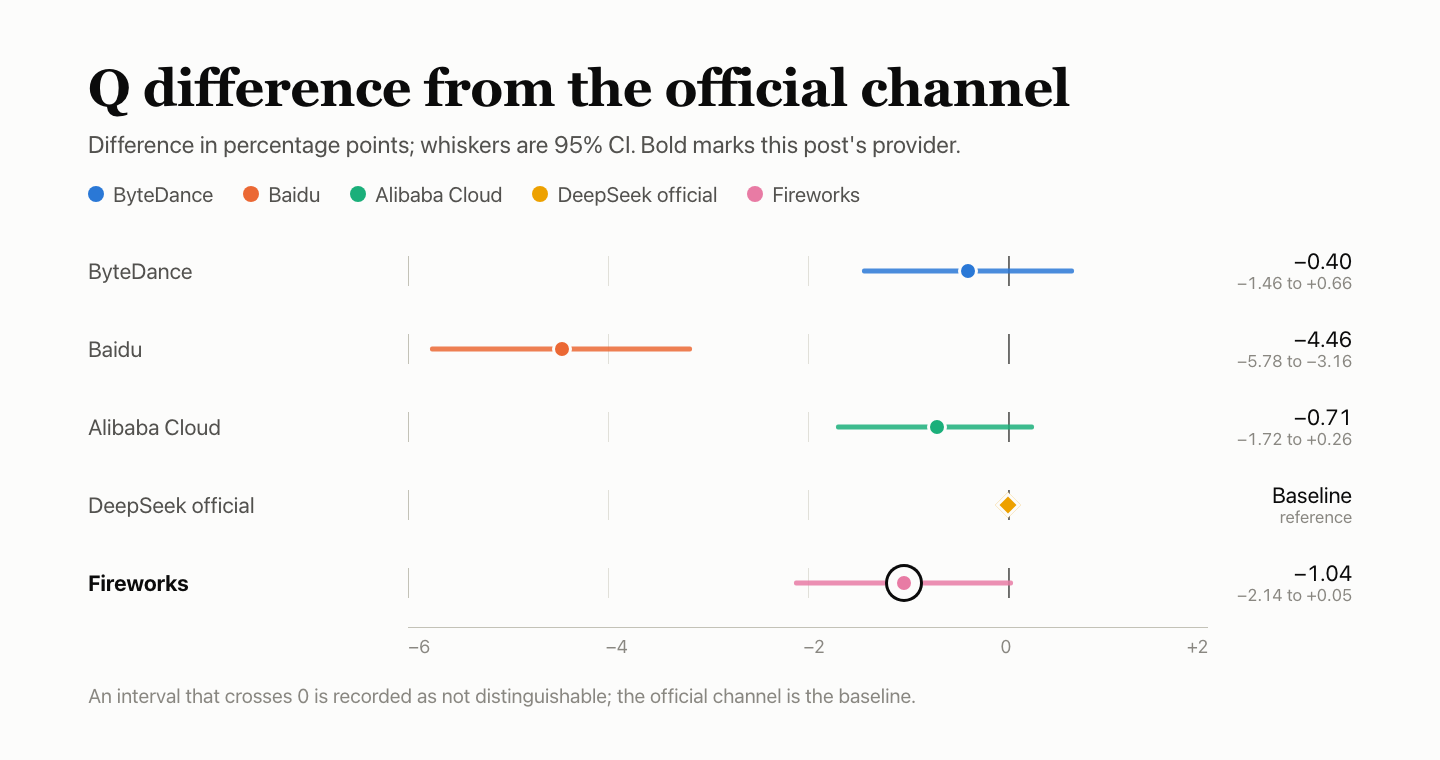
- Q — chất lượng câu trả lời: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. So với kênh chính thức: −1.04 điểm phần trăm, KTC 95% từ −2.14 đến +0.05, không thể phân biệt. Cả 34 trường hợp lỗi AA-LCR đều nằm ở cửa sổ 2 và được tính là sai.
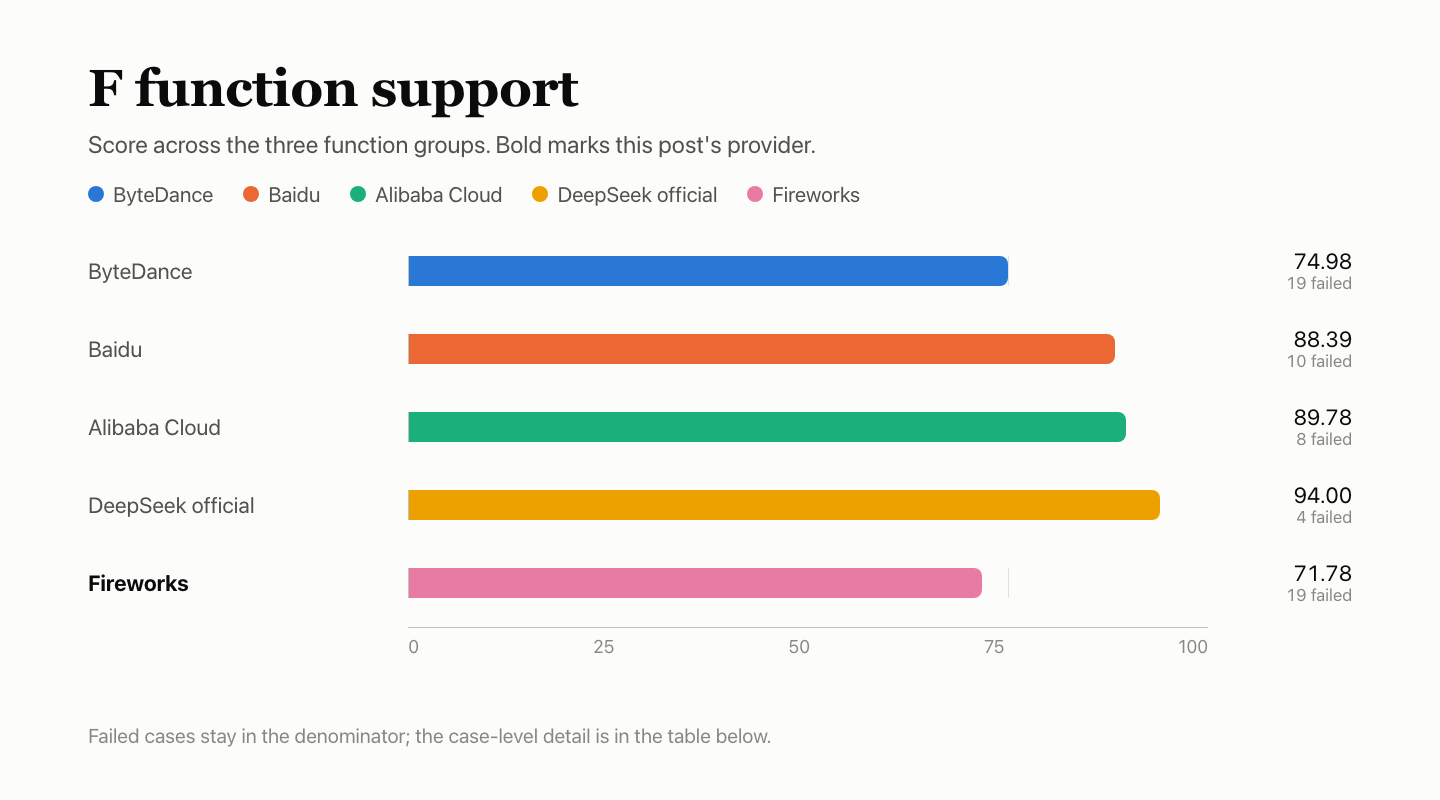
- F — hỗ trợ chức năng: 71.78. Đạt 122/177 kiểm tra được tính điểm. Cả hai trường hợp dừng đều trả về nội dung rỗng;
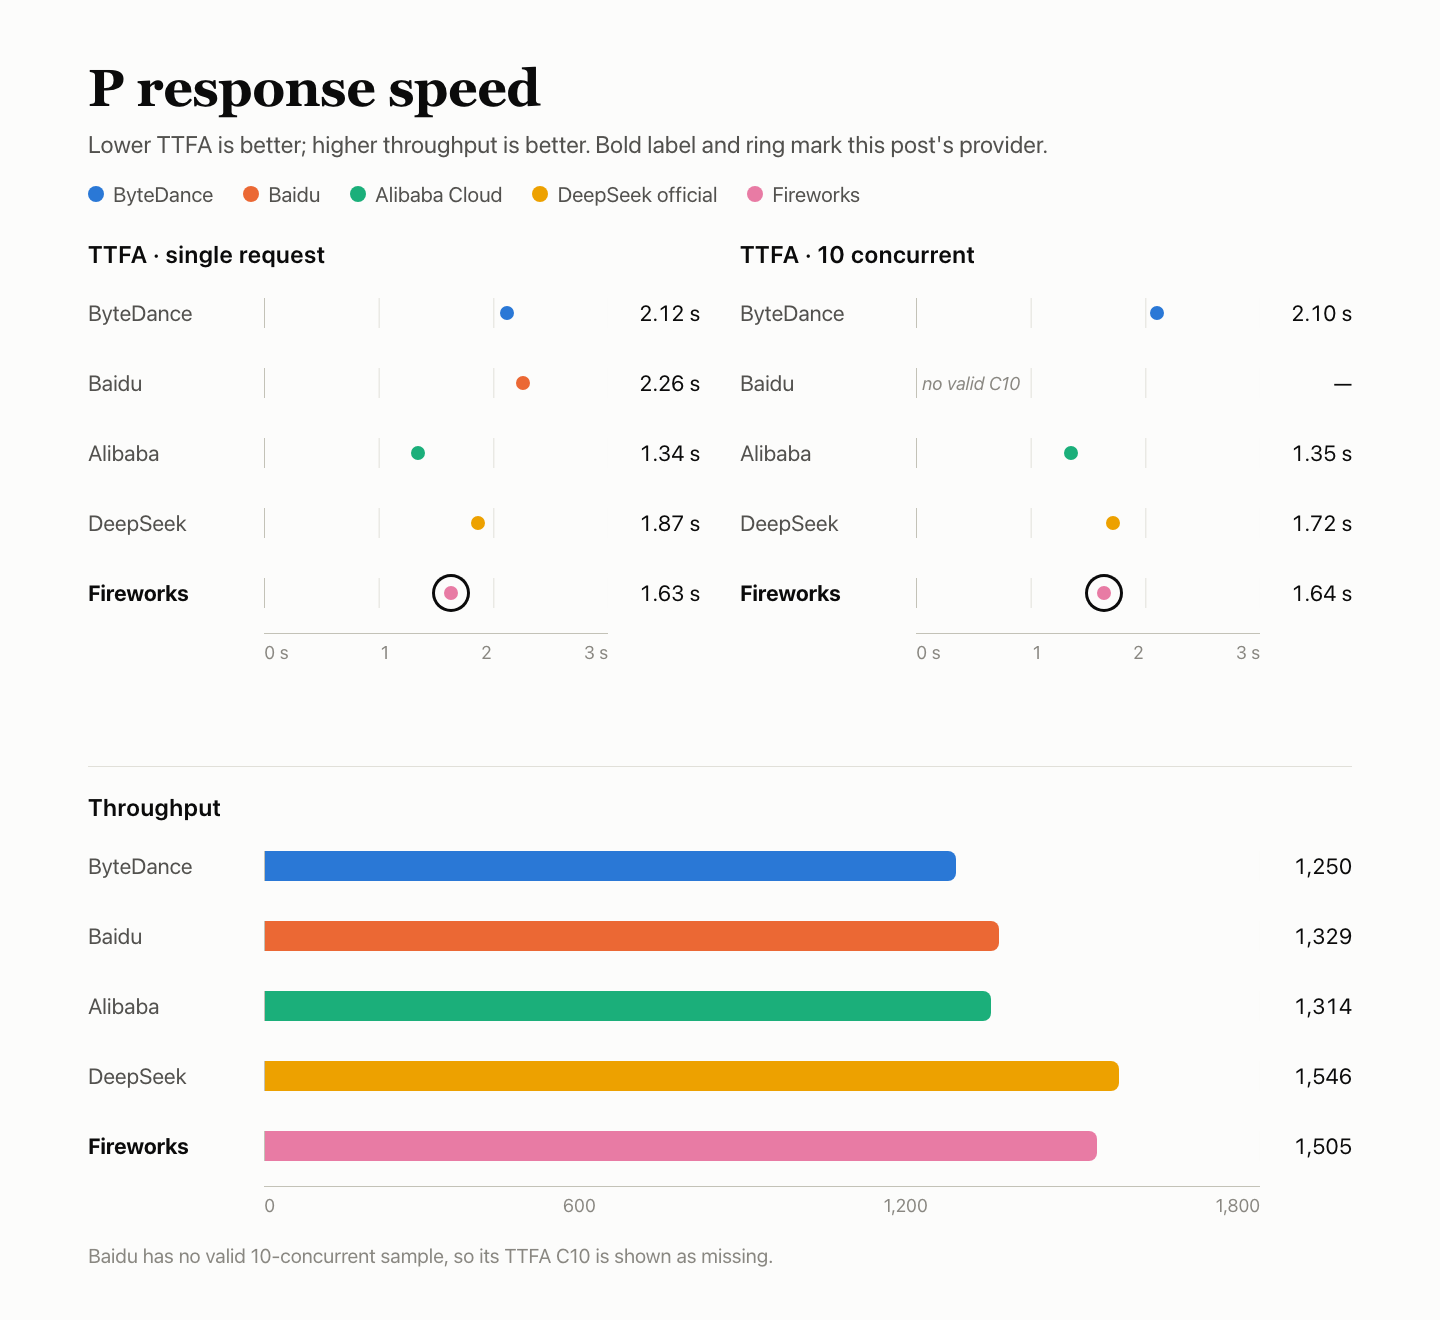
reasoning_effort=nonekhông tắt được chế độ suy luận; đầu vào 10k được báo cáo là 10,026 token, trong khi số đếm gốc là 10,000. - P — tốc độ phản hồi: 79.51. Điểm phản hồi 84.22, bộ nhớ đệm K chiếm 20%. Trung vị TTFA là 1.63 s khi chạy đơn, 1.64 s khi chạy đồng thời 10 yêu cầu; TPOT là 3.29 ms. 1 trong 180 đầu ra chỉ có một token và bị đánh dấu không hợp lệ.
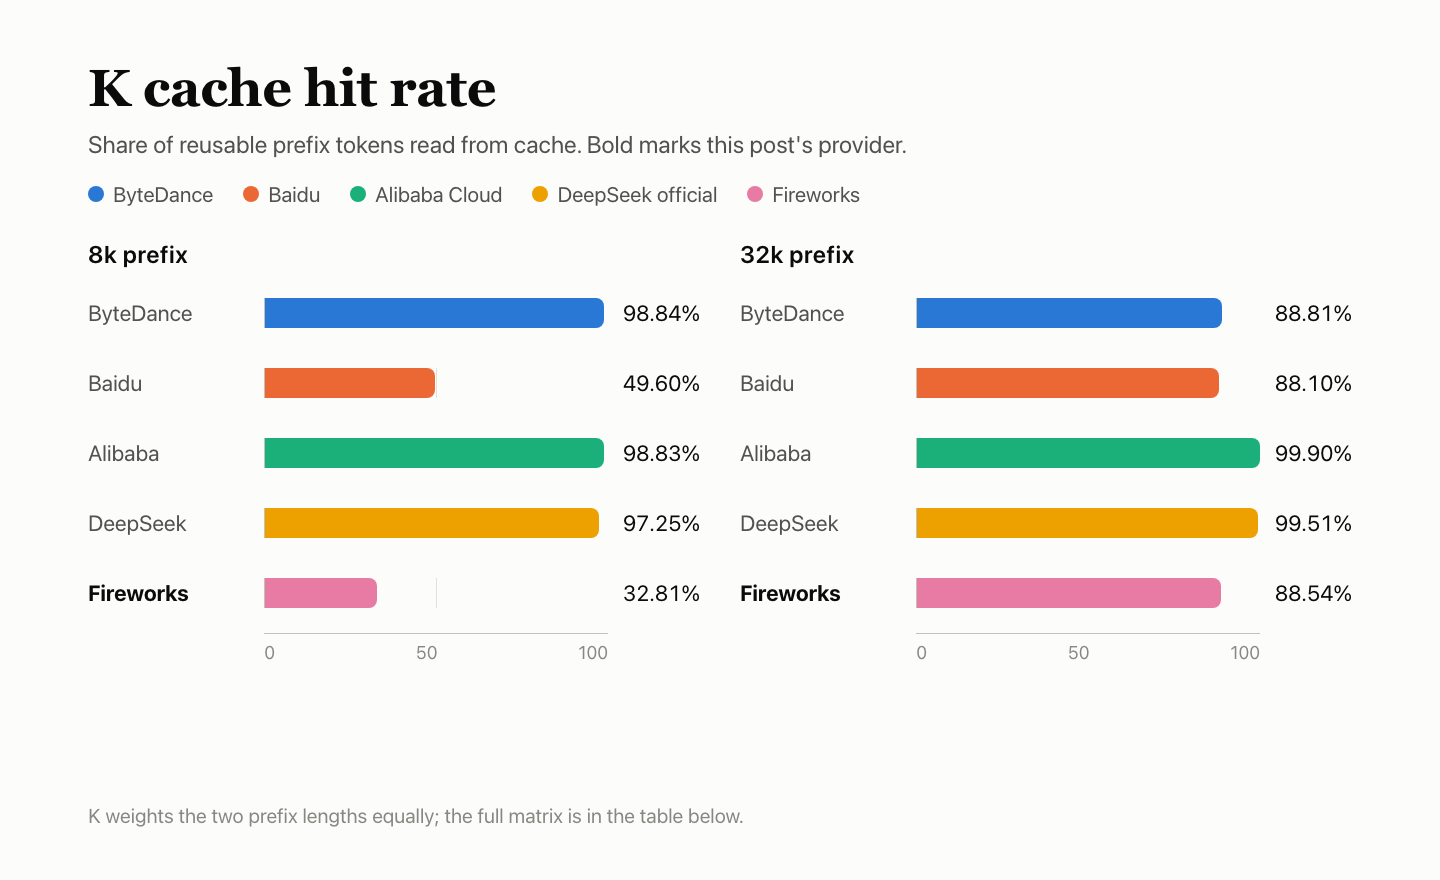
- K — bộ nhớ đệm: 60.68. Các phép thử K dùng cơ chế gắn phiên được tài liệu hóa. 32k nóng đạt 8/9; 8k nóng đạt 3/9.
- R — độ ổn định dịch vụ: 100. 300/300 yêu cầu riêng đều thành công ngay lần thử đầu tiên.
Thiết lập kiểm thử
| Hạng mục | Thiết lập |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| ID model được yêu cầu | fireworks-deepseek-v4.1-flash-1017 |
| Tên model được trả về | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Tuyến truy cập | ID model của nhà cung cấp trên AIHubMix, không phải tài khoản riêng của nhà cung cấp |
| Tham số | Không suy luận, temperature 1.0, max_tokens 16,384, timeout 300 s, không thử lại |
| Tắt suy luận | Dùng thinking.type=disabled gốc; reasoning_effort=none không tắt được chế độ suy luận. Các trường hợp kiểm thử chức năng vẫn giữ reasoning_effort=none. |
| Thời gian | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Cùng một máy Mac mini, mạng và tài khoản cho cả năm nhà cung cấp. |
| Mẫu | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Thiết lập bổ sung | Các phép thử K gửi kèm trường user và header x-session-affinity được tài liệu hóa để gắn với bản sao. |
Các yêu cầu sử dụng hướng dẫn bắt đầu nhanh của AIHubMix; ID model có trên trang model. Tắt suy luận bằng thinking.type=disabled gốc theo tài liệu API của model.
Q — chất lượng câu trả lời: 41.42
Bộ kiểm thử chạy 500 câu hỏi BFCL × 3 lượt, 250 câu HLE × 10 và 25 câu AA-LCR × 10. BFCL được chấm tự động; HLE và AA-LCR được đánh giá bởi deepseek-flash. Cả năm nhà cung cấp nhận cùng câu hỏi. Mười câu trả lời không thể chấm được đã bị loại, còn lại 4,240 trường hợp được chấm điểm.
| Tác vụ | Câu hỏi | Đúng | Độ chính xác | Lỗi |
|---|---|---|---|---|
| Gọi công cụ BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Hỏi đáp khó HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Suy luận tài liệu dài AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Tổng · KTC 95% 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Các trường hợp lỗi vẫn nằm trong mẫu số và được tính là sai: BFCL 2 (cửa sổ 2 và 3), HLE 5 bị cắt ở max_tokens, AA-LCR 34 đều nằm ở cửa sổ 2.
| Danh mục BFCL | Đạt | Tỷ lệ đạt |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python đạt 333/360 (92.50%), parallel đạt 270/300 (90.00%), ahm_multi_turn đạt 95/150 (63.33%) và irrelevance đạt 111/150 (74.00%).
So với bốn nhà cung cấp còn lại
Chênh lệch điểm phần trăm so với kênh chính thức; khoảng 95% được thể hiện bằng các thanh sai số. Nếu cắt qua 0 thì không thể phân biệt. Mô hình đánh giá deepseek-flash cùng họ và chưa được hiệu chuẩn, nên có thể chấm dễ dãi.
F — hỗ trợ chức năng: 71.78
60 trường hợp được chia thành sáu nhóm, mỗi nhóm chạy qua ba cửa sổ: tổng cộng 180 lượt kiểm tra, được đánh giá theo định dạng do nhà cung cấp tài liệu hóa. Các lượt kiểm tra không áp dụng, không hợp lệ và không quan sát được không tính vào mẫu số. Có 122/177 lượt kiểm tra được tính điểm đạt yêu cầu; tính trọng số theo nhóm cho kết quả 71.78.
| Nhóm trường hợp kiểm thử | Trọng số | Đạt | Bị loại | Điểm nhóm |
|---|---|---|---|---|
| Truyền phát và nhắn tin | 20% | 24/30 | — | 80.00 |
| Giao diện công cụ | 20% | 29/30 | — | 96.67 |
| Ràng buộc đầu ra | 20% | 21/30 | — | 70.00 |
| Ngữ cảnh và trạng thái | 15% | 15/30 | — | 50.00 |
| Lỗi và khôi phục | 15% | 21/30 | — | 70.00 |
| Đo lường và bộ nhớ đệm | 10% | 12/27 | 3 | 44.44 |
| Tổng · có trọng số | — | 122/177 | 3 | 71.78 |
“Số cửa sổ thất bại” là số cửa sổ trong ba cửa sổ mà trường hợp kiểm thử không đạt.
| Trường hợp kiểm thử không đạt | Số cửa sổ thất bại | Lý do |
|---|---|---|
| Dừng khi truyền phát | 3/3 | Nội dung rỗng khi có stop; hoạt động khi không có stop. |
| Suy luận trong nội dung | 3/3 | reasoning_effort=none vẫn trả về nội dung suy luận. |
| Chuỗi dừng | 3/3 | Nội dung rỗng khi có stop; hoạt động khi không có stop. |
| Thiết lập chế độ suy luận | 3/3 | reasoning_effort=none vẫn trả về nội dung suy luận. |
| Đa dạng lấy mẫu | 3/3 | Temp 0/1 quá giống nhau |
| Đầu vào dài 10k | 3/3 | Báo cáo 10,026; số đếm gốc là 10,000. |
| Trong giới hạn ngữ cảnh | 3/3 | Báo cáo 10,026; số đếm gốc là 10,000. |
| Đầu vào dài 32k | 3/3 | Báo cáo 10,026; số đếm gốc là 10,000. |
| Đầu vào dài 100k | 3/3 | Báo cáo 10,026; số đếm gốc là 10,000. |
| Vượt quá ngữ cảnh | 3/3 | Đáng lẽ phải là lỗi tham số; nhưng trả về 200. |
| Tin nhắn không hợp lệ | 3/3 | 400, nội dung rỗng |
| Kết quả công cụ mồ côi | 3/3 | Đáng lẽ phải là lỗi tham số; nhưng trả về 200. |
| stream_options không hợp lệ | 3/3 | 400, nội dung rỗng |
| Đo lường token suy luận | 3/3 | Vẫn báo cáo token suy luận sau khi tắt. |
| Số lượng đầu vào gốc | 3/3 | Báo cáo 34; số đếm gốc là 8. |
| Định nghĩa công cụ trong đầu vào | 3/3 | Trường hợp đối chứng không dùng công cụ vốn đã không khớp. |
| Số lượng đầu vào qua bộ nhớ đệm | 3/3 | Số lượng tiền tố lặp lại không khớp với số đếm gốc. |
| Mức độ thống nhất đầu vào khi truyền phát | 3/3 | Báo cáo 34; số đếm gốc là 8 |
| Mỗi lần một công cụ | 1/3 | Lỗi 500 từ phía thượng nguồn. |
Cả hai trường hợp dừng đều trả về nội dung rỗng trong cả ba cửa sổ, trong khi cùng đầu vào đó hoạt động nếu không có stop. reasoning_effort=none vẫn trả về nội dung suy luận trong cả hai trường hợp kiểm thử chế độ suy luận.
Các lượt kiểm tra bị loại không được tính là đạt hay thất bại.
| Trạng thái | Trường hợp kiểm thử | Số lượng | Lý do |
|---|---|---|---|
| Không áp dụng | cache_control tường minh | 3 | Được đăng ký trước là không được giao diện này hỗ trợ |
messages và stream_options không hợp lệ đều thất bại trên cả năm nhà cung cấp: trả về 400 với nội dung rỗng và không có lỗi có cấu trúc. Kết quả chung này nhiều khả năng nằm ở lớp cổng AIHubMix, cần được điều tra riêng. Việc đo lường token suy luận cũng thất bại trên cả năm, nhưng ByteDance và Fireworks báo cáo token suy luận sau khi tắt, còn ba nhà cung cấp kia không trả về số lượng token suy luận.
So với bốn nhà cung cấp còn lại
P — tốc độ phản hồi: 79.51
Mỗi yêu cầu mang theo khoảng 10,000 token đầu vào và yêu cầu khoảng 1,100 token đầu ra. Trong mỗi cửa sổ trong ba cửa sổ, gửi 30 yêu cầu với mức đồng thời 1 và 30 yêu cầu với mức đồng thời 10, tổng cộng 180 yêu cầu.
| Chỉ số | Kết quả |
|---|---|
| TTFA | 1.63 s khi chạy đơn; 1.64 s khi chạy đồng thời 10 yêu cầu |
| TPOT | 3.24 ms khi chạy đơn; 3.29 ms khi chạy đồng thời 10 yêu cầu |
| Thông lượng hữu ích | 1,504.5 token/s khi chạy đồng thời 10 yêu cầu |
| Hợp lệ | 90/90 khi chạy đơn; 89/90 khi chạy đồng thời 10 yêu cầu (29/30 ở cửa sổ 3), một đầu ra chỉ có một token |
| Thành phần | TTFA 54.91, TPOT 100.00, thông lượng hữu ích 100.00; trọng số 35/35/30 |
| Cơ cấu P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179/180 kết quả hợp lệ; yêu cầu không hợp lệ trả về một token và được tính là vô cực trong phép tính trung vị, nên trung vị có thể cao hơn so với chỉ tính riêng các yêu cầu hợp lệ. TPOT được tính từ các khối truyền phát; thông lượng hữu ích là số token đầu ra hợp lệ khi chạy đồng thời 10 yêu cầu chia cho thời gian thực thi của lô.
Cùng một máy, mạng và tài khoản; lịch chạy các cửa sổ được sắp xếp theo nhà cung cấp.
K — bộ nhớ đệm: 60.68
Mỗi nhóm gồm năm yêu cầu: tạo tiền tố 8k hoặc 32k, sau đó gửi lại cùng tiền tố với câu hỏi cuối mới sau 5 s, 30 s và 120 s, rồi dùng tiền tố mới làm đối chứng lạnh. Ba cửa sổ × hai độ dài = 30. K là số token đọc từ bộ nhớ đệm nóng chia cho số token có thể tái sử dụng; hai độ dài được tính trọng số ngang nhau. K chiếm 20% P.
| Tiền tố | Cửa sổ | Tạo mẫu | +5 s | +30 s | +120 s | Đối chứng lạnh |
|---|---|---|---|---|---|---|
| 8k | Cửa sổ 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Cửa sổ 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Cửa sổ 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Cửa sổ 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Cửa sổ 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Cửa sổ 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Tiền tố 8k trúng bộ nhớ đệm ở 3/9 yêu cầu nóng, đọc 23,706 trong tổng số 72,252 token có thể tái sử dụng, đạt 32.81. Tiền tố 32k trúng ở 8/9 yêu cầu, đọc 255,212 trong tổng số 288,261, đạt 88.54. K là 60.68 khi hai độ dài được tính trọng số ngang nhau. Các lượt đối chứng không có dữ liệu đọc nào. Vì vậy, hai độ dài tiền tố cho kết quả khác nhau dù dùng cùng một thiết kế. Các phép thăm dò K mang trường user và header x-session-affinity như tài liệu mô tả.
R — độ ổn định dịch vụ: 100
300 yêu cầu bao gồm văn bản ngắn, đầu vào dài, gọi công cụ và lịch sử nhiều lượt, được gửi với mức đồng thời là 1 trong ba cửa sổ. Chỉ kiểm tra tính hợp lệ và đầy đủ của phản hồi đầu tiên; câu trả lời không được chấm điểm và không có yêu cầu nào được thử lại. Các lỗi Q và P không được tính lại ở đây.
| Loại yêu cầu | Tỷ lệ thành công ở lần thử đầu tiên |
|---|---|
| Văn bản ngắn | 120/120 |
| Đầu vào dài 10k | 90/90 |
| Gọi công cụ | 60/60 |
| Lịch sử nhiều lượt | 30/30 |
| Tổng · KTC 95% 98.78%–100% | 300/300 |
Cả 300 yêu cầu đều trả về phản hồi hợp lệ, đầy đủ ngay lần đầu tiên. Với 300 lượt thành công, cận dưới 95% là 98.78%, vì vậy dữ liệu chỉ cho phép kết luận tỷ lệ lỗi thấp hơn 1.22%. R 100 bao quát 300 yêu cầu này, không phải toàn bộ quy trình.
| Nhà cung cấp | Tỷ lệ thành công ở lần thử đầu tiên | Khoảng tin cậy 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Câu hỏi thường gặp
Q 41.42 bao gồm những gì?
BFCL, HLE và AA-LCR trên 4,240 trường hợp được chấm điểm: 1,756 câu trả lời đúng, đạt 41.42%, KTC 95% 39.13%–43.59%; không thể phân biệt được khoảng cách so với kênh chính thức.
Vì sao cả hai trường hợp dùng stop đều thất bại?
Yêu cầu có stop trả về nội dung rỗng trong cả ba cửa sổ, trong khi cùng đầu vào đó hoạt động bình thường nếu không có stop. Hiện tượng này xảy ra ở cả trường hợp truyền phát lẫn không truyền phát.
reasoning_effort=none có tắt chế độ suy luận không?
Không. Cả ba cửa sổ vẫn trả về nội dung suy luận; các yêu cầu khác sử dụng thinking.type=disabled theo cách gốc.
Vì sao đầu vào 10k được ghi nhận là 10,026 token?
Trường hợp 10k ghi nhận 10,026 token thay vì 10,000 theo cách tính gốc. Các trường hợp 32k và 100k cũng ghi nhận cùng con số 10,026, và một lượt đối chứng không dùng công cụ vốn đã cho kết quả không khớp.
Vì sao 8k trúng 3/9 còn 32k trúng 8/9?
Cả hai đều dùng cùng thiết kế và các thiết lập affinity được tài liệu mô tả. Sự khác biệt nằm ở số liệu đọc do máy chủ báo cáo: 8k trúng ở cửa sổ 1 và 2, còn 32k trúng ở cả ba cửa sổ.
R 100 bao gồm những gì?
300 yêu cầu riêng biệt, tất cả đều hợp lệ ngay lần thử đầu tiên; cận dưới 95% là 98.78%. Các lỗi Q và P không được tính vào R.
Đọc tiếp: loạt bài DeepSeek V4.1 Flash
- ByteDance ghi nhận token suy luận sau khi đã tắt chế độ suy luận, giống như Fireworks: DeepSeek V4.1 Flash trên ByteDance: lệnh gọi công cụ khớp nhau, số liệu tính phí thì không
- Baidu ghi nhận Q 38.00 và P 37.77: DeepSeek V4.1 Flash trên Baidu: không kênh khả dụng nào đạt Q và P
- Alibaba Cloud ghi nhận thời gian đến token đầu tiên là 1.34 s và cache đạt 99.37: DeepSeek V4.1 Flash trên Alibaba Cloud: token đầu tiên sau 1.34s, cache đạt 99.37
- Kênh chính thức là mốc cơ sở của Q, với F 94.00: DeepSeek V4.1 Flash trên kênh chính thức: F 94.00, 15 lượt thăm dò không hợp lệ


