

Trong ngày 2026-11-03/04, DeepSeek V4.1 Flash 1017 được kiểm thử trên năm nhà cung cấp thông qua AIHubMix bằng bộ kiểm thử APB Full: cùng câu hỏi, tham số và tập lệnh yêu cầu ở mỗi lần. Hồ sơ APB này chỉ trình bày kết quả chạy trên Baidu, theo từng phần.
Các con số dưới đây chỉ là điểm số, không phải bảng xếp hạng hay khuyến nghị nhà cung cấp. Q 38.00, F 88.39, P 37.77, K 68.85 và R 100 được liệt kê trước; điểm tổng thể 56.48 là chỉ số tóm tắt, không có khoảng tin cậy. Quy tắc chấm điểm tuân theo AIHubMix Provider Benchmark Standard v2.0.
Điểm số của năm nhà cung cấp
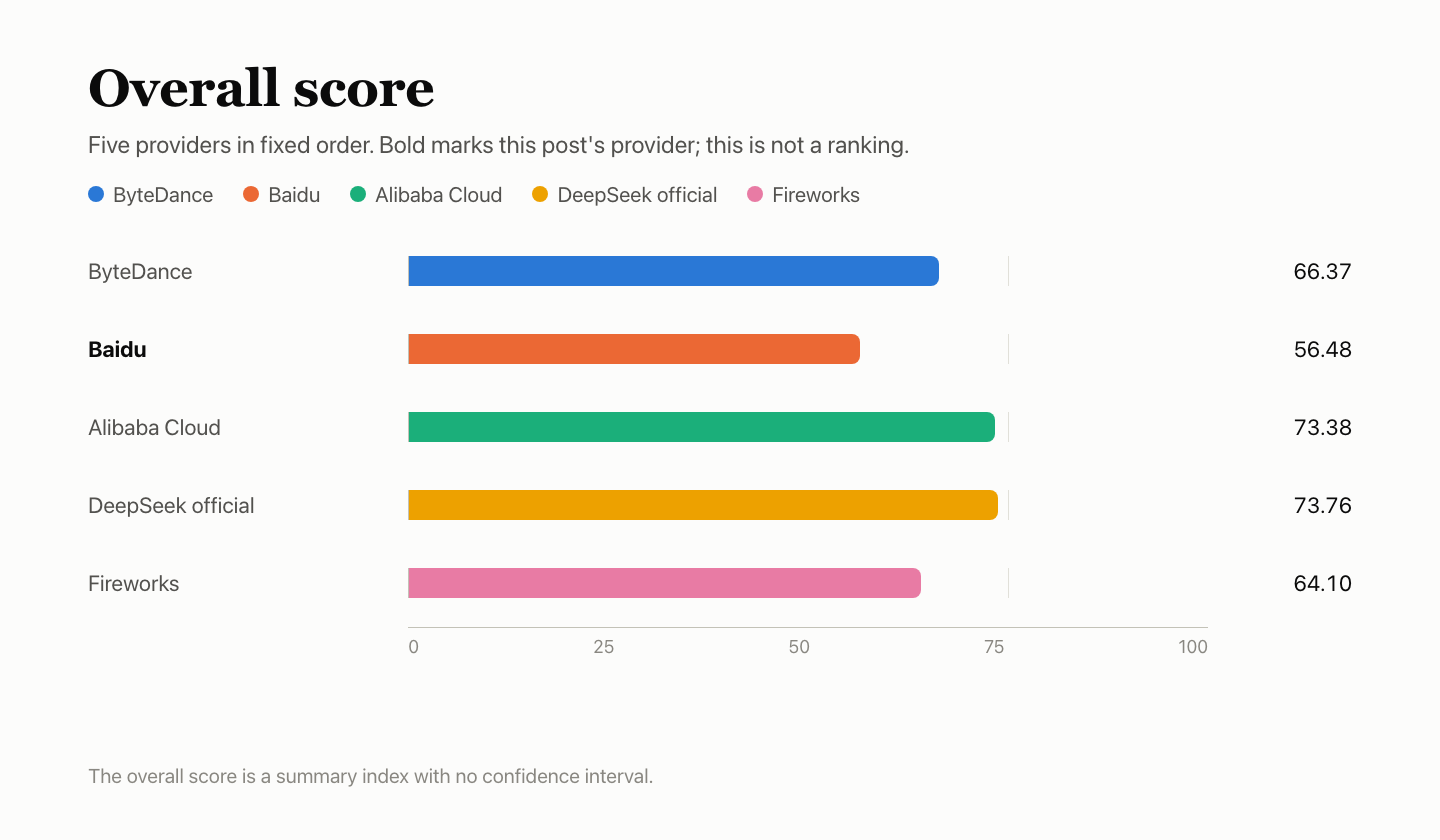
Chữ đậm đánh dấu nhà cung cấp trong bài viết này. Các nhà cung cấp được liệt kê theo thứ tự cố định, không phải thứ hạng. K là điểm thành phần của P, chiếm 20%. Điểm tổng thể là chỉ số tóm tắt, không có khoảng tin cậy. Kênh chính thức và Alibaba Cloud chênh nhau 0.37, mức chênh lệch không thể phân biệt được.
Tóm tắt nhanh
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. Kết quả tổng hợp thấp hơn kênh chính thức 4.46 điểm, với khoảng tin cậy 95% từ −5.78 đến −3.16, không bao gồm 0. HLE ghi nhận 864 yêu cầu thất bại và AA-LCR ghi nhận 100, gần như tất cả đều xảy ra trong cửa sổ đầu tiên và được tính là câu trả lời sai.
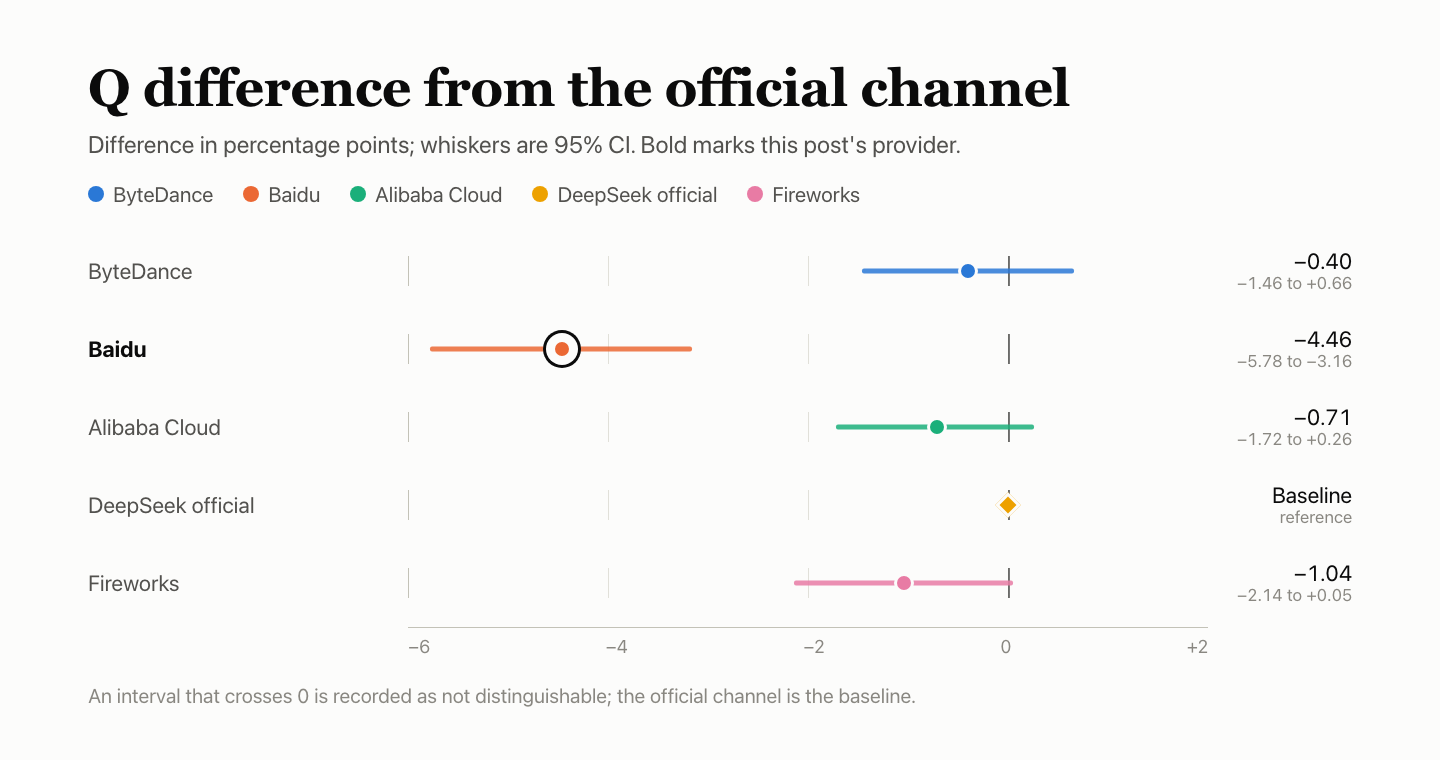
- F: 88.39. Có 148 trong số 174 lượt kiểm tra được tính điểm đạt yêu cầu. Trường số token đọc từ bộ nhớ đệm và số lượng token suy luận không được trả về; các trường hợp vượt ngữ cảnh và kết quả gọi công cụ mồ côi trả về mã 200.
- P: 37.77. Trong 90 phép thử đồng thời 10 luồng, 50 phép thử trả về
no_available_channel, tức hơn một nửa không hợp lệ; vì vậy TTFA và TPOT được chấm theo mức phạt. Các phép thử đơn luồng hợp lệ 78/90 lần. - K: 68.85. Các yêu cầu nóng 8k trúng bộ nhớ đệm 5/9 lần, với 3 yêu cầu thất bại; tiền tố 32k trúng bộ nhớ đệm 8/9 lần. Lượt trúng được báo cáo theo khối 1,024 token: 7,168 token đối với 8k và 31,744 đối với 32k.
- R: 100. Cả 300 yêu cầu chuyên biệt đều thành công ngay lần thử đầu tiên. Lỗi kênh trong quá trình trả lời và các phép thử tốc độ được tính vào Q và P.
Thiết lập kiểm thử
Các yêu cầu sử dụng tuyến bắt đầu nhanh của AIHubMix cùng ID riêng cho từng nhà cung cấp; tham số tuân theo tài liệu API của DeepSeek. ID của các nhà cung cấp khác được liệt kê trên trang model. Đây không phải kết nối trực tiếp tới tài khoản riêng của Baidu.
| Trường | Giá trị |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| ID model được yêu cầu | baidu-deepseek-v4.1-flash-1017 |
| Tên model được trả về | deepseek-v4.1-flash-1017 |
| Tuyến truy cập | Thông qua AIHubMix với ID model riêng cho nhà cung cấp; không kết nối trực tiếp tới tài khoản riêng của nhà cung cấp |
| Tham số | Chế độ không suy luận, temperature 1.0, max_tokens 16,384, thời gian chờ 300 s, không tự động thử lại |
| Tắt suy luận | Mọi yêu cầu đều sử dụng reasoning_effort=none |
| Thời gian | 2026-11-03 18:07 – 11-04 16:33 UTC+8; cả năm nhà cung cấp dùng chung một máy Mac mini, mạng và tài khoản |
| Mẫu | 4,250 lượt thử trả lời (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 trường hợp gọi hàm × 3 cửa sổ; 90 phép thử tốc độ đơn luồng và 90 phép thử đồng thời 10 luồng; 300 yêu cầu kiểm tra độ ổn định; 30 phép thử bộ nhớ đệm (mỗi độ dài tiền tố 8k và 32k có ba nhóm) |
Q — chất lượng câu trả lời: 38.00
Chất lượng câu trả lời được đánh giá qua ba loại tác vụ: 500 tác vụ BFCL, mỗi tác vụ trả lời ba lần; 250 tác vụ HLE, mỗi tác vụ trả lời mười lần; và 25 tác vụ AA-LCR, mỗi tác vụ trả lời mười lần. BFCL được chấm bằng quy tắc tự động; HLE và AA-LCR được model giám khảo deepseek-flash đánh giá đúng hoặc sai. Cả năm nhà cung cấp đều nhận cùng một bộ tác vụ và kết quả của cả ba loại được gộp thành một tỷ lệ chính xác. Mười câu trả lời bị loại vì không thể đánh giá tác vụ, còn lại 4,240 lượt thử được chấm điểm.
| Tác vụ | Số mục | Đúng | Độ chính xác | Lỗi |
|---|---|---|---|---|
| Lượt gọi công cụ BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Câu hỏi khó HLE, do giám khảo chấm | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Lập luận trên tài liệu dài AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Tổng hợp · khoảng tin cậy 95%: 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Lỗi dịch vụ, dù là yêu cầu thất bại hay đầu ra bị cắt cụt, vẫn nằm trong mẫu số và được tính là câu trả lời sai. HLE có 864 yêu cầu thất bại (863 trong cửa sổ đầu tiên, 1 trong cửa sổ thứ hai) và 11 đầu ra bị cắt cụt do chạm giới hạn max_tokens. AA-LCR có 100 yêu cầu thất bại, tất cả đều trong cửa sổ đầu tiên.
Mỗi tác vụ BFCL được trả lời ba lần; bảng hiển thị kết quả gộp của cả ba lượt.
| Danh mục BFCL | Đạt | Tỷ lệ đạt |
|---|---|---|
| simple_python: một hàm, lời gọi và đối số chính xác | 336/360 | 93.33% |
| multiple: chọn đúng hàm trong số nhiều hàm | 269/300 | 89.67% |
| parallel: gọi một hàm nhiều lần song song | 268/300 | 89.33% |
| parallel_multiple: gọi nhiều hàm khác nhau song song | 206/240 | 85.83% |
| irrelevance: không có hàm nào phù hợp, không gọi hàm | 113/150 | 75.33% |
| ahm_multi_turn: chuỗi công cụ ba bước | 104/150 | 69.33% |
So sánh với bốn nhà cung cấp còn lại
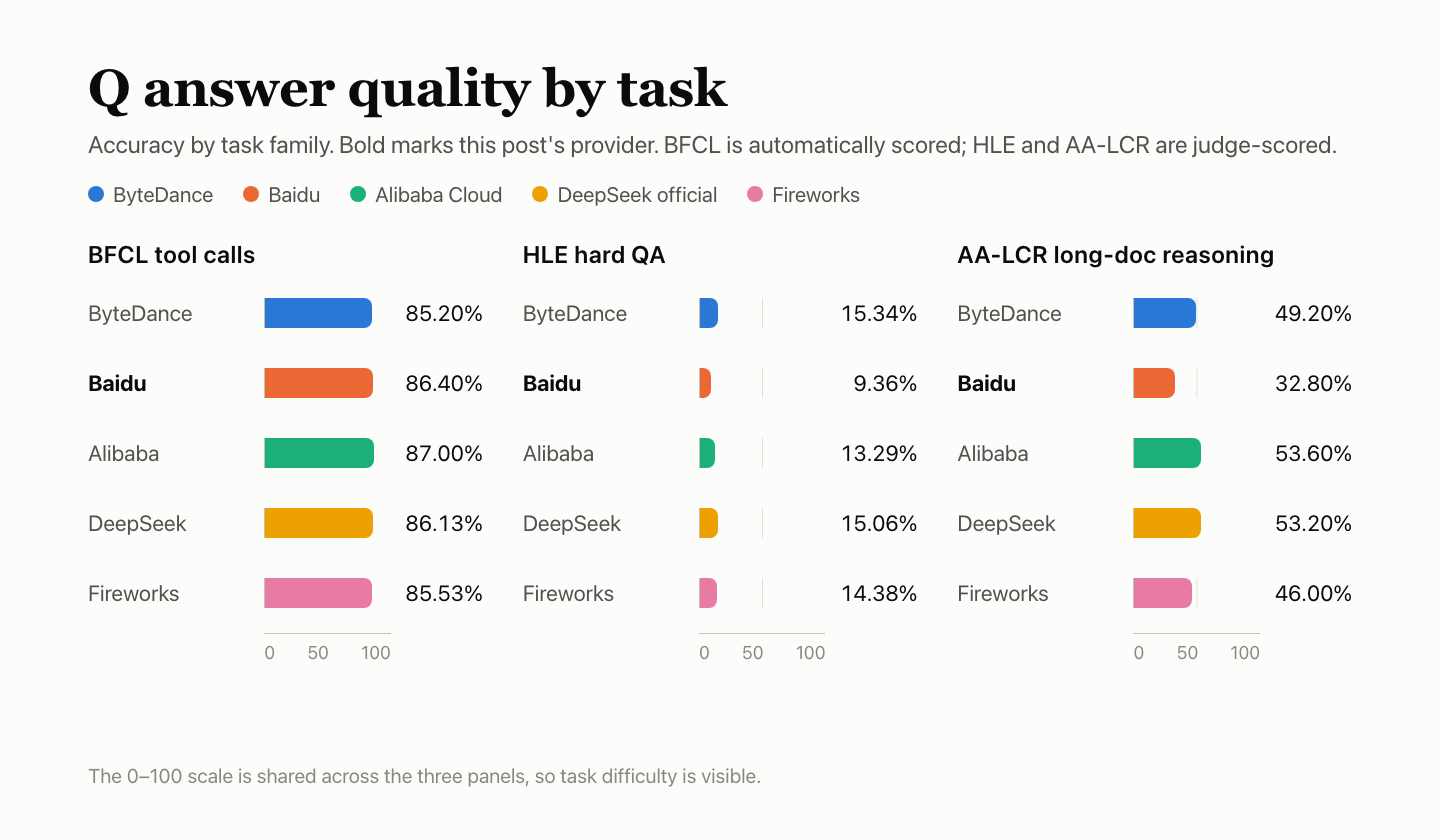
Chênh lệch được tính theo điểm phần trăm so với kênh chính thức; khoảng tin cậy 95% được thể hiện bằng các thanh sai số. Nếu khoảng tin cậy đi qua 0, kết quả được xem là không thể phân biệt. Giám khảo HLE và AA-LCR, deepseek-flash, thuộc cùng họ DeepSeek với model đang kiểm thử và chưa được hiệu chỉnh, vì vậy đánh giá của model này có thể rộng tay.
F — hỗ trợ hàm: 88.39
Các trường hợp kiểm tra hàm đánh giá giao diện có hoạt động theo đúng quy cách giao thức hay không, chứ không đánh giá chất lượng câu trả lời của model. Sáu nhóm gồm 60 trường hợp, mỗi nhóm được chạy một lần trong mỗi cửa sổ, tổng cộng 180 lượt kiểm tra; kết quả được đối chiếu với định dạng mà nhà cung cấp công bố. Các lượt kiểm tra không áp dụng, không hợp lệ hoặc không quan sát được sẽ bị loại khỏi mẫu số. Baidu có 174 lượt được tính điểm và đạt 148 lượt, cho điểm có trọng số là 88.39.
Điểm nhóm được tính theo tỷ trọng của từng nhóm, không phải phép chia đơn giản 148/174.
| Nhóm trường hợp | Trọng số | Đạt | Bị loại | Điểm nhóm |
|---|---|---|---|---|
| Giao thức truyền phát và thông điệp | 20% | 27/27 | 3 | 100.00 |
| Giao diện công cụ | 20% | 30/30 | — | 100.00 |
| Ràng buộc đầu ra và tham số | 20% | 29/30 | — | 96.67 |
| Ngữ cảnh và trạng thái | 15% | 26/30 | — | 86.67 |
| Lỗi và khôi phục | 15% | 21/30 | — | 70.00 |
| Đo lường và giao thức bộ nhớ đệm | 10% | 15/27 | 3 | 55.56 |
| Tổng cộng, có trọng số | 100% | 148/174 | 6 | 88.39 |
| Trường hợp không đạt | Các cửa sổ không đạt | Lý do |
|---|---|---|
| Vượt ngữ cảnh (ngữ cảnh và trạng thái) | 3/3 | Đáng lẽ phải trả về lỗi tham số; thực tế trả về 200 |
| Thông điệp sai định dạng (lỗi và khôi phục) | 3/3 | Trả về 400 với nội dung trống, không có lỗi có cấu trúc |
| Kết quả gọi công cụ mồ côi (lỗi và khôi phục) | 3/3 | Đáng lẽ phải trả về lỗi tham số; thực tế trả về 200 |
| stream_options sai định dạng (lỗi và khôi phục) | 3/3 | Trả về 400 với nội dung trống, không có lỗi có cấu trúc |
| Trường đọc bộ nhớ đệm (đo lường và giao thức bộ nhớ đệm) | 3/3 | Không trả về trường đọc bộ nhớ đệm; không thể xác nhận giá trị |
| Đo lường token suy luận (đo lường và giao thức bộ nhớ đệm) | 3/3 | Không trả về số lượng token suy luận |
| Định nghĩa công cụ được tính vào đầu vào (đo lường và giao thức bộ nhớ đệm) | 3/3 | Khi có định nghĩa công cụ, số token đầu vào được báo cáo không cao hơn khi không có |
| Số lượng đầu vào nhất quán trước và sau khi dùng bộ nhớ đệm (đo lường và giao thức bộ nhớ đệm) | 3/3 | Không trả về trường đọc bộ nhớ đệm; không thể xác nhận giá trị |
| Độ đa dạng khi lấy mẫu (ràng buộc đầu ra và tham số) | 1/3 | Các đầu ra lặp lại ở temperature 0 và 1 khác biệt quá ít, thấp hơn tiêu chuẩn đăng ký trước |
| Cách ly giữa các yêu cầu (ngữ cảnh và trạng thái) | 1/3 | Bước đầu tiên không chỉ trả lời STORED như yêu cầu, nên không thể tiếp tục kiểm tra cách ly |
Các lượt kiểm tra này bị loại khỏi mẫu số: không tính là đạt cũng không tính là không đạt.
| Trạng thái | Trường hợp | Số lượng | Lý do |
|---|---|---|---|
| Không quan sát được | Chuỗi dừng khi truyền phát | 3 | Yêu cầu cho bước này không được gửi sau bước trước, nên không thể đánh giá |
| Không áp dụng | cache_control tường minh | 3 | Được đăng ký trước là không được giao diện này hỗ trợ |
Các thông điệp messages sai định dạng và stream_options sai định dạng đều thất bại trên cả năm nhà cung cấp: cả hai đều trả về 400 với nội dung trống, khiến client không nhận được lỗi có cấu trúc. Lỗi xuất hiện ở cả năm có khả năng nằm tại lớp cổng AIHubMix hơn, cần được điều tra riêng. Đo lường token suy luận cũng thất bại trên cả năm, nhưng vì các lý do khác nhau: ByteDance và Fireworks báo cáo token suy luận dù đã tắt suy luận, còn ba nhà cung cấp kia không trả về số lượng token suy luận.
So sánh với bốn nhà cung cấp còn lại
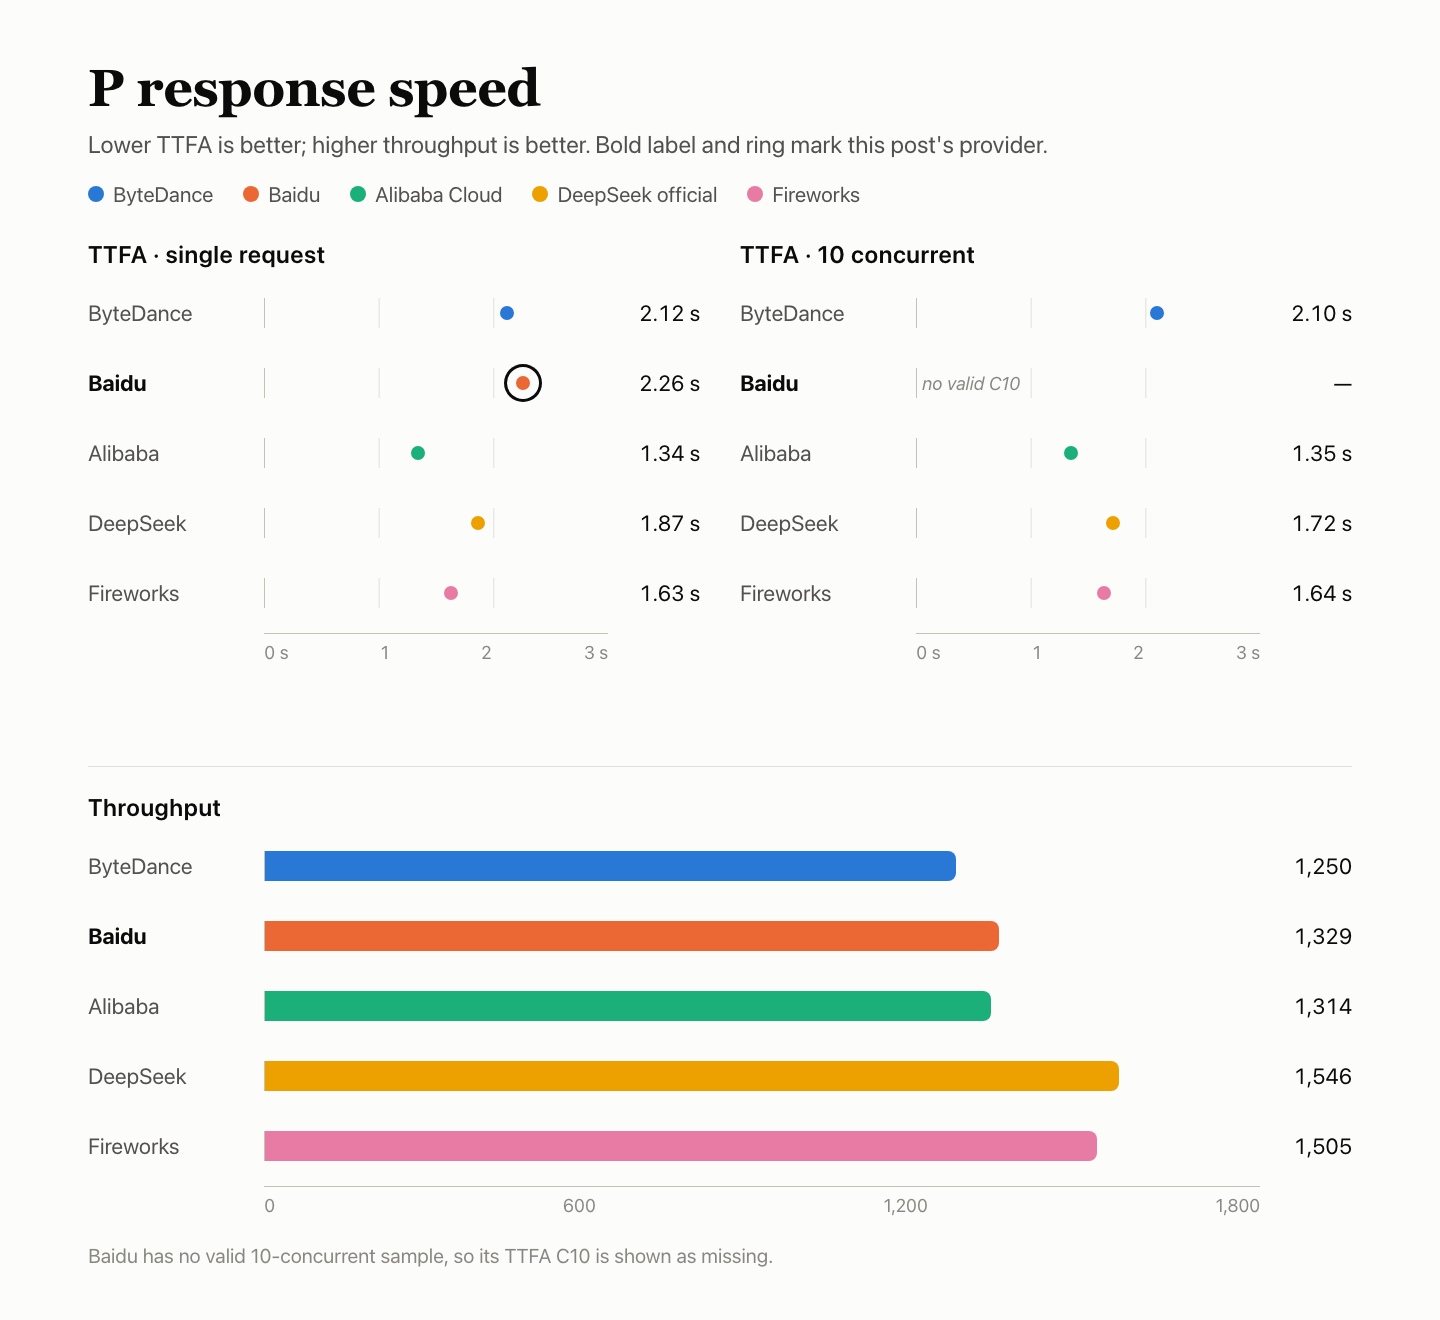
P — tốc độ phản hồi: 37.77
Mỗi yêu cầu mang khoảng 10,000 token đầu vào và yêu cầu nội dung đầu ra khoảng 1,100 token. Qua ba cửa sổ, mỗi cửa sổ gửi 30 phép thử đơn luồng và 30 phép thử đồng thời 10 luồng, tổng cộng 180 yêu cầu.
| Chỉ số | Kết quả |
|---|---|
| TTFA token đầu tiên | Trung vị đơn luồng 2.26 s (trung vị của yêu cầu hợp lệ 2.05 s); hơn một nửa phép thử đồng thời 10 luồng không hợp lệ, trung vị được tính là vô cực (trung vị của yêu cầu hợp lệ 1.86 s) |
| Tốc độ tạo sinh TPOT | Đơn luồng 3.48 ms/token; đồng thời 10 luồng 50.00 ms/token (hơn một nửa không hợp lệ, tính theo mức phạt) |
| Goodput (thông lượng hợp lệ) | Đồng thời 10 luồng: 1,329.2 token/s |
| Yêu cầu hợp lệ | Đơn luồng 78/90 (cửa sổ đầu tiên 18/30); đồng thời 10 luồng 40/90 (cửa sổ đầu tiên 0/30, cửa sổ thứ ba 10/30) |
| Lý do không hợp lệ | 62 phép thử trả về 400 no_available_channel |
| Điểm thành phần | TTFA 0.00, TPOT 0.00, thông lượng 100.00; điểm phản hồi 30.00 |
| Cấu thành P | Điểm phản hồi 30.00 với trọng số 80%, bộ nhớ đệm K 68.85 với trọng số 20%, tổng cộng 37.77 |
TPOT được ước tính từ các chunk truyền phát, không được đo theo từng token trên phần cứng. Goodput là số token đầu ra hợp lệ ở tải đồng thời 10 luồng chia cho thời gian thực của cả batch.
Ở mức đồng thời 10 luồng, 50 trong số 90 phép thử trả về no_available_channel. Vì hơn một nửa không hợp lệ, thời gian trung vị tới token đầu tiên được xem là vô cực, còn TTFA và TPOT đều chịu mức phạt. Mức đơn luồng có 78/90 phép thử hợp lệ.
Cả năm nhà cung cấp dùng chung một máy, mạng và tài khoản. Ba cửa sổ được lên lịch lần lượt theo từng nhà cung cấp, nên các giai đoạn thu thập dữ liệu không trùng khớp hoàn toàn; không nên diễn giải quá mức những chênh lệch nhỏ.
K — bộ nhớ đệm: 68.85
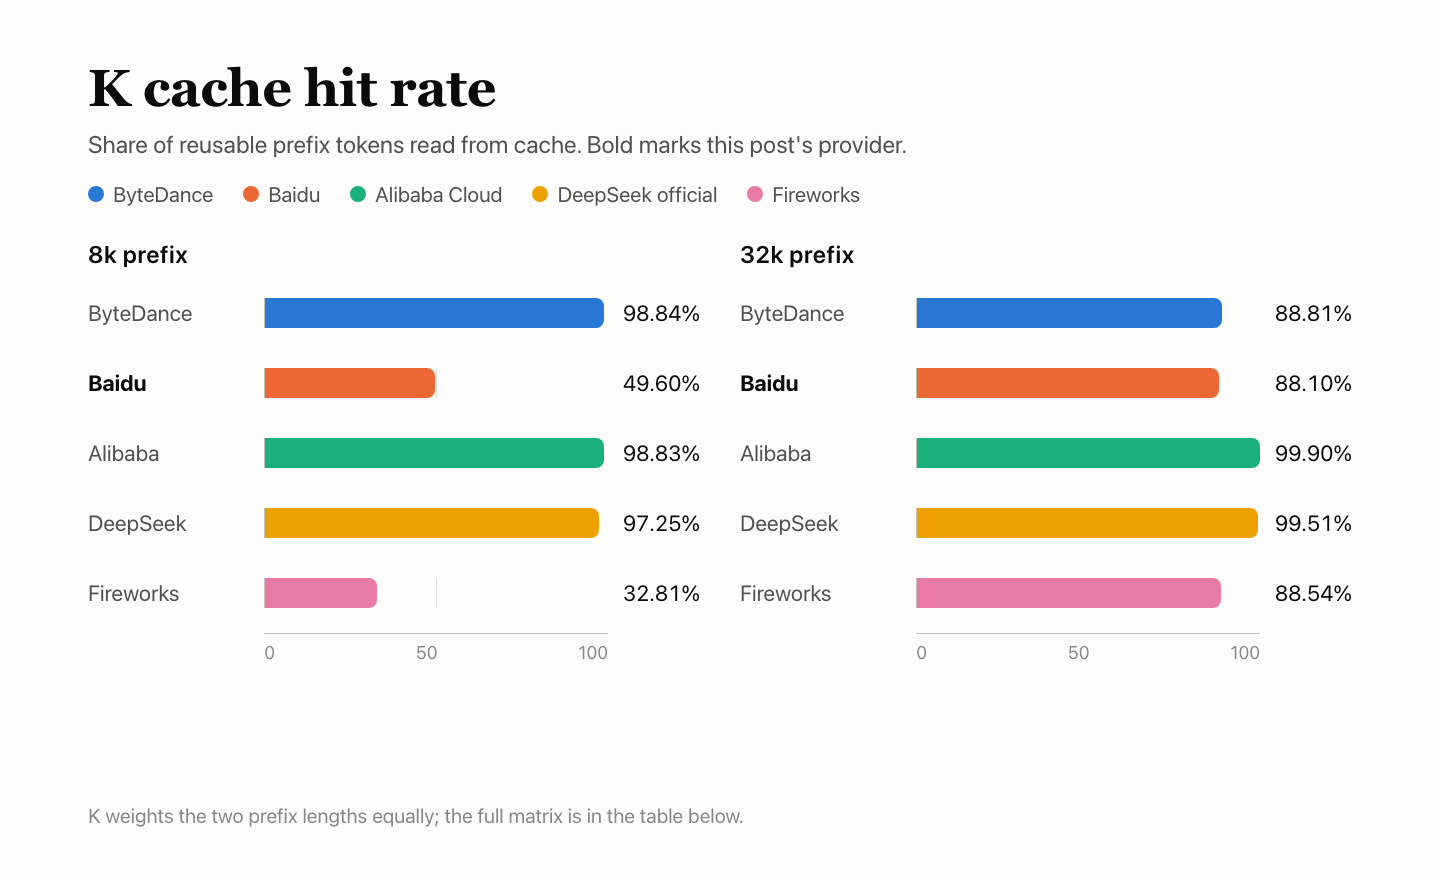
Mỗi nhóm gửi năm yêu cầu. Yêu cầu đầu tiên có một tiền tố cố định khoảng 8k hoặc 32k token để khởi tạo bộ nhớ đệm. Các yêu cầu 2–4 giữ nguyên tiền tố và chỉ thay đổi câu hỏi ở cuối, cách nhau 5 s, 30 s và 120 s. Yêu cầu thứ năm dùng tiền tố mới làm đối chứng chưa có bộ nhớ đệm. Ba cửa sổ × hai độ dài tạo thành 30 yêu cầu. K là số token được các yêu cầu nóng đọc từ bộ nhớ đệm chia cho số token có thể tái sử dụng theo quy tắc, trong đó mỗi độ dài được tính trọng số bằng nhau. K chiếm 20% P.
Bảng hiển thị số token đọc từ bộ nhớ đệm do máy chủ báo cáo; “không trả về” nghĩa là trường này không có trong phản hồi.
| Tiền tố | Cửa sổ | Khởi tạo | +5 s | +30 s | +120 s | Đối chứng không có bộ nhớ đệm |
|---|---|---|---|---|---|---|
| 8k | 1 | Thất bại | Thất bại | Thất bại | Không trả về | Không trả về |
| 8k | 2 | Không trả về | 7,168 | 7,168 | Thất bại | Thất bại |
| 8k | 3 | Không trả về | 7,168 | 7,168 | 7,168 | Không trả về |
| 32k | 1 | Không trả về | Không trả về | 31,744 | 31,744 | Không trả về |
| 32k | 2 | Không trả về | 31,744 | 31,744 | 31,744 | Không trả về |
| 32k | 3 | Không trả về | 31,744 | 31,744 | 31,744 | Không trả về |
Tiền tố 8k trúng bộ nhớ đệm ở 5 trong 9 yêu cầu nóng, đọc 35,840 trong số 72,252 token đáng lẽ có thể tái sử dụng, đạt 49.60. Tiền tố 32k trúng ở 8 trong 9 yêu cầu, đọc 253,952 trong số 288,261, đạt 88.10. K là 68.85 khi tính trọng số hai độ dài ngang nhau. Tổng cộng có năm yêu cầu 8k thất bại: yêu cầu khởi tạo, yêu cầu sau 5 s và 30 s của cửa sổ 1, cùng yêu cầu sau 120 s và yêu cầu đối chứng không dùng bộ nhớ đệm của cửa sổ 2; tất cả đều có lỗi no_available_channel. Như vậy, tầng 8k có ba yêu cầu nóng thất bại.
Khi trúng bộ nhớ đệm, lượng đọc được báo cáo tính theo khối 1,024 token: 7,168 token cho tiền tố 8k và 31,744 cho tiền tố 32k. Khi không trúng, khối usage không có prompt_tokens_details; bảng ghi là "không trả về" và giá trị được tính bằng 0.
So với bốn nhà cung cấp còn lại
R — độ ổn định dịch vụ: 100
300 yêu cầu thuộc bốn loại: văn bản ngắn, đầu vào dài, gọi công cụ và lịch sử nhiều lượt. Chúng được gửi với mức đồng thời đơn lẻ qua ba cửa sổ. Chỉ kiểm tra phản hồi đầu tiên có hợp lệ và đầy đủ hay không; câu trả lời không được chấm điểm và không có yêu cầu nào được gửi lại. Lỗi trong các lượt chạy trả lời và đo tốc độ được tính vào Q và P, không tính lại vào R.
| Loại yêu cầu | Thành công ngay lần thử đầu tiên |
|---|---|
| Văn bản ngắn | 120/120 |
| Đầu vào dài 10k | 90/90 |
| Gọi công cụ | 60/60 |
| Lịch sử nhiều lượt | 30/30 |
| Tổng cộng | 300/300, KTC 95% 98.78%–100% |
Cả 300 yêu cầu đều trả về phản hồi hợp lệ, đầy đủ ngay lần thử đầu tiên. R 100 chỉ áp dụng cho 300 yêu cầu chuyên biệt này; điều đó không có nghĩa là toàn bộ đường truyền không gặp lỗi. Với 300/300 yêu cầu thành công, cận dưới của khoảng tin cậy 95% là 98.78%, nên tỷ lệ lỗi có khả năng dưới 1.22%.
So với bốn nhà cung cấp còn lại
R chỉ áp dụng cho 300 yêu cầu chuyên biệt này; lỗi trong các lượt chạy trả lời và đo tốc độ được ghi nhận vào Q và P, không tính lại vào R.
| Nhà cung cấp | Thành công ngay lần thử đầu tiên | Khoảng tin cậy 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Câu hỏi thường gặp
Điểm tổng thể thể hiện điều gì?
Đây là chỉ số tổng hợp không có khoảng tin cậy, không phải chứng nhận. Bài viết này báo cáo Q, F, P, K và R, không đưa ra khuyến nghị nhà cung cấp.
Vì sao một nửa số lượt đo với 10 yêu cầu đồng thời thất bại?
50 trong số 90 lượt trả về no_available_channel. Vì hơn một nửa số lượt không hợp lệ, thời gian trung vị đến token đầu tiên được xem là vô hạn, còn TTFA và TPOT được chấm theo mức phạt.
R 100 có nghĩa là không có lỗi kênh không?
Không. R áp dụng cho 300 yêu cầu chuyên biệt, tất cả đều thành công ngay lần thử đầu tiên. 62 phản hồi no_available_channel trong lượt chạy đo tốc độ và các lỗi trong lượt chạy trả lời được tính vào P và Q.
Vì sao K là 68.85 khi tiền tố 32k trúng bộ nhớ đệm 8 trong 9 lần?
Hai độ dài có trọng số ngang nhau. Tiền tố 8k trúng bộ nhớ đệm ở 5 trong 9 yêu cầu nóng và đạt 49.60, trong khi tiền tố 32k trúng ở 8 trong 9 lần và đạt 88.10; điểm trung bình là 68.85.
Có thể phân biệt chất lượng câu trả lời của Baidu với kênh chính thức không?
Có. Chênh lệch Q tổng hợp là −4.46 điểm phần trăm, với khoảng tin cậy 95% từ −5.78 đến −3.16, không bao gồm 0. Đây là kết quả duy nhất của một nhà cung cấp thấp hơn kênh chính thức mà khoảng tin cậy không bao gồm 0.
Những kiểm tra nào bị loại khỏi F?
Có sáu kiểm tra: ba kiểm tra chuỗi dừng khi truyền phát chưa từng được quan sát vì yêu cầu ở bước trước đó không được gửi, và ba kiểm tra cache_control tường minh đã được đăng ký trước là không được giao diện này hỗ trợ.
Đọc tiếp: loạt bài DeepSeek V4.1 Flash
- Độ chính xác BFCL của Baidu gần với kênh chính thức; bài viết về ByteDance tiếp tục dùng cùng bộ kiểm thử để xem xét kết quả gọi công cụ và tính phí: DeepSeek V4.1 Flash trên ByteDance: gọi công cụ tương đồng, tính phí thì không
- TTFA 2.26 s của Baidu khi chỉ có một yêu cầu đồng thời tương phản với lượt chạy đạt 1.34 s: DeepSeek V4.1 Flash trên Alibaba Cloud: token đầu tiên sau 1.34s, bộ nhớ đệm đạt 99.37
- F 88.39 của Baidu thấp hơn lượt chạy tham chiếu đạt 94.00 với 15 lượt đo không hợp lệ: DeepSeek V4.1 Flash trên kênh chính thức: F 94.00, 15 lượt đo không hợp lệ
- Số lượt trúng bộ nhớ đệm 8k của Baidu là 5/9, so với lượt chạy đạt 3/9 và phản hồi dừng trống: DeepSeek V4.1 Flash trên Fireworks: phản hồi dừng trống, 3/9 lượt trúng bộ nhớ đệm


