

Trong đợt chạy APB Full ngày 2026-11-03/04, bốn điểm số của Pareto lần lượt là Q 44.58, F 93.42, P 57.69 và R 100, với điểm tổng thể 68.72. Các yêu cầu nóng 8k trúng bộ nhớ đệm 2/9 lần và yêu cầu 32k trúng 3/9 lần.
Ngày 2026-11-03/04, DeepSeek V4.1 Flash 1017 được thử nghiệm trên sáu nhà cung cấp thông qua AIHubMix với bộ kiểm thử APB Full; mỗi nhà cung cấp dùng cùng câu hỏi, tham số và tập lệnh gửi yêu cầu. Hồ sơ APB này chỉ đề cập đến Pareto: từng phần đo lường điều gì và kết quả ra sao.
Các số liệu dưới đây là điểm số, không phải bảng xếp hạng hay khuyến nghị nhà cung cấp. Bốn điểm Q, F, P và R được trình bày trước; điểm tổng thể là chỉ số tóm tắt, không phải chứng nhận và không có khoảng tin cậy. Quy tắc tính điểm được xác định trong Tiêu chuẩn Benchmark Nhà cung cấp AIHubMix v2.0.
Điểm số của sáu nhà cung cấp
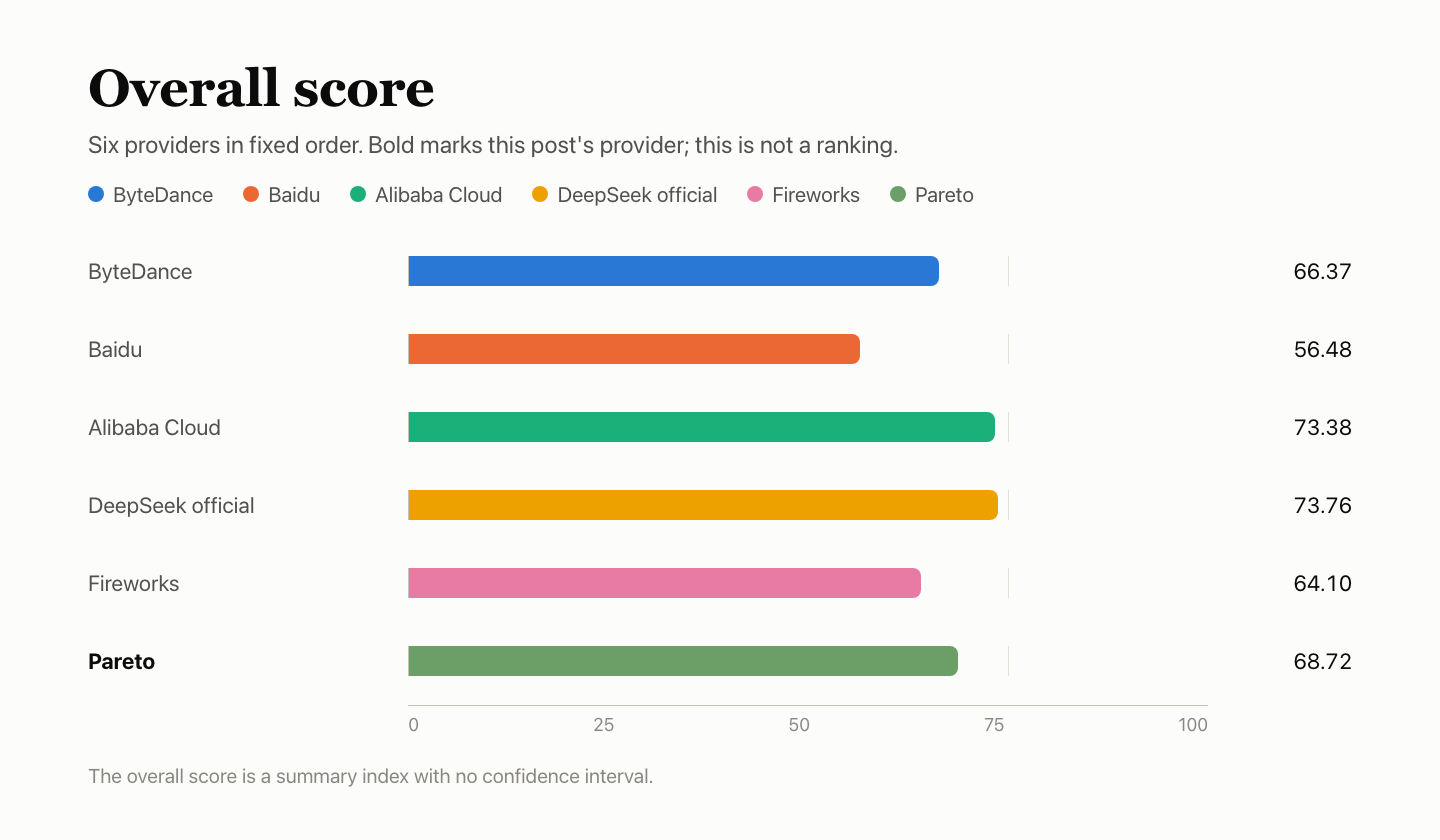
| Nhà cung cấp | Q chất lượng | F chức năng | P tốc độ | K bộ nhớ đệm | R độ ổn định | Tổng thể |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Kênh chính thức DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (bài viết này) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Các nhà cung cấp được liệt kê theo thứ tự cố định, không phải thứ hạng. K là điểm thành phần của P, chiếm 20% điểm P, và được liệt kê riêng để tham khảo. Điểm tổng thể được tính theo quy tắc tổng hợp của Tiêu chuẩn Benchmark Nhà cung cấp AIHubMix; cách tính này cũng xét đến kết quả so sánh với kênh chính thức và mức độ đầy đủ của bằng chứng, nên không phải là tổng có trọng số trực tiếp của bốn điểm trong bảng. Đây là chỉ số tóm tắt, không có khoảng tin cậy. Điểm tổng thể của kênh chính thức DeepSeek và Alibaba Cloud chỉ chênh nhau 0.37, không thể phân biệt được.
Tóm tắt nhanh
- Chất lượng câu trả lời: Q 44.58, với BFCL 85.27%, HLE 19.32% và AA-LCR 52.00%. Chênh lệch so với kênh chính thức là +2.12 điểm phần trăm, với khoảng 95% từ −0.02 đến +4.18: không thể phân biệt được.
- Hỗ trợ chức năng: F 93.42, với 29/33 lượt kiểm tra chấm điểm ban đầu đạt. Các bản ghi truyền phát bổ sung cho thấy gọi công cụ và vòng khứ hồi kết quả công cụ, gọi song song và gọi theo tên, chế độ JSON cùng lịch sử hội thoại đều thành công; điểm số vẫn giữ nguyên giá trị ban đầu.
- Tốc độ phản hồi: P 57.69. Trung vị thời gian đến token nội dung đầu tiên là 5.85 s ở mức đồng thời đơn và 6.13 s ở mức đồng thời 10 luồng; TPOT 4.63 ms; 110/180 yêu cầu tốc độ hợp lệ.
- Bộ nhớ đệm: K 27.58. Các yêu cầu nóng 8k trúng bộ nhớ đệm 2/9 lần và yêu cầu nóng 32k trúng 3/9 lần; không lượt đọc đối chứng lạnh nào truy cập bộ nhớ đệm.
- Độ ổn định dịch vụ: R 100. Cả 300 yêu cầu chuyên biệt đều thành công ngay lần thử đầu tiên.
Thiết lập kiểm thử
| Mục | Chi tiết |
|---|---|
| Mô hình | DeepSeek V4.1 Flash 1017 |
| ID mô hình được yêu cầu | deepseek/deepseek-v4.1-flash |
| Tên mô hình được trả về | deepseek/deepseek-v4.1-flash |
| Tuyến truy cập | Thông qua AIHubMix với ID mô hình riêng cho từng nhà cung cấp, không kết nối trực tiếp đến tài khoản của nhà cung cấp |
| Tham số | Cấu hình yêu cầu APB v2 cố định, temperature 1.0, max_tokens 16,384, thời gian chờ 300 s, không tự động thử lại |
| Thời gian | 2026-11-03 18:07 – 11-04 16:33; các yêu cầu bộ nhớ đệm: 11-05 19:31 – 11-06 10:35; tất cả theo UTC+8. Cả sáu nhà cung cấp dùng chung một máy Mac mini, một mạng và một tài khoản. |
| Mẫu | Q 4,250 lượt câu hỏi; F 180 lượt kiểm tra; P 180 yêu cầu; R 300; K 30 |
Các yêu cầu sử dụng tuyến bắt đầu nhanh của AIHubMix với ID mô hình riêng cho từng nhà cung cấp; ID của các nhà cung cấp khác được liệt kê trên trang mô hình. Tham số riêng của mô hình được mô tả trong tài liệu API của DeepSeek.
Q — chất lượng câu trả lời: 44.58
Chất lượng câu trả lời được đánh giá bằng ba bộ kiểm thử: 500 câu hỏi BFCL, mỗi câu trả lời 3 lần; 250 câu hỏi HLE, mỗi câu trả lời 10 lần; và 25 câu hỏi AA-LCR, mỗi câu trả lời 10 lần. BFCL được chấm bằng quy tắc tự động; HLE và AA-LCR được mô hình giám khảo deepseek-flash đánh giá đúng hoặc sai. Cả sáu nhà cung cấp nhận cùng câu hỏi, rồi kết quả của ba bộ được gộp thành một độ chính xác. Mười câu trả lời bị loại vì không thể chấm điểm câu hỏi, còn lại 4,240 lượt câu hỏi được chấm điểm.
| Bộ kiểm thử | Số câu hỏi × số lượt | Đúng | Độ chính xác | Lỗi dịch vụ |
|---|---|---|---|---|
| Lượt gọi công cụ BFCL, chấm tự động | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| QA khó HLE, do giám khảo chấm | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Suy luận tài liệu dài AA-LCR, do giám khảo chấm | 25 × 10 | 130/250 | 52.00% | 0 |
| Tổng · khoảng 95% 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Mỗi lượt câu hỏi đều nhận được câu trả lời đầy đủ; không có lỗi dịch vụ.
| Danh mục BFCL | Đạt | Tỷ lệ đạt |
|---|---|---|
| simple_python: một hàm, gọi đúng và dùng đúng đối số | 333/360 | 92.50% |
| multiple: chọn đúng một trong nhiều hàm | 269/300 | 89.67% |
| parallel: gọi một hàm nhiều lần cùng lúc | 265/300 | 88.33% |
| parallel_multiple: gọi nhiều hàm cùng lúc | 203/240 | 84.58% |
| irrelevance: không có hàm phù hợp nên không gọi hàm | 109/150 | 72.67% |
| ahm_multi_turn: chuỗi công cụ ba giai đoạn | 100/150 | 66.67% |
Mỗi câu hỏi BFCL được trả lời 3 lần; bảng cộng tổng của cả 3 lượt.
So sánh với năm nhà cung cấp còn lại
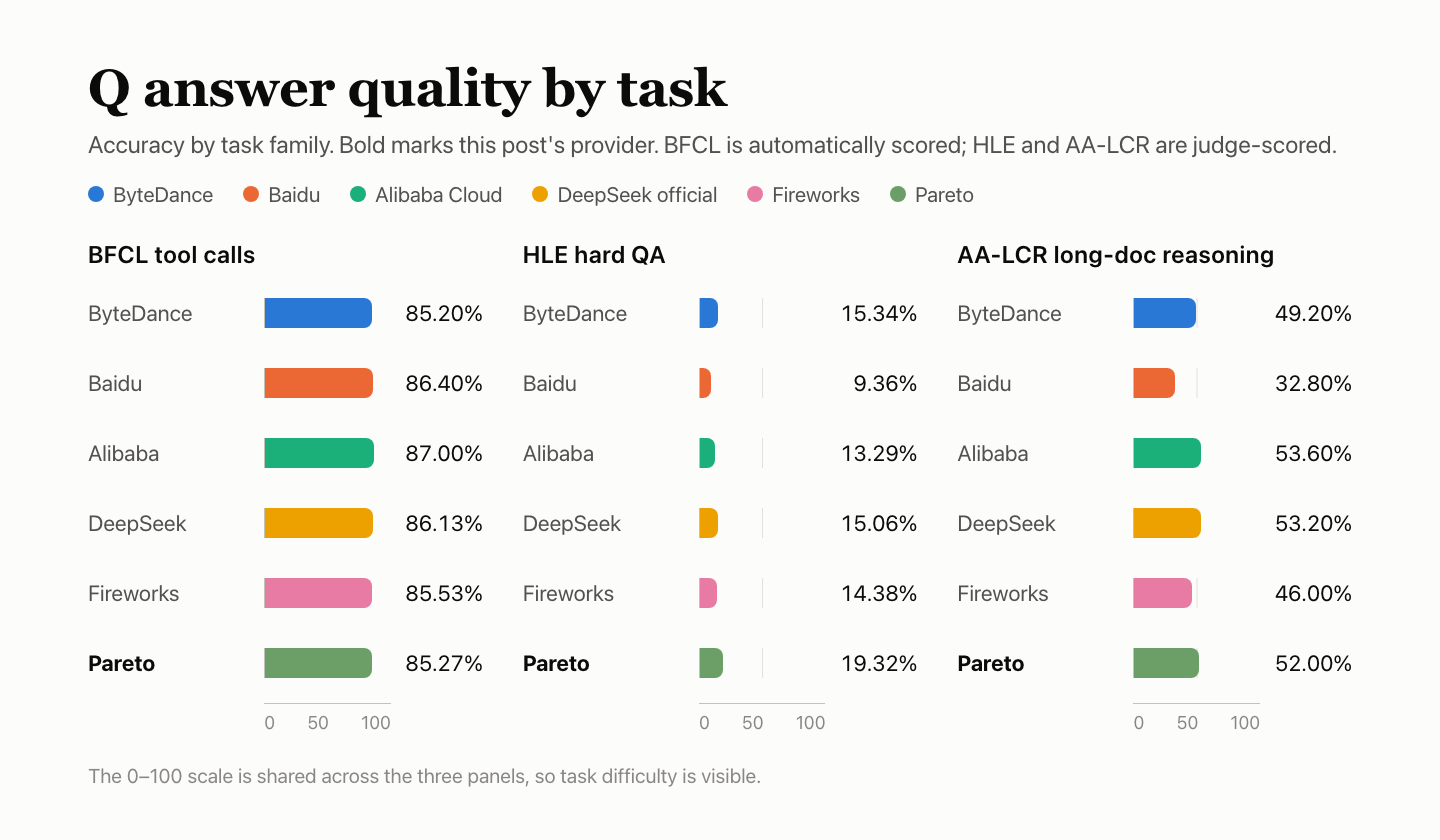
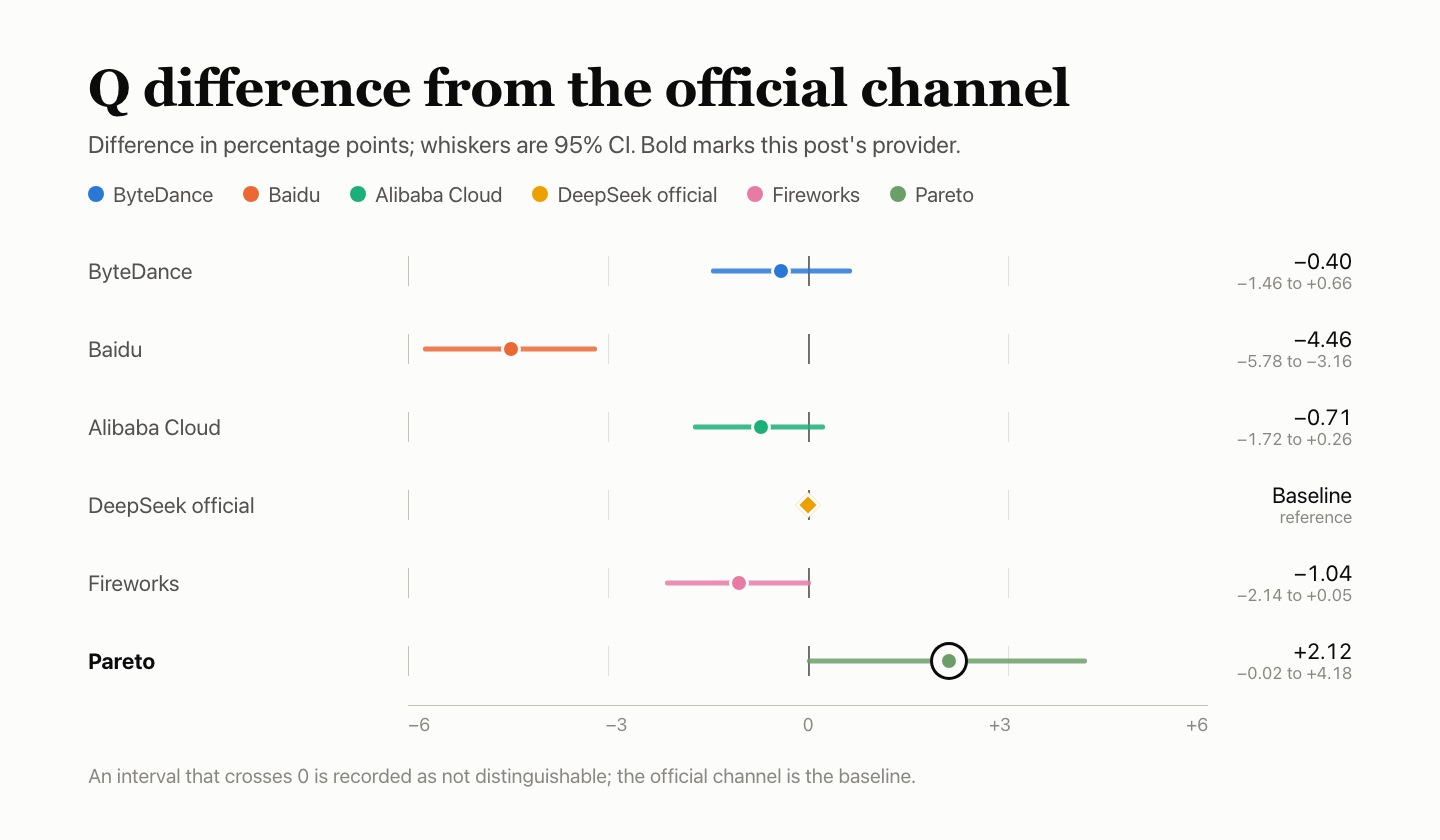
| Nhà cung cấp | BFCL | HLE | AA-LCR | Gộp | So với chính thức |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 đến +0.66), không thể phân biệt được |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 đến −3.16), thấp hơn bản chính thức |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 đến +0.26), không thể phân biệt được |
| Kênh chính thức DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Mốc chuẩn |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 đến +0.05), không thể phân biệt được |
| Pareto (bài viết này) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 đến +4.18), không thể phân biệt được |
So với chính thức: chênh lệch độ chính xác tính theo điểm phần trăm, kèm khoảng 95% trong ngoặc; nếu khoảng này đi qua 0 thì kết quả được ghi nhận là không thể phân biệt. Mô hình giám khảo deepseek-flash dùng cho HLE và AA-LCR thuộc cùng họ DeepSeek với mô hình được kiểm thử và chưa được hiệu chuẩn, nên các đánh giá có thể dễ dãi.
F — hỗ trợ chức năng: 93.42
Các trường hợp chức năng kiểm tra xem hành vi giao diện có tuân thủ giao thức hay không. F 93.42 được tính từ 33 lượt kiểm tra được tính điểm (29 lượt đạt), sau khi chuẩn hóa lại trọng số của các nhóm quan sát được; 147 lượt kiểm tra còn lại trong bộ kiểm thử ban đầu đã bị loại khỏi phần tính điểm.
| Nhóm trường hợp | Trọng số | Lượt đạt / quan sát truyền phát | Bị loại | Điểm nhóm |
|---|---|---|---|---|
| Truyền phát và giao thức thông điệp | 20% | 23/27 | 3 | 85.19 |
| Giao diện công cụ Gọi công cụ, vòng khứ hồi kết quả công cụ, gọi song song và gọi theo tên | 20% | Quan sát thấy các lượt truyền phát đạt* | 30 | — |
| Các giới hạn và tham số đầu ra Tắt chế độ JSON và suy luận | 20% | Quan sát thấy các lượt truyền phát đạt* | 30 | — |
| Ngữ cảnh và trạng thái Lịch sử hội thoại và chỉ dẫn hệ thống | 15% | Quan sát thấy các lượt truyền phát đạt* | 30 | — |
| Lỗi và khôi phục | 15% | 3/3 | 27 | 100.00 |
| Giao thức đo lường và bộ nhớ đệm | 10% | 3/3 | 27 | 100.00 |
| Tổng · điểm có trọng số | 29/33 | 147 | 93.42 | |
- Các tính năng được liệt kê có bản ghi truyền phát thành công; điều này không đồng nghĩa với việc cả nhóm đều đạt điểm tối đa. Không bổ sung lượt kiểm tra nào vào phần tính điểm. F 93.42 và điểm tổng thể 68.72 vẫn giữ nguyên giá trị ban đầu.
| Trường hợp thất bại | Cửa sổ | Lý do |
|---|---|---|
| Chuỗi dừng khi truyền phát Truyền phát và giao thức thông điệp | 3/3 | Nội dung phản hồi rỗng khi có chuỗi dừng; cùng đầu vào nhưng không có chuỗi dừng thì hoạt động |
| Đầu ra văn bản chính xác Truyền phát và giao thức thông điệp | 1/3 | Dấu chấm cuối thừa khiến kết quả không khớp chính xác với văn bản yêu cầu |
“Cửa sổ” là số cửa sổ trong tổng số 3 cửa sổ không vượt qua lượt kiểm tra.
Các trường hợp thông điệp sai định dạng và tùy chọn luồng dữ liệu sai định dạng trả về mã 400 với phần thân phản hồi rỗng trên một số nhà cung cấp. Cách đo lường token suy luận cũng khác nhau giữa các nhà cung cấp.
So sánh với năm nhà cung cấp còn lại
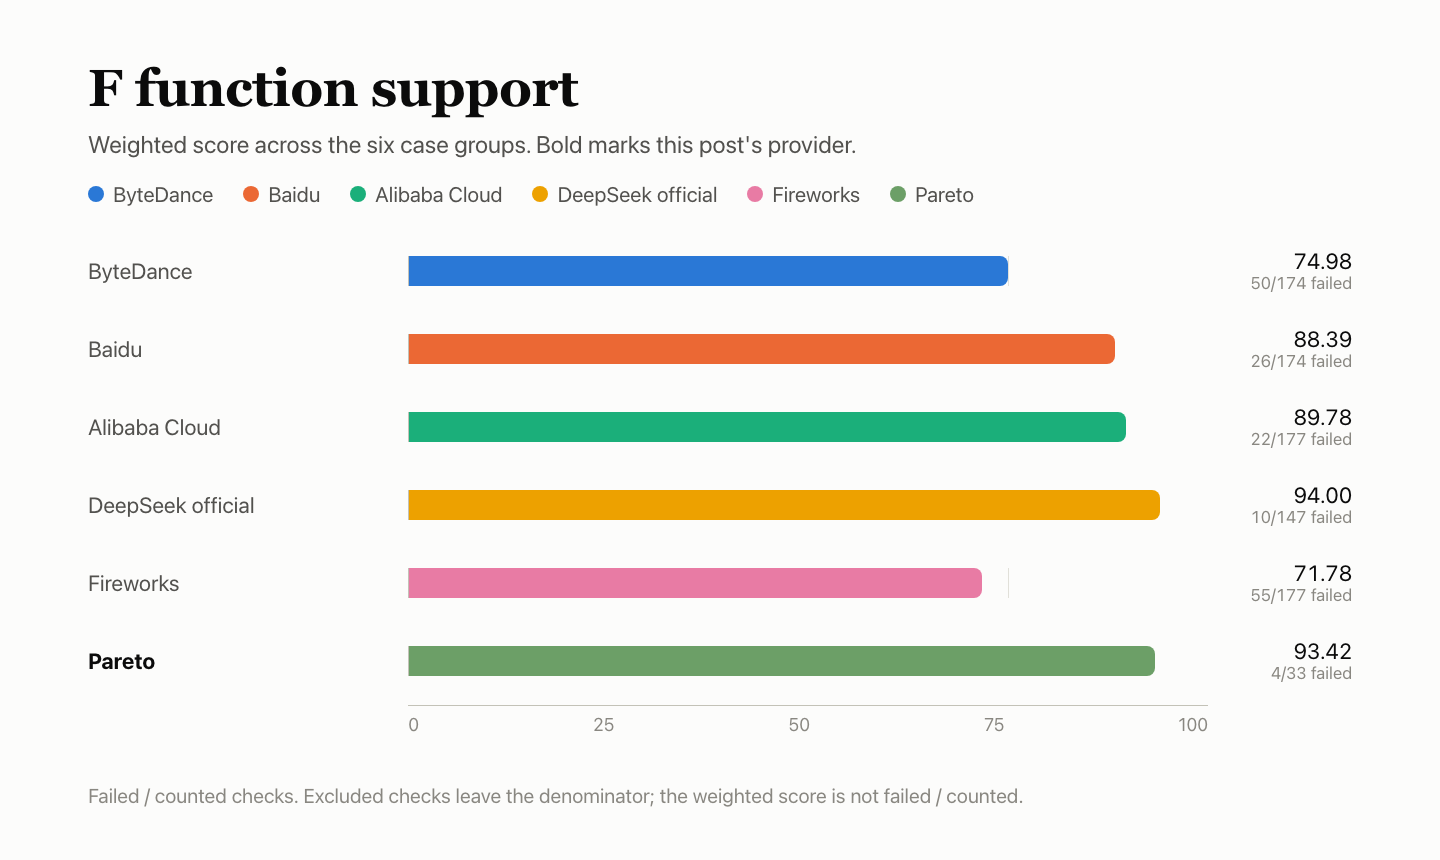
| Nhà cung cấp | Đạt | Không đạt | Bị loại | Điểm có trọng số |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Kênh chính thức DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (bài viết này) | 29 | 4 | 147 | 93.42 |
P — tốc độ phản hồi: 57.69
Mỗi yêu cầu có khoảng 10,000 token đầu vào và yêu cầu khoảng 1,100 token nội dung đầu ra. Trong mỗi một trong ba cửa sổ, 30 yêu cầu chạy ở mức đồng thời đơn và 30 yêu cầu ở mức đồng thời 10 luồng: tổng cộng 180 yêu cầu.
| Mục | Chi tiết |
|---|---|
| Token nội dung đầu tiên (TTFA) | Trung vị 5.85 s ở mức đồng thời đơn (chỉ tính lượt hợp lệ: 3.08 s), 6.13 s ở mức đồng thời 10 luồng (chỉ tính lượt hợp lệ: 4.92 s) |
| Tốc độ tạo sinh (TPOT) | 4.42 ms/token ở mức đồng thời đơn, 4.63 ms/token ở mức đồng thời 10 luồng |
| Thông lượng hiệu dụng | 519.4 token/s ở mức đồng thời 10 luồng |
| Yêu cầu hợp lệ | 53/90 ở mức đồng thời đơn (cửa sổ 1–3: 15/30, 18/30, 20/30), 57/90 ở mức đồng thời 10 luồng (23/30, 16/30, 18/30); không hợp lệ: 70 yêu cầu trả về 200 với None |
| Điểm thành phần | TTFA 24.59, TPOT 100.00, thông lượng 72.05; TTFA và TPOT thuộc nhóm trọng số thấp hơn, lần lượt chiếm 35% / 35% / 30%: điểm phản hồi 65.22 |
| Điểm P | Điểm phản hồi 65.22 × 80% + K bộ nhớ đệm 27.58 × 20% = 57.69 |
Yêu cầu không hợp lệ được tính như có giá trị vô hạn, nên các giá trị trung vị trong bảng có thể cao hơn trung vị chỉ tính lượt hợp lệ. TPOT được ước tính từ các phần dữ liệu truyền phát, không phải đo trực tiếp từng token trên phần cứng. Thông lượng được tính bằng số token đầu ra hợp lệ ở mức đồng thời 10 luồng chia cho thời gian thực hiện cả lô.
So sánh với năm nhà cung cấp còn lại
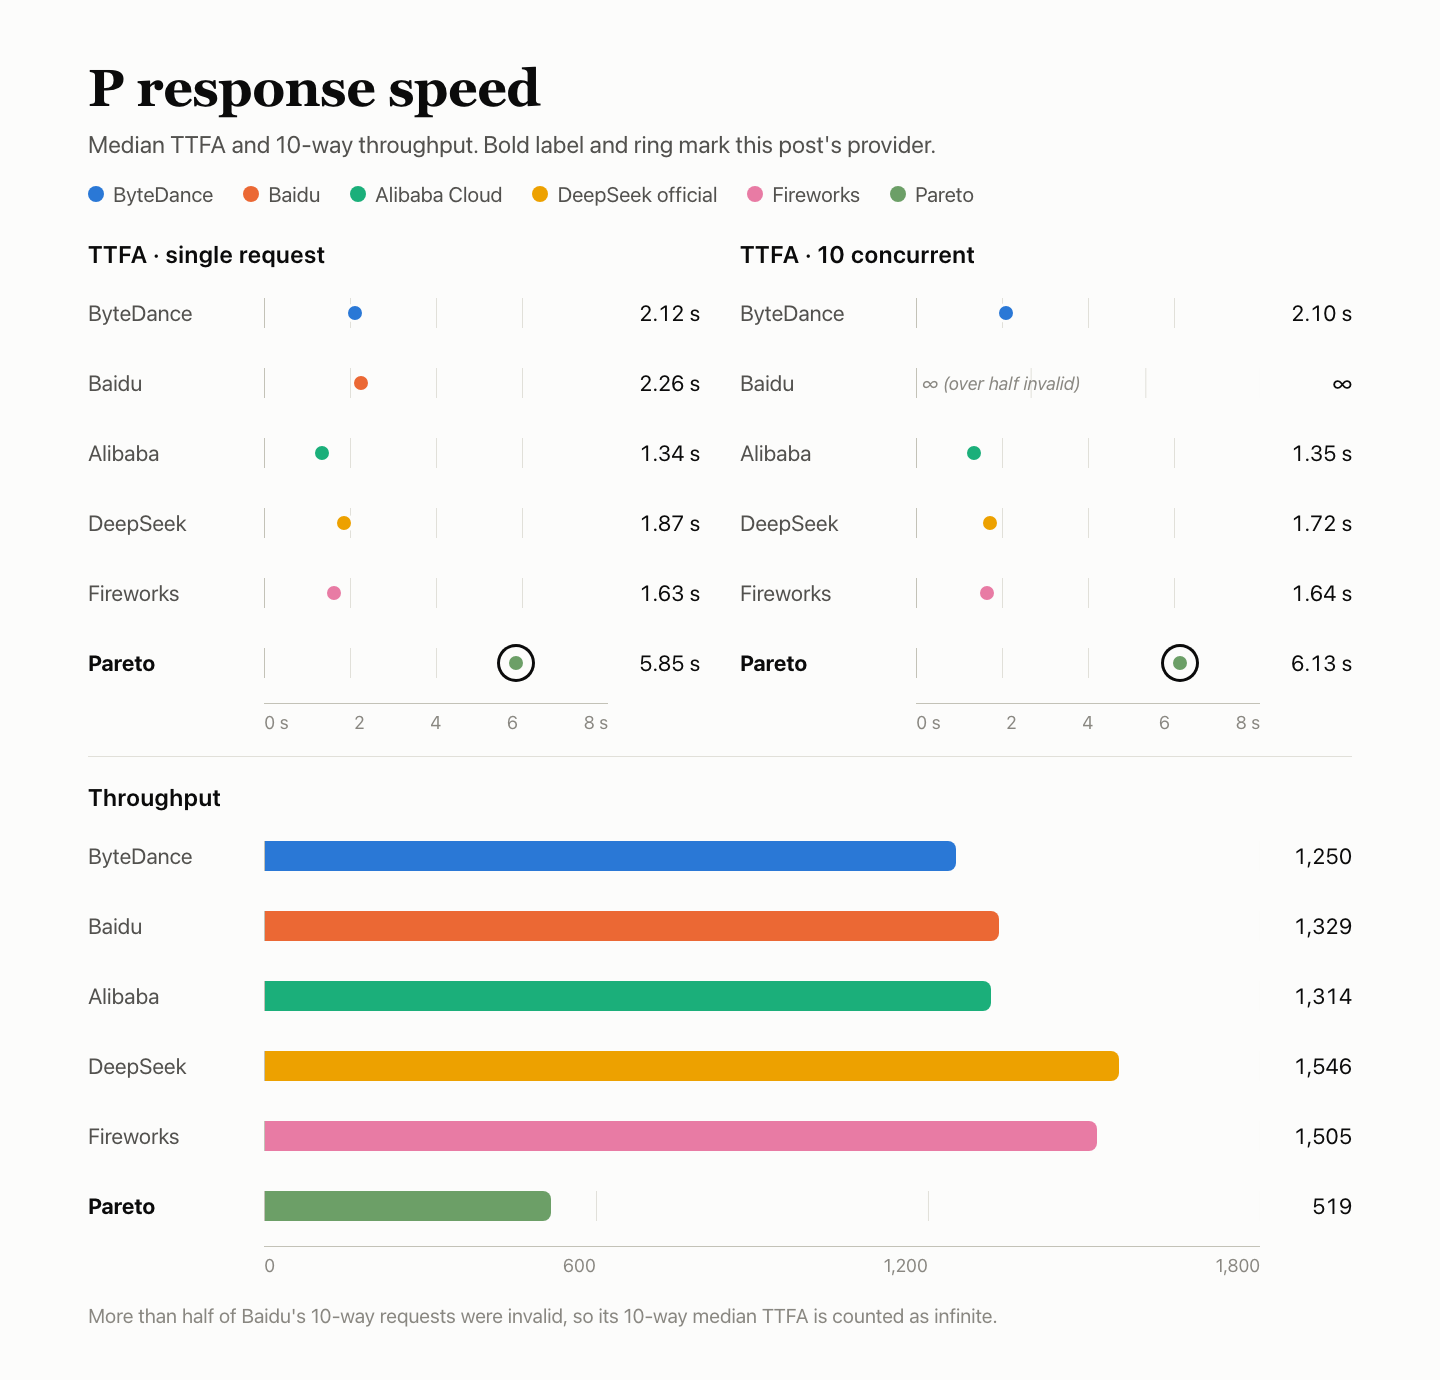
| Nhà cung cấp | Yêu cầu hợp lệ | TTFA đồng thời đơn | TTFA đồng thời 10 luồng | TPOT (chậm hơn) | Thông lượng token/s | Phản hồi |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Kênh chính thức của DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (bài viết này) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Cả sáu cùng dùng một máy, mạng và tài khoản. Ba khung thời gian được lên lịch lần lượt theo từng nhà cung cấp, nên các khoảng thu thập không trùng khớp hoàn toàn; không nên diễn giải quá mức những chênh lệch nhỏ. ∞ nghĩa là hơn một nửa số yêu cầu không hợp lệ, nên trung vị được tính là vô hạn.
K — bộ nhớ đệm: 27.58
Mỗi nhóm gửi năm yêu cầu. Yêu cầu đầu tiên mang tiền tố cố định khoảng 8k hoặc 32k token và khởi tạo bộ nhớ đệm. Các yêu cầu 2–4 giữ nguyên tiền tố, chỉ thay đổi câu hỏi cuối cùng, với khoảng cách lần lượt là 5 s, 30 s và 120 s. Yêu cầu thứ năm dùng tiền tố mới làm đối chứng lạnh. Ba khung thời gian × hai độ dài tạo thành 30 yêu cầu. K là số token bộ nhớ đệm được đọc bởi các yêu cầu nóng chia cho số token lẽ ra có thể tái sử dụng theo quy tắc, trong đó hai độ dài được tính trọng số ngang nhau; K chiếm 20% của P.
| Khung thời gian | 1 · khởi tạo | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · lạnh |
|---|---|---|---|---|---|
| Tiền tố 8k · yêu cầu nóng trúng bộ nhớ đệm 2/9 · đọc 15,872 trên 72,504 token có thể tái sử dụng · 21.89 | — | — | — | — | — |
| Khung thời gian 1 | 0 | 0 | 7,936 | 0 | 0 |
| Khung thời gian 2 | 0 | 0 | 0 | 0 | 0 |
| Khung thời gian 3 | 0 | 0 | 7,936 | 0 | 0 |
| Tiền tố 32k · yêu cầu nóng trúng bộ nhớ đệm 3/9 · đọc 96,000 trên 288,513 token có thể tái sử dụng · 33.27 | — | — | — | — | — |
| Khung thời gian 1 | 0 | 0 | 32,000 | 0 | 0 |
| Khung thời gian 2 | 0 | 0 | 0 | 0 | 0 |
| Khung thời gian 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k và 32k được tính trọng số ngang nhau) | — | — | — | — | 27.58 |
Giá trị là số token bộ nhớ đệm được máy chủ báo cáo; “Không được trả về” nghĩa là trường này không có trong phản hồi.
Các yêu cầu nóng 8k trúng bộ nhớ đệm 2/9 lần, mỗi lần đọc 7,936 token; các yêu cầu nóng 32k trúng 3/9 lần, mỗi lần đọc 32,000 token. Yêu cầu lạnh không đọc bộ nhớ đệm, nên có thể phân biệt rõ yêu cầu nóng và lạnh.
So với năm nhà cung cấp còn lại
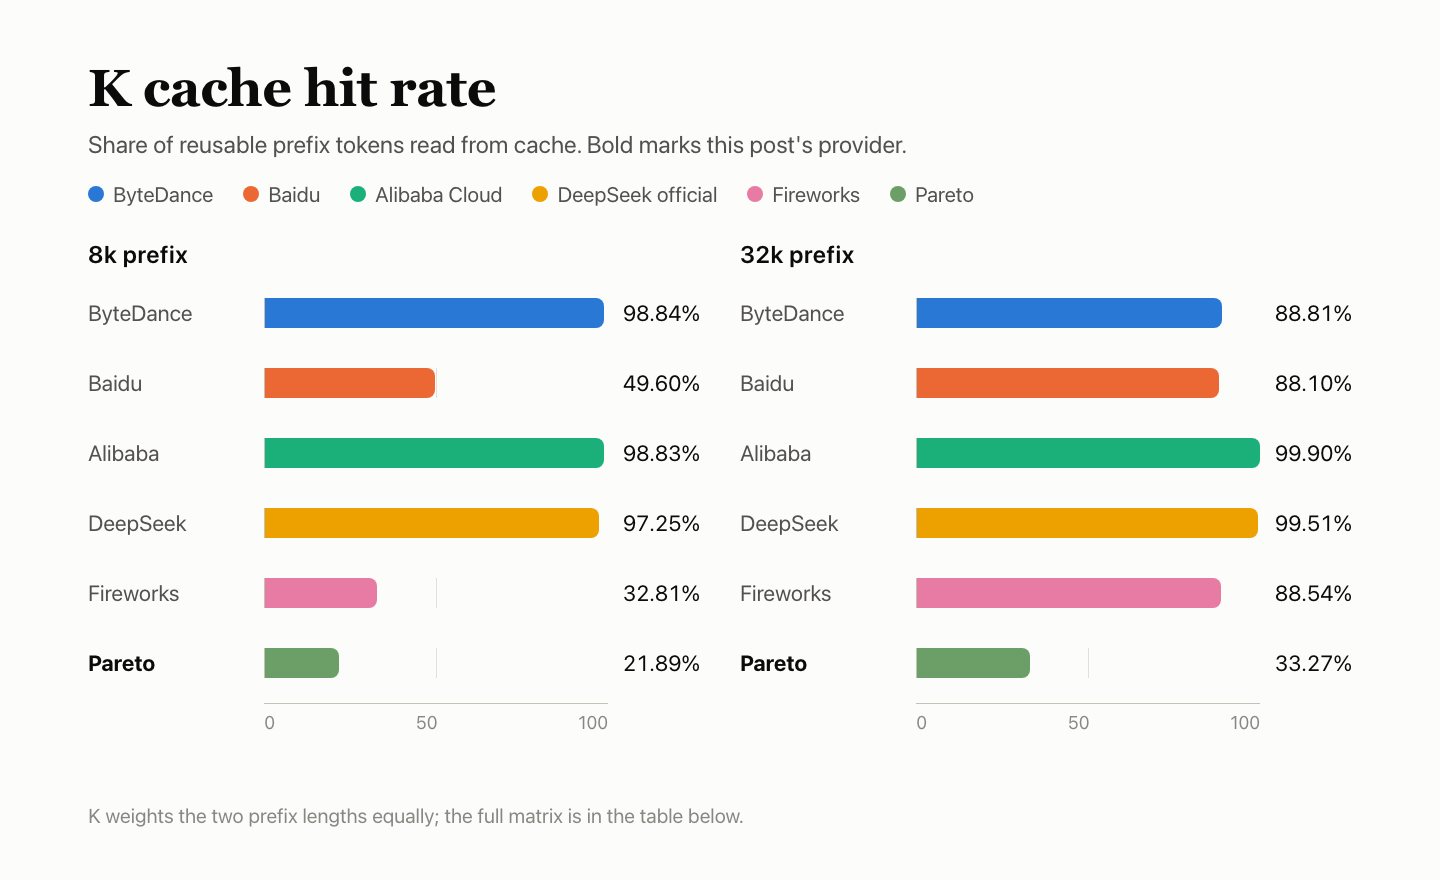
| Nhà cung cấp | Số lần trúng ở 8k | 8k | Số lần trúng ở 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Kênh chính thức của DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (bài viết này) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — độ ổn định dịch vụ: 100
300 yêu cầu thuộc bốn loại: văn bản ngắn, đầu vào dài, gọi công cụ và lịch sử nhiều lượt. Chúng được chạy với mức đồng thời đơn trong ba khung thời gian. Chỉ kiểm tra xem lần thử đầu tiên có trả về phản hồi hợp lệ, đầy đủ hay không; không chấm điểm câu trả lời và không thử lại. Lỗi trong các phần chất lượng câu trả lời và tốc độ được tính vào Q và P, không tính lại vào R.
| Loại yêu cầu | Thành công ở lần thử đầu tiên |
|---|---|
| Văn bản ngắn | 120/120 |
| Đầu vào dài 10k | 90/90 |
| Gọi công cụ | 60/60 |
| Lịch sử nhiều lượt | 30/30 |
| Tổng · khoảng tin cậy 95%: 98.78%–100% | 300/300 |
Cả 300 yêu cầu đều trả về phản hồi hợp lệ, đầy đủ ngay lần thử đầu tiên. R = 100 chỉ mô tả 300 yêu cầu chuyên biệt này; không có nghĩa là toàn bộ chuỗi không gặp lỗi. Cận dưới của khoảng tin cậy 95% là 98.78%: với 300/300 lần thành công, chỉ có thể nói tỷ lệ lỗi có khả năng thấp hơn 1.22%.
So với năm nhà cung cấp còn lại
| Nhà cung cấp | Thành công ở lần thử đầu tiên | Khoảng tin cậy 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Kênh chính thức của DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (bài viết này) | 300/300 | 98.78%–100% |
R chỉ bao gồm 300 yêu cầu chuyên biệt này; lỗi trong các phần chất lượng câu trả lời và tốc độ được ghi nhận trong Q và P, không tính lại vào R.
Câu hỏi thường gặp
Vì sao F là 93.42 khi chỉ tính 33 lượt kiểm tra?
Trong số các lượt kiểm tra được tính ban đầu, 29/33 lượt đạt, cho kết quả F là 93.42 sau khi chuẩn hóa lại trọng số của các nhóm đã quan sát; 147 lượt kiểm tra dự kiến còn lại bị loại khỏi phần chấm điểm. Bản ghi truyền phát mô tả các tính năng cụ thể hoạt động được và không bổ sung lượt kiểm tra nào vào điểm số. Điểm tổng thể hiển thị vẫn là 68.72.
Vì sao P là 57.69 trong khi TPOT được chấm 100.00?
Chỉ 110/180 yêu cầu tốc độ hợp lệ; 70 yêu cầu trả về 200 kèm None. Yêu cầu không hợp lệ được tính là vô hạn, nên trung vị thời gian đến token đầu tiên trong phần thân phản hồi là 5.85 s khi chạy đơn và 6.13 s ở mức đồng thời 10 (lần lượt là 3.08 s và 4.92 s nếu chỉ tính yêu cầu hợp lệ). TTFA được 24.59 điểm và thông lượng được 72.05 điểm, cho điểm phản hồi là 65.22; với K bộ nhớ đệm là 27.58, chiếm 20%, P là 57.69.
Vì sao K chỉ là 27.58?
Các yêu cầu nóng trúng bộ nhớ đệm 2/9 lần ở 8k (21.89) và 3/9 lần ở 32k (33.27), hai độ dài được tính trọng số ngang nhau. Khi trúng bộ nhớ đệm, yêu cầu đọc 7,936 hoặc 32,000 token; không có yêu cầu đối chứng lạnh nào đọc bộ nhớ đệm.
Chất lượng câu trả lời của Pareto có cao hơn kênh chính thức không?
Không thể phân biệt rõ. Độ chính xác tổng hợp là 44.58% so với 42.45%, chênh lệch +2.12 điểm, nhưng khoảng tin cậy 95% nằm trong khoảng −0.02 đến +4.18 và cắt qua 0. deepseek-flash, giám khảo của HLE và AA-LCR, chưa được hiệu chỉnh và có thể chấm dễ dãi.
Những trường hợp F nào không đạt?
Có hai trường hợp. Chuỗi dừng của tính năng truyền phát trả về phần thân phản hồi rỗng trong cả ba khung thời gian, trong khi cùng đầu vào đó hoạt động bình thường khi không có chuỗi dừng. Đầu ra văn bản chính xác có thêm một dấu chấm ở cuối trong một trên ba khung thời gian.
Đọc tiếp: loạt bài DeepSeek V4.1 Flash
- Chênh lệch Q +2.12 của Pareto được đo so với kênh chính thức; lần chạy riêng của kênh chuẩn được đăng trong bài Đánh giá DeepSeek V4.1 Flash trên kênh chính thức của DeepSeek: mốc so sánh cơ sở, 15 yêu cầu không hợp lệ khi chạy đơn.
- Fireworks cũng trả về phần thân phản hồi rỗng với các yêu cầu có chuỗi dừng, và trúng bộ nhớ đệm 3/9 lần ở 8k: Đánh giá DeepSeek V4.1 Flash trên Fireworks: yêu cầu có chuỗi dừng trả về phần thân rỗng, yêu cầu nóng bộ nhớ đệm 8k trúng 3/9 lần.
- Các yêu cầu nóng của Alibaba Cloud trúng bộ nhớ đệm 18/18 lần, so với 5/18 lần của Pareto: Đánh giá DeepSeek V4.1 Flash trên Alibaba Cloud: token đầu tiên trong phần thân phản hồi sau 1.34s, cả 18 yêu cầu nóng đều trúng bộ nhớ đệm, câu trả lời không thể phân biệt với kênh chính thức.
- Tất cả yêu cầu tốc độ của ByteDance đều hợp lệ, với thời gian đến token đầu tiên trong phần thân phản hồi là 2.12 s: Đánh giá DeepSeek V4.1 Flash trên ByteDance: câu trả lời không thể phân biệt với kênh chính thức, số lượng đầu vào không khớp.
- Baidu cũng làm mất nhiều yêu cầu tốc độ do no_available_channel: Đánh giá DeepSeek V4.1 Flash trên Baidu: gọi công cụ ngang tầm kênh chính thức, lỗi no-available-channel thường xuyên làm giảm chất lượng câu trả lời và tốc độ.
Nguồn
- Trang mô hình DeepSeek V4.1 Flash 1017 (AIHubMix)
- Tiêu chuẩn đánh giá nhà cung cấp AIHubMix v2.0 (tài liệu AIHubMix)
- Bắt đầu nhanh (tài liệu AIHubMix)
- Các mô hình (AIHubMix)
- Tài liệu API DeepSeek (DeepSeek)


