AIHubMix експлуатує власну глобальну мережу прискорення для трафіку API. Після оцінки сторонніх провайдерів прискорення, які виявилися недостатньо стабільними та швидкими для промислових AI-навантажень, ми розгорнули власні периферійні вузли, систему моніторингу та планування трафіку. У цьому матеріалі описано виміряні результати та архітектуру, що їх забезпечує.
Виміряні результати
Наведені нижче показники отримано в ході безперервного моніторингу в промисловій експлуатації після ітерацій алгоритму планування.
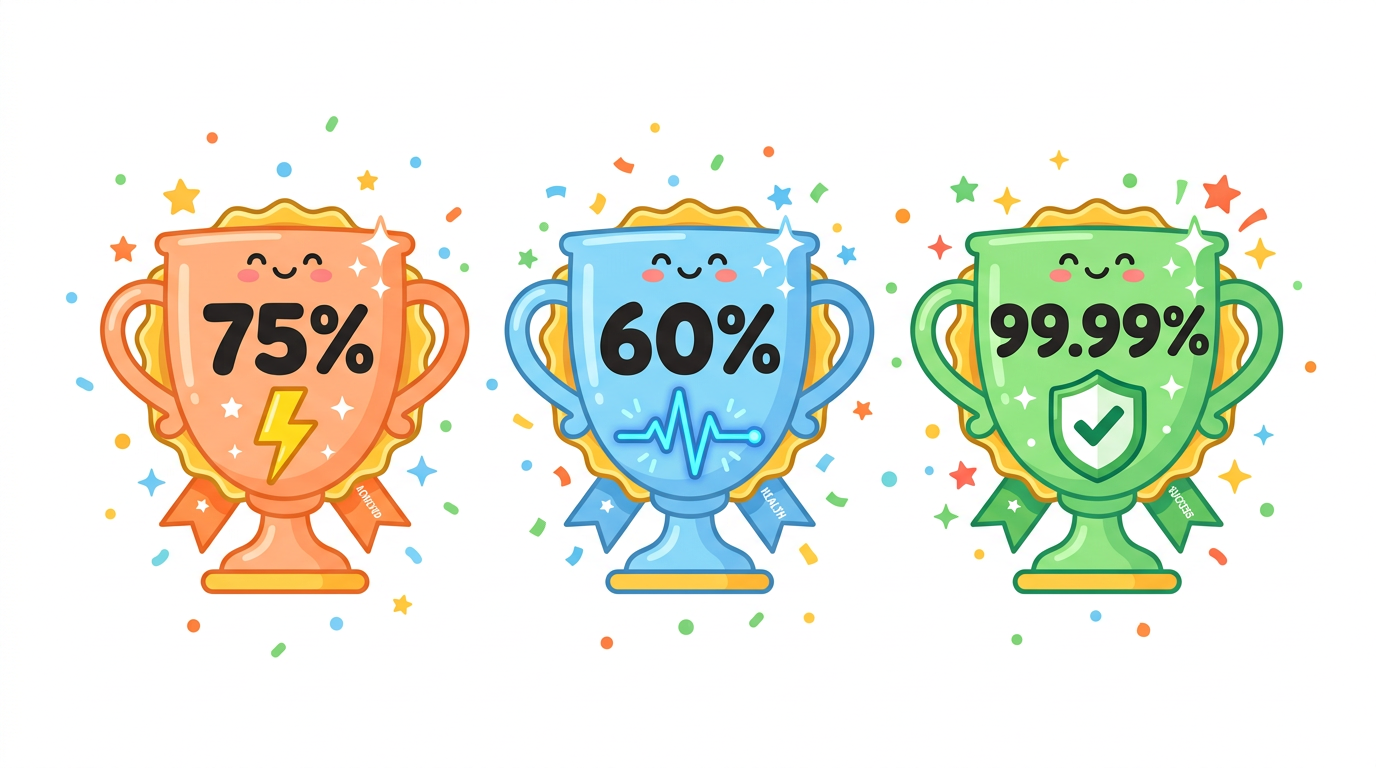
Затримка відповіді зменшена на 75%
Наскрізна затримка API в середньому знизилася на 75%. У потокових сценаріях це насамперед покращує час до першого токена (TTFT), тобто інтервал між надсиланням запиту та отриманням першого вихідного токена, який визначає, наскільки чутливим є чат-застосунок для користувача.
Коливання затримки зменшені на 60%
Дисперсія затримки від запиту до запиту знизилася на 60%. Стабільна затримка важлива для промислових застосунків: вона робить час відповіді для користувачів передбачуваним і зменшує кількість тайм-аутів через затримку на хвості розподілу.
Доступність сервісу на рівні 99.99%
Доступність, виміряна на промисловому трафіку, досягає 99.99%. Це виміряний показник, що охоплює всі години, включно з вихідними та святковими днями.
Архітектура
Власні периферійні вузли
Мережа працює на спеціалізованих вузлах прискорення, розгорнутих у кількох регіонах, незалежно від будь-якого окремого каналу зв'язку чи хмарного провайдера. Кожен вузол перед введенням у експлуатацію проходить тести затримки, втрат пакетів і пікового навантаження; вузли, що не відповідають пороговим значенням, виводяться з пулу. Маршрутизація обирає найшвидший доступний шлях для кожного виклику API.
Моніторинг стану з перевірками щохвилини
Розподілені зонди в кількох регіонах щохвилини виконують наскрізну перевірку стану кожного вузла за трьома показниками: затримка, частка успішних запитів і стабільність. Уся мережа сканується кожні 60 секунд, тож аномалії вузлів виявляються протягом одного циклу перевірки.
Планування трафіку з автоматичним перемиканням при відмовах
Система планування щохвилини перераховує оцінку стану для кожного вузла на основі даних зондів із чотирьох ковзних вікон: 1 хвилина, 5 хвилин, 15 хвилин і 1 година. Трафік спрямовується до вузла з найкращою поточною оцінкою. Коли вузол деградує, перемикання на справний вузол виконується за мілісекунди без втручання людини.
Автоматизовані операції
Керування вузлами, оптимізація маршрутів, розгортання конфігурацій, ротація сертифікатів і відновлення після збоїв автоматизовані. Обробка інцидентів не залежить від часу реагування чергової зміни: деградовані вузли виводяться з ротації системою планування, щойно зонди виявляють аномалію.
Що це означає для вашого застосунку
- Менший і стабільніший TTFT у потокових відповідях.
- Менше помилок тайм-ауту та сплесків затримки на хвості розподілу під навантаженням.
- Без змін в інтеграції: прискорення автоматично застосовується до стандартних кінцевих точок API.
Часті запитання
Чи потрібно змінювати інтеграцію, щоб скористатися мережею прискорення?
Ні. Прискорення застосовується на рівні точки входу платформи. Наявні кінцеві точки API, ключі та формати запитів працюють без змін.
Як часто перевіряється стан вузлів?
Розподілені зонди сканують кожен вузол мережі кожні 60 секунд, наскрізно вимірюючи затримку, частку успішних запитів і стабільність.
Що відбувається, коли вузол деградує?
Система планування щохвилини перераховує оцінки стану на основі чотирьох ковзних вікон (1 хвилина, 5 хвилин, 15 хвилин, 1 година) і автоматично переспрямовує трафік на справні вузли. Перемикання завершується за мілісекунди.
Останнє оновлення: 2026-06-01