Anthropic выпустила Claude Fable 5.2 9 ноября 2026 года. На следующий день Google перевела Gemini 4 Carbon в общую доступность. В собственной таблице бенчмарков запуска Anthropic есть столбец Carbon, поэтому модели можно сравнить на одной и той же задаче программирования с длинным горизонтом.
Обе модели предназначены для одной задачи: агентного программирования с длинным горизонтом. Агент читает репозиторий, редактирует несколько файлов, запускает команды, изучает результаты тестов и продолжает работу без участия человека от 15 до 45 минут. Именно эту задачу оценивают здесь. Чат, автодополнение и короткие скрипты — это другие испытания.
Краткий ответ
Fable 5.2 лидирует в перечисленных бенчмарках на сложных задачах программирования и работает быстрее при одинаковом уровне effort, занимая три верхние позиции AA впереди Carbon High, которая на #4. Carbon показывает более высокие результаты в перечисленных строках Terminal-Bench 4.0 и AutomationBench-AA и обходится дешевле за задачу при High effort, пока не закончится стартовая цена Google 30 ноября. При Medium Fable дешевле и намного быстрее, а Carbon набирает больше баллов в индексе AA.
Выбирайте Fable для сложных задач на рассуждение о коде, Carbon — для выполнения команд в терминале и автоматизации; перед использованием любой из моделей проверьте лимиты на ввод, хранение данных и вывод.
Что показывает единый стенд
Artificial Analysis тестирует все модели на одном и том же стенде и задачах; на страницах Carbon и Fable приведены результаты по отдельным оценкам. Данные взяты из снимка от 11 ноября 2026 года; AA использует стандартные цены из прайс-листов, а не стартовую скидку Google.
| Модель | Индекс AA | $/задачу | Минут/задачу | Первый токен |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Примечание: индекс Intelligence Index и стоимость задачи AA при стандартных ценах, снимок от 2026-11-11T05:23Z. Fable Max, Xhigh и High занимают места с #1 по #3; Carbon High — #4; Opus 5.5 Max — #5; Carbon Medium — #6. «Первый токен» — время до появления первого токена ответа.
При High effort Fable опережает Carbon на 1.79 балла, стоит на 17.0% дороже за задачу ($9.08 против $7.76), справляется за 17.3 минуты вместо 25.6 и выдаёт первый токен за 30.4 секунды вместо 67.1. Задача с Max стоит $26.54 — в 3.4 раза дороже, чем с Carbon High, — а ожидание составляет 233.9 секунды.
При Medium порядок меняется: Fable набирает 56.41 против 58.26 у Carbon, то есть на 1.85 балла меньше, но стоит $3.80 против $6.59 и справляется за 7.8 минуты против 23.3. Более низкая цена токенов Carbon не делает её дешевле за задачу: здесь модель расходует больше токенов.
| Бенчмарк | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Без галлюцинаций, % | 88.58 | 42.02 | 40.73 | 49.66 |
| Точность, % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Примечание: Artificial Analysis, один и тот же стенд и снимок. Показатель отсутствия галлюцинаций — доля ответов в Omniscience без выдуманных утверждений; точность — отдельная оценка. Чем выше значение, тем лучше, во всех строках. Fable Xhigh не включена, чтобы таблицу было проще читать; её результат в FrontierCode 2.0 — 47.58.
Какая модель лидирует в каждом тесте при High effort? В приведённой ниже разнице со знаком из результата Fable вычитается результат Carbon: так направление разницы видно, а в таблице выше указаны абсолютные значения.
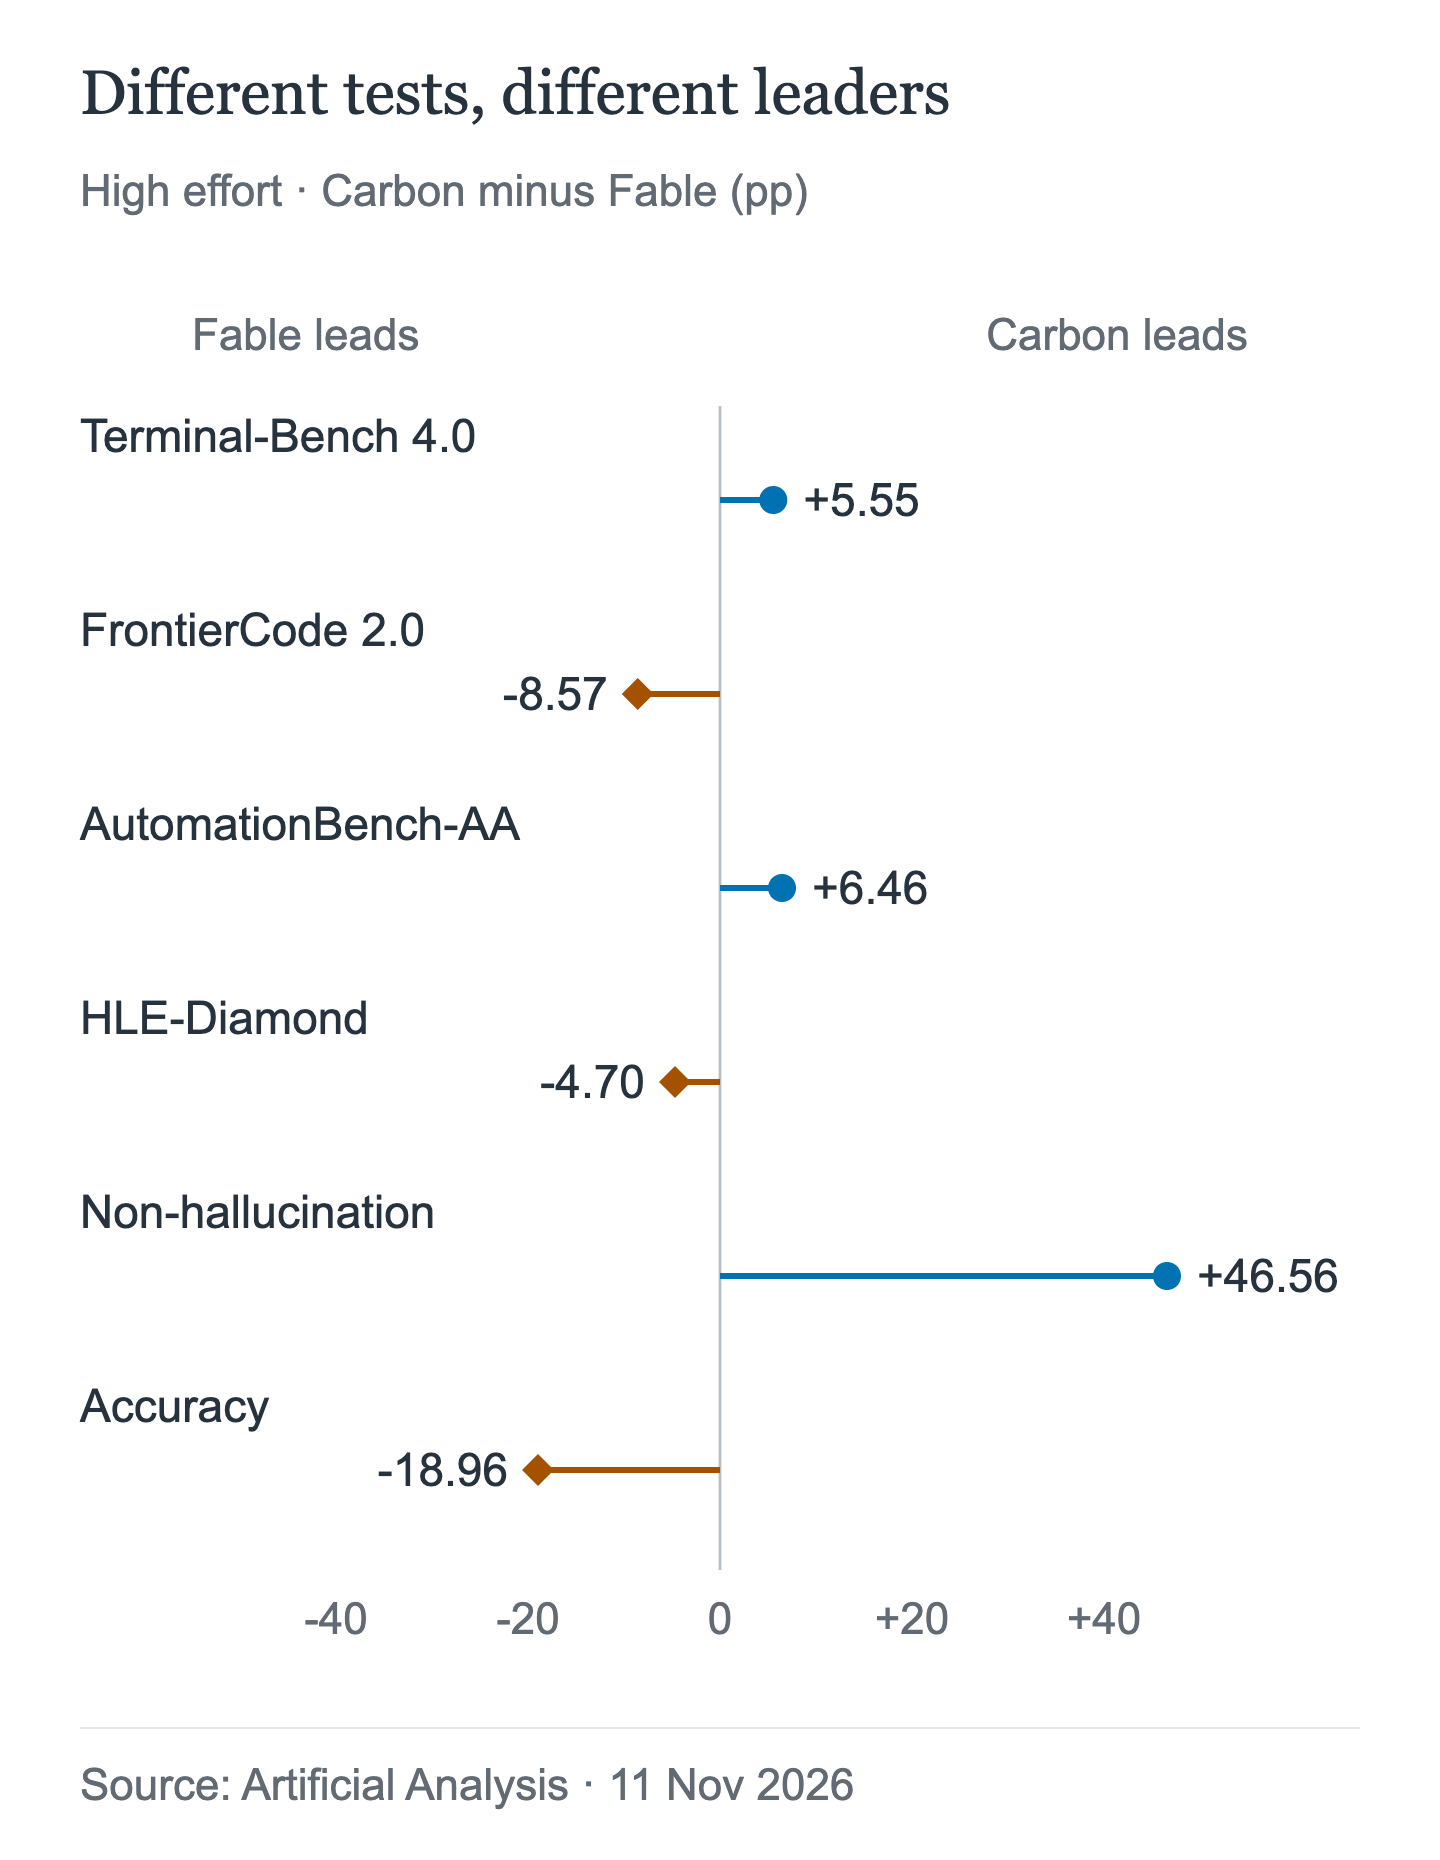
Это разница в процентных пунктах между независимыми тестами, а не сводная оценка качества. Большая разница в одном бенчмарке не означает более значительного общего роста возможностей. В частности, отсутствие галлюцинаций и точность измеряют разные результаты.
Fable опережает Carbon в FrontierCode 2.0 на 8.57 балла при High, а в HLE-Diamond — на 4.7; показатель Briefcase Elo составляет 1677.4 против 1610.6. FrontierCode — наиболее близкий бенчмарк к сложным изменениям кода сразу в нескольких файлах. Carbon опережает Fable в Terminal-Bench 4.0 на 5.55 балла, а в AutomationBench — на 6.46: эти тесты оценивают выполнение команд, восстановление после ошибок и автоматизацию.
Разница в показателе отсутствия галлюцинаций — самая большая в таблице: 88.58% у Carbon против 42.02% у Fable при High. По точности соотношение обратное: 58.27% против 77.23%. Carbon реже выдумывает факты, но и реже даёт правильный ответ. Для агента, который не должен выдумывать API, это может быть преимуществом; для агента, которому нужно ответить правильно, точность Fable — более важный показатель.
Больше effort не всегда лучше: результат Fable Max в FrontierCode — 48.76 — немного ниже, чем у High (49.13), а результат в Terminal-Bench остаётся на уровне 59.6.
Собственная таблица Anthropic
На странице запуска Anthropic опубликована сравнительная таблица моделей разных провайдеров, в которую включена Carbon. Настройки отличаются от AA: Fable тестируется на Xhigh, то есть на самом высоком из указанных уровней effort, а Carbon — на Medium. Сравнивайте результаты только внутри этой таблицы.
| Бенчмарк | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Примечание: данные предоставлены самой Anthropic. Fable тестировалась на Xhigh — самом высоком доступном уровне effort; Carbon — на Medium. Шкала AutomationBench у Anthropic отличается от шкалы AA (51.4/53.9 против 71.36/77.82), поэтому сравнивайте показатели внутри этой таблицы. Результат Carbon 41.1 в FrontierCode получен на Medium; результат AA 40.56 — на High и на другом стенде.
Общая картина совпадает с AA: Fable лидирует в FrontierCode, FrontierSWE, OSWorld и TB-Science; Carbon опережает Fable в AutomationBench на 2.5 балла — меньше, чем на 6.5 у AA, но направление то же. Таблица подтверждает, что «Carbon конкурентоспособна в автоматизации», а не что «Carbon лучше справляется со сложными задачами программирования».
Собственная рекомендация Anthropic ставит под вопрос утверждение «Fable — это обновление»: «Для большинства задач программирования и работы со знаниями мы рекомендуем начать с Claude Opus 5.5». По словам компании, при High effort Fable показывает примерно такой же результат, как лучший показатель Opus 5.5 (45.3% против 45.5%), при этом стоимость задачи примерно вдвое ниже.
Сколько стоят токены
| Модель | Ввод | Вывод | Чтение из кэша |
|---|---|---|---|
| Carbon, до Nov 30 | $2 | $10 | $0.10 |
| Carbon, с Dec 1 | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Примечание: USD за 1M токенов, официальные цены. Запись в кэш для Fable: $10 (5 min) или $16 (1 hour); скидка 50% на Batch. Указанная для Carbon цена кэшированного токена — за чтение; официальная цена чтения из кэша для Opus 5.5 — $0.20.
Цена токенов Fable вдвое выше стандартной цены Carbon и вчетверо выше её стартовой цены. Соотношение простое, а стоимость задачи — нет. По замерам AA, задача с Carbon High при цене $4/$20 стоит $7.76, а с Fable High — $9.08, разница 17.0%. При тарифе Google $2/$10 то же использование будет стоить примерно $3.88 — это расчётная оценка. До 30 ноября задача с Fable High стоит примерно в 2.3 раза дороже; с 1 декабря разница снова составит 17.0%.
При стандартных ценах задача с Fable Medium стоит $3.80 против $6.59 с Carbon — на 42% дешевле, несмотря на двукратную разницу в цене токенов. Carbon тратит больше токенов и работает 23.3 минуты; Fable — 7.8 минуты. При стартовом тарифе задача с Carbon Medium обойдётся примерно в $3.30 по такому же расчёту — почти столько же, сколько с Fable; это преимущество исчезнет 1 декабря.
Задача с Max стоит в 3.4 раза дороже, чем с Carbon High ($26.54), и занимает 45.2 минуты. Более высокие расходы не гарантируют, что агент для программирования будет лучше во всём: результат Max в FrontierCode немного ниже, чем у High.
AIHubMix предлагает Carbon по стартовой цене Google. Указанные здесь цены Fable — официальные тарифы Anthropic.
Различия в поведении, влияющие на выбор для развёртывания
| Параметр | Carbon | Fable 5.2 |
|---|---|---|
| Макс. длина вывода | 65,536; нативный предел ≤1,048,576−input* | 128,000 |
| Контекст | 1,048,576 (нативный для Google) | 1M |
| Thinking | low / medium / high; по умолчанию medium | адаптивный; по умолчанию high |
| Принудительные вызовы инструментов | документирован auto* | any / вызов инструмента возвращает 400 |
| Параметры семплирования | игнорируются; удалите их | некоторые значения возвращают 400 |
| Хранение данных | ограничение не указано | 30 дней; ZDR нет |
| Ввод | текст в AIHubMix | текст, изображение, PDF† |
| Дата отсечения знаний | March 2026 | June 2026 |
Примечание: *Более высокие пределы Carbon доступны в нативном режиме Google при длительной генерации; AIHubMix на данный момент документирует только текстовый ввод и Chat Completions, поддержка со стороны шлюза не подтверждена. †Модальности ввода Fable указаны в каталоге моделей AIHubMix. *В документации AIHubMix указан tool_choice="auto", но поддержка Carbon отдельно не подтверждена. Документированный лимит вывода Fable — 128,000. ZDR — хранение данных с нулевым сроком.
Принудительное использование инструментов — серьёзное препятствие при работе с Fable: «Принудительный вызов инструмента (типы tool_choice any и tool) возвращает ошибку 400». Агент, который должен вызывать определённый инструмент на каждом шаге, не сможет работать с Fable без изменений. В руководстве Google по Carbon рекомендуется последовательное выполнение шагов с вызовами инструментов; в руководстве AIHubMix по Gemini указан tool_choice="auto", но поддержка вызовов инструментов Carbon на шлюзе не подтверждена.
Требования к хранению данных могут стать препятствием для Fable: в её обзоре сказано, что «требуется хранение данных в течение 30 дней; модель недоступна при нулевом сроке хранения, если Anthropic не предоставит специальное разрешение». В рассмотренной здесь документации Carbon подобное ограничение не указано, но это не гарантия его отсутствия. Командам, работающим в регулируемых отраслях, следует подтвердить обе политики до развёртывания.
Стандартный лимит Carbon в 65,536 токенов покрывает большинство правок, но при генерации целых файлов его можно превысить. Фоновый режим Google Native позволяет использовать до 1,048,576 минус входные токены; переходы между сегментами тарифицируются, а запрос может вернуть incomplete с пустым текстом, но всё равно быть платным. В AIHubMix этот режим не документирован. Fable выдаёт до 128,000 токенов в одном ответе.
Отключить thinking не позволяет ни одна из моделей. Carbon предлагает уровни low, medium и high, по умолчанию использует medium и игнорирует параметры семплирования. В Fable «адаптивный thinking всегда включён и его нельзя отключить»; по умолчанию установлен high, а некоторые значения параметров семплирования приводят к ошибке 400.
До общего запуска Google предоставляла Carbon специалистам по защите через программу Fairwind. Классификаторы Fable блокируют запросы на пентесты и эксплуатацию уязвимостей и перенаправляют задачи по кибербезопасности и биологии на другие модели. Для тестирования безопасности поведение при отказе важнее результата в одной строке бенчмарка.
Opus 5.5 как модель для сравнения
Opus 5.5 — не конкурент, а собственная точка отсчёта Anthropic. При цене $4/$20 модель набирает 59.11 в AA, стоит $10.04 за задачу, справляется за 25.0 минуты и выдаёт первый токен через 356.4 секунды — это самое долгое ожидание в таблице (в строке AA указан Max effort; по умолчанию установлен medium). Opus лидирует в Briefcase Elo с результатом 1800.6, но уступает Fable High в FrontierCode, а Carbon High — в Terminal-Bench. Тем не менее Anthropic рекомендует начинать с Opus 5.5 для большинства задач программирования.
Кому что выбрать
Выбирайте Fable 5.2, если основная задача — сложные изменения кода и вам нужны лучшие измеренные результаты в FrontierCode и HLE. При Medium она дешевле и быстрее: $3.80 и 7.8 минуты против $6.59 и 23.3 у Carbon, хотя Carbon набирает больше баллов в индексе AA. Также выбирайте Fable, если нужен ввод изображений, более актуальная дата отсечения знаний — June 2026, а хранение данных в течение 30 дней и отсутствие принудительных вызовов инструментов вас устраивают.
Выбирайте Carbon, если основная нагрузка — работа в терминале: циклы «тест — исправление», автоматизация через shell, многошаговые операции. Он набирает больше баллов в указанных строках Terminal-Bench 4.0 и AutomationBench-AA и обходится дешевле при High effort до November 30. Совместимость с родным для Google контекстом и ограничения на длину вывода через AIHubMix не подтверждены; используйте его только для текста с tool_choice="auto", предварительно подтвердив поддержку инструментов в Carbon. Показатель отсутствия галлюцинаций у него выше, а точность — ниже.
Выбирайте Opus 5.5, если нужен рекомендуемый Anthropic вариант для начала и сбалансированный профиль; будьте готовы к медленному первому токену при Max effort.
Не выбирайте ни одну модель для интерактивных сценариев, чувствительных к задержке: первые токены при High effort появляются через 30.4 секунды у Fable и 67.1 у Carbon, а 23.2 секунды у Carbon Medium всё ещё далеко от скорости чата.
Запустите обе модели через AIHubMix
AIHubMix предоставляет доступ к обеим моделям с одним ключом и через общий эндпоинт chat completions. ID Carbon — gemini-4-carbon; на странице модели описаны chat completions, текстовый ввод и стартовая цена Google. ID Fable 5.2 — claude-fable-5-2; AIHubMix указывает Chat Completions, Responses и Anthropic Messages, контекстное окно 1M и максимальный вывод 128K. У Carbon задокументированы более ограниченные возможности: chat completions, но не родной Gemini API. Шлюз также повторяет запрос через следующего по рейтингу провайдера, поэтому поведение может отличаться от развёртывания у одного провайдера.
Краткое руководство описывает аутентификацию и базовый URL. Проверка может показать, доступны ли обе модели по одному ключу; для этого черновика проверка в реальном времени не проводилась:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Это проверяет маршрутизацию, а не возможности: без инструментов и длинного вывода. Для полноценного сравнения запустите одну и ту же трассу агента с обоими ID и зафиксируйте время выполнения задач, расход токенов и ошибки. На странице сравнения рядом представлены контекст, протоколы и цены.
FAQ
Gemini 4 Carbon лучше Fable 5.2 подходит для агентного программирования?
Ни одна из моделей не выигрывает по всем параметрам. Fable 5.2 лидирует в FrontierCode 2.0 и в общем индексе при High effort; Carbon — в Terminal-Bench 4.0 и AutomationBench. Выбирайте с учётом задач, которые агент будет выполнять на практике.
Почему Fable 5.2 в четыре раза дороже Carbon?
По официальным тарифам Fable стоит $8/$40 за миллион токенов, а стартовая цена Carbon — $2/$10, то есть Fable обходится в четыре раза дороже и за ввод, и за вывод. По сравнению со стандартным тарифом Carbon $4/$20, действующим с December 1, разница двукратная.
Действительно ли Fable 5.2 при Medium обходится дешевле за задачу?
При стандартных ценах — да: $3.80 против $6.59 у Carbon Medium, а время выполнения составляет 7.8 минуты против 23.3. Стартовая цена токенов Carbon сокращает разницу; сравнение по стандартным ценам остаётся актуальным и в дальнейшем.
Можно ли принудительно вызвать инструмент в Fable 5.2?
Нет. Согласно документации Anthropic, значения tool_choice any и tool возвращают ошибку 400. Для агентов, которым необходим принудительный вызов инструмента, нужен другой цикл или другая модель.
Carbon реже галлюцинирует, чем Fable 5.2?
Да, если судить по показателю отсутствия галлюцинаций Omniscience от AA: 88.58% против 42.02% при High. Однако точность у Carbon ниже — 58.27% против 77.23%, поэтому он также реже даёт правильный ответ.
Можно ли запускать обе модели через AIHubMix с одним ключом?
Да. Используйте gemini-4-carbon и claude-fable-5-2 с одним ключом и базовым URL. Для Carbon AIHubMix документирует chat completions, а для Fable — chat completions, Responses и Messages.
Читайте дальше: серия Gemini 4 Carbon
- Прежде чем выбирать конкурента, разберитесь с вопросом о моделях одной линейки: Gemini 4 Carbon против Argon: одинаковая цена — когда Carbon стоит выбрать?
- Если Carbon уже используется в цикле, первые ошибки 400 и тайм-ауты обычно связаны с настройками, а не с моделью: Миграция API Gemini 4 Carbon: ошибки 400, тайм-ауты и ограничения на вывод
Источники
- Gemini 4 Carbon уже доступна — Google, November 10, 2026.
- Claude Fable 5.2 — Anthropic, November 9, 2026.
- Обзор Claude Fable 5.2 — документация Anthropic.
- Gemini 4 Carbon и Claude Fable 5.2 — Artificial Analysis, данные на November 11, 2026.
- Gemini 4 Carbon на AIHubMix — страница модели и цены.