Gemini 4 Carbon — не новое семейство моделей. Это Gemini 4 Argon, который тратит больше ресурсов на thinking в каждом ходе, но продаётся по той же цене за токен: $2 за миллион входных токенов и $10 за миллион выходных токенов по вводным тарифам до November 30, 2026, а с December 1 — $4 и $20. Вопрос не в том, какая модель дешевле за токен: цена у них одинаковая. Вопрос в том, окупается ли дополнительное thinking на каждую выполненную задачу настолько, чтобы оправдать более долгий первый ответ.
Актуальные данные Artificial Analysis дают однозначный ответ для одного типа задач и чёткое предупреждение для другого. Carbon High занимает #4 из 104 в AA Intelligence Index с результатом 60.03 против 50.41 у Argon High. Стоимость задачи — $7.76 против $9.95, а время выполнения — 25.6 минуты против 29.0. Но время до первого токена ответа составляет 67.1 секунды против 40.1 у Argon. Carbon лучше подходит для очереди задач. Argon — для диалога.
В этом и заключается главная мысль статьи. Ниже — что изменилось, о чём говорят измерения, что добавляет карточка модели Google, как изменятся цены December 1 и для каких задач стоит оставить Argon.
Что изменилось по сравнению с Argon
В карточке модели Google связь сформулирована прямо: «Gemini 4 Carbon основана на Gemini 4 Argon». ID модели — gemini-4-carbon, такой же и на AIHubMix. Google указывает контекстное окно на 1,048,576 токенов. Уровни thinking — low, medium и high; по умолчанию используется medium. Стандартный лимит вывода — 65,536 токенов; собственный режим Google для длинной генерации может выдавать до 1,048,576 токенов за вычетом входных, в качестве примеров указаны 131,072 и 262,144. В документации AIHubMix сейчас указан только Chat Completions, поэтому не задавайте в запросах через шлюз значение выше 65,536, пока не будет документирован режим с большим лимитом. Дата отсечения знаний — March 2026. Google не предлагает эту модель на бесплатном тарифе.
Изменение описано в примечаниях Google к AI Studio: «Carbon тратит больше токенов на thinking в каждом ходе, чтобы тщательно исследовать задачу и проверять результат. Поэтому расход токенов и задержка на ход у неё выше, чем у Argon». Эта фраза объясняет почти все различия, о которых пойдёт речь дальше. Дополнительное thinking повышает планку на сложных задачах, увеличивает счёт за каждый ход и заставляет дольше ждать первый токен.
Миграция предельно проста. «Для перехода с Argon не требуется менять схему запросов». На уровне API достаточно заменить строку с названием модели. Практическая рекомендация Google: «Оставьте thinking_level на medium (по умолчанию), если для задачи не нужен high, и убедитесь, что max_output_tokens и тайм-ауты HTTP допускают более длительные этапы рассуждений».
Компромисс по результатам измерений: больше thinking, ниже стоимость задачи
Приведённые ниже данные — это актуальные измерения Artificial Analysis, полученные 2026-11-11T05:23Z (страницы моделей повторно проверены в 06:01Z, без изменений), по стандартным тарифам: $4 за миллион входных токенов и $20 за миллион выходных токенов.
Полезнее всего сравнивать качество со стоимостью выполненной задачи: повышает ли Carbon индекс при меньшем счёте? На графике показаны все четыре конфигурации моделей по отдельности.
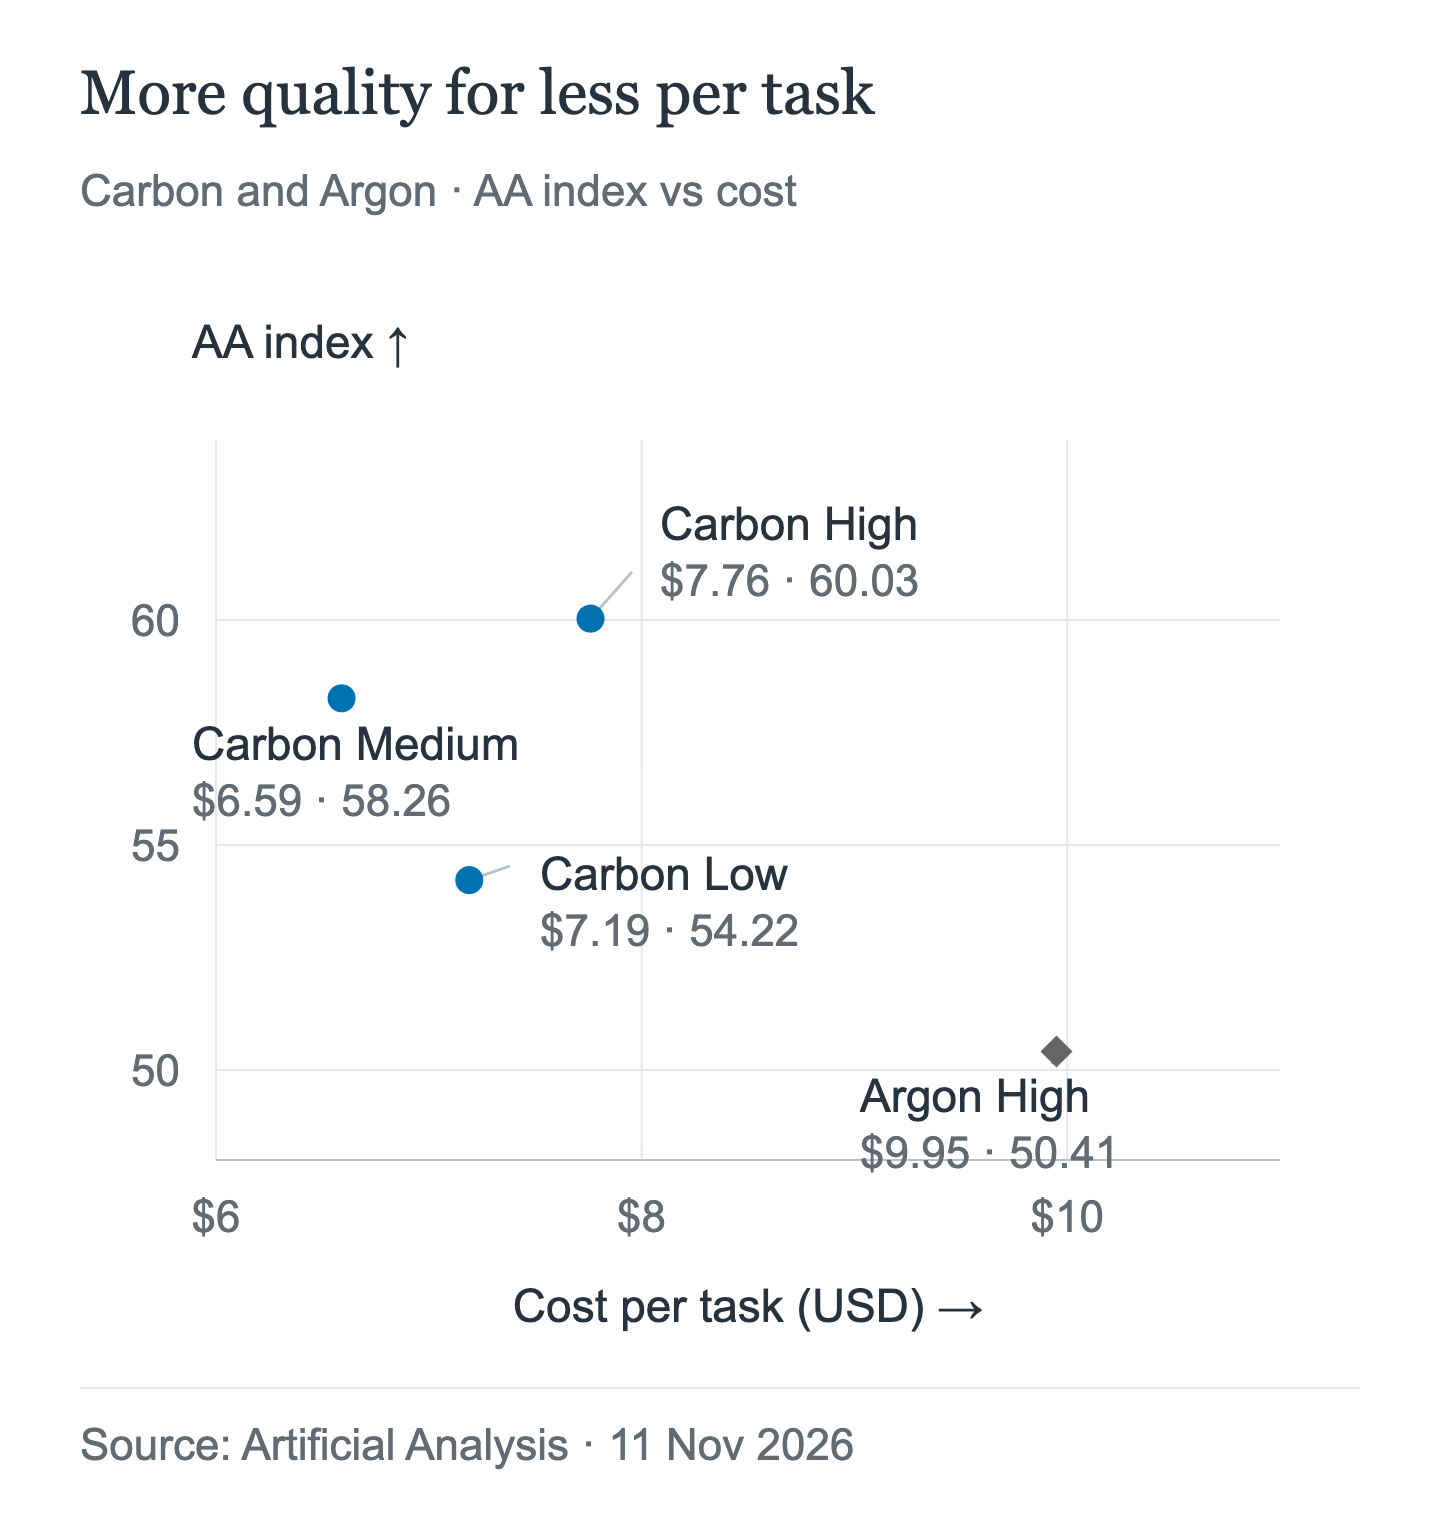
Carbon High расположена выше и левее Argon High. В этом запуске Carbon Medium — самая дешёвая настройка Carbon; Low — вариант с меньшей задержкой, а не с минимальной стоимостью. Это стоимость задач AA по стандартным ценам, а не счета за запросы AIHubMix.
| Модель | Индекс AA | $/задачу | Мин./задачу | Первый токен | Выход, токенов/с |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium и Low занимают соответственно #4, #6 и #14 из 104; Argon High находится ниже них. Все три модели выше Carbon High — конфигурации Claude Fable 5.2. «Первый токен» — это время до первого токена ответа. По сравнению с Argon High, у Carbon High индекс выше на 9.62 пункта, стоимость задачи ниже на 22.0%, а время выполнения составляет 25.6 минуты против 29.0, но первый токен ответа появляется через 67.1 секунды против 40.1.
Разрыв в индексе достаточно велик, чтобы повлиять на место в рейтинге. Разница в задержке достаточно велика, чтобы повлиять на готовность человека ждать. Оба утверждения следуют из одной и той же строки.
Artificial Analysis называет Carbon «заметно медленной на задачу и очень многословной» и сообщает, что для расчёта индекса она сгенерировала 205 million токенов, против 113 million у Argon и медианы 72.8 million среди измеренных моделей. В этом запуске AA более высокая стоимость вывода сочетается с намного большим объёмом генерации: цена за токен та же, токенов гораздо больше, а совокупная стоимость задач ниже.
Стоит отдельно отметить одну аномалию. Carbon Low стоит $7.19 за задачу — дороже Medium за $6.59, несмотря на меньший объём thinking. Какова бы ни была причина, Low работает скорее как настройка для снижения задержки, а не стоимости, поэтому перед тем, как направлять на неё большой поток задач, измерьте стоимость каждой задачи.
Взгляд через призму агента для программирования
Intelligence Index усредняет результаты множества задач. Coding Agent Index v2 ближе к типичному сценарию клиента API: агент для программирования с инструментами, тестируемый от начала до конца на одном и том же стенде. Carbon High занимает #4, Argon High — #11.
| Место | Агент + модель | Индекс | $/задачу | Мин./задачу | Попадания в кэш |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Агент и тестовый стенд одинаковы, различается только модель, поэтому сравнение изолирует именно её, а не инфраструктуру. Стоимость задачи у Carbon ниже на 34.0%, индекс выше на 6.2 пункта, выполнение быстрее на 4.9 минуты, а объём вывода почти одинаков: 109,031 токенов против 109,236. Доля попаданий в кэш выше — 0.95 против 0.87, а расход входных токенов ниже: 12.44 million против 13.76 million.
Есть два важных уточнения. Carbon занимает в этом индексе #4: лидирует Claude Code с Opus 5.5 Max с результатом 61.7, за ним следуют Devin Fusion CLI и GitHub Copilot Fusion. А Fable 5.2 в индексе вообще отсутствует, поэтому эта таблица не позволяет сделать вывод о сравнении Carbon и Fable.
Что добавляет карточка модели Google — и чего она не показывает
Карточка модели Google — это документ поставщика: результаты по состоянию на October 2026, предоставленные самой компанией и относящиеся к другому срезу данных, чем приведённые выше актуальные измерения. Во всех строках ниже результат Carbon выше.
| Бенчмарк | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (данные поставщика) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
В строке AA указано округлённое значение Google — 59, а не 60.03 из предыдущей таблицы. Эти цифры получены в разных срезах данных, их не следует смешивать. Во внешнем сравнении в карточке фигурирует Fable 5.1, а не Fable 5.2.
Полезно то, что результат стабилен: прирост наблюдается не на одном бенчмарке. Но видны и ограничения. Карточка поставщика не сообщает стоимость задачи, не измеряет задержку до первого токена и не показывает, сколько ходов потребуется вашему агенту. Она подтверждает, что «в среднем Carbon — более сильная модель». Но не подтверждает, что «Carbon лучше подойдёт для вашего цикла работы».
Цена: одинаковые тарифы и одинаковое изменение December 1
Тарифы Carbon и Argon совпадают во всех пунктах. Для обеих моделей действуют вводные цены до November 30, 2026, а December 1 они удваиваются.
| Модель | Ввод | Вывод | Чтение из кэша |
|---|---|---|---|
| Carbon, вводный тариф (до Nov 30) | $2.00 | $10.00 | $0.10 |
| Carbon, с Dec 1 | $4.00 | $20.00 | $0.20 |
| Argon, вводный тариф (до Nov 30) | $2.00 | $10.00 | $0.10 |
| Argon, с Dec 1 | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Официальные цены в USD за миллион токенов по состоянию на November 11, 2026. Для Gemini 3.1 Pro Preview при объёме промпта свыше 200k цена составляет $4/$18/$0.40, плюс $4.50 за миллион токенов в час хранения. Запись в кэш для Fable 5.2 стоит $10 на пять минут или $16 на один час; пакетная обработка — со скидкой 50%. Вводные тарифы Carbon и Argon заканчиваются November 30; December 1 все тарифы Carbon и Argon удваиваются.
AIHubMix указывает для Carbon тариф $2/$10/$0.10, соответствующий вводным тарифам Google. В этой статье мы не предполагаем, какие цены шлюз будет брать после November 30: уточните текущую стоимость на странице модели.
Если пересчитать измеренное Artificial Analysis количество токенов по вводным тарифам, примерная стоимость задачи составит $3.88 для Carbon High, $3.30 для Medium, $3.60 для Low и $4.98 для Argon High. Это расчётные оценки, а не измерения AA: в расчёте предполагается, что соотношение типов токенов для каждой задачи не меняется, а результат у вас будет зависеть от промптов и доли попаданий в кэш.
При стандартных тарифах Fable 5.2 стоит за токен вдвое дороже Carbon, а по вводным тарифам — вчетверо. Это разница в цене, а не оценка качества; сравнению посвящена третья статья серии.
В каких случаях Carbon не лучше
Аргумент против Carbon не в том, что она хуже. Дело в том, что её главное преимущество — больше thinking на ход — нельзя позволить себе в интерактивном продукте.
Первый токен приходит с задержкой. Carbon High ждёт 67.1 секунды до первого токена ответа, Argon High — 40.1. Для Medium ожидание сокращается до 23.2 секунды, для Low — до 12.9, но обе уступают по индексу. Чат-интерфейс, который заставляет ждать целую минуту, уже теряет пользователя, каким бы хорошим ни оказался ответ, когда наконец появится.
Google советует оставить Argon ради скорости. Argon позиционируется как модель для «более быстрых ответов и меньшего расхода токенов на ход» в сценариях «интерактивной разработки, повседневной работы над функциями и быстрых производственных циклов». В примечаниях к миграции рекомендация предельно ясна: «Оставьте Argon там, где важна скорость». В публикации с анонсом Google повторяет эту мысль: «Argon остаётся оптимальным выбором для большинства задач разработки ПО и интеллектуальной работы».
Расход на ход выше, даже если стоимость задачи ниже. Цена за токен одинакова, но Carbon расходует больше токенов на thinking в каждом ходе. Если команда следит за расходом токенов на ход или ограничивает квоту токенов, Carbon будет восприниматься как более дорогая модель. Запуск индекса на 205 million токенов против 113 million у Argon — крайнее проявление этого эффекта.
Low — не экономичный вариант. При стоимости $7.19 за задачу Carbon Low обходится дороже Medium за $6.59. Если маршрутизация основывается на стоимости выполненной задачи, Low не подходит.
Победы в бенчмарках не компенсируют ожидание. В таблице Google OSWorld-2.1 и FrontierSWE 2 показывают преимущество Carbon, но эти результаты предоставлены самим поставщиком, и ни один из них не сокращает ожидание первого токена. Бенчмарки измеряют конечный результат; пользователи ощущают начало.
Кому стоит перейти сейчас, а кому остаться на Argon
Перейдите на Carbon уже сейчас, если используете пакетную обработку или фоновые задачи агентов через нативные сервисы провайдера (на AIHubMix эти сценарии для Carbon не задокументированы), если ошибка качества обходится дороже, чем время выполнения, если ваши запросы допускают более длительное ожидание и больший бюджет вывода или если вы уже тратите деньги на повторные попытки, которых Carbon мог бы избежать.
Оставайтесь на Argon, если создаёте чат, автодополнение или любой цикл, в котором человек ждёт ответа; если бюджет или квота рассчитываются на один ход; или если для продукта важно укладываться в задержку менее примерно 30 секунд.
Сначала протестируйте, если ваш случай находится где-то посередине. Отправьте через обе модели от 20 до 50 реальных запросов, зафиксируйте время до первого токена и стоимость выполненной задачи, а затем выбирайте модель по этим показателям, а не по позиции в рейтинге. На странице сравнения AIHubMix страницы обеих моделей расположены рядом.
Как вызывать модель через AIHubMix
Для Carbon на AIHubMix используется та же схема ID модели и задокументированный эндпоинт chat completions.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Эндпоинт — POST /v1/chat/completions; это единственный маршрут, который AIHubMix документирует для этой модели. В качестве входных данных указан текст. Ввод изображений и PDF, Responses API, Anthropic Messages и нативный эндпоинт Gemini для Carbon на AIHubMix не задокументированы, поэтому считайте их неподтверждёнными. То же относится к поддержке reasoning_effort: не предполагайте, что шлюз передаёт параметр уровня thinking. Значение max_tokens должно укладываться в стандартный лимит вывода 65,536; более высокие лимиты требуют фонового режима Google, и их поддержка на AIHubMix не подтверждена. Для этой статьи не проводилось тестирование в реальном времени, поэтому пример показывает формат запроса, а не проверенный ответ.
Часто задаваемые вопросы
Carbon стоит столько же, сколько Argon?
Да. Официальные тарифы Google одинаковы: $2 за миллион входных токенов и $10 за миллион выходных токенов до November 30, 2026, затем — $4 и $20. Чтение из кэша стоит $0.10, а затем — $0.20.
Carbon лучше Argon?
По качеству и стоимости выполненной задачи — да, согласно измерениям Artificial Analysis: 60.03 против 50.41 по Intelligence Index и $7.76 против $9.95 за задачу. По скорости ответа — нет: первый токен ответа появляется через 67.1 секунды против 40.1.
Почему Carbon медленнее, если быстрее выполняет задачи?
Он дольше ждёт, прежде чем ответить, но затем быстрее завершает задачу целиком: за 25.6 минуты против 29.0. Ожидание первого токена и общее время выполнения задачи — разные показатели, и они дают противоположные результаты.
Нужно ли менять запросы?
Нет. Google сообщает, что для перехода с Argon не требуется менять схему; достаточно заменить строку модели на gemini-4-carbon. Увеличьте лимит вывода и HTTP-таймаут, чтобы учесть более длительное обдумывание.
Почему Carbon Low обходится дороже за задачу, чем Medium?
По измерениям Artificial Analysis, стоимость Low составила $7.19, а Medium — $6.59. Рассматривайте Low как настройку задержки, а не как способ сэкономить, и измерьте стоимость одной задачи, прежде чем направлять на него большой поток запросов.
Какое место Carbon занимает в рейтинге Artificial Analysis?
Он занимает #4 в Intelligence Index, уступая трём конфигурациям Claude Fable 5.2. В карточке модели Google для того же индекса указано округлённое значение 59; актуальный показатель — 60.03, и эти цифры не следует смешивать.
Доступен ли Carbon на бесплатном тарифе?
Нет. Google не предлагает Gemini 4 Carbon на бесплатном тарифе, поэтому доступ к нему предоставляется по платным тарифам API или через шлюз, например AIHubMix.
Читайте дальше: серия материалов о Gemini 4 Carbon
- Если эта статья убедила вас попробовать Carbon, но первый запрос завершился ошибкой, в руководстве по миграции описаны ошибки 400, настройки тайм-аутов и лимиты вывода, которые меняются при более длительных циклах обдумывания: Миграция API Gemini 4 Carbon: ошибки 400, тайм-ауты и лимиты вывода.
- Если вы хотите понять, достаточно ли Carbon для агентного программирования или даёт ли премиальная цена Fable 5.2 какие-либо преимущества, в третьей статье те же измеренные показатели сопоставляются с Fable 5.2: Gemini 4 Carbon против Fable 5.2: что выбрать для агентного программирования?.
Источники
- Google AI Studio, Gemini 4 Carbon: что нового
- Google DeepMind, карточка модели Gemini 4 Carbon
- Google AI Studio, тарифы Gemini API
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon