A AIHubMix opera uma rede global de aceleração própria para o tráfego de API. Após avaliar provedores terceirizados de aceleração e constatar que sua latência e estabilidade eram insuficientes para cargas de trabalho de IA em produção, implantamos nossos próprios nós de borda, sistema de monitoramento e escalonamento de tráfego. Este post descreve os resultados medidos e a arquitetura por trás deles.
Resultados medidos
Os números a seguir vêm do monitoramento contínuo em produção, após a iteração do algoritmo de escalonamento.
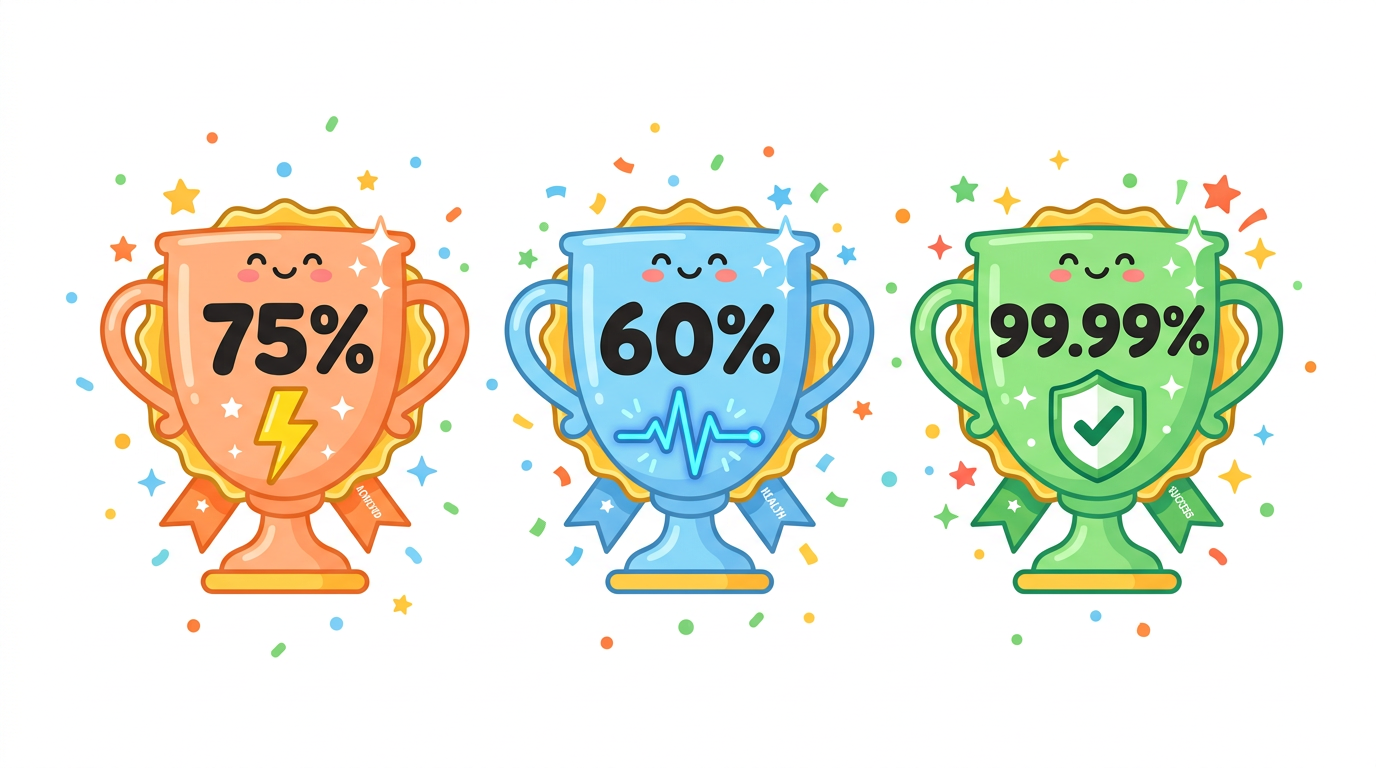
Latência de resposta reduzida em 75%
A latência de ponta a ponta das APIs caiu 75% em média. Em cenários de streaming, isso melhora principalmente o tempo até o primeiro token (TTFT), intervalo entre o envio da requisição e o recebimento do primeiro token de saída, que determina a sensação de responsividade de um aplicativo de chat.
Flutuação de latência reduzida em 60%
A variância de latência entre requisições caiu 60%. A consistência da latência é importante para aplicações em produção: ela mantém os tempos de resposta percebidos pelo usuário previsíveis e reduz os timeouts causados por latência de cauda.
Disponibilidade do serviço em 99,99%
A disponibilidade medida sobre o tráfego de produção chega a 99,99%. Trata-se de um dado medido que abrange todas as horas, incluindo fins de semana e feriados.
Arquitetura
Nós de borda próprios
A rede roda em nós de aceleração dedicados, implantados em múltiplas regiões e independentes de qualquer linha ou provedor de nuvem específico. Cada nó passa por testes de referência de latência, perda de pacotes e carga máxima antes de entrar em produção; nós que não atingem os limites são removidos do pool. O roteamento seleciona o caminho mais rápido disponível para cada chamada de API.
Monitoramento de saúde com sondagens em nível de minuto
Sondas distribuídas em múltiplas regiões executam uma verificação de saúde de ponta a ponta em cada nó a cada minuto, cobrindo três dimensões: latência, taxa de sucesso e estabilidade. A rede inteira é varrida a cada 60 segundos, de modo que anomalias nos nós são detectadas dentro de um ciclo de sondagem.
Escalonamento de tráfego com failover automático
O sistema de escalonamento recalcula uma pontuação de saúde para cada nó a cada minuto, com base nos dados das sondas em quatro janelas deslizantes: 1 minuto, 5 minutos, 15 minutos e 1 hora. O tráfego é roteado para o nó com a melhor pontuação atual. Quando um nó se degrada, a transferição para um nó saudável é concluída em milissegundos, sem intervenção humana.
Operações automatizadas
Gerenciamento de nós, otimização de rotas, implantação de configurações, rotação de certificados e recuperação de falhas são todos automatizados. O tratamento de incidentes não depende do tempo de resposta de plantão: nós degradados são retirados da rotação pelo sistema de escalonamento assim que as sondas detectam a anomalia.
O que isso significa para sua aplicação
- TTFT menor e mais consistente em respostas de streaming.
- Menos erros de timeout e picos de latência de cauda sob carga.
- Sem alterações na integração: a aceleração se aplica automaticamente aos endpoints padrão da API.
FAQ
Preciso alterar minha integração para me beneficiar da rede de aceleração?
Não. A aceleração se aplica na camada de entrada da plataforma. Endpoints de API, chaves e formatos de requisição existentes funcionam sem alterações.
Com que frequência a saúde dos nós é verificada?
Sondas distribuídas varrem cada nó da rede a cada 60 segundos, medindo latência, taxa de sucesso e estabilidade de ponta a ponta.
O que acontece quando um nó se degrada?
O sistema de escalonamento recalcula as pontuações de saúde a cada minuto a partir de quatro janelas deslizantes (1 minuto, 5 minutos, 15 minutos, 1 hora) e transfere automaticamente o tráfego para os nós saudáveis. O failover é concluído em milissegundos.
Última atualização: 2026-06-01