Conectar um LLM basta para que uma aplicação gere texto. Não basta para que um agente de IA conclua uma tarefa do mundo real.
Peça a um modelo para resumir um documento que já está em seu contexto, e a camada de modelo é suficiente. Peça para comparar preços atuais de concorrentes, enriquecer o registro de uma empresa, verificar uma conta em rede social ou escolher a melhor API para uma tarefa desconhecida, e a metade que falta fica óbvia: o agente precisa de uma forma confiável de acessar sistemas externos.
Um agente de produção, portanto, toma duas decisões separadas:
- Qual modelo deve processar esta etapa?
- Qual ferramenta ou API deve fornecer os dados ou a ação?
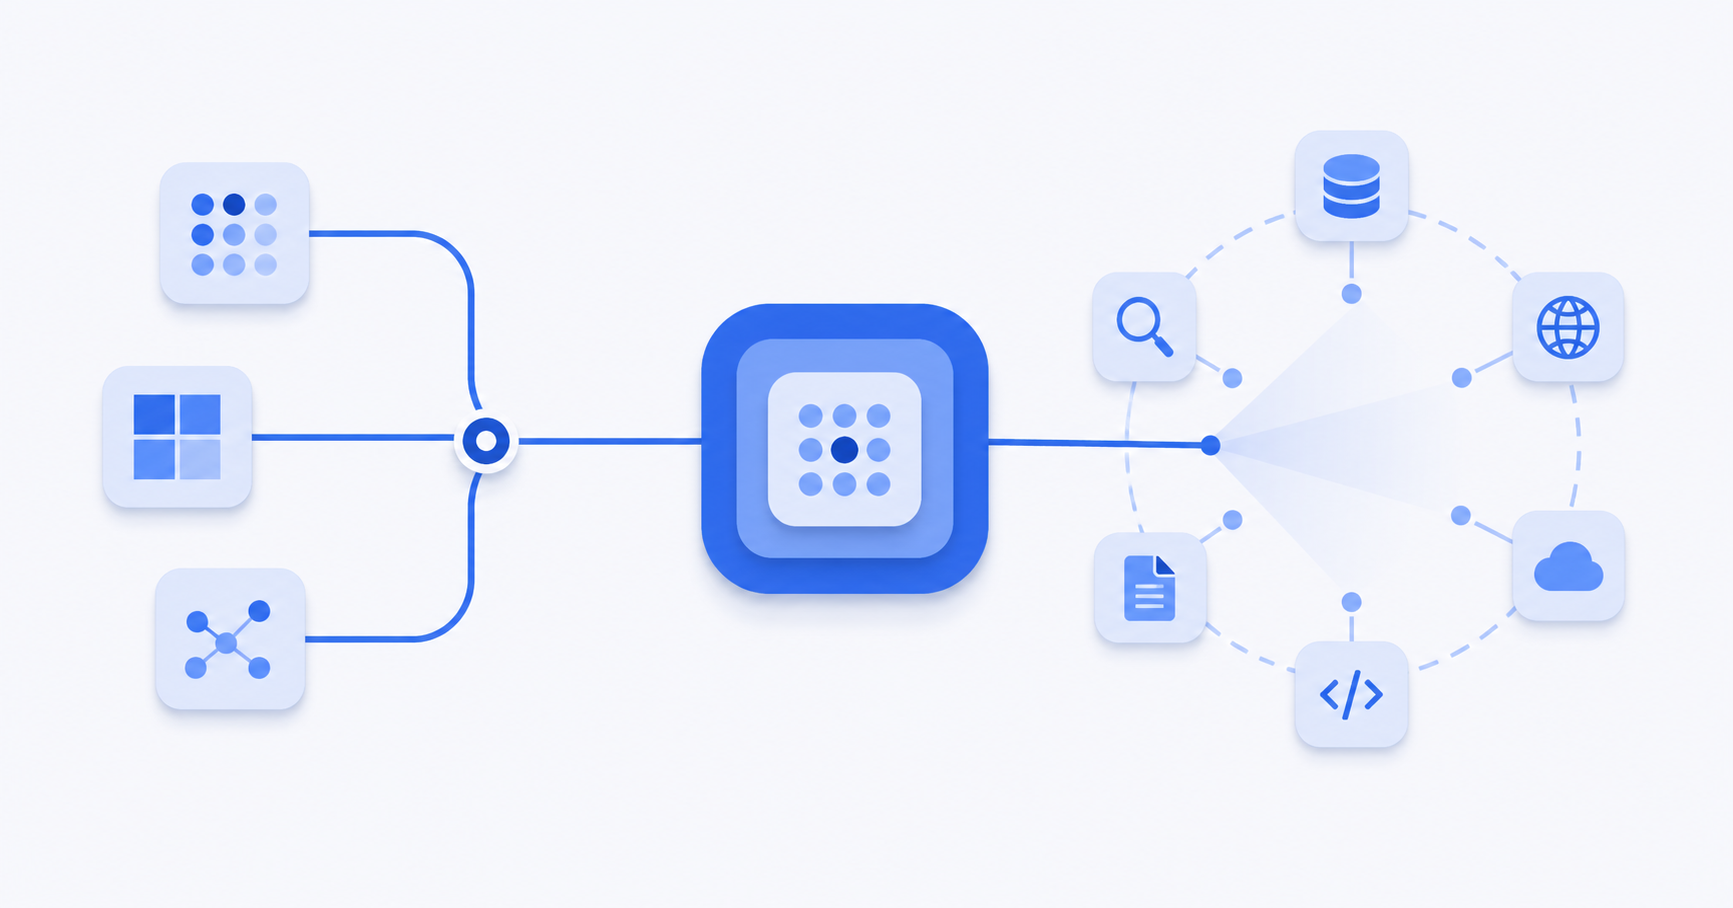
O AIHubMix trata da primeira decisão com acesso unificado a modelos e roteamento de modelos no momento da requisição. O Monid trata da segunda com descoberta de ferramentas em tempo de execução, inspeção de schema e execução paga por chamada. Os produtos ficam em camadas diferentes da mesma arquitetura.
Divulgação: Este artigo foi criado como parte de uma colaboração de conteúdo com o Monid. O AIHubMix é a plataforma de modelos discutida abaixo; o Monid é a plataforma de ferramentas. Cada um pode ser usado de forma independente.
Os dois problemas de roteamento dentro de um agente de IA
A execução de um agente raramente é uma única chamada homogênea a um modelo. Um agente de pesquisa pode classificar uma solicitação, buscar informações atuais, extrair fatos estruturados, comparar resultados e redigir uma resposta final. Essas etapas exigem capacidades diferentes.
O mesmo vale fora do modelo. Uma tarefa de pesquisa sobre empresas pode precisar de uma API de busca hoje, de um endpoint de enriquecimento de empresas amanhã e de uma ferramenta de automação de navegador na semana seguinte. Se cada modelo e ferramenta forem fixados no momento do build, cada nova tarefa vira um projeto de integração.
As duas camadas são paralelas:
| Camada de modelo | Camada de ferramentas | |
|---|---|---|
| Decisão central | Qual modelo deve responder? | Qual API deve ser chamada? |
| Momento da seleção | Por requisição | Por tarefa, em tempo de execução |
| Entrada | Prompt, modalidade, necessidades de qualidade e latência | Objetivo, dados ou ação necessários, schema e preço |
| Saída | Uma completação do modelo | Dados externos ou uma ação executada |
| Exemplo | AIHubMix | Monid |
Essa separação importa. Um modelo melhor não cria acesso a dados em tempo real, e um catálogo maior de ferramentas não consegue raciocinar sobre os dados que retorna. O agente precisa das duas capacidades, com um contrato claro entre elas.
O Monid apresenta a visão complementar, do lado das ferramentas, em Por que um Agente de IA Precisa de Duas Integrações. Do lado do modelo, a lição arquitetural é a mesma: manter a seleção de modelo e a seleção de ferramenta independentes e, então, otimizar cada camada para a sua função.
Por que um modelo fixo fica caro em um loop de agente
Usar um único modelo em todos os lugares parece simples. Na prática, isso obriga cada etapa a aceitar o mesmo compromisso entre capacidade, latência e preço.
Considere um agente de pesquisa de mercado:
- A classificação de intenção é curta e mecânica.
- A seleção de ferramentas exige seguimento confiável de instruções.
- Extrair campos de um JSON retornado é, sobretudo, transformação.
- O relatório final pode exigir raciocínio mais forte e redação melhor.
Enviar as quatro etapas para o modelo mais capaz desperdiça dinheiro em trabalho rotineiro. Enviar as quatro para o modelo mais barato pode reduzir a qualidade da única saída que o usuário lê. À medida que o loop do agente cresce, esse compromisso se repete em cada chamada.
O AIHubMix oferece um endpoint compatível com a OpenAI sobre um amplo catálogo de modelos. Uma integração existente com o SDK da OpenAI pode apontar para o AIHubMix alterando a chave de API e o base_url:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Definir model como auto move a seleção de modelo para o caminho da requisição. O roteador analisa a tarefa e resolve um modelo adequado. Um sufixo de política torna explícito o objetivo da otimização:
| Valor do roteador | Prioridade | Etapa típica do agente |
|---|---|---|
auto |
Custo primeiro | Trabalho em lote e transformações rotineiras |
auto:balanced |
Capacidade, custo e latência | Trabalho de agente de uso geral |
auto:quality_first |
Capacidade primeiro | Raciocínio complexo e entregas finais |
auto:latency_critical |
Velocidade primeiro | Loops interativos e planejamento leve |
O roteamento não gera uma taxa separada. A requisição é cobrada pelo preço de tabela do modelo que de fato a processou. O modelo resolvido e os detalhes do roteamento são expostos na resposta, incluindo o cabeçalho X-Aihubmix-Router-Resolved-Model, de modo que a decisão continua observável e não se torna uma caixa-preta.
O comportamento completo, os endpoints suportados, as políticas e as limitações atuais estão documentados no guia do roteador de LLM do AIHubMix.
O roteamento de modelos não dá dados em tempo real ao agente
Depois de configurado o roteamento de modelos, o agente pode escolher um cérebro melhor para cada etapa. Ele continua sem conseguir saber o que mudou depois dos dados de treinamento do modelo, sem acessar um sistema empresarial privado ou executar uma ação em outro aplicativo, a menos que uma ferramenta forneça essa capacidade.
É aqui que muitos projetos de agentes acumulam código frágil. Uma equipe conecta uma API de busca, depois uma API de scraping e depois uma API de enriquecimento. Cada integração introduz mais uma conta, credencial, formato de requisição, modelo de erros e relação de cobrança. As descrições das ferramentas costumam ser copiadas para um prompt de sistema e, aos poucos, ficam desatualizadas.
O modo de falha é perigoso porque pode parecer bem-sucedido. Um modelo pode produzir uma chamada plausível contra um schema desatualizado, receber uma resposta incompleta e seguir adiante como se a tarefa tivesse dado certo. A inspeção de schema em tempo de execução é mais segura do que pedir ao modelo que lembre de um contrato de API a partir do treinamento ou de um prompt antigo.
A camada de ferramentas deve, portanto, responder a três perguntas antes da execução:
- Qual ferramenta pode atender a este objetivo?
- Qual schema e qual preço valem agora?
- Qual resultado a chamada realmente retornou?
A descoberta de ferramentas é a segunda camada de roteamento
O Monid transforma o acesso a ferramentas em um fluxo de descobrir, inspecionar e executar. Em vez de exigir que o desenvolvedor preveja todas as APIs de que um agente possa precisar, o agente pode pesquisar um catálogo em linguagem natural, inspecionar o contrato de um candidato e executar o endpoint selecionado.
O fluxo básico tem esta forma:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
A descoberta e a inspeção permitem que o agente compare opções antes de gastar qualquer valor. A execução é cobrada de acordo com o modelo de preço do endpoint selecionado. O desenvolvedor mantém uma única integração enquanto o agente ganha acesso a ferramentas de vários provedores.
Para runtimes de agentes que conseguem ler instruções de configuração, o Monid também publica uma skill legível por máquina:
Set up https://monid.ai/SKILL.md
A documentação do fluxo de trabalho do Monid explica com mais detalhes as etapas de catálogo, inspeção e execução.
Como as duas camadas trabalham juntas
O gateway de modelos e a camada de ferramentas devem continuar como componentes separados, com uma passagem de bastão pequena e explícita:
- O agente recebe o objetivo do usuário.
- O AIHubMix roteia uma chamada de planejamento para um modelo adequado.
- O plano identifica informações faltantes ou uma ação externa necessária.
- O Monid descobre ferramentas candidatas e expõe seus schemas e preços.
- O agente seleciona e executa uma ferramenta dentro de suas permissões e orçamento.
- A ferramenta retorna fatos ou o resultado de uma ação.
- O AIHubMix roteia a chamada de síntese de acordo com a qualidade, o custo ou a latência exigidos.
- O agente devolve uma resposta fundamentada no resultado da ferramenta.
Em Python simplificado, as chamadas do lado do modelo podem permanecer inalteradas enquanto o resultado da ferramenta é inserido como contexto:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
O detalhe importante não é o número de linhas. É que nenhuma das escolhas precisa ficar permanentemente embutida na lógica da aplicação. O modelo pode mudar conforme o prompt muda, e a ferramenta pode mudar conforme a tarefa muda.
Os controles de custo pertencem às duas camadas
Custos de modelo e de ferramenta usam unidades diferentes, por isso devem ser medidos separadamente.
Na camada de modelo, o modelo resolvido determina o preço por token. O AIHubMix torna essa decisão rastreável e permite que os desenvolvedores escolham uma política de roteamento ou restrinjam os modelos que uma chave de API pode usar. Etapas rotineiras podem priorizar custo ou latência, enquanto saídas voltadas ao usuário podem priorizar qualidade.
Na camada de ferramentas, um endpoint pode cobrar por chamada ou por resultado. O Monid expõe o preço durante a inspeção, antes da execução. Um agente pode rejeitar um endpoint que exceda seu orçamento, preferir uma opção verificada ou pedir aprovação antes de uma operação incomumente cara.
Controles úteis em produção incluem:
- Uma lista de modelos permitidos ou um teto de preço para cada chave de API.
- Um orçamento máximo de chamadas de ferramentas por tarefa.
- Listas de permissão de provedores ou endpoints para dados regulamentados.
- Logs que conectem a decisão de roteamento do modelo à chamada da ferramenta e à resposta final.
- Confirmação explícita antes de ações irreversíveis ou sensíveis.
- Validação da saída, para que os dados da ferramenta sejam tratados como entrada não confiável, e não como instruções.
Essa divisão também facilita a depuração de custos. Se uma execução ficar cara, os logs de tokens mostram se o agente raciocinou demais, enquanto os logs de ferramentas mostram se ele buscou dados demais. As correções são diferentes, e a arquitetura deve preservar essa distinção.
Confiabilidade exige contratos atualizados e decisões visíveis
A seleção dinâmica não deve significar comportamento imprevisível.
Do lado do modelo, o AIHubMix informa o modelo resolvido e a política de roteamento de cada requisição. A fixação de sessão pode preservar a consistência do modelo e os benefícios do cache de prompts em trabalhos de múltiplas interações, enquanto o comportamento de fallback pode afastar-se de um modelo instável quando necessário.
Do lado das ferramentas, o agente inspeciona o schema atual do endpoint antes de fazer uma chamada paga. Os resultados da descoberta incluem as informações necessárias para comparar candidatos, e o resultado da chamada real torna-se a única evidência externa passada para a completação final.
Juntos, esses controles criam uma trilha de auditoria útil:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Essa trilha é mais valiosa do que simplesmente ter acesso a muitos modelos ou a muitas APIs. Ela explica por que o agente fez cada escolha e quais evidências sustentaram sua resposta.
Quando você não precisa das duas camadas
Nem todo fluxo de trabalho se beneficia da escolha em tempo de execução.
Se uma aplicação envia um prompt estável a um único modelo já avaliado, especificar esse modelo diretamente é mais simples e mais determinístico do que roteá-lo. Se um pipeline agendado sempre chama uma única API conhecida, integrar essa API diretamente pode ser mais claro do que adicionar uma camada de descoberta.
A arquitetura de duas camadas se justifica quando a variedade faz parte da carga de trabalho:
- Os prompts variam o suficiente para que o melhor modelo mude de etapa para etapa.
- Agentes fazem múltiplas chamadas a modelos e precisam controlar o custo ou a latência acumulados.
- As ferramentas necessárias não podem ser totalmente previstas em tempo de build.
- Os dados externos precisam estar atualizados, e a origem deles precisa ser visível.
- A equipe quer adicionar capacidades sem criar uma nova integração com fornecedor para cada uma delas.
Use a camada de modelos, a camada de ferramentas ou ambas, de acordo com as decisões que sua aplicação realmente precisa tomar.
Construa o agente em torno de decisões, não de dependências
Um agente de IA em produção não se define pela quantidade de modelos ou APIs que consegue acessar. Ele se define por conseguir escolher a capacidade certa para a etapa atual, operar dentro de um orçamento e explicar o que aconteceu.
A AIHubMix oferece ao agente um endpoint de modelo unificado e roteamento em tempo de requisição com base em prioridades de custo, qualidade e latência. A Monid oferece descoberta de ferramentas em tempo de execução, schemas atuais, preços visíveis e execução em provedores externos.
Uma camada decide como o agente raciocina. A outra decide como ele descobre informações e age. Manter essas decisões separadas gera um agente mais fácil de estender, observar e controlar.
Comece pelo quick start da AIHubMix e depois conecte o lado das ferramentas por meio da Monid.
FAQ
O que é roteamento de modelos para agentes de IA?
O roteamento de modelos seleciona um modelo para cada requisição com base em fatores como tipo de tarefa, capacidade, custo e latência. Na AIHubMix, definir model como auto ou uma política como auto:quality_first habilita a seleção em tempo de requisição, mantendo uma API compatível com a OpenAI.
Por que um agente de IA precisa de ferramentas se o LLM já tem conhecimento?
Um LLM gera respostas a partir do contexto que recebe e do que aprendeu durante o treinamento. Ele não consegue saber de forma confiável preços atuais, consultar um banco de dados privado ou executar uma ação externa sem uma ferramenta conectada. As ferramentas fornecem dados em tempo real e execução; o modelo planeja e interpreta o resultado.
Um gateway de modelos é o mesmo que um servidor MCP ou uma plataforma de ferramentas?
Não. Um gateway de modelos roteia requisições de inferência para modelos. Servidores MCP e plataformas de ferramentas expõem capacidades externas para um agente. Eles resolvem problemas de integração complementares e podem ser usados juntos.
A AIHubMix e a Monid podem ser usadas de forma independente?
Sim. A AIHubMix pode rotear chamadas de modelos para aplicações que não têm requisitos dinâmicos de ferramentas. A Monid pode fornecer descoberta de ferramentas para agentes que usam outro provedor de modelos ou gateway. Usar as duas é útil quando um agente precisa de escolha em tempo de execução em ambas as camadas.
Como posso manter o roteamento automático auditável?
Registre o modelo resolvido, a política de roteamento, o candidato de ferramenta, o preço inspecionado, o endpoint selecionado e o resultado retornado para cada tarefa. A AIHubMix expõe os detalhes do roteamento de modelos na resposta, enquanto a Monid separa descoberta e inspeção da execução, para que a decisão sobre a ferramenta possa ser registrada antes da chamada paga.