Gemini 4 Carbon nie jest nową rodziną modeli. To Gemini 4 Argon z większą ilością rozumowania w każdej turze, oferowany w tej samej cenie za token: 2 USD za milion tokenów wejściowych i 10 USD za milion tokenów wyjściowych w ramach cen promocyjnych do 30 listopada 2026 r., a następnie odpowiednio 4 USD i 20 USD od 1 grudnia. Pytanie nie brzmi, który model jest tańszy w przeliczeniu na token. Są identyczne pod tym względem. Chodzi o to, czy dodatkowe rozumowanie przynosi wystarczającą korzyść w przeliczeniu na ukończone zadanie, by uzasadnić wolniejszą pierwszą odpowiedź.
Bieżące dane Artificial Analysis dają jasną odpowiedź w przypadku jednego rodzaju pracy i wyraźne ostrzeżenie w przypadku innego. Carbon High zajmuje 4. miejsce spośród 104 modeli w AA Intelligence Index z wynikiem 60.03, wobec 50.41 dla Argon High. Koszt wykonania zadania to 7.76 USD wobec 9.95 USD, a czas realizacji — 25.6 minuty wobec 29.0. Jednak czas do pierwszego tokenu odpowiedzi wynosi 67.1 sekundy, a w przypadku Argon — 40.1. Carbon lepiej sprawdzi się w kolejce zadań. Argon lepiej sprawdzi się w rozmowie.
Na tym polega cały podział, o którym jest ten wpis. Poniżej: co się zmieniło, co pokazują pomiary, co wnosi karta modelu Google, jak zmieni się cena 1 grudnia i które obciążenia powinny pozostać na Argon.
Co się zmieniło w porównaniu z Argon
Karta modelu Google jasno określa tę relację: „Gemini 4 Carbon bazuje na Gemini 4 Argon”. Identyfikator modelu to gemini-4-carbon — taki sam w AIHubMix. Google podaje okno kontekstu o długości 1,048,576 tokenów. Dostępne poziomy rozumowania to niski, średni i wysoki, przy czym domyślnie ustawiony jest średni. Standardowy limit wyjściowy wynosi 65,536 tokenów; natywna ścieżka Google do generowania długich sekwencji może obsłużyć do 1,048,576 tokenów minus tokeny wejściowe, a jako przykłady podano 131,072 i 262,144. AIHubMix dokumentuje obecnie wyłącznie Chat Completions, dlatego dopóki nie zostanie udokumentowana ścieżka obsługująca większe wartości, żądania kierowane przez bramę powinny mieć limit nieprzekraczający 65,536 tokenów. Data graniczna wiedzy to marzec 2026 r. Google nie udostępnia tego modelu w darmowym planie.
Zmianę opisano w notatkach Google AI Studio: „Carbon poświęca więcej tokenów na rozumowanie w każdej turze, by dokładniej analizować i weryfikować swoją pracę, co w porównaniu z Argon zwiększa zużycie tokenów i opóźnienie w każdej turze”. To zdanie wyjaśnia niemal wszystkie różnice omówione w dalszej części wpisu. Więcej rozumowania podnosi poprzeczkę w trudnych zadaniach, zwiększa koszt każdej tury i wydłuża oczekiwanie na pierwszy token.
Migracja jest celowo prosta. „Przejście z Argon nie wymaga żadnych zmian w schemacie żądania”. Na poziomie API wystarczy zmienić nazwę modelu. Google zaleca, by „pozostawić thinking_level na poziomie medium (domyślnym), chyba że konkretne obciążenie wymaga high, oraz upewnić się, że max_output_tokens i limity czasu HTTP pozwalają na dłuższe przebiegi rozumowania”.
Kompromis w pomiarach: więcej rozumowania, niższy koszt zadania
Poniższe dane pochodzą z bieżących pomiarów Artificial Analysis, wykonanych 2026-11-11T05:23Z (strony modeli sprawdzono ponownie o 06:01Z — bez zmian), przy standardowych cenach 4 USD za milion tokenów wejściowych i 20 USD za milion tokenów wyjściowych.
Przydatne porównanie zestawia jakość z kosztem ukończonego zadania: czy Carbon osiąga wyższy wynik indeksu przy niższym rachunku? Wykres przedstawia osobno wszystkie cztery konfiguracje modeli.
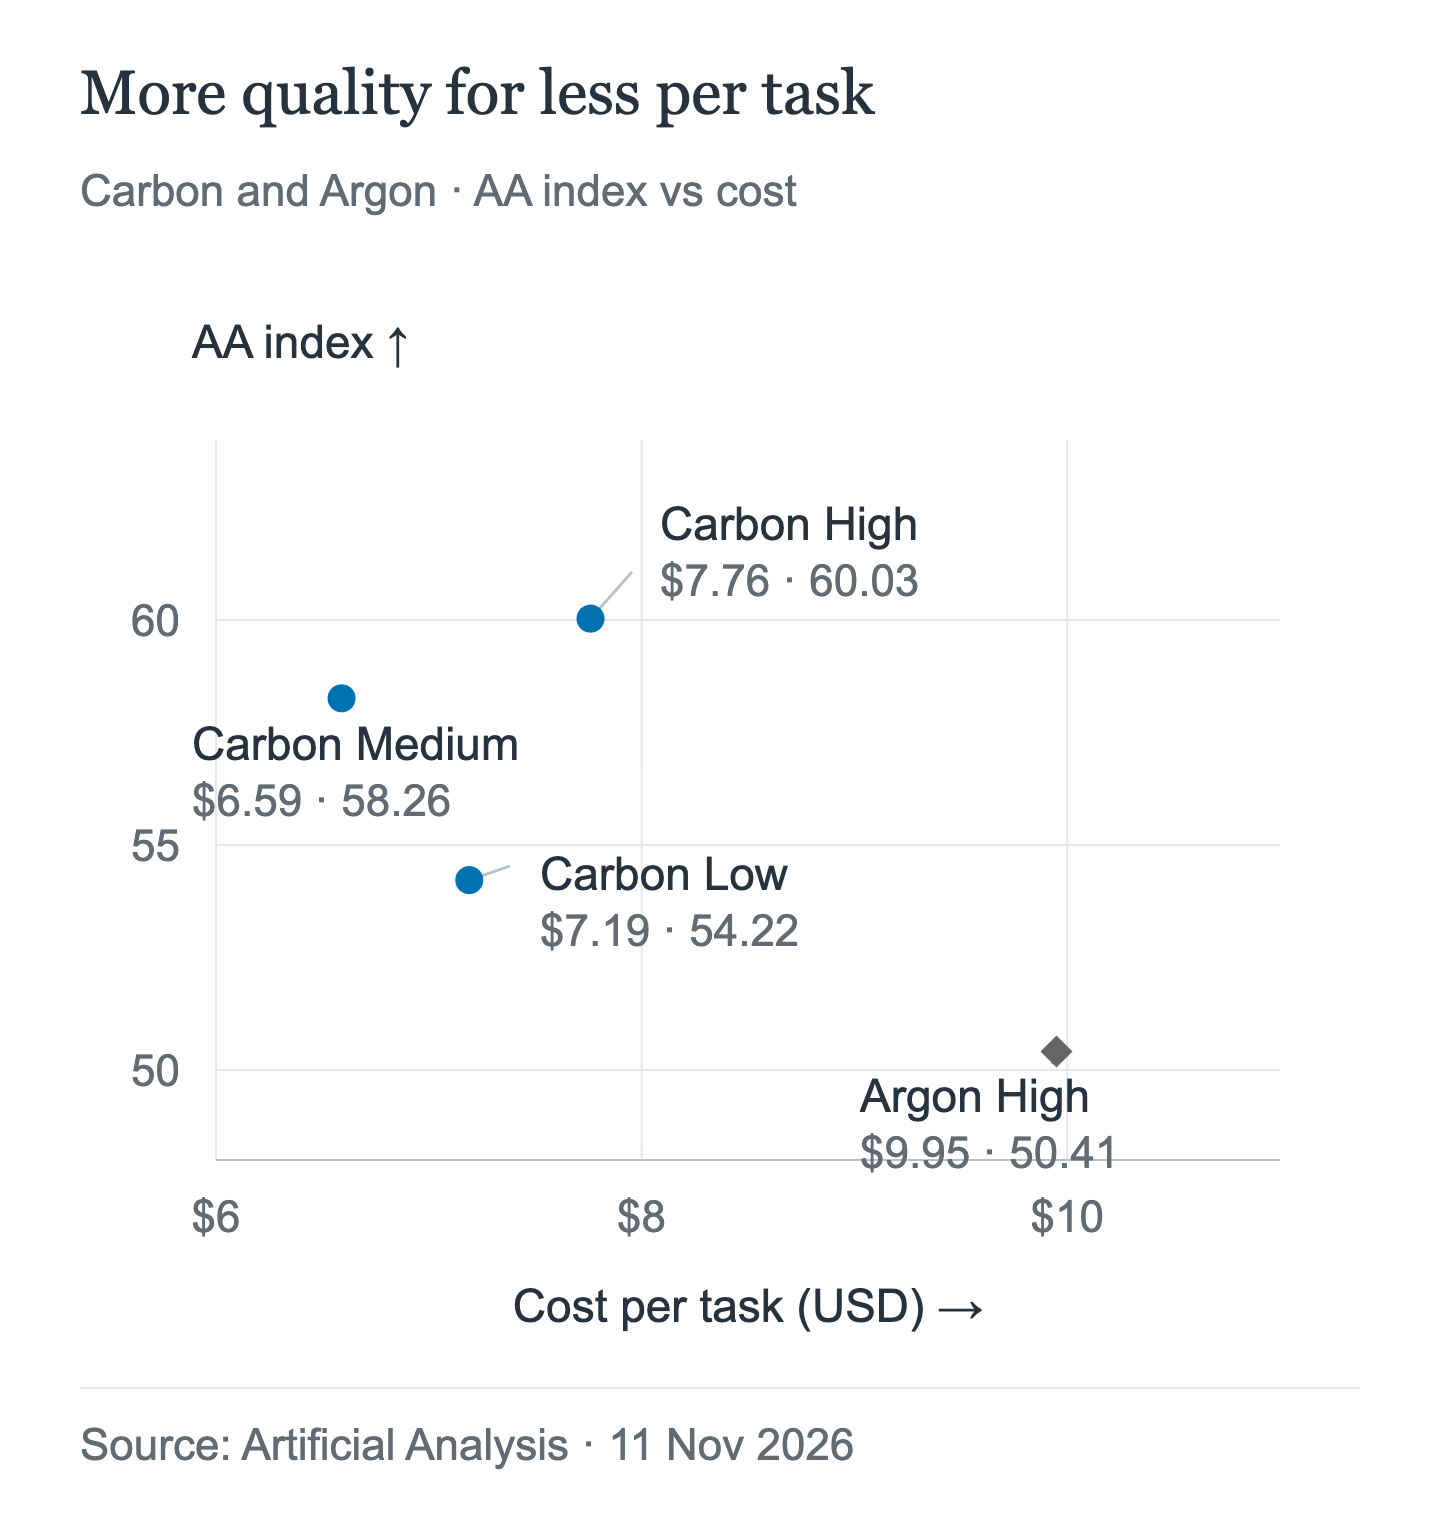
Carbon High znajduje się wyżej i bardziej na lewo niż Argon High. W tym pomiarze Medium to najtańsze ustawienie Carbon; Low wybiera się ze względu na opóźnienie, a nie najniższy koszt. Są to koszty zadań AA przy standardowych cenach, a nie rachunki za żądania w AIHubMix.
| Model | Indeks AA | USD/zadanie | Min/zadanie | Pierwszy token | Tokeny wyjściowe/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium i Low zajmują odpowiednio 4., 6. i 14. miejsce spośród 104 modeli; Argon High plasuje się za nimi. Trzy pozycje powyżej Carbon High należą do konfiguracji Claude Fable 5.2. „Pierwszy token” oznacza czas do pierwszego tokenu odpowiedzi. Porównanie Carbon High z Argon High: o 9.62 punktu wyższy wynik indeksu, koszt zadania niższy o 22.0%, czas realizacji 25.6 minuty wobec 29.0, ale czas do pierwszego tokenu odpowiedzi — 67.1 sekundy wobec 40.1.
Różnica w indeksie jest na tyle duża, że zmienia pozycję w rankingu. Różnica w opóźnieniu jest na tyle duża, że może zmienić to, czy ktoś będzie czekać. Oba stwierdzenia wynikają z tego samego wiersza tabeli.
Artificial Analysis określa Carbon jako „wyraźnie powolny w przeliczeniu na zadanie i bardzo rozwlekły” oraz podaje, że podczas obliczania indeksu wygenerował 205 milionów tokenów, wobec 113 milionów w przypadku Argon i mediany 72.8 miliona dla wszystkich mierzonych modeli. W tym pomiarze AA dużo większej liczbie tokenów wyjściowych towarzyszy niższy koszt zadania: ta sama cena katalogowa, znacznie więcej tokenów, a łączny koszt zadania niższy.
Jedna anomalia zasługuje na osobną wzmiankę. Carbon Low kosztuje 7.19 USD za zadanie, czyli więcej niż Medium (6.59 USD), mimo że wymaga mniej rozumowania. Bez względu na przyczynę Low sprawdza się jako ustawienie zapewniające krótsze opóźnienie, a nie niższą cenę — przed skierowaniem na nie ruchu zmierz więc koszt zadania.
Perspektywa agenta programistycznego
Intelligence Index uśrednia wyniki z wielu zadań. Coding Agent Index v2 lepiej odzwierciedla to, co uruchamia klient API: agenta programistycznego z narzędziami, mierzonego od początku do końca w tym samym środowisku testowym. Carbon High zajmuje 4. miejsce, a Argon High — 11.
| Miejsce | Agent + model | Indeks | USD/zadanie | Min/zadanie | Trafienie w pamięć podręczną |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Ten sam agent i środowisko testowe, inny model — dzięki temu porównanie pozwala ocenić sam model, a nie otaczającą go infrastrukturę. Koszt zadania z Carbon jest niższy o 34.0%, wynik indeksu wyższy o 6.2 punktu, a zadanie trwa o 4.9 minuty krócej. Liczba tokenów wyjściowych na zadanie jest niemal identyczna: 109,031 wobec 109,236. Wskaźnik trafień w pamięci podręcznej jest wyższy — 0.95 wobec 0.87 — a zużycie tokenów wejściowych niższe: 12.44 miliona wobec 13.76 miliona.
Dwa zastrzeżenia. Carbon zajmuje 4. miejsce w tym indeksie: prowadzi Claude Code z Opus 5.5 Max z wynikiem 61.7, a za nim plasują się Devin Fusion CLI i GitHub Copilot Fusion. Ponadto Fable 5.2 w ogóle nie uwzględniono w indeksie, więc ta tabela nie rozstrzyga porównania Carbon z Fable.
Co wnosi karta modelu Google, a czego nie
Karta modelu Google to dokument dostawcy: przedstawia wyniki z października 2026 r., zgłoszone przez samą firmę, i pochodzi z innego momentu niż omówione wcześniej bieżące dane. W każdym z poniższych wierszy wynik Carbon podany przez Google jest wyższy.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (dane dostawcy) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
Wiersz AA podaje zaokrąglony przez Google wynik 59, a nie 60.03 z wcześniejszej tabeli; te wartości pochodzą z różnych pomiarów i nie należy ich ze sobą łączyć. Zewnętrzne porównanie w karcie dotyczy Fable 5.1, a nie Fable 5.2.
Przydatna jest spójność wyników: przewaga nie ogranicza się do jednego benchmarku. Widać też ograniczenia. Karta dostawcy nie określa ceny zadania, nie mierzy opóźnienia do pierwszego tokenu ani nie informuje, ilu tur będzie wymagał agent. Potwierdza, że „Carbon jest przeciętnie mocniejszym modelem”. Nie dowodzi, że „Carbon jest lepszym modelem w twojej pętli działania”.
Cena: ten sam cennik i ta sama zmiana od 1 grudnia
Cenniki Carbon i Argon są identyczne w każdym wierszu. Oba modele objęte są cenami promocyjnymi do 30 listopada 2026 r., a 1 grudnia ich ceny się podwoją.
| Model | Wejście | Wyjście | Odczyt z pamięci podręcznej |
|---|---|---|---|
| Carbon, cena promocyjna (do 30 listopada) | $2.00 | $10.00 | $0.10 |
| Carbon, od 1 grudnia | $4.00 | $20.00 | $0.20 |
| Argon, cena promocyjna (do 30 listopada) | $2.00 | $10.00 | $0.10 |
| Argon, od 1 grudnia | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Oficjalne ceny w USD za milion tokenów, stan na 11 listopada 2026 r. Gemini 3.1 Pro Preview kosztuje 4/18/0.40 USD przy ponad 200k tokenów w promptcie, a ponadto 4.50 USD za milion tokenów na godzinę przechowywania. Zapis do pamięci podręcznej w Fable 5.2 kosztuje 10 USD przy ważności pięciominutowej lub 16 USD przy godzinnej; przetwarzanie wsadowe jest tańsze o 50%. Ceny promocyjne Carbon i Argon obowiązują do 30 listopada; od 1 grudnia każda z cen Carbon i Argon zostanie podwojona.
AIHubMix podaje cenę Carbon jako 2/10/0.10 USD, zgodną z promocyjnym cennikiem Google. W tym wpisie nie zakładamy, ile brama będzie pobierać po 30 listopada — sprawdź aktualną cenę na stronie modelu.
Po przeliczeniu zmierzonych przez Artificial Analysis liczby tokenów po cenach promocyjnych szacunkowy koszt zadania wynosi 3.88 USD dla Carbon High, 3.30 USD dla Medium, 3.60 USD dla Low i 4.98 USD dla Argon High. Są to obliczone szacunki, a nie pomiary AA: kalkulacja zakłada niezmienną strukturę tokenów w każdym zadaniu, a wynik zmienią twoje prompty i wskaźnik trafień w pamięci podręcznej.
W przeliczeniu na token Fable 5.2 kosztuje dwa razy więcej niż Carbon przy standardowych cenach i cztery razy więcej przy cenach promocyjnych. To różnica cenowa, a nie ocena jakości; porównanie modeli z tej serii omówiono w trzecim wpisie.
Kiedy Carbon nie jest lepszym wyborem
Argumentem przeciwko Carbon nie jest to, że wypada gorzej. Chodzi o to, że interaktywny produkt nie może sobie pozwolić na to, co ten model oferuje — więcej rozumowania w każdej turze.
Na pierwszy token trzeba długo czekać. Carbon High czeka 67.1 sekundy, zanim zwróci pierwszy token odpowiedzi; Argon High — 40.1 sekundy. Medium skraca oczekiwanie do 23.2 sekundy, a Low do 12.9, ale oba ustawienia tracą punkty w indeksie. Interfejs czatu, który milczy przez minutę, zdążył już zmarnować tę turę — niezależnie od tego, jak będzie wyglądać odpowiedź, gdy w końcu dotrze.
Google zaleca pozostawić Argon ze względu na szybkość. Argon jest przeznaczony do „szybszych odpowiedzi i mniejszego zużycia tokenów na turę” w przypadku „interaktywnego programowania, codziennej pracy nad funkcjami i szybkich cykli wdrożeń produkcyjnych”. Zalecenie z notatek dotyczących migracji jest jednoznaczne: „Pozostaw Argon tam, gdzie liczy się szybkość”. Wpis ogłoszeniowy Google powtarza tę myśl: „Argon pozostaje idealnym wyborem do większości prac inżynierii oprogramowania i zadań wymagających pracy z wiedzą”.
Wydatek na turę jest większy, nawet jeśli koszt zadania jest niższy. Cena za token pozostaje taka sama, ale Carbon zużywa więcej tokenów na rozumowanie w każdej turze. Zespół monitorujący wydatki na tokeny w przeliczeniu na turę lub ograniczający przydzielony limit odczuje, że Carbon jest droższym modelem. Przebieg indeksu, w którym wykorzystano 205 milionów tokenów, wobec 113 milionów w przypadku Argon, pokazuje skrajną skalę tego efektu.
Low nie jest najtańszą opcją. Przy koszcie 7.19 USD za zadanie Carbon Low kosztuje więcej niż Medium (6.59 USD). Jeśli kryterium wyboru modelu jest koszt ukończonego zadania, Low go nie spełnia.
Wygrana w benchmarku nie cofnie wskazówek zegara. W tabeli Google OSWorld-2.1 i FrontierSWE 2 przemawiają na korzyść Carbon, ale są to wyniki zgłoszone przez dostawcę i żaden z nich nie skraca czasu do pierwszego tokenu. Benchmarki mierzą rezultat; użytkownicy odczuwają oczekiwanie na początek.
Kto powinien przejść już teraz, a kto pozostać przy Argon
Przejdź teraz na Carbon, jeśli korzystasz z natywnych dla dostawcy zadań wsadowych lub zadań agentów działających w tle (te ścieżki nie są udokumentowane dla Carbon w AIHubMix), jeśli koszt błędu jakościowego przewyższa koszt czasu wykonania, jeśli Twoje żądania mogą tolerować dłuższe limity czasu i większy budżet na wyjście lub jeśli już płacisz za ponowienia, których Carbon mógłby uniknąć.
Pozostań przy Argon, jeśli tworzysz czat, autouzupełnianie albo dowolną pętlę, w której człowiek czeka na odpowiedź; jeśli budżet lub limit są liczone na turę; albo jeśli docelowe opóźnienie poniżej około 30 sekund jest częścią produktu.
Najpierw przetestuj, jeśli jesteś gdzieś pośrodku. Wyślij te same 20–50 rzeczywistych żądań do obu modeli, zanotuj czas do pierwszego tokenu i koszt ukończonego zadania, a następnie kieruj żądania na tej podstawie, a nie według indeksu. Strona porównawcza AIHubMix wyświetla strony obu modeli obok siebie.
Jak wywołać model przez AIHubMix
Carbon korzysta z tego samego wzorca identyfikatora modelu w AIHubMix i z udokumentowanego punktu końcowego chat-completions.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Punkt końcowy to POST /v1/chat/completions; to jedyna trasa udokumentowana przez AIHubMix dla tego modelu. Wymienionym formatem wejściowym jest tekst. Obsługa obrazów i plików PDF, Responses API, Anthropic Messages oraz natywny punkt końcowy Gemini nie są udokumentowane dla Carbon w AIHubMix, więc należy uznać je za niepotwierdzone. To samo dotyczy mapowania reasoning_effort: nie zakładaj, że brama przekazuje dalej parametr poziomu rozumowania. Utrzymuj max_tokens w granicach standardowego limitu wyjścia 65,536; wyższe limity wymagają trybu background od Google i nie są potwierdzone w AIHubMix. Na potrzeby tego wpisu nie przeprowadzono testu na żywo, więc przykład pokazuje format żądania, a nie zweryfikowaną odpowiedź.
FAQ
Czy Carbon kosztuje tyle samo co Argon?
Tak. Oficjalne stawki Google są identyczne: 2 USD za milion tokenów wejściowych i 10 USD za milion tokenów wyjściowych do 30 listopada 2026 r., a następnie odpowiednio 4 USD i 20 USD. Odczyty z pamięci podręcznej kosztują 0,10 USD, a następnie 0,20 USD.
Czy Carbon jest lepszy od Argon?
Pod względem jakości i kosztu ukończonego zadania — tak, według pomiarów Artificial Analysis: 60.03 wobec 50.41 w Intelligence Index oraz 7,76 USD wobec 9,95 USD za zadanie. Pod względem responsywności — nie: uzyskanie pierwszego tokenu odpowiedzi zajmuje 67.1 sekundy wobec 40.1.
Dlaczego Carbon działa wolniej, skoro szybciej kończy zadania?
Dłużej czeka z odpowiedzią, ale potem szybciej kończy całe zadanie: 25,6 minuty wobec 29,0. Czas oczekiwania na pierwszy token i łączny czas zadania to różne miary, które wskazują przeciwne kierunki.
Czy trzeba zmieniać żądania?
Nie. Google informuje, że aktualizacja z Argon nie wymaga zmian schematu; zmienia się tylko nazwa modelu na gemini-4-carbon. Zwiększ limit wyjścia i limit czasu HTTP, aby uwzględnić dłuższe rozumowanie.
Dlaczego Carbon Low kosztuje więcej za zadanie niż Medium?
Artificial Analysis zmierzyło koszt 7,19 USD dla Low wobec 6,59 USD dla Medium. Traktuj Low jako ustawienie opóźnienia, a nie rabatu, i zmierz koszt zadania przed wysłaniem większej liczby żądań.
Jaką pozycję Carbon zajmuje w rankingu Artificial Analysis?
Zajmuje 4. miejsce w Intelligence Index, za trzema konfiguracjami Claude Fable 5.2. Karta modelu Google podaje zaokrąglony wynik 59 dla tego samego indeksu; aktualna wartość to 60.03, więc nie należy ich mieszać.
Czy Carbon jest dostępny w bezpłatnym planie?
Nie. Google nie udostępnia Gemini 4 Carbon w bezpłatnym planie, więc dostęp wymaga płatnego cennika API lub bramy, takiej jak AIHubMix.
Czytaj dalej: seria Gemini 4 Carbon
- Jeśli ten wpis przekonał Cię do wypróbowania Carbon, ale pierwsze żądanie zakończyło się błędem, przewodnik po migracji omawia błędy 400, ustawienia limitu czasu i limity wyjścia, które zmieniają się przy dłuższych etapach rozumowania: Migracja Gemini 4 Carbon API: błędy 400, limity czasu i limity wyjścia.
- Jeśli zastanawiasz się, czy Carbon wystarczy do kodowania agentowego, czy też dopłata do Fable 5.2 daje jakąś korzyść, trzeci wpis zestawia te same zmierzone wartości z Fable 5.2: Gemini 4 Carbon kontra Fable 5.2: który model wybrać do kodowania agentowego?.
Źródła
- Google AI Studio, Gemini 4 Carbon: co nowego
- Google DeepMind, karta modelu Gemini 4 Carbon
- Google AI Studio, cennik Gemini API
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon