Gemini 4 Carbon is geen nieuwe modelfamilie. Het is Gemini 4 Argon met meer denkwerk per beurt, verkocht voor dezelfde prijs per token: $2 per miljoen invoertokens en $10 per miljoen uitvoertokens tegen introductietarieven tot en met 30 november 2026, daarna $4 en $20 vanaf 1 december. De vraag is niet welk model goedkoper is per token. Ze zijn identiek. De vraag is of het extra denkwerk per voltooide taak voldoende oplevert om een tragere eerste reactie te rechtvaardigen.
De actuele cijfers van Artificial Analysis geven een duidelijk antwoord voor één soort werk en een duidelijke waarschuwing voor een ander. Carbon High staat op #4 van 104 in de AA Intelligence Index met 60.03, tegenover 50.41 voor Argon High. Het kost $7.76 per taak tegenover $9.95 en is klaar in 25.6 minuten tegenover 29.0. Maar de tijd tot de eerste antwoordtoken is 67.1 seconden, tegenover 40.1 voor Argon. Carbon is het betere model voor een wachtrij. Argon is het betere model voor een gesprek.
Dat verschil vormt de kern van dit artikel. Hieronder lees je wat er is veranderd, wat de metingen laten zien, wat Google's modelkaart toevoegt, hoe de prijs op 1 december verandert en welke workloads beter op Argon blijven.
Wat er is veranderd ten opzichte van Argon
De modelkaart van Google beschrijft de relatie helder: "Gemini 4 Carbon is gebaseerd op Gemini 4 Argon." De model-ID is gemini-4-carbon, ook op AIHubMix. Google documenteert een contextvenster van 1,048,576 tokens. De denk-niveaus zijn low, medium en high, waarbij medium de standaardinstelling is. De standaarduitvoer is 65,536 tokens; Google's native pad voor lange decodering kan oplopen tot 1,048,576 tokens min de invoer, met 131,072 en 262,144 als voorbeelden. AIHubMix documenteert momenteel alleen Chat Completions, dus houd gateway-verzoeken op of onder 65,536 totdat een groter pad is gedocumenteerd. De kennisgrens is maart 2026. Google biedt het model niet aan binnen het gratis abonnement.
De verandering wordt beschreven in Google's AI Studio-notities: "Carbon gebruikt per beurt meer denktokens om grondig te verkennen en het werk te controleren, wat het tokenverbruik en de latentie per beurt verhoogt ten opzichte van Argon." Die zin verklaart bijna elk verschil dat verderop in dit artikel aan bod komt. Meer denkwerk verhoogt het plafond voor moeilijke taken, verhoogt de kosten per beurt en verlengt de wachttijd tot de eerste token.
Migratie is bewust eenvoudig. "Een upgrade vanaf Argon vereist geen wijzigingen in het aanvraagschema." Op API-niveau volstaat het om de modelnaam te vervangen. Google's operationele advies is om "thinking_level op medium te laten staan (de standaardinstelling), tenzij een workload high vereist, en ervoor te zorgen dat max_output_tokens en HTTP-time-outs langere redeneerprocessen toestaan."
De afweging in de metingen: meer denkwerk, lagere kosten per taak
De onderstaande cijfers zijn actuele metingen van Artificial Analysis, geraadpleegd op 2026-11-11T05:23Z (modelpagina's opnieuw gecontroleerd om 06:01Z, zonder wijzigingen), tegen standaardprijzen van $4 per miljoen invoertokens en $20 per miljoen uitvoertokens.
De nuttige vergelijking is kwaliteit tegenover kosten per voltooide taak: brengt Carbon de index omhoog terwijl de rekening lager uitvalt? De grafiek houdt de vier modelconfiguraties apart.
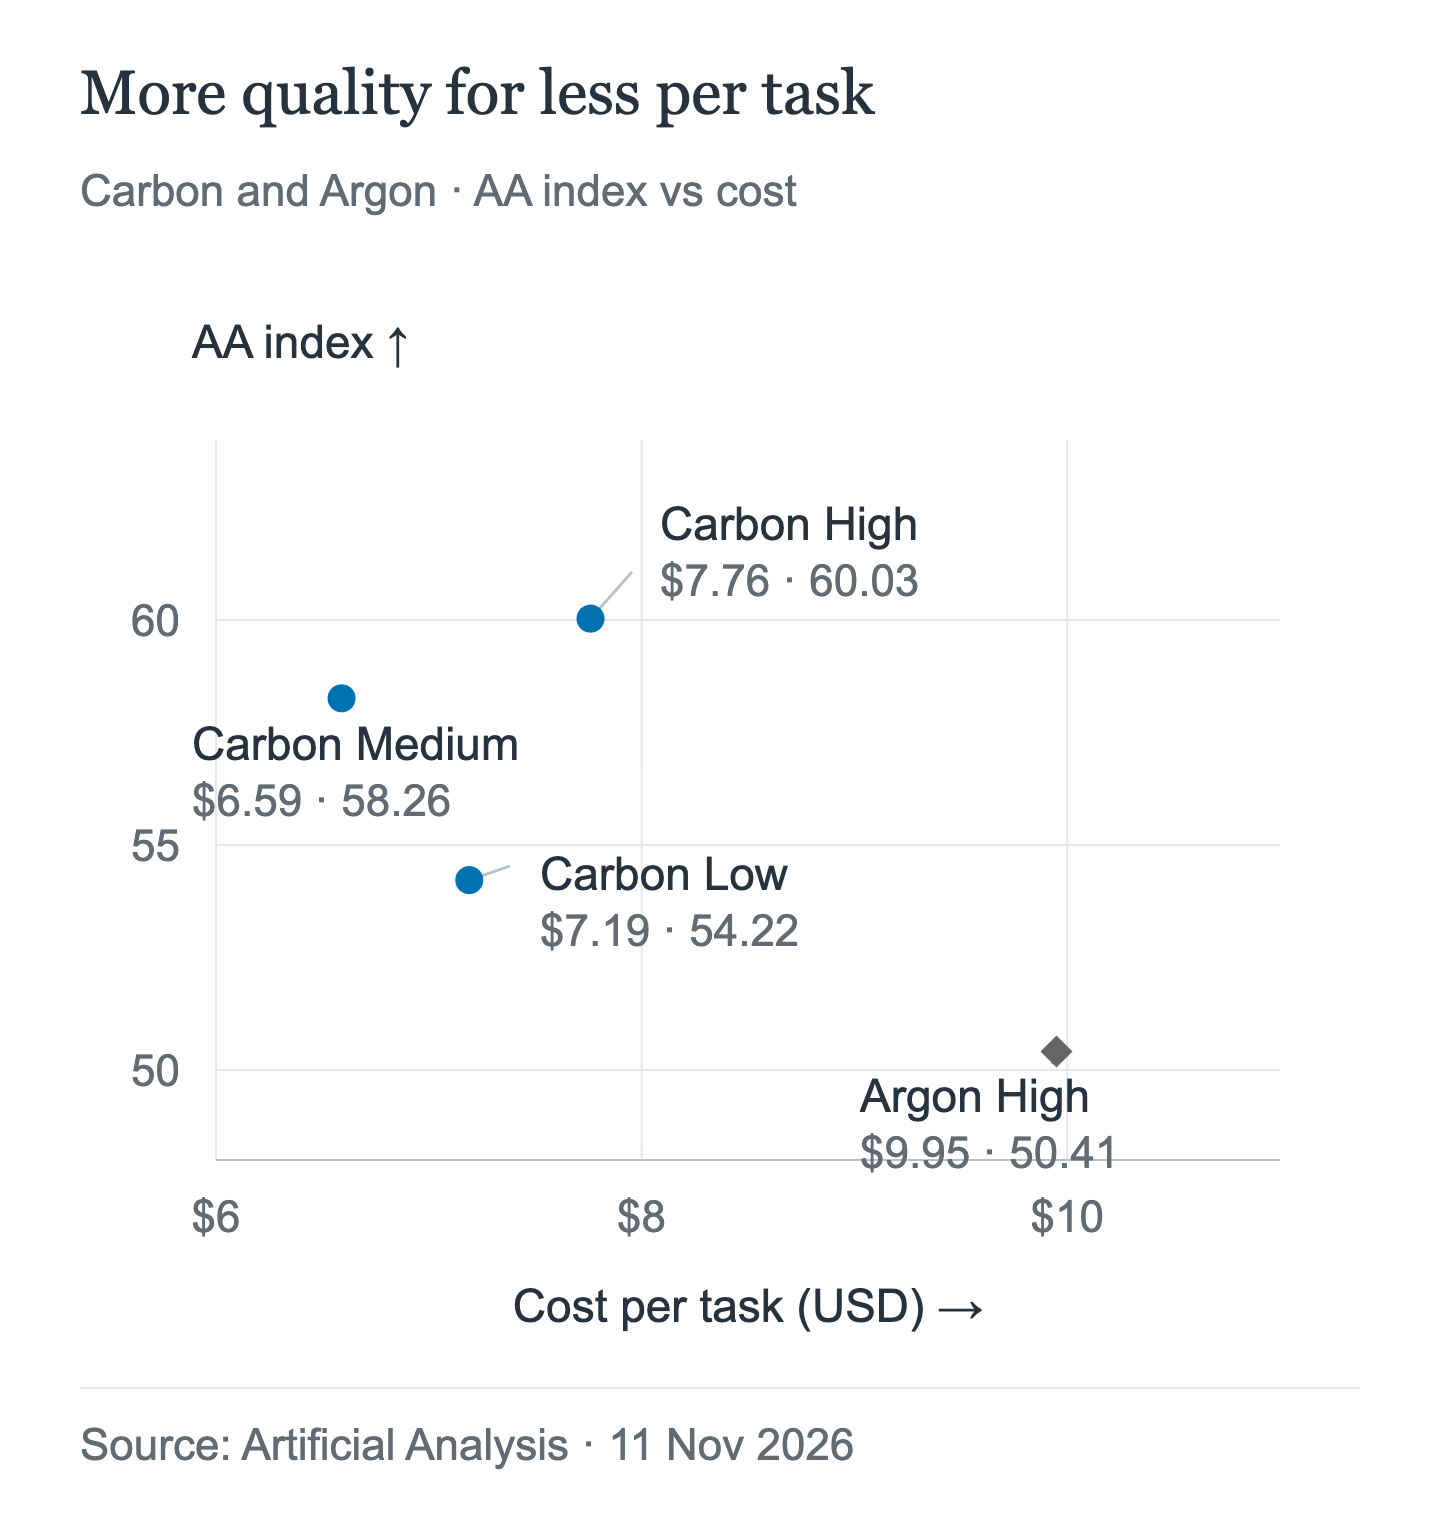
Carbon High staat hoger en meer naar links dan Argon High. Medium is in deze meting de goedkoopste Carbon-instelling; Low is een keuze voor lagere latentie, niet voor lagere kosten. Dit zijn AA-taakkosten tegen standaardprijzen, geen AIHubMix-rekeningen voor API-verzoeken.
| Model | AA-index | $/taak | Min./taak | Eerste token | Uitvoer tok/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium en Low staan respectievelijk op #4, #6 en #14 van 104; Argon High staat daaronder. De drie modellen boven Carbon High zijn allemaal Claude Fable 5.2-configuraties. "Eerste token" is de tijd tot de eerste antwoordtoken. Carbon High tegenover Argon High: +9.62 indexpunten, 22.0% goedkoper per taak, 25.6 tegenover 29.0 minuten, maar 67.1 tegenover 40.1 seconden tot de eerste antwoordtoken.
Het verschil in de index is groot genoeg om een plek op de ranglijst te veranderen. Het verschil in latentie is groot genoeg om te bepalen of iemand moet wachten. Beide uitspraken komen uit dezelfde rij.
Artificial Analysis noemt Carbon "opvallend traag per taak en zeer uitvoerig" en meldt dat het 205 miljoen tokens heeft gegenereerd voor de index, tegenover 113 miljoen voor Argon en een mediaan van 72.8 miljoen voor de gemeten modellen. In deze AA-meting gaan de lagere kosten per taak samen met een veel grotere uitvoerhoeveelheid: dezelfde lijstprijs, veel meer tokens en lagere totale taakkosten.
Eén afwijking verdient een eigen vermelding. Carbon Low kost $7.19 per taak, meer dan Medium met $6.59, ondanks dat het minder denkwerk verricht. Wat de oorzaak ook is, Low gedraagt zich als een latentie-instelling en niet als een kortingsinstelling. Meet dus de kosten per taak voordat je er veel verkeer naartoe stuurt.
Bekeken vanuit coding agents
De Intelligence Index middelt veel taken. De Coding Agent Index v2 sluit beter aan bij wat een API-klant gebruikt: een coding agent met tools, van begin tot eind gemeten op dezelfde testopstelling. Carbon High staat op #4; Argon High op #11.
| Rang | Agent + model | Index | $/taak | Min./taak | Cache-hit |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Dezelfde agent, dezelfde testopstelling, ander model: zo isoleert de vergelijking het model en niet de omringende infrastructuur. Carbon is 34.0% goedkoper per taak, scoort +6.2 indexpunten en is 4.9 minuten sneller. De uitvoer per taak is vrijwel gelijk: 109,031 tokens tegenover 109,236. Het cache-hitpercentage is hoger, 0.95 tegenover 0.87, en het invoerverbruik lager: 12.44 miljoen tokens tegenover 13.76 miljoen.
Twee kanttekeningen. Carbon staat op #4 in deze index: Claude Code met Opus 5.5 Max voert aan met 61.7, gevolgd door Devin Fusion CLI en GitHub Copilot Fusion. En Fable 5.2 staat helemaal niet in de index, dus deze tabel kan de vergelijking tussen Carbon en Fable niet beslechten.
Wat Google's modelkaart wel en niet toevoegt
Google's modelkaart is een document van de aanbieder: resultaten van oktober 2026, zelfgerapporteerd en gebaseerd op een andere momentopname dan de actuele gegevens hierboven. Voor de onderstaande benchmarks is Google's score voor Carbon telkens hoger.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (aanbieder) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
De AA-score is Google's afgeronde 59, niet de actuele 60.03 in de eerdere tabel; de twee cijfers komen uit verschillende momentopnamen en mogen niet door elkaar worden gehaald. De externe vergelijking in de kaart is met Fable 5.1, niet met Fable 5.2.
Het nuttige punt is de consistentie: de winst beperkt zich niet tot één benchmark. De beperking is ook duidelijk. Een modelkaart van de aanbieder vermeldt niet de kosten per taak, meet de latentie tot de eerste token niet en vertelt je niet hoeveel beurten je agent nodig zal hebben. De kaart ondersteunt de uitspraak "Carbon is gemiddeld genomen het sterkere model." Niet de uitspraak "Carbon is het betere model voor jouw interactielus."
Prijs: dezelfde tariefkaart, met dezelfde wijziging op 1 december
Carbon en Argon zijn regel voor regel gelijk geprijsd. Beide hebben introductietarieven tot en met 30 november 2026, en beide tarieven verdubbelen op 1 december.
| Model | Invoer | Uitvoer | Gecachte leesbewerking |
|---|---|---|---|
| Carbon, introductie (t/m 30 nov.) | $2.00 | $10.00 | $0.10 |
| Carbon, vanaf 1 dec. | $4.00 | $20.00 | $0.20 |
| Argon, introductie (t/m 30 nov.) | $2.00 | $10.00 | $0.10 |
| Argon, vanaf 1 dec. | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Officiële prijzen in USD per miljoen tokens, 11 november 2026. Gemini 3.1 Pro Preview kost $4/$18/$0.40 boven 200k prompttokens, plus $4.50 per miljoen tokens per uur opslag. Voor cachebewerkingen bij Fable 5.2 kost schrijven $10 voor vijf minuten of $16 voor één uur; batchverwerking heeft 50% korting. De introductietarieven voor Carbon en Argon eindigen op 30 november; alle tarieven voor Carbon en Argon verdubbelen op 1 december.
AIHubMix vermeldt Carbon voor $2/$10/$0.10, overeenkomstig Google's introductietarieven. Dit artikel gaat niet uit van wat de gateway na 30 november rekent; controleer de modelpagina voor het actuele tarief.
Als we de gemeten tokenaantallen van Artificial Analysis herberekenen tegen de introductietarieven, komen we uit op ruwe schattingen per taak van $3.88 voor Carbon High, $3.30 voor Medium, $3.60 voor Low en $4.98 voor Argon High. Dit zijn berekende schattingen, geen metingen van AA: de berekening houdt de tokenmix per taak constant, terwijl jouw prompts en cache-hitpercentage het resultaat beïnvloeden.
Per token kost Fable 5.2 tegen standaardtarieven twee keer zoveel als Carbon en tegen de introductietarieven vier keer zoveel. Dat is een prijsverschil, geen oordeel over de kwaliteit; het derde artikel in de reeks behandelt de vergelijking.
Wanneer Carbon niet de betere keuze is
Het argument tegen Carbon is niet dat het slechter is. Het is dat de meerwaarde, meer denkwerk per beurt, precies datgene is waar een interactief product geen tijd aan kan besteden.
De eerste token laat op zich wachten. Carbon High wacht 67.1 seconden voordat de eerste antwoordtoken verschijnt; bij Argon High is dat 40.1. Medium verkort de wachttijd tot 23.2 seconden en Low tot 12.9, maar beide leveren indexpunten in. Een chatinterface die een minuut pauzeert, heeft de beurt al verloren, wat het antwoord er ook uitziet zodra het verschijnt.
Google raadt aan Argon te behouden voor snelheid. Argon wordt aanbevolen voor "snellere reacties en lager tokenverbruik per beurt" bij "interactief programmeren, dagelijks functiewerk en snelle productiecycli". De instructie in de migratienotities is onomwonden: "Behoud Argon waar snelheid belangrijk is." Google's aankondigingsbericht herhaalt dit: "Argon blijft de ideale keuze voor de meeste software-engineering- en kenniswerktaken."
De uitgaven per beurt zijn hoger, zelfs als de kosten per taak lager zijn. De prijs per token is gelijk, maar Carbon gebruikt per beurt meer denktokens. Een team dat het tokenverbruik per beurt in de gaten houdt of een tokenquotum moet verdelen, ervaart Carbon als het duurdere model. De indexmeting met 205 miljoen tokens tegenover 113 miljoen voor Argon is het extreme voorbeeld van dit effect.
Low is niet de goedkope optie. Met $7.19 per taak kost Carbon Low meer dan Medium met $6.59. Als de kosten per voltooide taak de doorslag geven bij routering, voldoet Low niet aan dat criterium.
Benchmarkoverwinningen maken de tijd niet goed. OSWorld-2.1 en FrontierSWE 2 vallen allebei in het voordeel van Carbon uit in Google's tabel, maar de cijfers zijn door de aanbieder gerapporteerd en veranderen niets aan de wachttijd tot de eerste token. Benchmarks meten het eindresultaat; gebruikers ervaren het begin.
Wie moet nu overstappen en wie kan beter bij Argon blijven?
Stap nu over op Carbon als je batch- of achtergrondtaken voor agents uitvoert via de native API van de aanbieder (die mogelijkheden zijn niet gedocumenteerd voor Carbon op AIHubMix), als een kwaliteitsfout meer kost dan extra wachttijd, als je verzoeken langere time-outs en een hoger uitvoerbudget aankunnen, of als je al betaalt voor nieuwe pogingen die Carbon mogelijk overbodig maakt.
Blijf bij Argon als je chat, autocomplete of een andere cyclus bouwt waarbij iemand wacht; als je budget of quotum per beurt wordt berekend; of als een latentiedoel van minder dan ongeveer 30 seconden onderdeel is van het product.
Test eerst als je twijfelt. Stuur dezelfde 20 tot 50 echte verzoeken door beide modellen, registreer de tijd tot het eerste token en de kosten per voltooide taak, en routeer op basis daarvan in plaats van de index. Op de vergelijkingspagina van AIHubMix staan de pagina's van beide modellen naast elkaar.
Zo roep je het aan via AIHubMix
Carbon gebruikt op AIHubMix hetzelfde patroon voor model-ID's en hetzelfde gedocumenteerde eindpunt voor chat completions.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Het eindpunt is POST /v1/chat/completions; dit is de enige route die AIHubMix voor dit model documenteert. Tekst is de vermelde invoermodaliteit. Afbeeldings- en PDF-invoer, de Responses API, Anthropic Messages en het native Gemini-eindpunt zijn niet gedocumenteerd voor Carbon op AIHubMix, dus beschouw ze als onbevestigd. Hetzelfde geldt voor de mapping van reasoning_effort: ga er niet van uit dat de gateway een parameter voor het denkniveau doorgeeft. Houd max_tokens binnen de standaardlimiet voor uitvoer van 65,536; voor de hogere limieten is de achtergrondmodus van Google nodig en die is niet bevestigd op AIHubMix. Voor dit artikel is geen live test uitgevoerd, dus het voorbeeld toont de vorm van het verzoek en geen geverifieerd antwoord.
Veelgestelde vragen
Heeft Carbon dezelfde prijs als Argon?
Ja. De officiële tarieven van Google zijn identiek: tot en met 30 november 2026 $2 per miljoen invoertokens en $10 per miljoen uitvoertokens; daarna $4 en $20. Gecachte leesbewerkingen kosten respectievelijk $0.10 en $0.20.
Is Carbon beter dan Argon?
Qua kwaliteit en kosten per voltooide taak wel, volgens de metingen van Artificial Analysis: 60.03 tegenover 50.41 op de Intelligence Index en $7.76 tegenover $9.95 per taak. Qua reactiesnelheid niet: het duurt 67.1 seconden voordat het eerste antwoordtoken verschijnt, tegenover 40.1.
Waarom is Carbon trager als het taken sneller afrondt?
Het wacht langer voordat het antwoord geeft, maar rondt daarna de hele taak sneller af: 25.6 minuten tegenover 29.0. De wachttijd tot het eerste token en de totale taakduur zijn verschillende metingen en wijzen in tegengestelde richtingen.
Moeten de verzoeken worden aangepast?
Nee. Volgens Google zijn er bij een upgrade van Argon geen wijzigingen aan het schema nodig; alleen de modelreeks wordt gemini-4-carbon. Verhoog de uitvoerlimiet en de HTTP-time-out om langere denksessies mogelijk te maken.
Waarom kost Carbon Low per taak meer dan Medium?
Artificial Analysis mat $7.19 voor Low tegenover $6.59 voor Medium. Beschouw Low als een instelling voor latentie, niet als een instelling voor korting, en meet de kosten per taak voordat je er veel verzoeken naartoe stuurt.
Welke positie heeft Carbon op Artificial Analysis?
Het staat op #4 in de Intelligence Index, achter drie configuraties van Claude Fable 5.2. Op de modelkaart van Google staat voor dezelfde index een afgeronde score van 59; de actuele score is 60.03. Die twee mogen niet door elkaar worden gebruikt.
Is Carbon beschikbaar in het gratis abonnement?
Nee. Google biedt Gemini 4 Carbon niet aan in het gratis abonnement, dus toegang is mogelijk via betaalde API-tarieven of een gateway zoals AIHubMix.
Lees verder: de Gemini 4 Carbon-serie
- Als dit artikel je heeft overtuigd om Carbon te proberen, maar je eerste verzoek is mislukt, behandelt de migratiehandleiding de 400-fouten, time-outinstellingen en uitvoerlimieten die veranderen bij langere denksessies: Gemini 4 Carbon API-migratie: 400-fouten, time-outs en uitvoerlimieten.
- Als je je afvraagt of Carbon krachtig genoeg is voor agentisch programmeren, of de meerprijs voor Fable 5.2 iets oplevert, zet het derde artikel dezelfde gemeten cijfers naast die van Fable 5.2: Gemini 4 Carbon vs Fable 5.2: welk model voor agentisch programmeren?.
Bronnen
- Google AI Studio, Gemini 4 Carbon: wat is er nieuw?
- Google DeepMind, modelkaart van Gemini 4 Carbon
- Google AI Studio, Gemini API-prijzen
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon