Anthropic은 2026년 11월 9일 Claude Fable 5.2를 출시했습니다. Google은 하루 뒤 Gemini 4 Carbon을 정식 출시했습니다. Anthropic이 공개한 자체 출시 벤치마크 표에는 Carbon 열이 포함되어 있어, 동일한 장기 코딩 작업을 놓고 유용하게 비교할 수 있습니다.
두 모델은 같은 작업을 대상으로 판매됩니다. 바로 장기 에이전트 코딩입니다. 에이전트가 저장소를 읽고, 여러 파일을 수정하고, 명령을 실행하고, 테스트 출력을 확인한 뒤, 사람의 개입 없이 15~45분 동안 작업을 이어 갑니다. 여기서 평가하는 작업이 바로 이것입니다. 채팅, 자동 완성, 짧은 스크립트는 다른 테스트입니다.
요약
공개된 하드 코드 벤치마크에서는 Fable 5.2가 앞서며, 같은 추론 수준에서 더 빠릅니다. AA 상위 3개 순위를 차지해 Carbon High를 4위로 밀어냈습니다. 반면 공개된 Terminal-Bench 4.0 및 AutomationBench-AA 항목에서는 Carbon 점수가 더 높고, 11월 30일 Google의 출시 기념 가격이 끝날 때까지 High 추론 수준 기준 작업당 비용도 더 저렴합니다. Medium에서는 Fable이 더 저렴하고 훨씬 빠르며, Carbon은 AA 지수가 더 높습니다.
하드 코드 추론에는 Fable, 터미널 실행과 자동화에는 Carbon을 선택하세요. 어느 쪽이든 사용 전에 입력, 데이터 보존, 출력 한도를 확인해야 합니다.
하나의 하네스에서 확인한 결과
Artificial Analysis는 모든 모델을 동일한 하네스와 작업으로 실행합니다. Carbon과 Fable 페이지에서 평가별 결과를 확인할 수 있습니다. 수치는 2026년 11월 11일 스냅샷 기준이며, AA는 Google의 출시 기념 할인이 아닌 표준 가격을 사용합니다.
| 모델 | AA 지수 | 작업당 비용($) | 작업당 시간(분) | 첫 토큰 |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
참고: AA Intelligence Index 및 표준 가격 기준 작업당 비용, 스냅샷 2026-11-11T05:23Z. Fable Max, Xhigh, High가 1~3위이며, Carbon High는 4위, Opus 5.5 Max는 5위, Carbon Medium은 6위입니다. 첫 토큰은 첫 응답 토큰까지 걸리는 시간입니다.
High 추론 수준에서 Fable은 1.79점 앞서고, 작업당 비용은 17.0% 더 높습니다($9.08 대 $7.76). 작업을 25.6분이 아닌 17.3분 만에 마치며, 첫 토큰도 67.1초가 아닌 30.4초 만에 반환합니다. Max는 작업당 $26.54로 Carbon High의 3.4배이며, 첫 토큰까지 233.9초가 걸립니다.
Medium에서는 순위가 바뀝니다. Fable은 56.41점으로 Carbon의 58.26점보다 1.85점 낮지만, 비용은 $6.59가 아닌 $3.80이고 소요 시간은 23.3분이 아닌 7.8분입니다. Carbon은 토큰 가격이 더 낮아도 여기서는 작업당 비용이 더 저렴하지 않습니다. 토큰을 더 많이 사용하기 때문입니다.
| 벤치마크 | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| 환각 없는 답변 비율(%) | 88.58 | 42.02 | 40.73 | 49.66 |
| 정확도(%) | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
참고: Artificial Analysis, 동일한 하네스와 스냅샷 기준. 환각 없는 답변 비율은 Omniscience 답변 중 허위 주장이 없는 비율이며, 정확도는 별도의 점수입니다. 모든 항목에서 높을수록 좋습니다. 표를 읽기 쉽게 하려고 Fable Xhigh는 생략했습니다. 해당 모델의 FrontierCode 2.0 점수는 47.58입니다.
High 추론 수준에서 각 테스트의 선두 모델은 무엇일까요? 아래의 부호 있는 차이는 Carbon에서 Fable을 뺀 값입니다. 표 위의 절대 점수는 그대로 두고, 어느 쪽이 앞서는지 명확히 보여 줍니다.
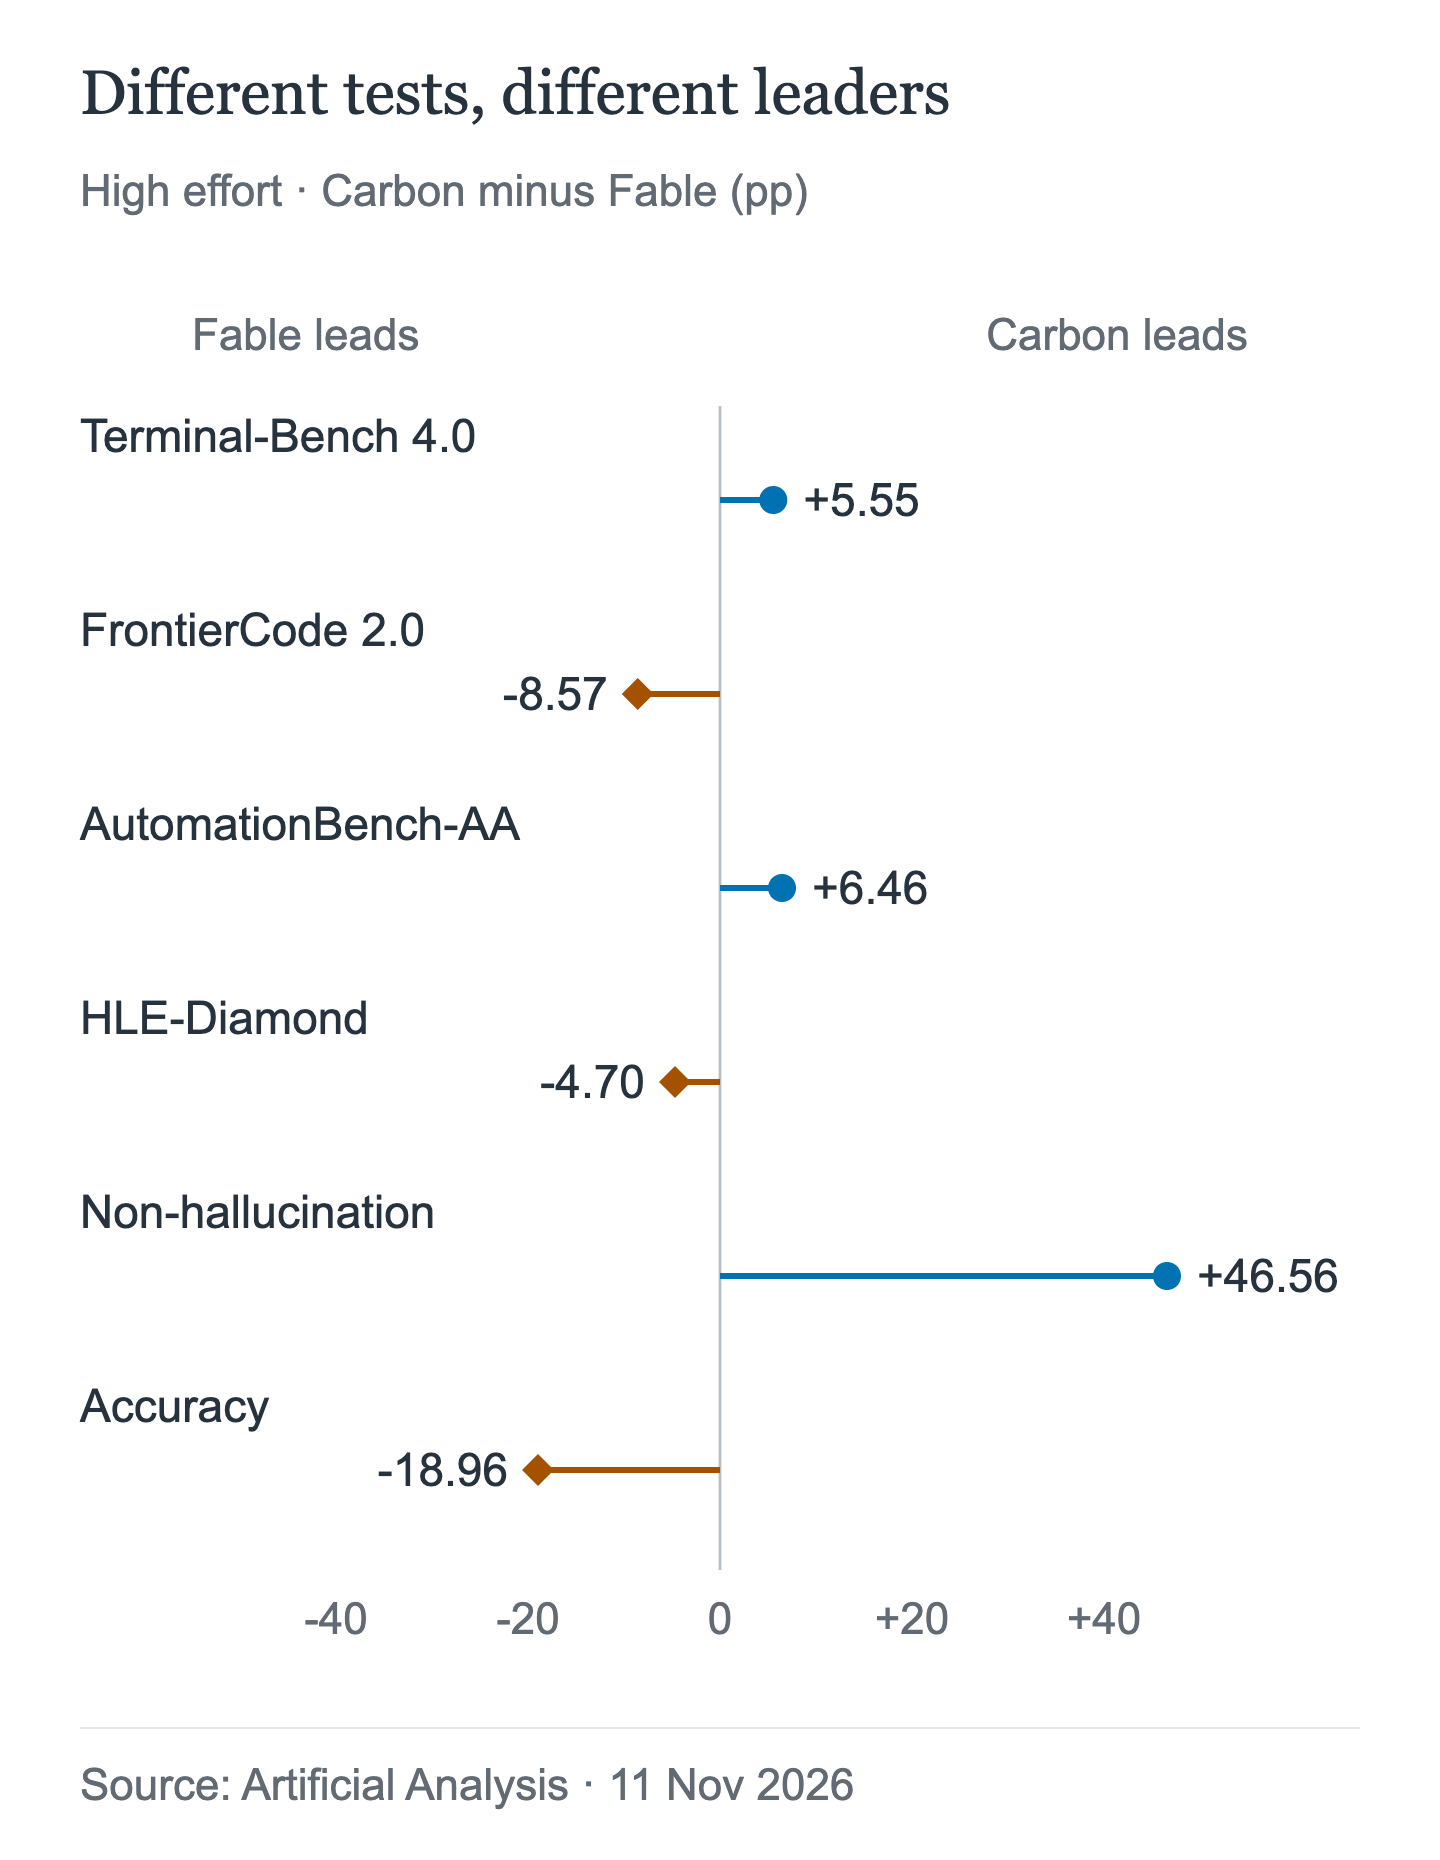
이는 독립적인 테스트에서의 퍼센트포인트 차이이지, 종합 품질 점수가 아닙니다. 한 벤치마크에서 차이가 더 크다고 해서 전반적인 능력이 더 크게 향상됐다는 뜻은 아닙니다. 특히 환각 없는 답변 비율과 정확도는 서로 다른 결과를 측정합니다.
Fable은 High에서 FrontierCode 2.0에서 8.57점, HLE-Diamond에서 4.7점 앞섭니다. Briefcase Elo는 Fable이 1677.4, Carbon이 1610.6입니다. FrontierCode는 까다로운 다중 파일 코드 변경 작업과 가장 가까운 벤치마크입니다. Carbon은 명령줄 실행, 복구, 자동화 성능을 평가하는 Terminal-Bench 4.0에서 5.55점, AutomationBench에서 6.46점 앞섭니다.
환각 없는 답변 비율 격차가 표에서 가장 큽니다. High에서 Carbon은 88.58%, Fable은 42.02%입니다. 정확도는 반대로 Carbon 58.27%, Fable 77.23%입니다. Carbon은 허위 정보를 만들어 낼 가능성은 낮지만 정답을 내놓을 가능성도 낮습니다. API를 지어내면 안 되는 에이전트라면 이 점이 장점일 수 있지만, 정답을 내야 하는 에이전트라면 Fable의 정확도가 더 나은 지표입니다.
추론 수준을 높인다고 항상 더 나은 것은 아닙니다. Fable Max의 FrontierCode 점수는 48.76으로 High의 49.13보다 약간 낮고, Terminal-Bench 점수는 59.6으로 그대로입니다.
Anthropic 자체 표
Anthropic의 출시 페이지에는 Carbon을 포함한 여러 공급자 간 비교 표가 실려 있습니다. 설정은 AA와 다릅니다. Fable은 공개된 가장 높은 추론 수준인 Xhigh로, Carbon은 Medium으로 실행했습니다. 이 표는 표 안에서만 비교해야 합니다.
| 벤치마크 | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
참고: Anthropic 자체 보고 수치. Fable은 사용 가능한 가장 높은 추론 수준인 Xhigh, Carbon은 Medium으로 실행했습니다. Anthropic의 AutomationBench 척도는 AA의 척도와 다르므로(51.4/53.9 대 71.36/77.82), 이 표 안에서 비교하세요. Carbon의 FrontierCode 점수 41.1은 Medium 실행 결과이며, AA의 40.56은 다른 하네스에서 High로 실행한 결과입니다.
전반적인 양상은 AA와 같습니다. Fable은 FrontierCode, FrontierSWE, OSWorld, TB-Science에서 앞서고, Carbon은 AutomationBench에서 2.5점 앞섭니다. AA의 6.5점보다 차이는 작지만 방향은 같습니다. 이 표가 뒷받침하는 결론은 “Carbon은 자동화에서 경쟁력이 있다”이지, “Carbon이 하드 코드에 더 적합한 모델이다”가 아닙니다.
Anthropic 자체 권고를 보면 “Fable이 업그레이드”라는 주장은 한층 복잡해집니다. Anthropic은 “대부분의 코딩 및 지식 작업에서는 Claude Opus 5.5부터 시작할 것을 권장합니다”라고 말합니다. 또한 High 추론 수준에서 Fable은 Opus 5.5의 최고 성능과 거의 같은 점수(45.3% 대 45.5%)를 작업당 비용은 약 절반으로 달성한다고 설명합니다.
토큰 비용
| 모델 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| Carbon, 11월 30일까지 | $2 | $10 | $0.10 |
| Carbon, 12월 1일부터 | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
참고: 토큰 1M개당 USD, 공식 가격. Fable 캐시 쓰기: $10(5분) 또는 $16(1시간), Batch는 50% 할인. Carbon의 캐시 가격은 읽기 요금이며, Opus 5.5의 공식 캐시 읽기 가격은 $0.20입니다.
Fable의 토큰 가격은 Carbon의 표준 요금보다 두 배, 출시 기념 요금보다 네 배 높습니다. 비율은 단순하지만 작업당 청구액은 그렇지 않습니다. AA 측정 결과, Carbon High는 $4/$20 요금으로 작업당 $7.76이었고 Fable High는 $9.08로 17.0% 차이가 났습니다. Google의 $2/$10 요금을 적용하면 같은 사용량은 약 $3.88입니다. 이는 계산에 따른 추정치입니다. 11월 30일까지 Fable High의 작업당 비용은 약 2.3배 높으며, 12월 1일부터는 격차가 다시 17.0%로 돌아갑니다.
표준 가격에서 Fable Medium은 토큰 가격이 두 배 높은데도 Carbon의 $6.59보다 42% 저렴한 $3.80입니다. Carbon은 23.3분 동안 토큰을 더 많이 쓰지만, Fable은 7.8분이 걸립니다. 같은 방식으로 계산하면 출시 기념 요금에서 Carbon Medium은 약 $3.30으로 Fable과 비슷합니다. 이 이점은 12월 1일에 사라집니다.
Max는 Carbon High보다 작업당 비용이 3.4배 높은 $26.54이며, 45.2분이 걸립니다. 더 많이 지출한다고 코딩 에이전트의 성능이 모든 면에서 더 좋아지는 것은 아닙니다. Max의 FrontierCode 점수는 High보다 약간 낮습니다.
AIHubMix는 Carbon을 Google의 출시 기념 가격으로 제공합니다. 여기 제시된 Fable 수치는 Anthropic의 공식 요금 기준입니다.
도입 여부를 좌우하는 동작 차이
| 항목 | Carbon | Fable 5.2 |
|---|---|---|
| 최대 출력 | 65,536; 네이티브 환경에서는 1,048,576−입력 이하* | 128,000 |
| 컨텍스트 | 1,048,576(Google 네이티브) | 1M |
| 사고 | low / medium / high; 기본값 medium | 적응형; 기본값 high |
| 도구 강제 사용 | auto 문서화됨* | any / tool 사용 시 400 반환 |
| 샘플링 | 무시됨; 제거 필요 | 일부 값은 400 반환 |
| 데이터 보존 | 한도로 명시되지 않음 | 30일, ZDR 미지원 |
| 입력 | AIHubMix에서는 텍스트 | 텍스트, 이미지, PDF† |
| 기준 날짜 | 2026년 3월 | 2026년 6월 |
참고: *Carbon의 더 높은 상한은 Google 네이티브 장시간 디코딩 기능입니다. AIHubMix는 현재 텍스트 입력과 Chat Completions만 문서화하고 있어 게이트웨이 지원 여부는 확인되지 않았습니다. †Fable의 입력 모달리티는 AIHubMix 모델 색인 기준입니다. *AIHubMix는 tool_choice="auto"를 문서화했지만 Carbon 전용 지원 여부는 확인되지 않았습니다. Fable의 문서상 모델 출력 한도는 128,000입니다. ZDR은 데이터 무보존을 뜻합니다.
Fable의 도구 강제 사용은 도입을 가로막는 큰 제약입니다. “강제 도구 사용(tool_choice 유형 any 및 tool)은 400 오류를 반환합니다.” 매 차례 특정 도구를 반드시 호출해야 하는 에이전트는 Fable을 변경 없이 사용할 수 없습니다. Google의 Carbon 가이드는 순차적인 도구 실행 턴을 권장합니다. AIHubMix는 Gemini 가이드에서 tool_choice="auto"를 문서화했지만, 게이트웨이의 Carbon 전용 도구 지원은 아직 확인되지 않았습니다.
Fable의 데이터 보존 정책은 도입을 가로막는 제약입니다. 개요에는 “데이터를 30일간 보존해야 하며, Anthropic이 명시적으로 승인하지 않는 한 데이터 무보존 환경에서는 사용할 수 없습니다”라고 나와 있습니다. 여기서 확인한 Carbon 문서에는 이와 같은 제약이 명시되어 있지 않지만, 그렇다고 보장이 되는 것은 아닙니다. 규제 대상 조직은 배포 전에 두 모델의 정책을 모두 확인해야 합니다.
Carbon의 표준 65,536토큰 한도는 대부분의 편집 작업에 충분하지만, 파일 전체를 생성할 때는 한도에 도달할 수 있습니다. Google 네이티브 백그라운드 모드는 입력 토큰 수를 뺀 최대 1,048,576개까지 지원하고, 분할된 단계마다 요금이 부과됩니다. 또한 청구는 계속되면서도 텍스트가 비어 있는 incomplete 응답이 반환될 수 있습니다. AIHubMix는 이 경로를 문서화하지 않았습니다. Fable은 128,000토큰을 한 번의 응답으로 출력합니다.
두 모델 모두 사고 모드를 끌 수 없습니다. Carbon은 low, medium, high를 제공하고 기본값은 medium이며 샘플링 매개변수를 무시합니다. Fable은 “적응형 사고 모드가 항상 켜져 있으며 끌 수 없고”, 기본값은 high입니다. 일부 샘플링 값은 400 오류를 반환합니다.
Google은 GA 이전에 Fairwind 프로그램을 통해 Carbon을 방어 담당자에게 제공했습니다. Fable은 침투 테스트 및 익스플로잇 요청을 차단하는 분류기를 적용하고, 사이버 보안 및 생물학 작업은 다른 모델로 넘깁니다. 보안 테스트에서는 벤치마크 점수보다 거부 동작이 더 중요합니다.
기준 모델로 보는 Opus 5.5
Opus 5.5는 경쟁 모델은 아니지만 Anthropic 자체 기준 모델입니다. 가격은 $4/$20이며 AA 점수는 59.11, 작업당 비용은 $10.04, 소요 시간은 25.0분, 첫 토큰까지 걸리는 시간은 356.4초로 표에서 가장 느립니다(AA 항목은 Max 추론 수준이며 기본값은 medium). Briefcase Elo에서는 1800.6으로 앞서지만, FrontierCode에서는 Fable High에, Terminal-Bench에서는 Carbon High에 뒤집니다. 그럼에도 Anthropic은 대부분의 코딩 작업을 Opus 5.5로 시작할 것을 권장합니다.
어떤 모델을 선택할까
하드 코드 변경 작업이 주를 이루고 측정된 FrontierCode 및 HLE 성능에서 최고를 원한다면 Fable 5.2를 선택하세요. Medium에서 Fable은 Carbon이 $6.59와 23.3분인 데 비해 $3.80과 7.8분으로 더 저렴하고 빠릅니다. 다만 Carbon의 AA 지수가 더 높습니다. 이미지 입력이나 2026년 6월 기준 날짜가 필요하거나, 30일 데이터 보존과 도구 강제 호출 미지원이 허용된다면 Fable을 선택하세요.
터미널 작업이 대부분이라면 Carbon을 선택하세요. 테스트와 수정 반복, 셸 자동화, 여러 단계로 이루어진 작업에 적합합니다. 공개된 Terminal-Bench 4.0 및 AutomationBench-AA 항목에서 더 높은 점수를 기록했고, 11월 30일까지 High 추론 수준의 가격도 더 저렴합니다. Google 기본 컨텍스트와 긴 출력 한도는 AIHubMix를 통해 확인되지 않았으므로, Carbon의 도구 지원을 확인한 뒤 tool_choice="auto"를 사용해 텍스트 전용으로 배포하세요. 환각하지 않는 점수는 더 높지만 정확도는 더 낮습니다.
Anthropic이 권장하는 시작점이자 균형 잡힌 프로필을 원한다면 Opus 5.5를 선택하세요. 단, Max 추론 수준에서는 첫 토큰이 느리게 나온다는 점을 감수해야 합니다.
대화형 지연 시간이 중요하다면 둘 다 선택하지 마세요. High 추론 수준에서 첫 토큰이 Fable은 30.4초, Carbon은 67.1초 걸리며, Carbon의 Medium 추론 수준도 23.2초로 채팅 속도와는 거리가 있습니다.
AIHubMix를 통해 두 모델 모두 사용하기
AIHubMix에서는 두 모델을 하나의 키와 공용 채팅 완성 엔드포인트로 사용할 수 있습니다. Carbon의 ID는 gemini-4-carbon이며, 모델 페이지에는 채팅 완성, 텍스트 입력, Google의 출시 가격이 안내되어 있습니다. Fable 5.2의 ID는 claude-fable-5-2입니다. AIHubMix는 채팅 완성, Responses, Anthropic Messages를 지원하며, 컨텍스트는 1M, 최대 출력은 128K입니다. Carbon에서 문서화된 지원 범위는 더 좁습니다. 네이티브 Gemini API가 아니라 채팅 완성만 지원합니다. 게이트웨이는 다음으로 적합한 공급자를 대상으로 재시도하므로, 단일 공급자 배포와는 동작이 다를 수 있습니다.
빠른 시작에서 인증과 기본 URL을 확인할 수 있습니다. 같은 키로 두 ID가 모두 연결되는지 스모크 테스트를 통해 확인할 수 있습니다. 이 초안 작성 시 실제 테스트는 수행하지 않았습니다.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
이 테스트로 확인할 수 있는 것은 라우팅뿐이며, 기능 지원 여부는 확인할 수 없습니다. 도구도 사용하지 않고 긴 출력도 테스트하지 않습니다. 실제로 비교하려면 동일한 에이전트 추적을 두 ID에 실행하고 작업 시간, 토큰 사용량, 실패를 기록하세요. 비교 페이지에서 컨텍스트, 프로토콜, 가격을 나란히 확인할 수 있습니다.
FAQ
에이전틱 코딩에는 Gemini 4 Carbon과 Fable 5.2 중 어느 쪽이 더 나은가요?
작업의 모든 부분에서 우위를 차지하는 모델은 없습니다. High 추론 수준에서 Fable 5.2는 FrontierCode 2.0과 종합 지수에서 앞서고, Carbon은 Terminal-Bench 4.0과 AutomationBench에서 앞섭니다. 에이전트가 실제로 수행하는 작업에 맞춰 선택하세요.
Fable 5.2는 왜 Carbon보다 4배 비싼가요?
공식 가격 기준으로 Fable은 토큰 100만 개당 $8/$40, Carbon은 출시 기념 가격 $2/$10이므로 입력과 출력 모두 4배 비쌉니다. 12월 1일부터 적용되는 Carbon의 일반 가격 $4/$20과 비교하면 2배입니다.
Fable 5.2가 Medium에서 작업당 비용이 실제로 더 저렴한가요?
일반 가격 기준으로는 그렇습니다. Fable은 $3.80, Carbon Medium은 $6.59이며, 각각 7.8분과 23.3분이 걸립니다. Carbon의 출시 기념 토큰 가격을 적용하면 격차가 줄어들지만, 일반 가격 비교가 지속적으로 적용되는 기준입니다.
Fable 5.2에서 도구 호출을 강제할 수 있나요?
아니요. Anthropic 문서에 따르면 tool_choice 값으로 any와 tool을 사용하면 400 오류가 반환됩니다. 호출을 강제해야 하는 에이전트에는 다른 루프나 다른 모델이 필요합니다.
Carbon은 Fable 5.2보다 환각을 덜 일으키나요?
AA의 Omniscience 비환각 지표에서는 그렇습니다. High 추론 수준에서 Carbon은 88.58%, Fable 5.2는 42.02%입니다. 하지만 Carbon의 정확도는 58.27%로 Fable 5.2의 77.23%보다 낮아, 정답을 제시할 가능성도 더 낮습니다.
두 모델을 하나의 키로 AIHubMix에서 실행할 수 있나요?
네. 같은 키와 기본 URL로 gemini-4-carbon 및 claude-fable-5-2를 사용하면 됩니다. AIHubMix는 Carbon에서 채팅 완성을, Fable에서는 채팅 완성, Responses, Messages를 지원한다고 안내합니다.
더 읽어보기: Gemini 4 Carbon 시리즈
- 다른 모델을 고르기 전에 먼저 같은 시리즈 내 모델부터 비교해 보세요. Gemini 4 Carbon vs Argon: 가격은 같은데, Carbon은 언제 선택할 만할까?
- Carbon을 워크플로에 도입한 뒤 발생하는 첫 400 오류와 타임아웃은 대개 모델이 아니라 설정 문제입니다. Gemini 4 Carbon API 마이그레이션: 400 오류, 타임아웃, 출력 한도
출처
- Gemini 4 Carbon 출시 — Google, 2026년 11월 10일.
- Claude Fable 5.2 — Anthropic, 2026년 11월 9일.
- Claude Fable 5.2 개요 — Anthropic 문서.
- Gemini 4 Carbon 및 Claude Fable 5.2 — Artificial Analysis, 2026년 11월 11일 스냅샷.
- AIHubMix의 Gemini 4 Carbon — 모델 페이지 및 가격.