
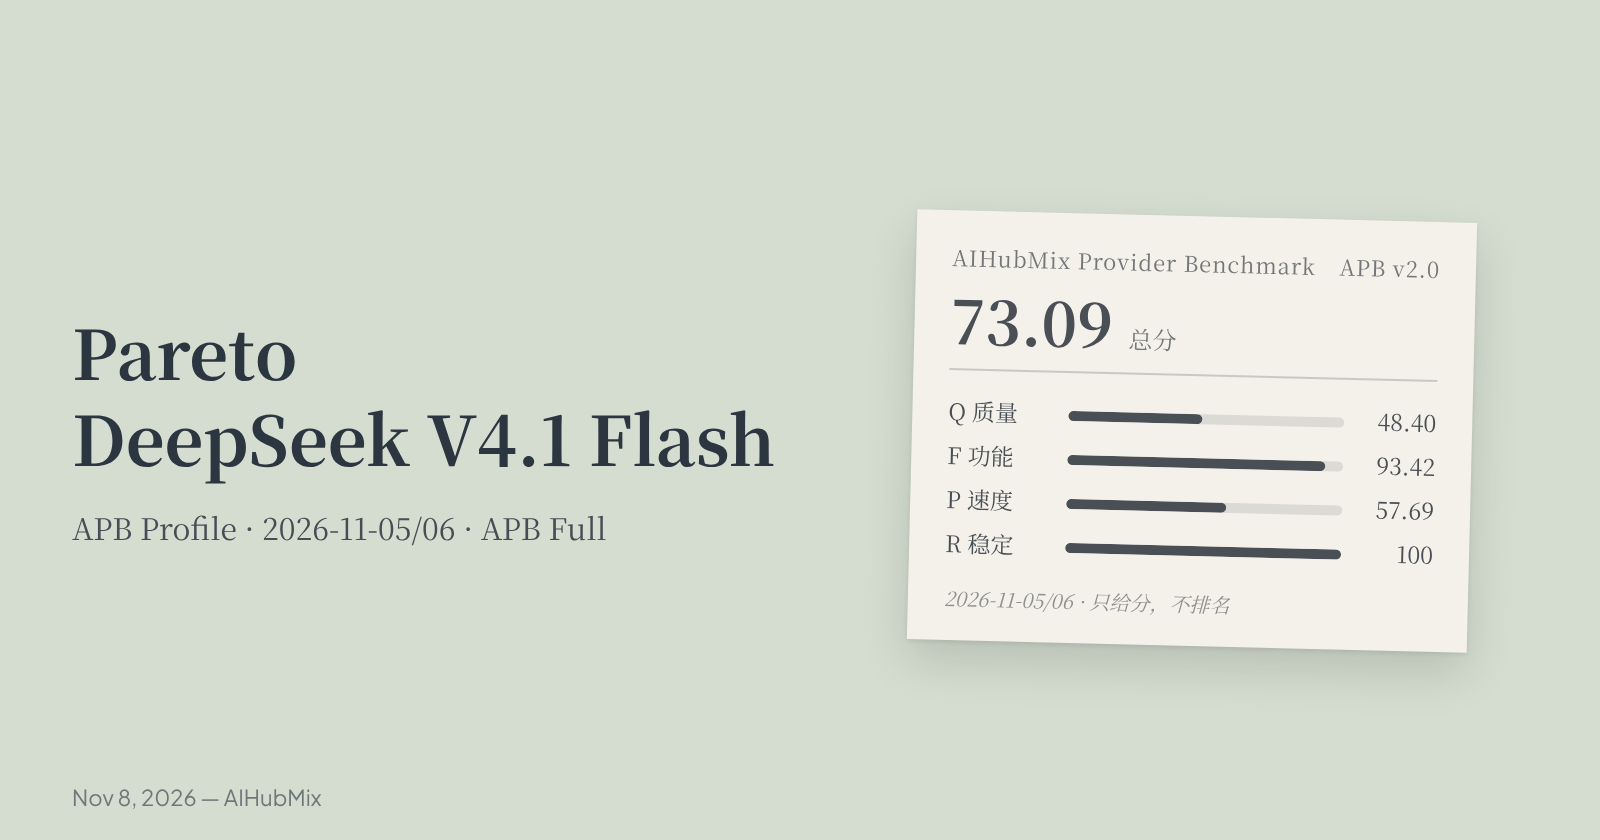
2026-11-05/06에 Pareto에서 DeepSeek V4.1 Flash 1017을 AIHubMix Provider Benchmark (APB) 전체 제품군으로 테스트했습니다. 점수는 Q 48.40, F 93.42, P 57.69, K 27.58, R 100이며, 종합 지수는 73.09입니다. 이 APB 프로필은 Pareto만 다룹니다. 모델은 DeepSeek V4.1 Flash 1017로 등록되어 있습니다.
이 글은 순위나 공급자 추천 없이 점수만 보고합니다. Q, F, P, K, R 점수를 먼저 제시하며, 종합 지수는 신뢰 구간이 없는 요약 수치입니다. 기준은 AIHubMix Provider Benchmark Standard v2.0입니다.
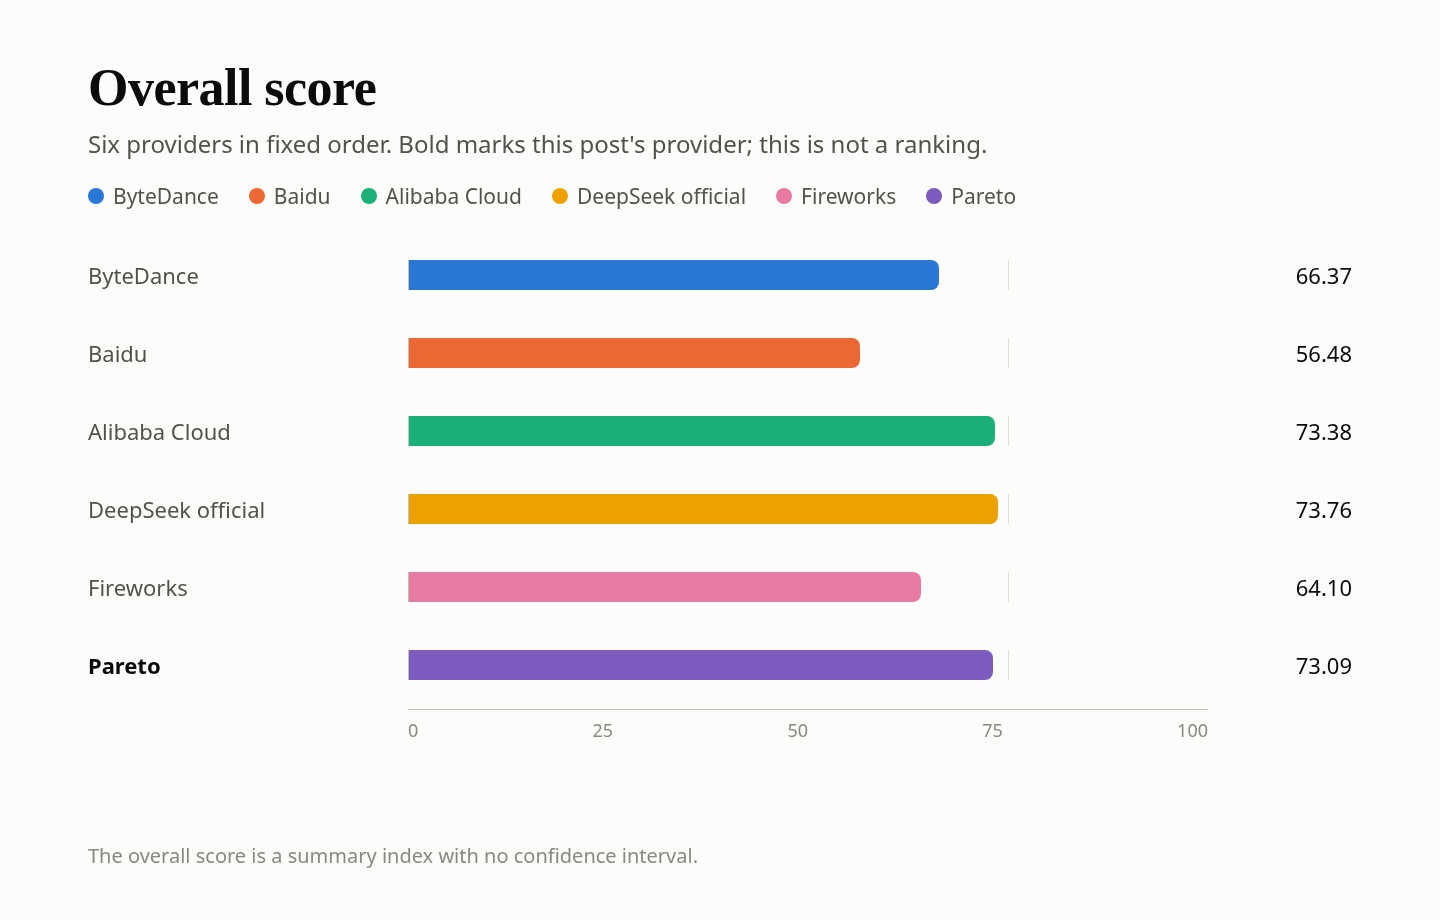
6개 공급자 점수 비교
굵은 글씨는 이 글에서 다루는 공급자를 나타냅니다. 공급자 순서는 고정되어 있으며 순위가 아닙니다. K는 P의 20%를 차지하는 하위 점수입니다. 종합 지수는 신뢰 구간이 없는 요약 수치입니다. DeepSeek 공식 채널과 Alibaba Cloud의 차이는 0.37로, 서로 구분할 수 없습니다.
한눈에 보기
- Q — 답변 품질: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. 공식 채널 대비 +5.94%포인트, 95% 신뢰 구간은 +3.54~+8.36입니다. HLE에서는 서비스 오류가 996건 발생했으며, 대부분 사고 과정이 출력 길이 예산을 소진해 응답이 잘렸습니다. 이 응답은 오답으로 처리했습니다.
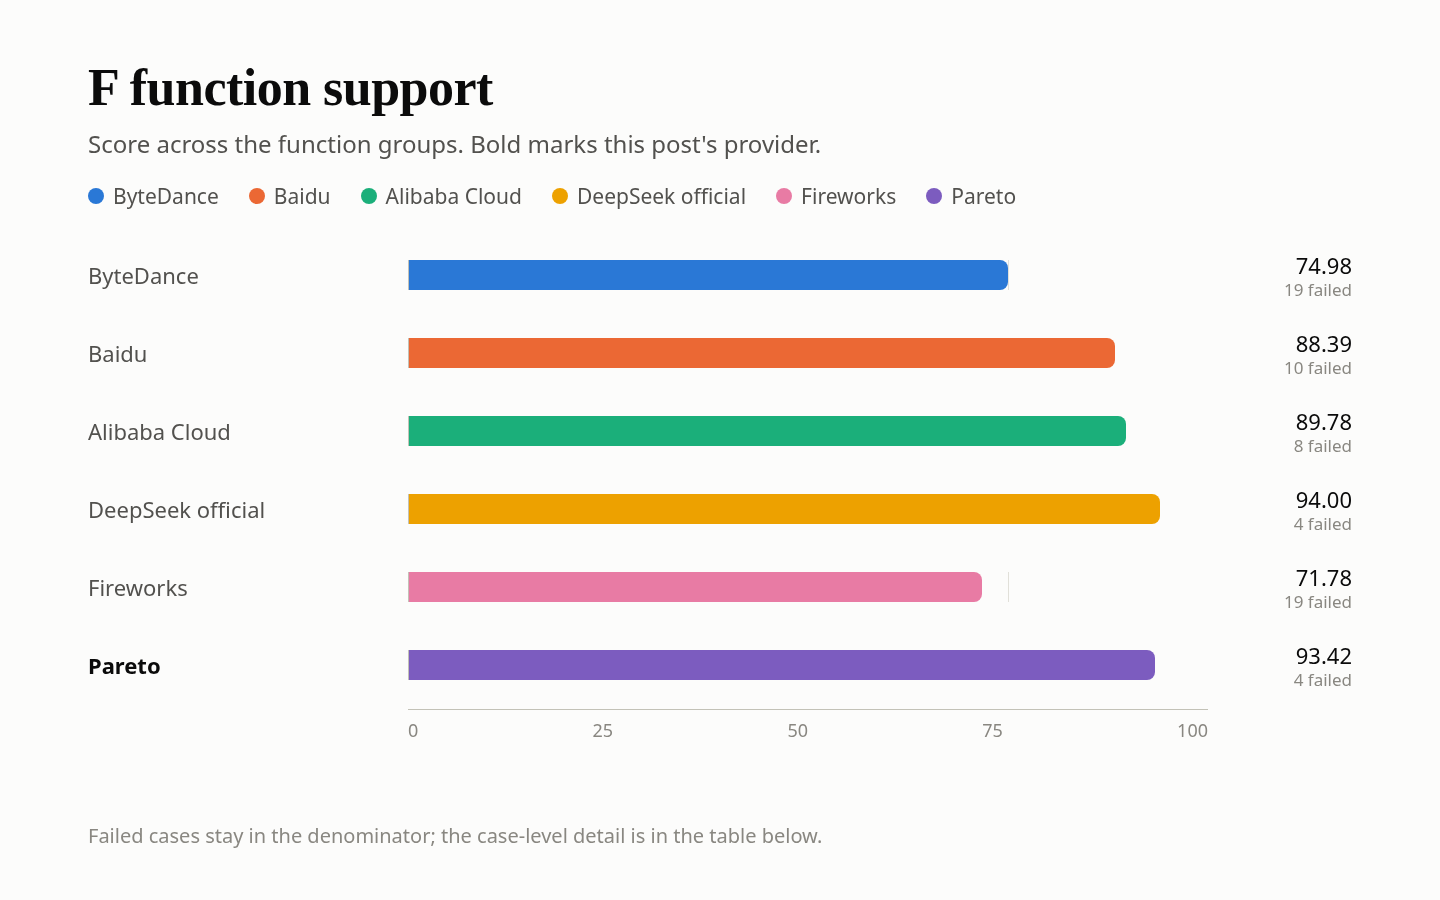
- F — 기능 지원: 93.42. 집계 대상 검사 33개 중 29개를 통과했습니다(스트리밍 23/27, 오류 3/3, 미터링 3/3). 147개 검사는 분모에서 제외했습니다. 실패 4건 중 3건은 stop 시퀀스 요청에서 빈 본문이 반환된 경우였고, 1건은 스트리밍 텍스트 fixture가 정확히 일치하지 않은 경우였습니다.
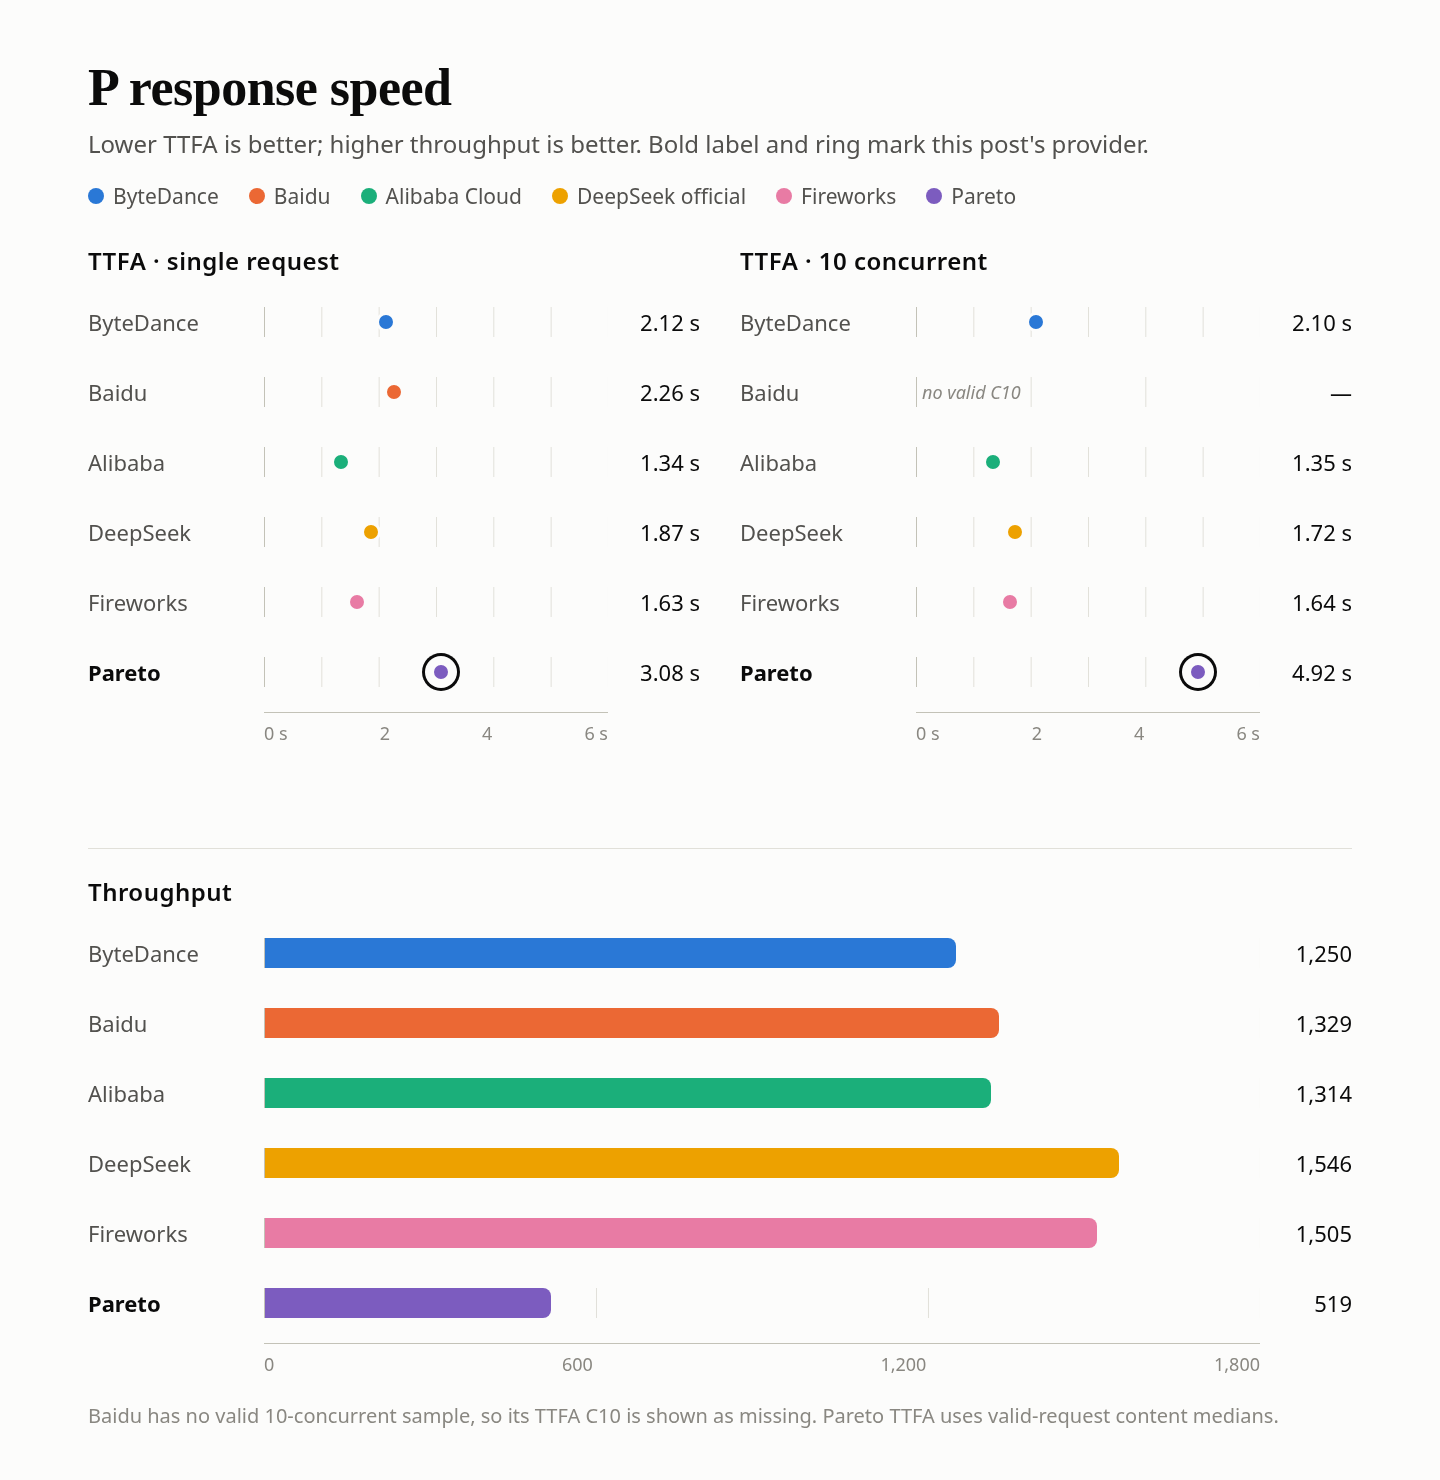
- P — 응답 속도: 57.69. 응답 점수는 65.22이며 캐시 K가 20%를 차지합니다. 유효한 요청의 TTFA 중앙값은 동시 요청 1개에서 3.08초, 10개에서 4.92초였습니다. 무효 요청을 포함한 점수 산정용 중앙값은 각각 5.85초와 6.13초였습니다. 프로브 180개 중 110개가 유효했고, 70개는 사고 과정이 속도 테스트의 출력 예산을 소진해 무효 처리됐습니다.
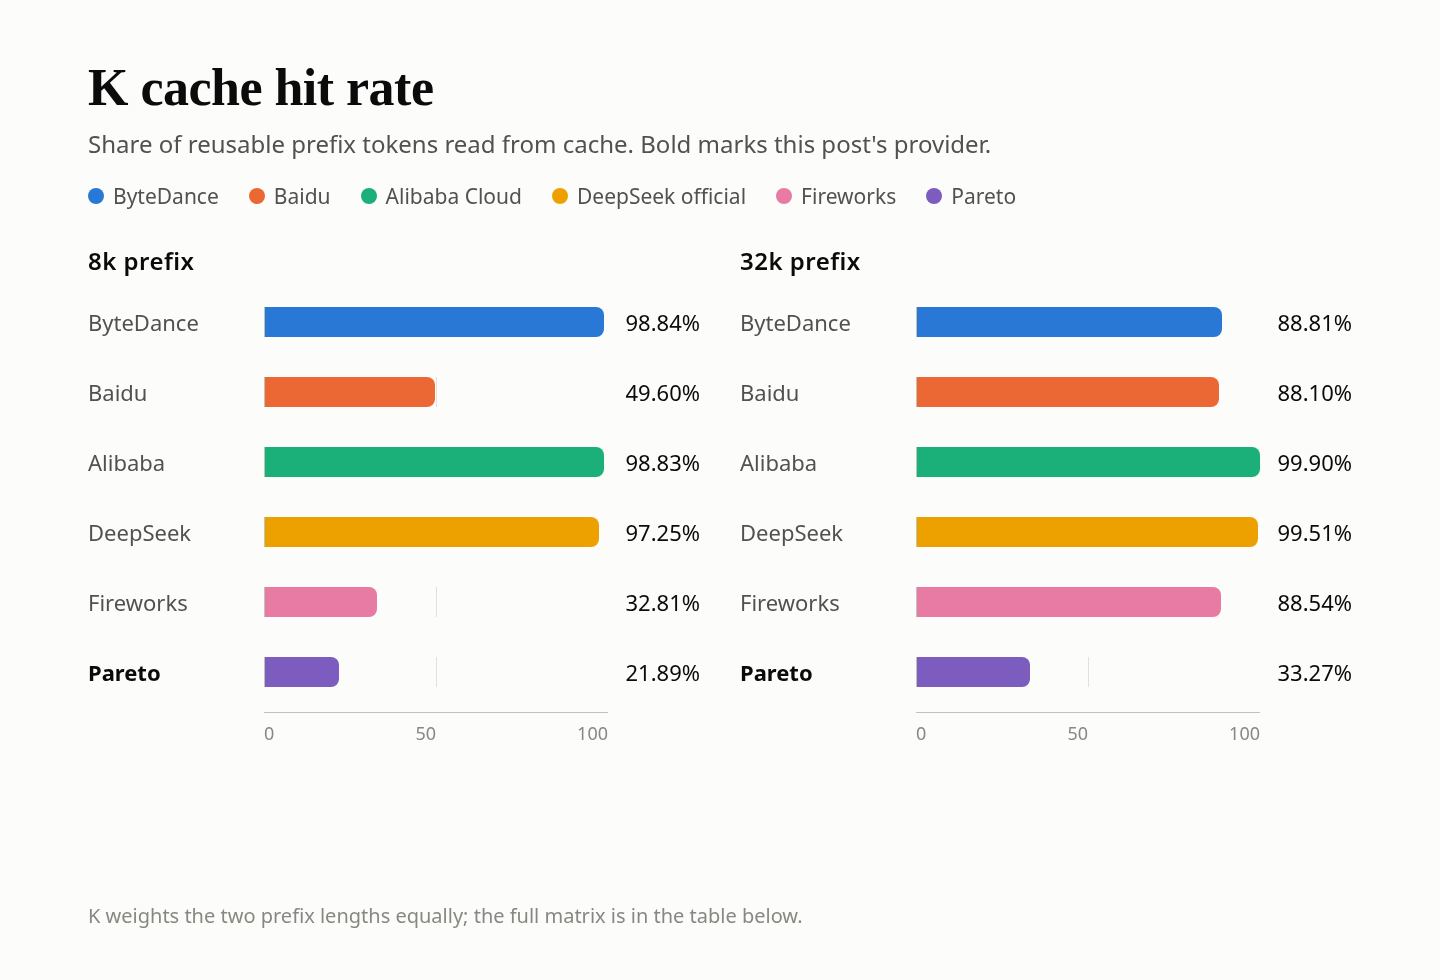
- K — 캐시: 27.58. 8k 핫 캐시 적중 2/9(읽기 15,872 / 재사용 가능 72,504), 32k 핫 캐시 적중 3/9(읽기 96,000 / 재사용 가능 288,513). 기본 구성에서 점수를 산정했습니다.
- R — 서비스 안정성: 100. 전용 요청 300/300건이 첫 시도에 성공했습니다.
테스트 설정
| 항목 | 설정 |
|---|---|
| 모델 | DeepSeek V4.1 Flash 1017 |
| 요청한 모델 ID | deepseek/deepseek-v4.1-flash |
| 접속 경로 | Pareto, 위의 모델 ID 사용 |
| 매개변수 | temperature 1.0, max_tokens 16,384, timeout 300 s; 스트리밍 요청만 사용 |
| 사고 모드 | 높은 강도의 사고 모드 활성화 |
| 시간 | 2026-11-05/06 UTC+8; 캐시는 2026-11-06 기본 구성 재테스트 결과 |
| 샘플 | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| 참고 | 이번 실행에서는 높은 강도의 사고 모드를 사용했고, 시리즈의 나머지 공급자 5곳에서는 사용하지 않았습니다. 기능 지원은 스트리밍이 가능한 항목만 점수에 반영하며, 캐시는 기본 구성을 사용합니다. |
AIHubMix 빠른 시작을 사용해 요청을 보냈습니다. 모델 ID는 모델 페이지에서 확인할 수 있습니다.
Q — 답변 품질: 48.40
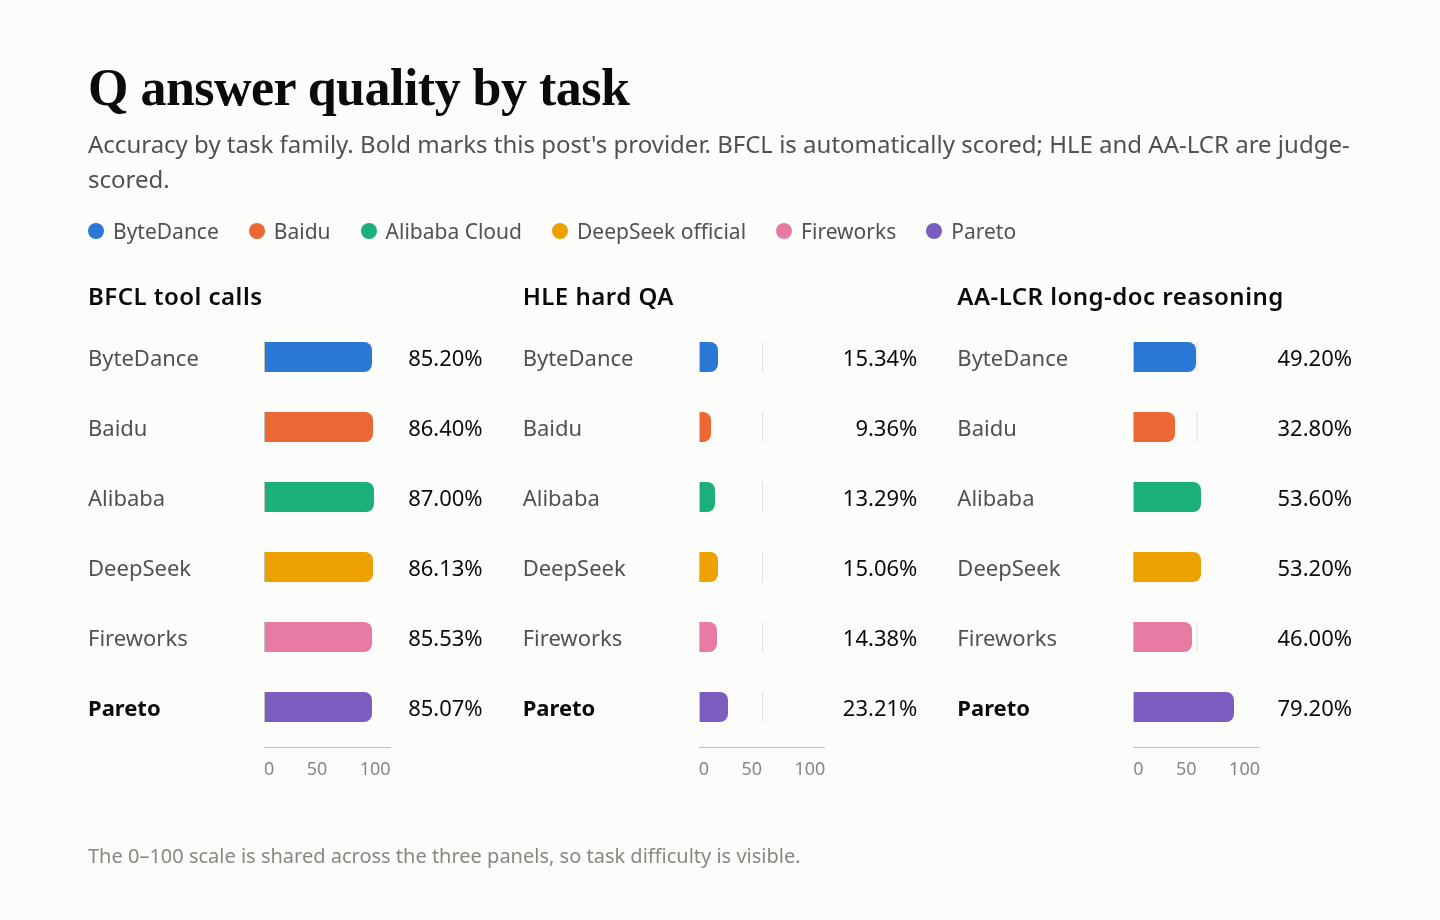
테스트 제품군은 BFCL 질문 500개 × 3회, HLE 250개 × 10회, AA-LCR 25개 × 10회로 구성했습니다. BFCL은 자동 채점했고, HLE와 AA-LCR은 deepseek-flash가 평가했습니다. 세 가지 계열 모두 다른 공급자에 사용한 것과 동일한 항목을 사용했습니다. 점수를 매길 수 없는 답변 10개를 제외해 총 4,240개 사례의 점수를 산정했습니다.
| 작업 | 질문 수 | 정답 | 정확도 | 실패 |
|---|---|---|---|---|
| BFCL 도구 호출 | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE 고난도 QA | 250 × 10 | 578/2,490 | 23.21% | 996 |
| AA-LCR 장문서 추론 | 25 × 10 | 198/250 | 79.20% | 0 |
| 합계 · 95% 신뢰 구간 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
실패는 오답으로 분모에 포함했습니다. HLE에서는 사고 과정이 출력 길이 예산을 소진해 996건의 응답이 잘렸습니다. 완전한 답변을 반환한 HLE 시도 1,494건 중 578건이 정답이었습니다(약 38.7%).
| BFCL 범주 | 통과 | 통과율 |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python은 333/360(92.50%), multiple은 269/300(89.67%), ahm_multi_turn은 102/150(68.00%), irrelevance는 104/150(69.33%)을 통과했습니다.
나머지 5개 공급자와 비교
공식 채널 대비 차이를 %포인트로 표시했으며, 95% 구간은 오차 막대로 나타냈습니다. 구간이 0을 가로지르면 두 값을 구분할 수 없습니다. deepseek-flash 평가자는 같은 계열에 속하며 보정되지 않아 관대하게 평가할 수 있습니다.
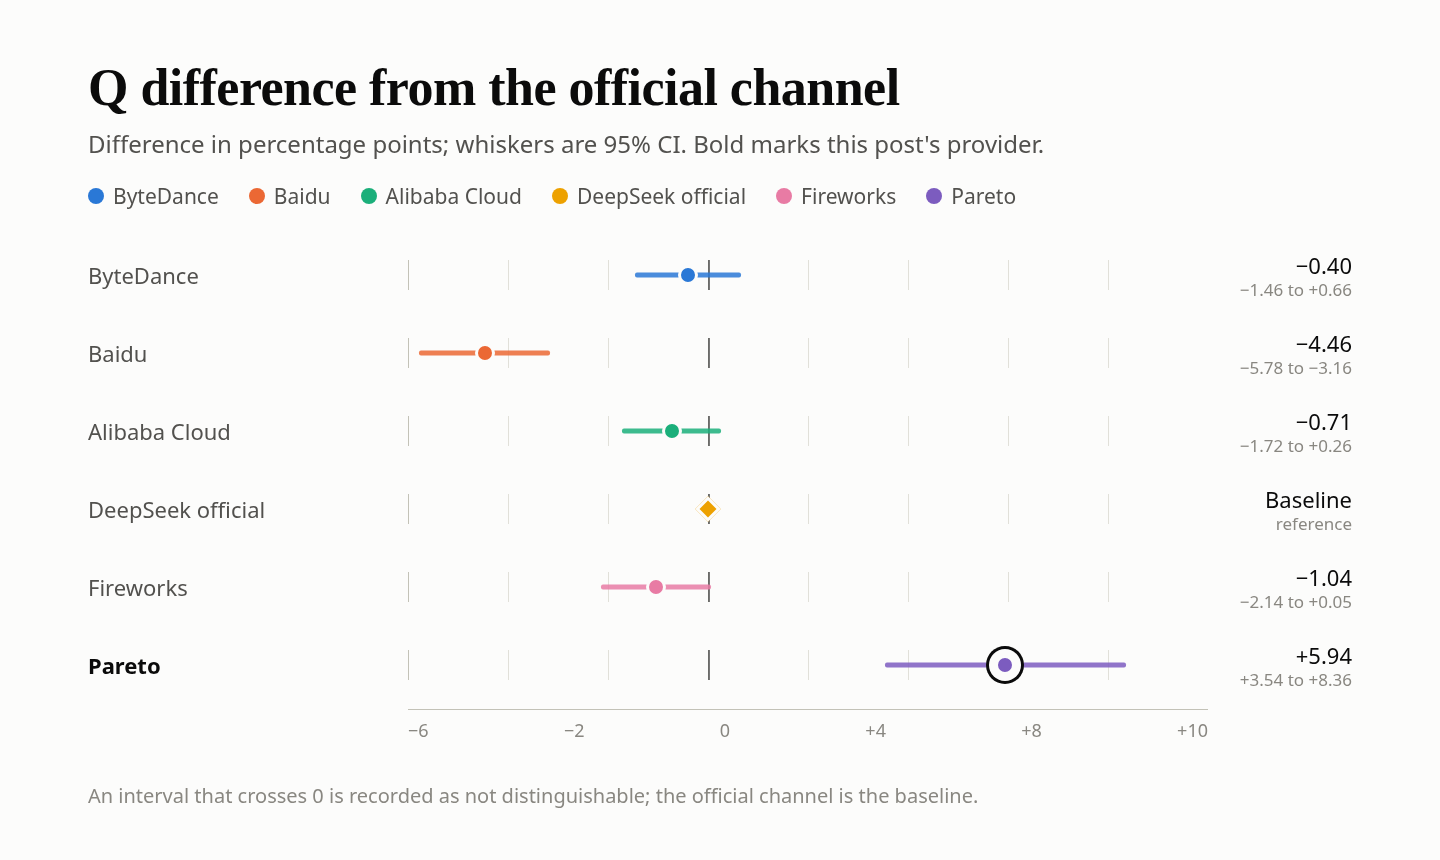
공식 채널 대비 수치상 차이는 +5.94(+3.54~+8.36)입니다.
F — 기능 지원: 93.42
검사 33개 중 29개를 통과했고, 147개는 집계에서 제외했습니다. 93.42점은 관측된 그룹의 원래 그룹 가중치를 재정규화한 값입니다(스트리밍 20%, 오류 15%, 미터링 10%; 합계 45%). 단순 통과율은 29/33, 즉 87.88%입니다. 도구, 제약 조건, 컨텍스트는 전부 집계하지 않았습니다.
| 사례 그룹 | 가중치 | 통과 | 제외 | 그룹 점수 |
|---|---|---|---|---|
| 스트리밍 및 메시징 | 20% | 23/27 | 3 | 85.19 |
| 도구 인터페이스 | 20% | — | 30 | — |
| 출력 제약 조건 | 20% | — | 30 | — |
| 컨텍스트 및 상태 | 15% | — | 30 | — |
| 오류 및 복구 | 15% | 3/3 | 27 | 100.00 |
| 미터링 및 캐시 | 10% | 3/3 | 27 | 100.00 |
| 관측 / 가중 합계 | — | 29/33 | 147 | 93.42 |
“Windows failed”는 해당 사례를 통과하지 못한 윈도우 3개를 집계합니다.
| 실패 사례 | 실패한 윈도우 | 이유 |
|---|---|---|
| 스트리밍 stop | 3/3 | stop 시 빈 본문 |
| 스트리밍 텍스트 | 1/3 | 본문 끝에 fixture와 다른 마침표가 추가됨 |
나머지 5개 공급자와 비교
P — 응답 속도: 57.69
점수 산정에는 첫 번째 토큰이 도착한 시간이 아니라 첫 번째 콘텐츠 토큰까지 걸린 시간을 사용합니다. 사고 모드가 활성화되면 모델이 사용자에게 보이는 답변 텍스트보다 먼저 사고 내용을 생성하므로, 콘텐츠를 기다리는 시간이 첫 패킷을 기다리는 시간보다 길어집니다. 세 번의 윈도우에서 각각 동시 요청 1개로 30건, 동시 요청 10개로 30건씩 보내 총 180건을 요청했습니다.
| 지표 | 결과 |
|---|---|
| 콘텐츠 TTFA | 점수 산정용 중앙값은 5.85초(c=1), 6.13초(c=10)이며, 유효한 요청의 중앙값은 3.08초와 4.92초입니다. |
| 첫 번째 토큰 | 유효한 요청의 중앙값은 1.46초와 1.76초입니다. |
| TPOT | 느린 점수 산정 구간은 4.87 ms/token |
| 굿풋 | 동시 요청 10개에서 519 token/s |
| 유효 요청 | c=1에서 53/90, c=10에서 57/90으로 총 110/180건입니다. 70건은 사고 과정이 속도 테스트 출력 예산(~2,048토큰)을 소진해 무효 처리됐습니다. |
| 구성 요소 | TTFA 24.59, TPOT 100.00, 굿풋 72.05; 응답 점수 65.22 |
| P 구성 | 65.22 × 80% + 27.58 × 20% = 57.69 |
굿풋 분자에서는 사고 토큰을 제외합니다.
K — 캐시: 27.58
2026-11-06 기본 구성 재테스트의 읽기 수를 합산했습니다. 요청별 캐시 행렬은 포함하지 않았습니다(원시 추적 데이터가 마이그레이션되지 않음). K는 두 접두사 길이에 동일한 가중치를 적용하며, P의 20%를 차지합니다.
| 접두사 | 핫 캐시 적중 | 읽기 / 재사용 가능 | 구간 |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (동일 가중치) | 27.58 |
각 길이에서 콜드 컨트롤 6/6을 통과했습니다.
R — 서비스 안정성: 100
동시 요청 1개로 짧은 텍스트, 긴 입력, 도구 호출, 멀티턴 대화를 포함한 요청 300건을 테스트했습니다. 첫 응답의 유효성과 완전성만 확인했으며, 답변은 채점하지 않았고 재시도도 하지 않았습니다. Q 및 P 실패는 여기서 다시 집계하지 않습니다.
| 요청 유형 | 첫 시도 성공 |
|---|---|
| 짧은 텍스트 | 120/120 |
| 10k 장문 입력 | 90/90 |
| 도구 호출 | 60/60 |
| 멀티턴 대화 기록 | 30/30 |
| 합계 · 95% 신뢰 구간 98.78%–100% | 300/300 |
FAQ
Q 48.40에는 무엇이 포함되나요?
점수를 산정한 사례 4,240개에서 BFCL, HLE, AA-LCR을 평가한 결과입니다. 정답은 2,052개, 정확도는 48.40%, 95% 신뢰 구간은 45.39%–51.26%입니다. 공식 채널 대비 수치상 차이는 +5.94(+3.54~+8.36)입니다.
HLE 서비스 오류 996건은 왜 발생했나요?
대부분 사고 과정이 출력 길이 예산을 소진해 응답이 잘렸습니다. 이러한 응답은 오답으로 분모에 포함했습니다.
검사 147개를 제외했는데 F가 93.42인 이유는 무엇인가요?
스트리밍이 가능한 하위 집합만 집계합니다. 관측된 그룹을 기준으로 그룹 가중치를 재정규화하며, 도구, 제약 조건, 컨텍스트는 전부 집계에서 제외합니다.
stop 사례는 왜 실패했나요?
stop 시퀀스가 포함된 요청에서 세 윈도우 모두 빈 본문이 반환됐습니다.
속도 프로브 180개 중 70개가 무효였던 이유는 무엇인가요?
사고 과정이 속도 테스트의 출력 예산(약 2,048토큰)을 소진했습니다.
R 100에는 무엇이 포함되나요?
전용 요청 300건이 모두 첫 시도에 유효했습니다. 95% 신뢰 구간의 하한은 98.78%입니다. Q 및 P 실패는 R에 포함하지 않습니다.
계속 읽기: DeepSeek V4.1 Flash 시리즈
- ByteDance에서는 사고 모드를 끈 뒤에도 사고 토큰이 보고됐습니다: ByteDance의 DeepSeek V4.1 Flash: 도구 호출은 일치하지만 미터링은 불일치
- Baidu의 Q는 38.00, P는 37.77이었습니다: Baidu의 DeepSeek V4.1 Flash: 사용 가능한 채널 중 Q와 P를 모두 충족한 곳 없음
- Alibaba Cloud는 첫 토큰 1.34초, 캐시 99.37을 기록했습니다: Alibaba Cloud의 DeepSeek V4.1 Flash: 첫 토큰 1.34s, 캐시 99.37
- 공식 채널은 Q 기준선이며 F는 94.00입니다: 공식 채널의 DeepSeek V4.1 Flash: F 94.00, 무효 프로브 15개
- Fireworks는 빈 stop 응답을 반환했고 8k에서 캐시 적중은 3/9였습니다: Fireworks의 DeepSeek V4.1 Flash: 빈 stop 응답, 캐시 적중 3/9


