

2026-11-03/04에 DeepSeek V4.1 Flash 1017을 5개 공급자에서 APB Full 제품군으로 테스트했습니다. 모든 테스트는 AIHubMix를 통해 동일한 질문, 매개변수, 요청 스크립트로 진행했습니다. 이 APB 프로필은 Fireworks만 다룹니다. 모델은 DeepSeek V4.1 Flash 1017로 등록되어 있습니다.
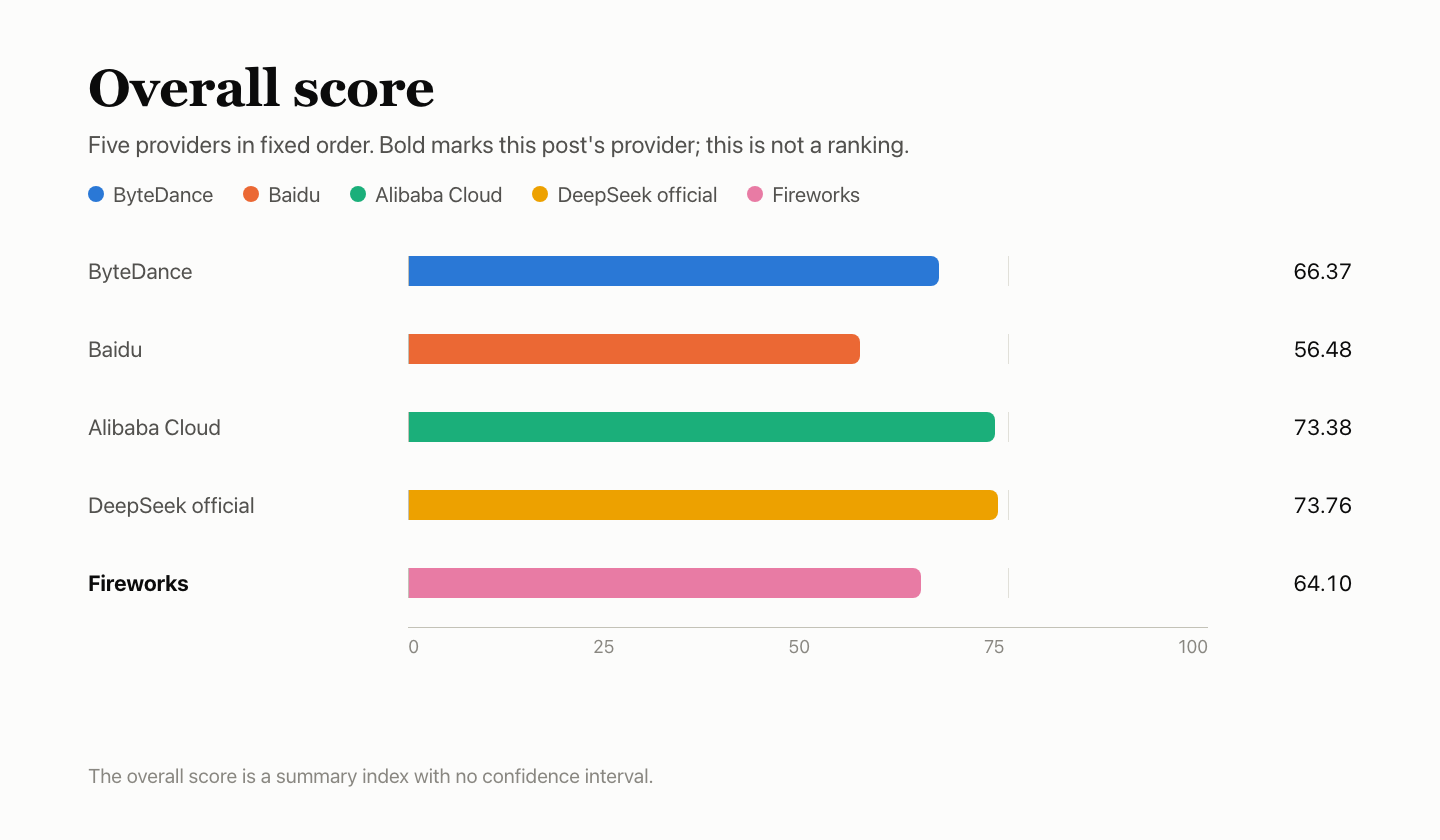
점수는 Q 41.42, F 71.78, P 79.51, K 60.68, R 100이며 종합 지수는 64.10입니다. 이 게시물은 점수만 보고하며 순위나 공급자 추천은 제공하지 않습니다. Q, F, P, K, R을 먼저 제시하며 종합 지수는 신뢰 구간이 없는 요약 수치입니다. 기준은 AIHubMix Provider Benchmark Standard v2.0입니다.
5개 공급자 점수 비교
굵게 표시된 항목은 이 게시물에서 다루는 공급자입니다. 공급자 순서는 고정되어 있으며 순위가 아닙니다. K는 P의 하위 점수로 20%를 차지합니다. 종합 지수는 신뢰 구간이 없는 요약 수치입니다. DeepSeek 공식 채널과 Alibaba Cloud의 차이는 0.37로, 구분할 수 없습니다.
한눈에 보기
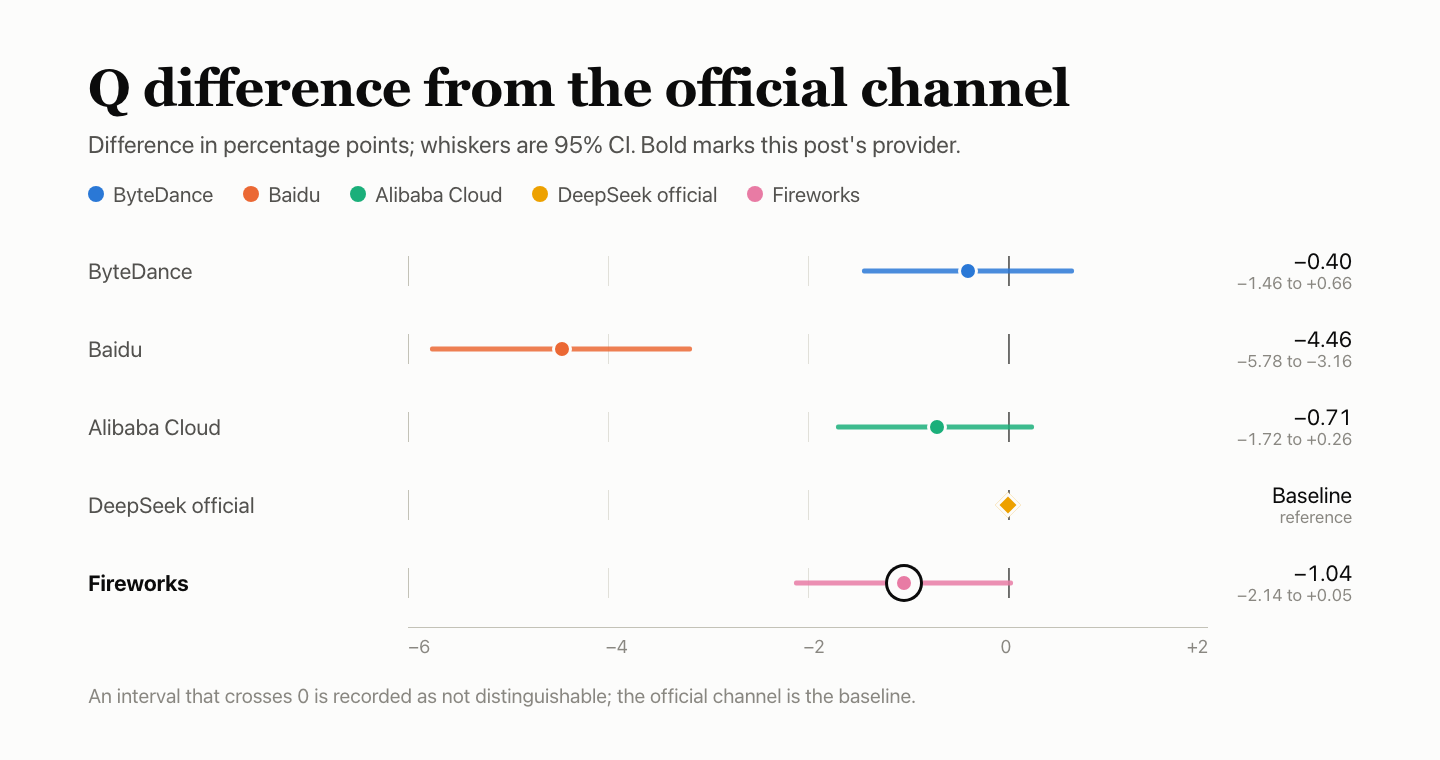
- Q — 답변 품질: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. 공식 채널 대비 −1.04%포인트, 95% 신뢰 구간은 −2.14~+0.05로 구분할 수 없습니다. AA-LCR 실패 34건은 모두 두 번째 윈도우에서 발생했으며 오답으로 계산했습니다.
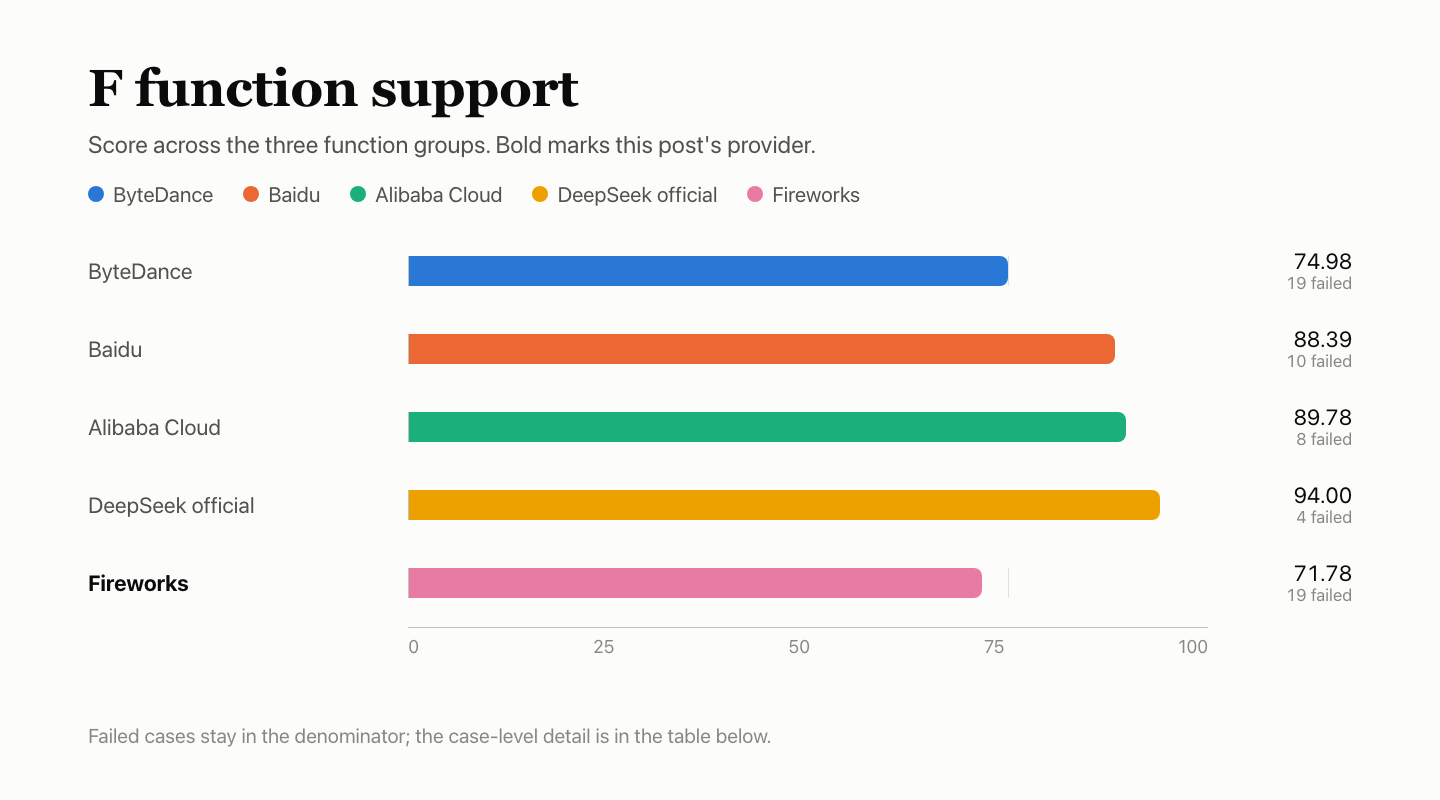
- F — 기능 지원: 71.78. 집계 대상 검사 177건 중 122건을 통과했습니다. stop을 포함한 두 사례 모두 본문이 비어 있었습니다.
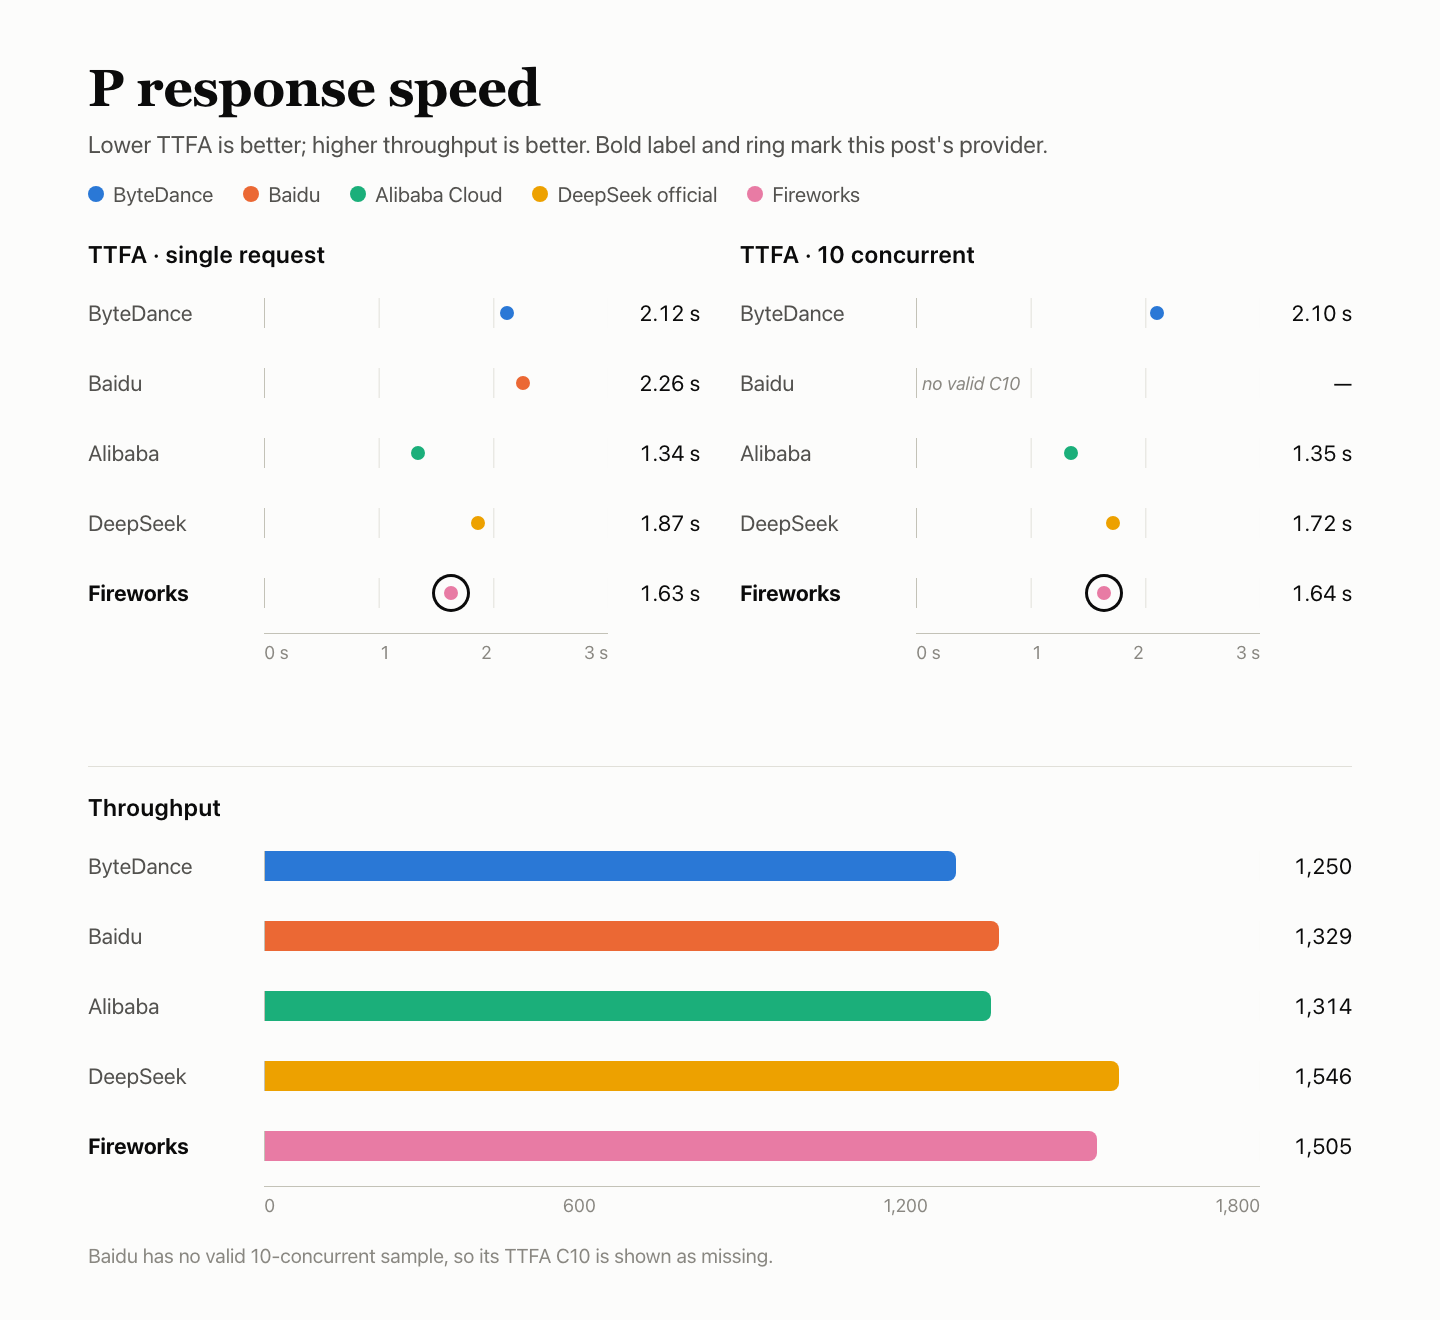
reasoning_effort=none으로 사고 모드가 꺼지지 않았으며, 10k 입력의 토큰 수는 네이티브 집계 10,000개에 대해 10,026개로 보고되었습니다. - P — 응답 속도: 79.51. 응답 점수는 84.22이며, 캐시 K는 20%를 차지합니다. TTFA 중앙값은 단일 요청에서 1.63 s, 동시 요청 10개에서 1.64 s였고, TPOT는 3.29 ms였습니다. 출력 180건 중 1건은 토큰 하나만 반환되어 유효하지 않은 것으로 표시되었습니다.
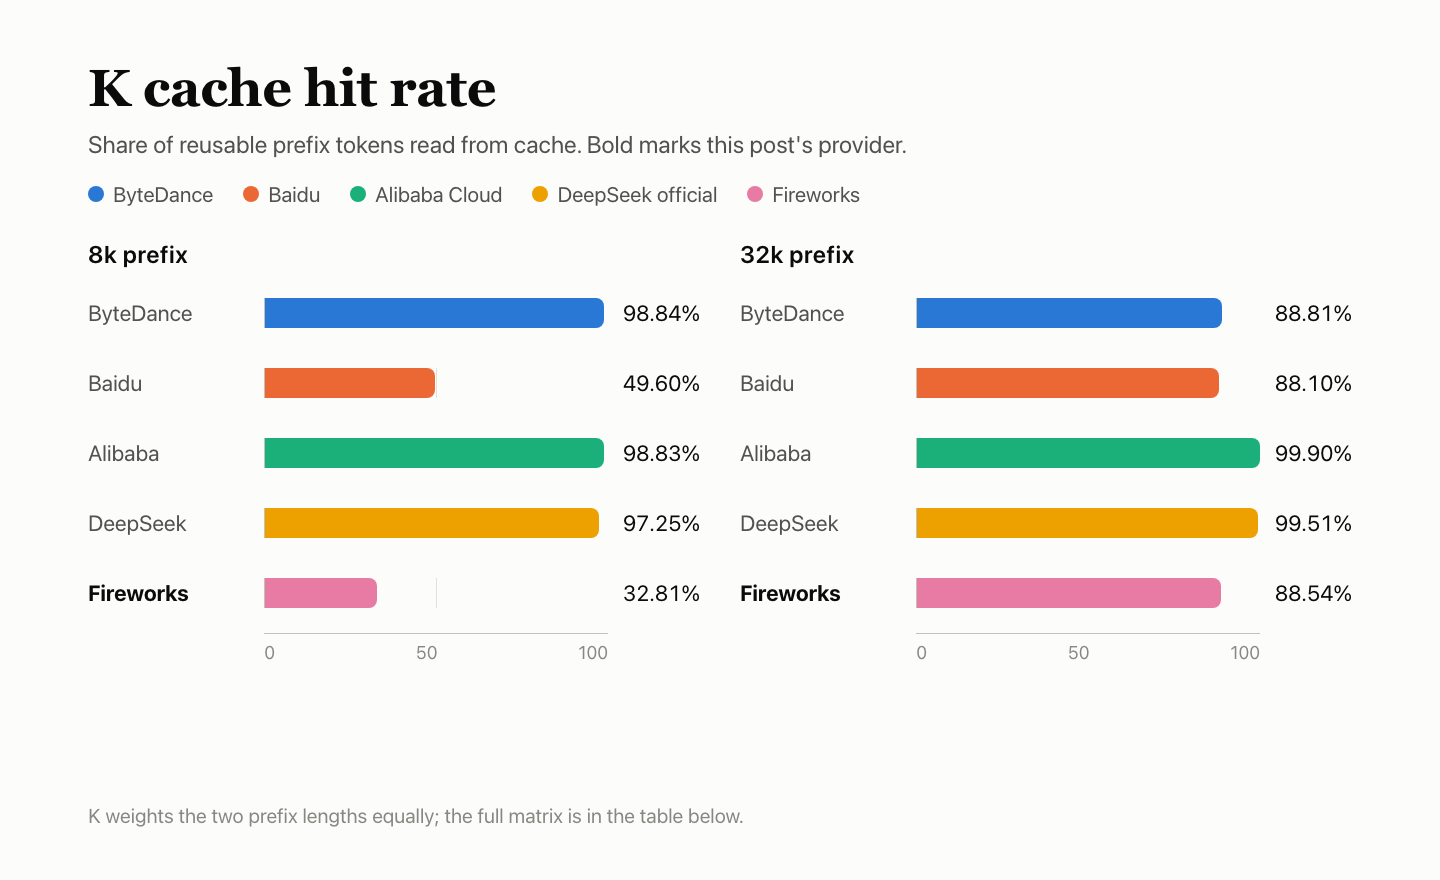
- K — 캐시: 60.68. K 탐침에서는 문서에 명시된 세션 어피니티를 사용했습니다. 32k 핫 캐시는 8/9, 8k 핫 캐시는 3/9였습니다.
- R — 서비스 안정성: 100. 전용 요청 300건 중 300건이 첫 시도에 성공했습니다.
테스트 설정
| 항목 | 설정 |
|---|---|
| 모델 | DeepSeek V4.1 Flash 1017 |
| 요청한 모델 ID | fireworks-deepseek-v4.1-flash-1017 |
| 반환된 모델명 | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| 접속 경로 | 공급자 자체 계정이 아닌 AIHubMix 공급자 모델 ID |
| 매개변수 | 사고 모드 비활성화, temperature 1.0, max_tokens 16,384, timeout 300 s, 재시도 없음 |
| 사고 모드 비활성화 | 네이티브 thinking.type=disabled 사용. reasoning_effort=none은 사고 모드를 끄지 않습니다. 기능 테스트에서는 reasoning_effort=none을 유지했습니다. |
| 시간 | 2026-11-03 18:07 – 11-04 16:33 UTC+8. 5개 공급자 모두 동일한 Mac mini, 네트워크, 계정을 사용했습니다. |
| 샘플 | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| 추가 설정 | K 탐침에는 복제본 어피니티를 위해 문서에 명시된 user 필드와 x-session-affinity 헤더를 포함했습니다. |
요청에는 AIHubMix 빠른 시작 가이드를 사용했습니다. 모델 ID는 모델 페이지에서 확인할 수 있습니다. 사고 모드를 끄기 위해 모델의 API 문서에 명시된 네이티브 thinking.type=disabled를 사용했습니다.
Q — 답변 품질: 41.42
제품군에서는 BFCL 질문 500개를 3라운드, HLE 250개를 10라운드, AA-LCR 25개를 10라운드 실행했습니다. BFCL은 자동 채점했고, HLE와 AA-LCR은 deepseek-flash로 판정했습니다. 5개 공급자 모두 동일한 질문을 받았습니다. 채점할 수 없는 답변 10건을 제외해 채점 대상 인스턴스는 4,240개였습니다.
| 작업 | 질문 수 | 정답 | 정확도 | 실패 |
|---|---|---|---|---|
| BFCL 도구 호출 | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| HLE 고난도 QA | 250 × 10 | 358/2,490 | 14.38% | 5 |
| AA-LCR 장문서 추론 | 25 × 10 | 115/250 | 46.00% | 34 |
| 합계 · 95% 신뢰 구간 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
실패는 오답으로 분모에 포함합니다. BFCL 2건(윈도우 2와 3), HLE 5건(max_tokens에서 잘림), AA-LCR 34건(모두 윈도우 2)이었습니다.
| BFCL 범주 | 통과 | 통과율 |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python은 333/360(92.50%), parallel은 270/300(90.00%), ahm_multi_turn은 95/150(63.33%), irrelevance는 111/150(74.00%)를 통과했습니다.
나머지 4개와 비교
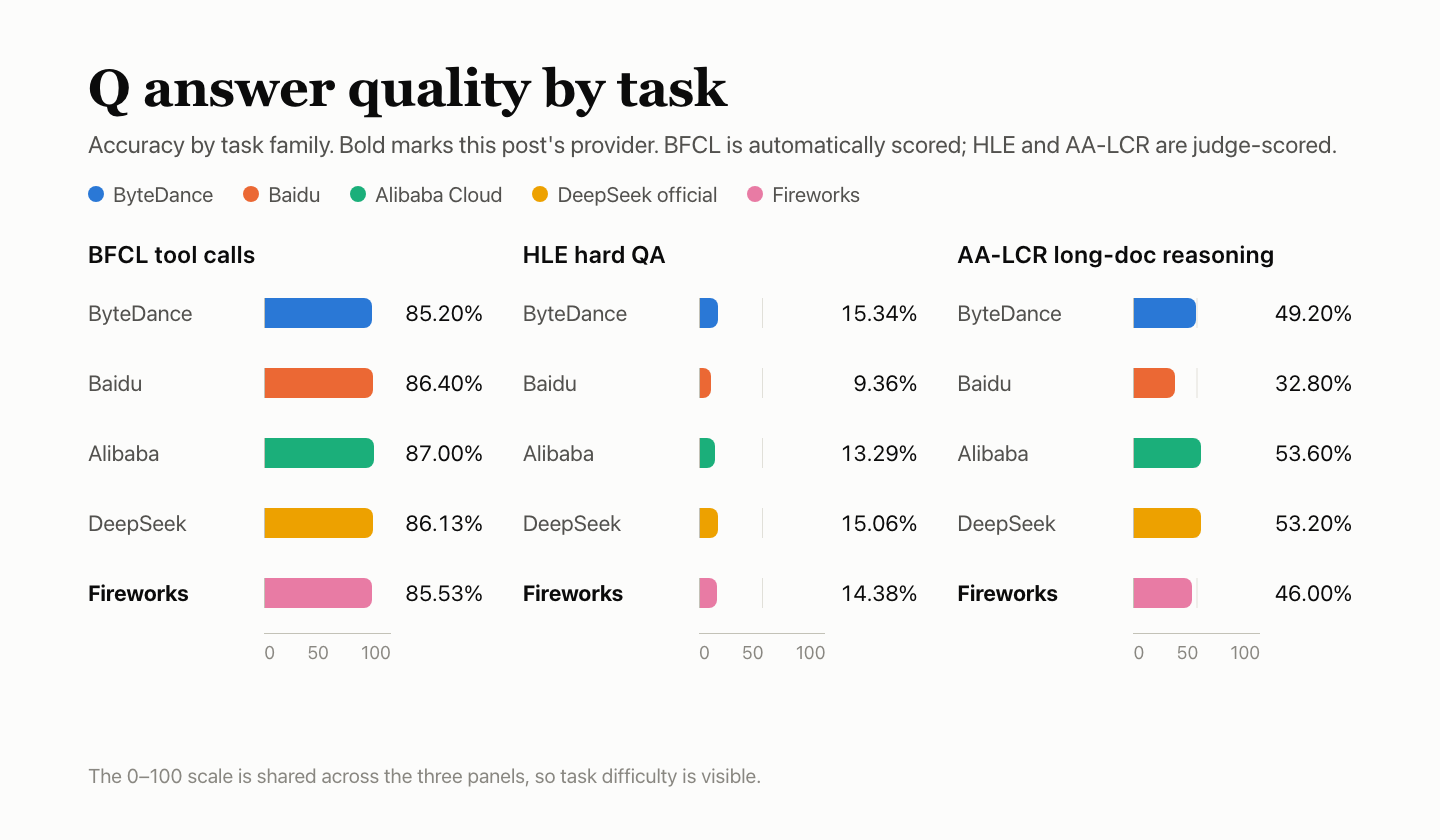
공식 채널 대비 차이를 %포인트로 표시했으며, 95% 구간은 오차 막대로 나타냈습니다. 0을 가로지르면 구분할 수 없습니다. deepseek-flash 판정자는 같은 계열이며 보정되지 않았으므로 관대하게 판정할 수 있습니다.
F — 기능 지원: 71.78
60개 사례는 6개 그룹으로 구성되며, 각 사례는 세 개의 윈도우에서 실행했습니다. 총 180개 검사를 공급자가 문서화한 형식과 대조해 판정했습니다. 해당 없음, 유효하지 않음, 관측되지 않은 검사는 분모에서 제외했습니다. 집계 대상 검사 177건 중 122건을 통과했으며, 그룹별 가중치를 적용한 점수는 71.78입니다.
| 사례 그룹 | 가중치 | 통과 | 제외 | 그룹 점수 |
|---|---|---|---|---|
| 스트리밍 및 메시징 | 20% | 24/30 | — | 80.00 |
| 도구 인터페이스 | 20% | 29/30 | — | 96.67 |
| 출력 제약 조건 | 20% | 21/30 | — | 70.00 |
| 컨텍스트 및 상태 | 15% | 15/30 | — | 50.00 |
| 오류 및 복구 | 15% | 21/30 | — | 70.00 |
| 미터링 및 캐시 | 10% | 12/27 | 3 | 44.44 |
| 합계 · 가중치 적용 | — | 122/177 | 3 | 71.78 |
“실패한 윈도우”는 해당 사례가 통과하지 못한 세 개의 윈도우 수를 뜻합니다.
| 실패한 사례 | 실패한 윈도우 | 이유 |
|---|---|---|
| 스트리밍 중지 | 3/3 | stop이 있으면 본문이 비어 있습니다. stop이 없으면 정상 작동합니다. |
| 본문 내 추론 | 3/3 | reasoning_effort=none인데도 추론이 반환되었습니다. |
| 중지 시퀀스 | 3/3 | stop이 있으면 본문이 비어 있습니다. stop이 없으면 정상 작동합니다. |
| 사고 모드 설정 | 3/3 | reasoning_effort=none인데도 추론이 반환되었습니다. |
| 샘플링 다양성 | 3/3 | Temp 0/1 결과가 지나치게 유사함 |
| 10k 장문 입력 | 3/3 | 10,026개로 보고됨. 네이티브 집계는 10,000개. |
| 컨텍스트 제한 내 | 3/3 | 10,026개로 보고됨. 네이티브 집계는 10,000개. |
| 32k 장문 입력 | 3/3 | 10,026개로 보고됨. 네이티브 집계는 10,000개. |
| 100k 장문 입력 | 3/3 | 10,026개로 보고됨. 네이티브 집계는 10,000개. |
| 컨텍스트 초과 | 3/3 | 매개변수 오류여야 하지만 200을 반환했습니다. |
| 잘못된 메시지 | 3/3 | 400, 빈 본문 |
| 짝이 없는 도구 결과 | 3/3 | 매개변수 오류여야 하지만 200을 반환했습니다. |
| 잘못된 stream_options | 3/3 | 400, 빈 본문 |
| 사고 토큰 미터링 | 3/3 | 비활성화 후에도 사고 토큰이 보고됨. |
| 네이티브 입력 토큰 수 | 3/3 | 34개로 보고됨. 네이티브 집계는 8개. |
| 입력 내 도구 정의 | 3/3 | 도구 없는 대조군도 이미 불일치했습니다. |
| 캐시별 입력 토큰 수 | 3/3 | 반복된 접두부의 토큰 수가 네이티브 집계와 불일치했습니다. |
| 스트리밍 입력 일치 여부 | 3/3 | 34개로 보고됨. 네이티브 집계는 8개 |
| 한 번에 도구 하나만 | 1/3 | 업스트림 500. |
stop을 제외한 동일 입력은 정상 작동했지만, stop을 포함한 두 사례 모두 세 개의 윈도우에서 본문이 비어 있었습니다. 두 사고 모드 사례 모두 reasoning_effort=none인데도 추론이 반환되었습니다.
제외된 검사는 통과나 실패 어느 쪽으로도 집계되지 않습니다.
| 상태 | 사례 | 건수 | 이유 |
|---|---|---|---|
| 해당 없음 | 명시적 cache_control | 3 | 이 인터페이스에서 지원되지 않는 것으로 사전 등록됨 |
messages 및 stream_options가 잘못된 경우 5개 공급자 모두 실패했습니다. 400과 빈 본문이 반환됐고 구조화된 오류는 없었습니다. 공통된 결과를 고려하면 AIHubMix 게이트웨이 계층의 문제일 가능성이 더 높으며, 별도 조사가 필요합니다. 사고 토큰 미터링도 5개 공급자 모두 실패했습니다. 다만 ByteDance와 Fireworks는 비활성화 후에도 사고 토큰을 보고한 반면 나머지 세 공급자는 사고 토큰 수를 반환하지 않았습니다.
나머지 4개와 비교
P — 응답 속도: 79.51
각 요청에는 입력 토큰 약 10,000개가 포함되었고 출력 토큰 약 1,100개를 요청했습니다. 세 개의 윈도우 각각에서 동시성 1로 30건, 동시성 10으로 30건을 전송해 총 180건을 처리했습니다.
| 지표 | 결과 |
|---|---|
| TTFA | 단일 요청 1.63 s, 동시 요청 10개 1.64 s |
| TPOT | 단일 요청 3.24 ms, 동시 요청 10개 3.29 ms |
| 굿풋 | 동시 요청 10개에서 1,504.5 token/s |
| 유효 | 단일 요청 90/90, 동시 요청 10개 89/90(윈도우 3에서 29/30). 출력 하나는 토큰 한 개뿐이었습니다. |
| 구성 요소 | TTFA 54.91, TPOT 100.00, 굿풋 100.00. 가중치는 35/35/30 |
| P 구성 | 84.22 × 80% + 60.68 × 20% = 79.51 |
180건 중 179건이 유효했습니다. 유효하지 않은 요청은 토큰 하나를 반환했으며 중앙값 계산에서 무한대로 처리되므로, 중앙값은 유효한 요청만으로 계산한 값보다 높을 수 있습니다. TPOT는 스트림 청크에서 계산하고, 굿풋은 동시 요청 10개에서 생성한 유효 출력 토큰 수를 배치 처리 시간으로 나눈 값입니다.
동일한 기기, 네트워크, 계정을 사용했으며 윈도우는 공급자별로 일정을 잡았습니다.
K — 캐시: 60.68
각 그룹은 요청 5건으로 구성됩니다. 8k 또는 32k 접두부를 심은 뒤, 마지막 질문만 바꾼 동일 접두부를 5 s, 30 s, 120 s 간격으로 요청하고, 마지막에는 콜드 대조군으로 새 접두부를 요청했습니다. 윈도우 3개 × 길이 2종으로 총 30건입니다. K는 핫 캐시에서 읽은 토큰을 재사용 가능한 토큰으로 나눈 값이며, 두 길이에 동일한 가중치를 적용합니다. K는 P의 20%를 차지합니다.
| 접두부 | 윈도우 | 시드 | +5 s | +30 s | +120 s | 콜드 대조군 |
|---|---|---|---|---|---|---|
| 8k | 윈도우 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | 윈도우 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | 윈도우 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | 윈도우 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | 윈도우 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | 윈도우 3 | 0 | 31,900 | 31,900 | 0 | 0 |
8k 접두사는 핫 요청 9건 중 3건에서 적중해 재사용 가능한 토큰 72,252개 중 23,706개를 읽었으며, K는 32.81이었다. 32k 접두사는 9건 중 8건에서 적중해 288,261개 중 255,212개를 읽었으며, K는 88.54였다. 두 길이에 동일한 가중치를 적용한 K는 60.68이다. 콜드 대조군은 0개를 읽었다. 따라서 같은 설계에서도 두 접두사 길이는 서로 다르게 작동했다. K 테스트에는 문서화된 user 필드와 x-session-affinity 헤더가 포함됐다.
R — 서비스 안정성: 100
3개 윈도우에서 동시 요청 수를 1로 유지하며 짧은 텍스트, 긴 입력, 도구 호출, 멀티턴 대화를 대상으로 요청 300건을 실행했다. 첫 응답의 유효성과 완전성만 확인했으며, 답변을 채점하거나 재시도하지 않았다. Q와 P의 실패는 여기서 다시 집계하지 않는다.
| 요청 유형 | 첫 시도 성공률 |
|---|---|
| 짧은 텍스트 | 120/120 |
| 10k 장문 입력 | 90/90 |
| 도구 호출 | 60/60 |
| 멀티턴 대화 | 30/30 |
| 합계 · 95% 신뢰구간 98.78%–100% | 300/300 |
요청 300건 모두 첫 시도에 유효하고 완전한 응답을 반환했다. 300건 모두 성공했을 때 95% 하한은 98.78%이므로, 데이터로 뒷받침되는 결론은 실패율이 1.22% 미만이라는 것뿐이다. R 100은 이 300건의 요청에 해당하며, 전체 경로를 나타내지는 않는다.
| 공급자 | 첫 시도 성공률 | 95% 구간 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek 공식 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Q 41.42는 무엇을 평가하나요?
BFCL, HLE, AA-LCR의 채점 대상 4,240개 항목에서 정답 1,756개, 41.42%를 기록했고, 95% 신뢰구간은 39.13%–43.59%였다. 공식 채널과의 차이는 통계적으로 구별되지 않는다.
두 stop 사례는 왜 모두 실패했나요?
stop이 포함된 요청은 세 윈도우 모두에서 빈 본문을 반환했지만, 같은 입력에서 stop을 제외하면 정상 작동했다. 스트리밍과 비스트리밍 사례 모두에서 확인됐다.
reasoning_effort=none을 설정하면 사고 모드가 꺼지나요?
아니요. 세 윈도우 모두에서 추론 콘텐츠가 반환됐다. 다른 요청에는 기본 제공되는 thinking.type=disabled를 사용했다.
10k 입력이 왜 토큰 10,026개로 보고되나요?
10k 사례에서는 기본값 10,000에 대해 10,026개로 보고됐다. 32k와 100k 사례에서도 동일하게 10,026개로 보고됐으며, 도구를 사용하지 않은 대조군에서도 이미 불일치가 나타났다.
8k는 왜 3/9, 32k는 왜 8/9 적중했나요?
두 사례 모두 같은 설계와 문서화된 어피니티 설정을 사용했다. 차이는 서버가 보고한 읽기 횟수에 있다. 8k는 윈도우 1과 2에서, 32k는 세 윈도우 모두에서 적중했다.
R 100은 무엇을 평가하나요?
전용 요청 300건을 평가했으며, 모두 첫 시도에 유효했다. 95% 하한은 98.78%다. Q와 P의 실패는 R에 포함하지 않는다.
계속 읽기: DeepSeek V4.1 Flash 시리즈
- Fireworks에서와 마찬가지로 ByteDance에서도 사고 모드를 비활성화한 뒤 사고 토큰이 보고됐다: ByteDance의 DeepSeek V4.1 Flash: 도구 호출은 일치하지만 미터링은 불일치
- Baidu는 Q 38.00, P 37.77을 기록했다: Baidu의 DeepSeek V4.1 Flash: 사용 가능한 채널 중 Q와 P를 모두 충족한 곳은 없음
- Alibaba Cloud는 첫 토큰까지 1.34초, 캐시 99.37을 기록했다: Alibaba Cloud의 DeepSeek V4.1 Flash: 첫 토큰 1.34s, 캐시 99.37
- 공식 채널은 Q의 기준선이며 F 94.00을 기록했다: 공식 채널의 DeepSeek V4.1 Flash: F 94.00, 유효하지 않은 테스트 15건


