

2026-11-03/04, DeepSeek V4.1 Flash 1017을 AIHubMix를 통해 5개 공급자에서 APB Full 제품군으로 테스트했습니다. 매번 동일한 질문, 매개변수, 요청 스크립트를 사용했습니다. 이 APB 프로필은 Baidu 테스트만 섹션별로 다룹니다.
아래 수치는 점수일 뿐, 순위나 공급자 추천이 아닙니다. Q 38.00, F 88.39, P 37.77, K 68.85, R 100이 먼저 제시되며, 종합 점수 56.48은 신뢰 구간이 없는 요약 지수입니다. 점수 산정 규칙은 AIHubMix Provider Benchmark Standard v2.0을 따릅니다.
5개 공급자 점수 비교
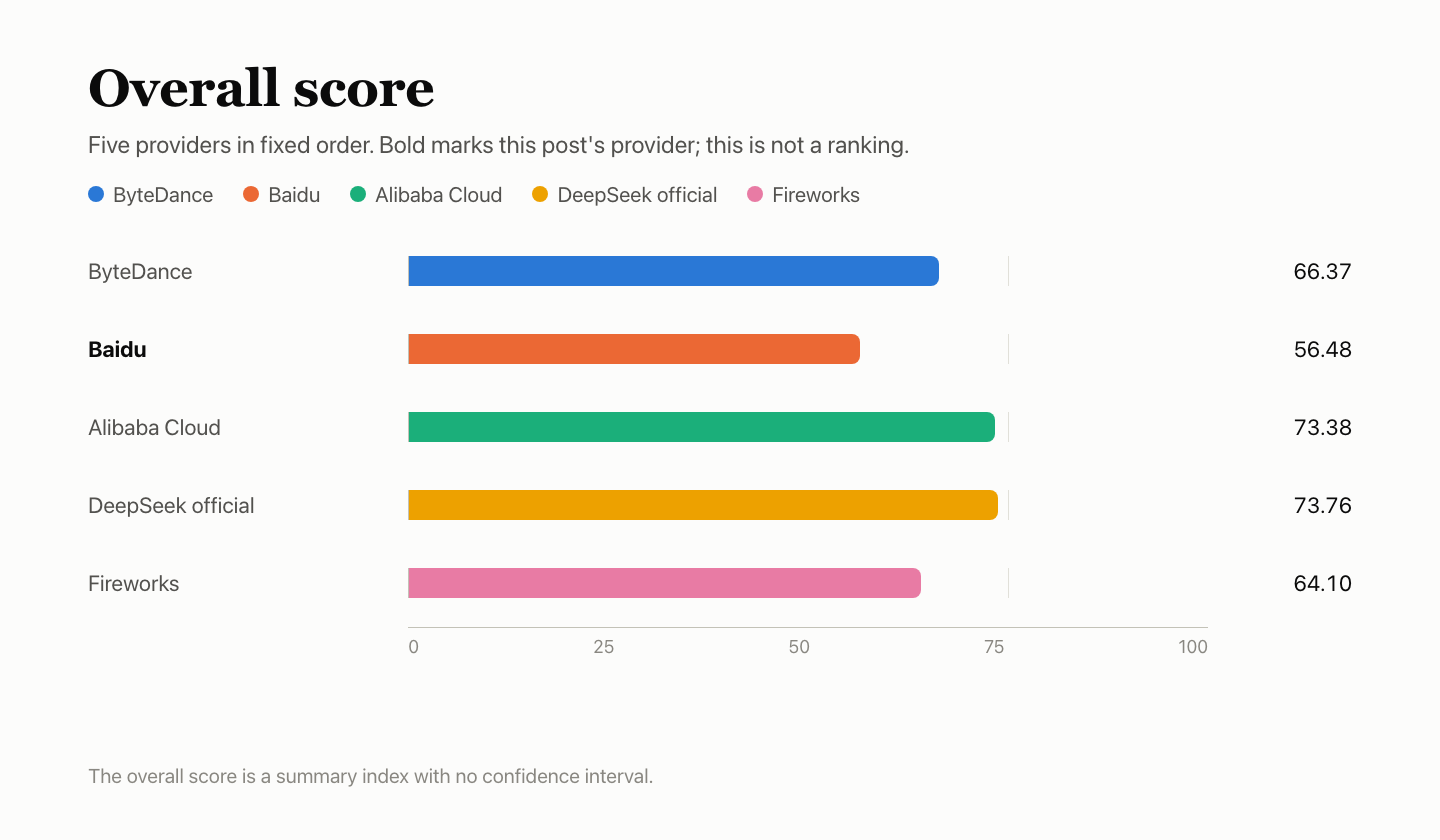
굵은 글씨는 이 게시물에서 다루는 공급자를 나타냅니다. 공급자는 순위가 아닌 고정된 순서로 나열했습니다. K는 P의 하위 점수로, 비중은 20%입니다. 종합 점수는 신뢰 구간이 없는 요약 지수입니다. 공식 채널과 Alibaba Cloud의 차이는 0.37로, 구분할 수 없는 차이입니다.
한눈에 보기
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%입니다. 종합 결과는 공식 채널보다 4.46포인트 낮으며, 95% 구간은 −5.78~−3.16으로 0을 포함하지 않습니다. HLE에서 요청 실패 864건, AA-LCR에서 100건이 발생했으며, 거의 모두 첫 번째 윈도우에 발생해 오답으로 계산됐습니다.
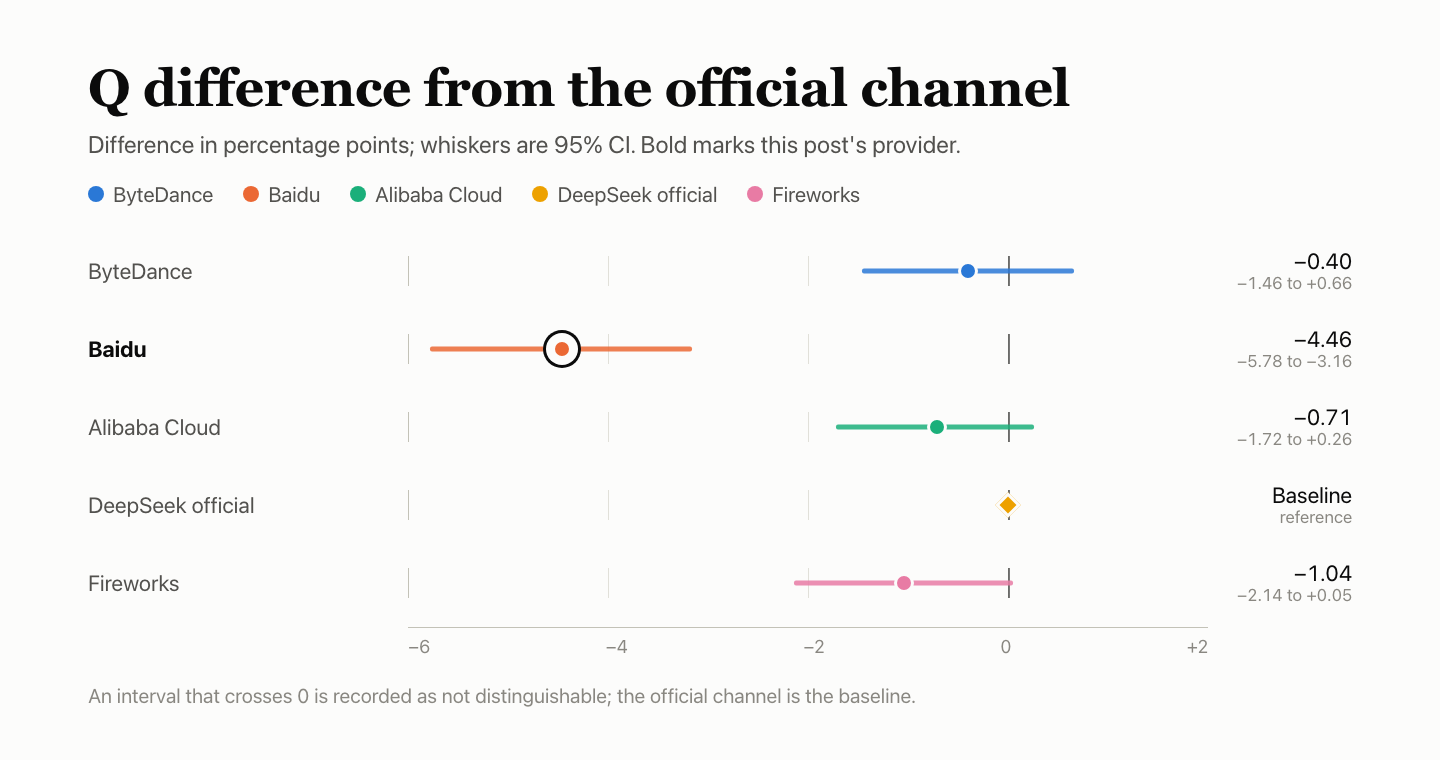
- F: 88.39. 집계 대상 검사 174건 중 148건을 통과했습니다. 캐시 읽기 필드와 사고 토큰 수는 반환되지 않았고, 컨텍스트 초과 및 고아 도구 결과 사례는 200을 반환했습니다.
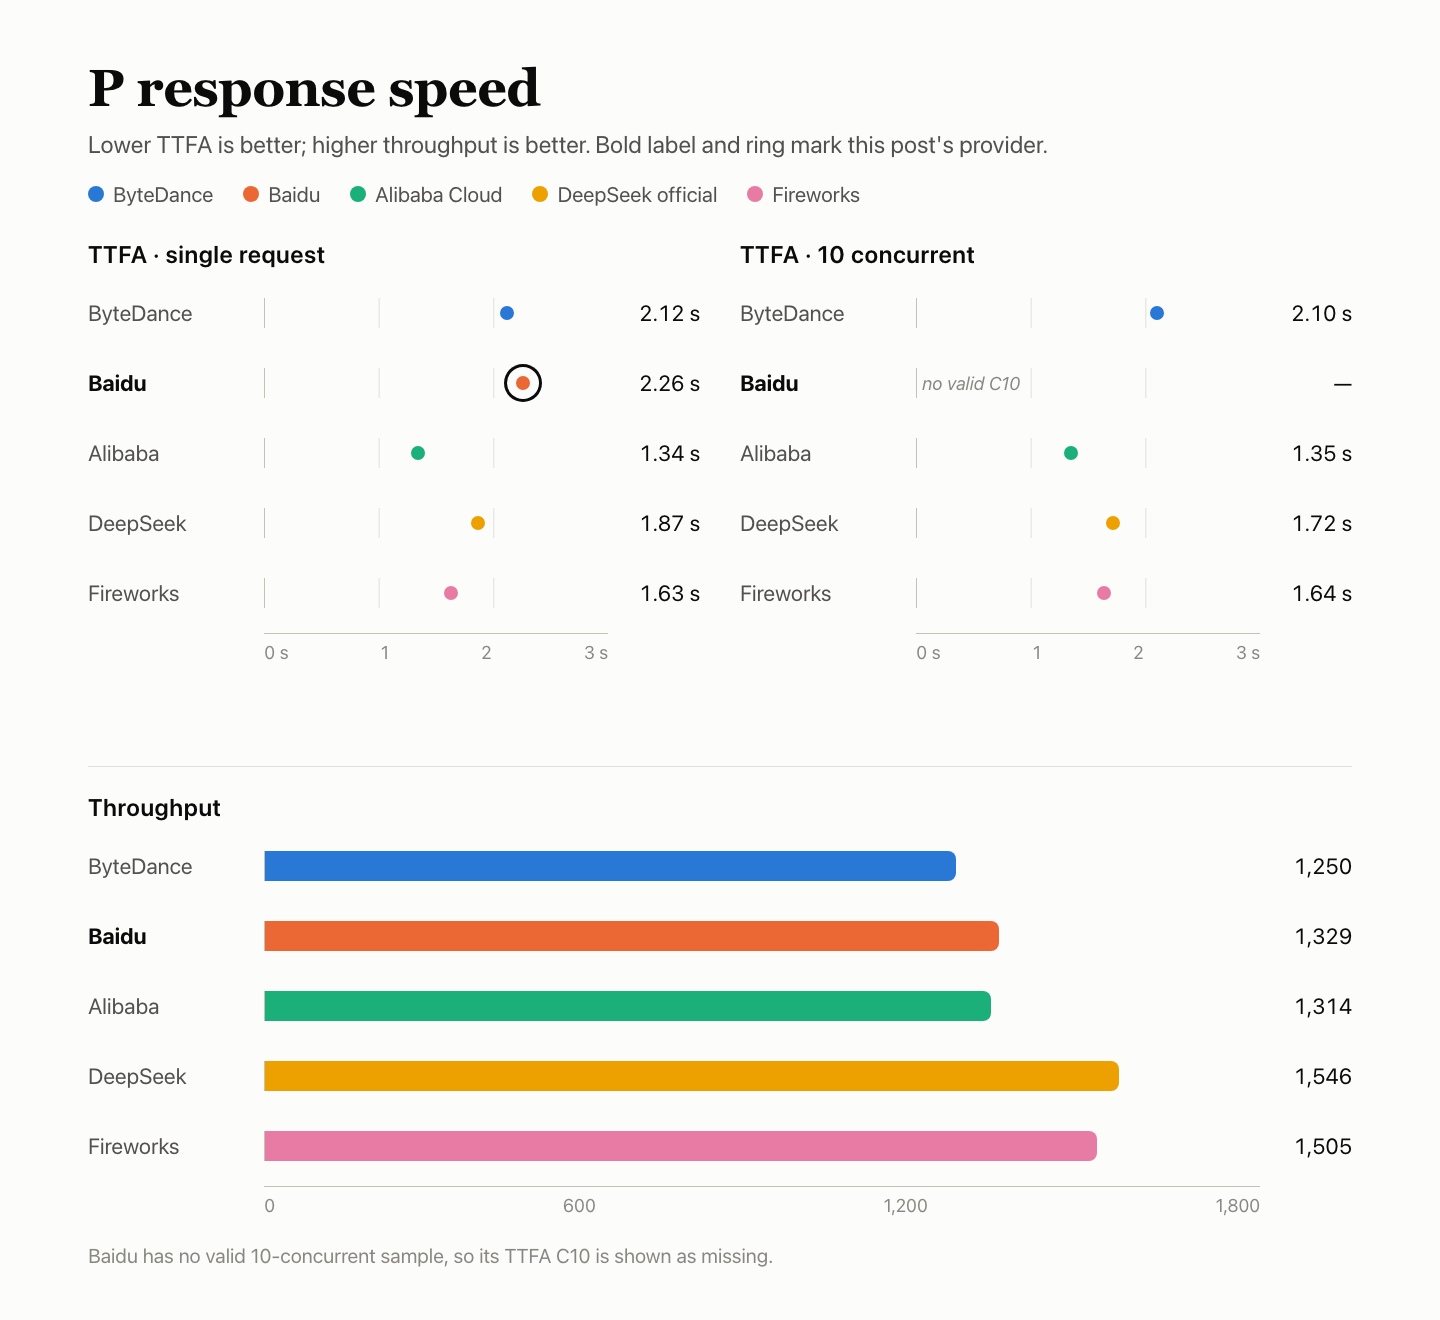
- P: 37.77. 동시 요청 10건 테스트 90회 중 50회에서
no_available_channel이 반환되어 절반이 넘는 테스트가 유효하지 않았고, TTFA와 TPOT는 페널티 값으로 채점됐습니다. 단일 동시성 테스트는 90회 중 78회가 유효했습니다. - K: 68.85. 8k 핫 요청은 9회 중 5회 캐시 적중했고, 요청 실패가 3건 발생했습니다. 32k 프리픽스는 9회 중 8회 캐시 적중했습니다. 적중량은 1,024토큰 단위로 보고됩니다. 8k는 7,168토큰, 32k는 31,744토큰입니다.
- R: 100. 전용 요청 300건이 모두 첫 시도에 성공했습니다. 답변 생성 및 속도 테스트 중의 채널 오류는 Q와 P에 반영됩니다.
테스트 설정
요청은 공급자별 ID를 사용해 AIHubMix 빠른 시작 경로로 전송했으며, 매개변수는 DeepSeek의 API 문서를 따랐습니다. 다른 공급자 ID는 모델 페이지에 나와 있습니다. Baidu 자체 계정에 직접 연결한 테스트가 아닙니다.
| 항목 | 값 |
|---|---|
| 모델 | DeepSeek V4.1 Flash 1017 |
| 요청한 모델 ID | baidu-deepseek-v4.1-flash-1017 |
| 반환된 모델 이름 | deepseek-v4.1-flash-1017 |
| 접속 경로 | 공급자별 모델 ID로 AIHubMix를 통해 접속. 공급자 자체 계정에 직접 연결한 것이 아님 |
| 매개변수 | 비사고 모드, temperature 1.0, max_tokens 16,384, 타임아웃 300 s, 자동 재시도 없음 |
| 사고 모드 끔 | 모든 요청에 reasoning_effort=none 사용 |
| 시간 | 2026-11-03 18:07 – 11-04 16:33 UTC+8. 5개 공급자는 모두 동일한 Mac mini, 네트워크, 계정을 사용했습니다. |
| 샘플 | 답변 시도 4,250건(BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10), 함수 사례 60개 × 3개 윈도우, 단일 동시성 속도 테스트 90회 및 동시 요청 10건 속도 테스트 90회, 안정성 요청 300건, 캐시 테스트 30회(8k 및 32k 프리픽스 각각 3개 그룹) |
Q — 답변 품질: 38.00
답변 품질은 세 가지 작업 유형으로 측정합니다. BFCL 작업 500개는 각각 세 번, HLE 작업 250개는 각각 열 번, AA-LCR 작업 25개는 각각 열 번 답변을 생성했습니다. BFCL은 자동 규칙으로 채점하고, HLE와 AA-LCR은 심사 모델 deepseek-flash가 정답 또는 오답으로 판정합니다. 5개 공급자 모두 동일한 작업 세트를 받았으며, 세 유형을 하나의 정확도 수치로 통합했습니다. 작업 판정이 불가능한 답변 10개를 제외해 총 4,240건의 시도를 채점했습니다.
| 작업 | 항목 수 | 정답 | 정확도 | 실패 |
|---|---|---|---|---|
| BFCL 도구 호출 | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| HLE 어려운 질문, 심사 모델 채점 | 250 × 10 | 233/2,490 | 9.36% | 875 |
| AA-LCR 장문서 추론 | 25 × 10 | 82/250 | 32.80% | 100 |
| 종합 · 95% 구간 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
요청 실패든 잘린 출력이든 서비스 실패는 분모에 포함하고 오답으로 계산합니다. HLE에서는 요청 실패 864건(첫 번째 윈도우 863건, 두 번째 윈도우 1건)과 max_tokens 제한으로 잘린 출력 11건이 발생했습니다. AA-LCR에서는 요청 실패 100건이 발생했으며, 모두 첫 번째 윈도우에서 발생했습니다.
BFCL은 작업별로 세 번 답변을 생성하며, 표에는 세 차례 결과를 합산해 표시합니다.
| BFCL 범주 | 통과 | 통과율 |
|---|---|---|
| simple_python: 함수 하나에 올바른 호출과 인수 사용 | 336/360 | 93.33% |
| multiple: 여러 함수 중 올바른 함수 선택 | 269/300 | 89.67% |
| parallel: 함수 하나를 여러 번 병렬 호출 | 268/300 | 89.33% |
| parallel_multiple: 서로 다른 함수 여러 개를 병렬 호출 | 206/240 | 85.83% |
| irrelevance: 적용 가능한 함수가 없으면 호출하지 않음 | 113/150 | 75.33% |
| ahm_multi_turn: 3단계 도구 체인 | 104/150 | 69.33% |
다른 4개와 비교
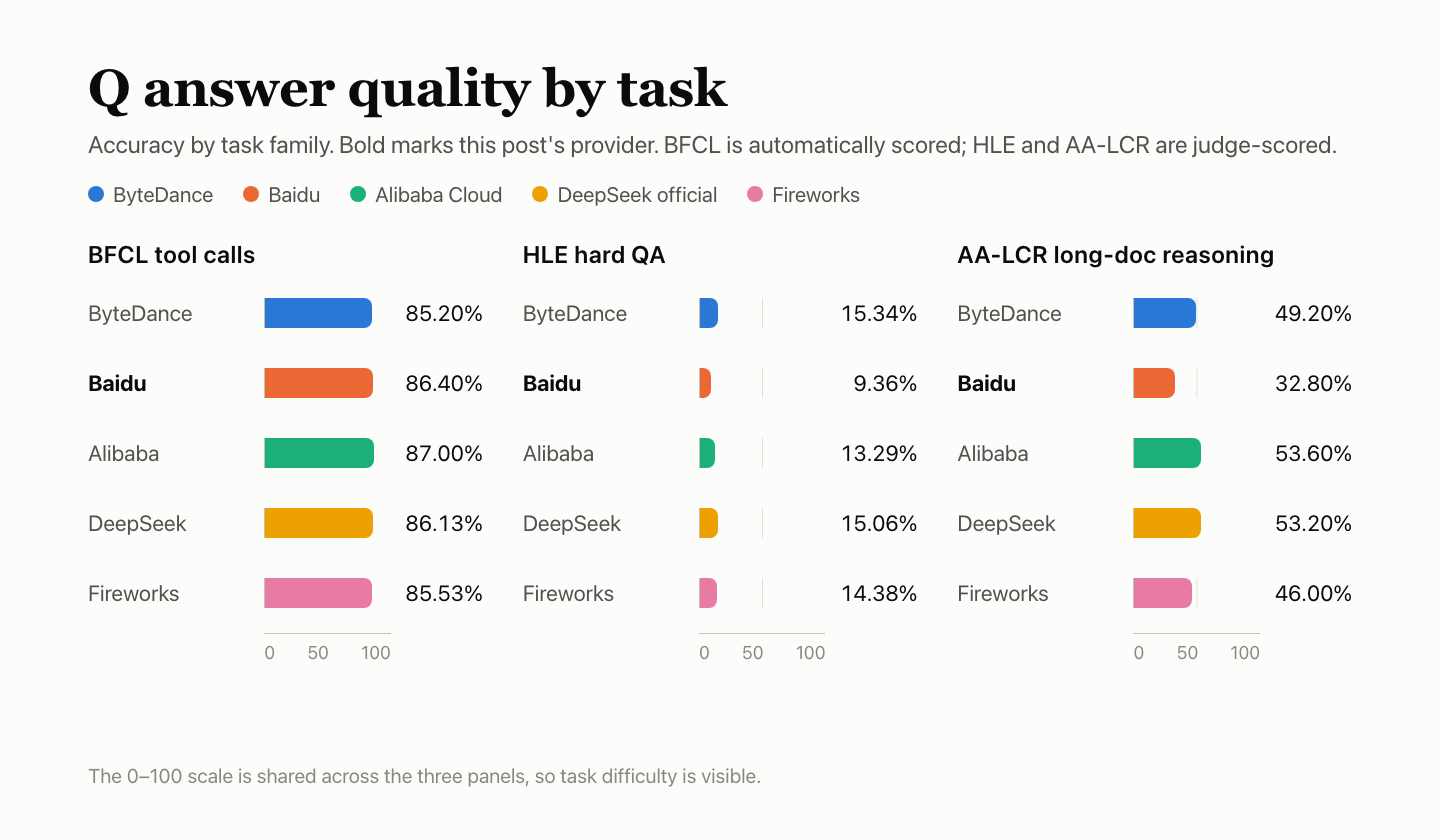
차이는 공식 채널 대비 퍼센트포인트로 표시하며, 95% 구간은 오차 막대로 나타냅니다. 구간이 0을 가로지르면 구분할 수 없는 차이로 간주합니다. HLE와 AA-LCR 심사 모델인 deepseek-flash는 테스트 대상 모델과 같은 DeepSeek 계열이며 보정되지 않았으므로, 판정이 관대할 수 있습니다.
F — 함수 지원: 88.39
함수 사례는 모델이 답변을 잘하는지가 아니라 인터페이스가 프로토콜에 명시된 대로 동작하는지를 테스트합니다. 6개 그룹의 사례 60개를 3개 윈도우에서 각각 한 번씩 실행해 총 180건을 검사했으며, 공급자가 문서화한 형식에 따라 판정했습니다. 적용 대상이 아니거나, 유효하지 않거나, 관찰되지 않은 검사는 분모에서 제외합니다. Baidu는 174건을 집계해 148건을 통과했으며, 가중 점수는 88.39입니다.
그룹 점수에는 단순히 148/174를 계산하는 대신 각 그룹의 비중에 따른 가중치를 적용합니다.
| 사례 그룹 | 가중치 | 통과 | 제외 | 그룹 점수 |
|---|---|---|---|---|
| 스트리밍 및 메시지 프로토콜 | 20% | 27/27 | 3 | 100.00 |
| 도구 인터페이스 | 20% | 30/30 | — | 100.00 |
| 출력 제약 및 매개변수 | 20% | 29/30 | — | 96.67 |
| 컨텍스트 및 상태 | 15% | 26/30 | — | 86.67 |
| 오류 및 복구 | 15% | 21/30 | — | 70.00 |
| 계량 및 캐시 프로토콜 | 10% | 15/27 | 3 | 55.56 |
| 총점, 가중치 적용 | 100% | 148/174 | 6 | 88.39 |
| 실패한 사례 | 실패한 윈도우 | 이유 |
|---|---|---|
| 컨텍스트 초과(컨텍스트 및 상태) | 3/3 | 매개변수 오류를 반환해야 하지만 200을 반환함 |
| 잘못된 메시지(오류 및 복구) | 3/3 | 400과 빈 본문을 반환했으며, 구조화된 오류는 없었음 |
| 고아 도구 결과(오류 및 복구) | 3/3 | 매개변수 오류를 반환해야 하지만 200을 반환함 |
| 잘못된 stream_options(오류 및 복구) | 3/3 | 400과 빈 본문을 반환했으며, 구조화된 오류는 없었음 |
| 캐시 읽기 필드(계량 및 캐시 프로토콜) | 3/3 | 캐시 읽기 필드가 반환되지 않아 읽기 여부를 확인할 수 없음 |
| 사고 토큰 계량(계량 및 캐시 프로토콜) | 3/3 | 사고 토큰 수가 반환되지 않음 |
| 입력에 포함된 도구 정의 계량(계량 및 캐시 프로토콜) | 3/3 | 도구 정의가 포함된 경우 보고된 입력 토큰 수가 포함되지 않은 경우보다 높지 않았음 |
| 캐시 전후 입력 수 일관성(계량 및 캐시 프로토콜) | 3/3 | 캐시 읽기 필드가 반환되지 않아 읽기 여부를 확인할 수 없음 |
| 샘플링 다양성(출력 제약 및 매개변수) | 1/3 | temperature 0과 1에서 반복 생성한 출력의 차이가 너무 작아 사전 등록 기준에 미달함 |
| 요청 간 격리(컨텍스트 및 상태) | 1/3 | 첫 단계에서 요구된 대로 STORED만 응답하지 않아 격리 검사를 진행할 수 없었음 |
이 검사는 분모에서 제외하며, 통과도 실패도 아닙니다.
| 상태 | 사례 | 개수 | 이유 |
|---|---|---|---|
| 관찰되지 않음 | 스트리밍 종료 시퀀스 | 3 | 이전 단계 이후 해당 단계의 요청이 전송되지 않아 판정할 수 없음 |
| 해당 없음 | 명시적 cache_control | 3 | 이 인터페이스에서 지원되지 않는 것으로 사전 등록됨 |
잘못된 messages와 잘못된 stream_options는 5개 공급자 모두에서 실패했습니다. 두 경우 모두 400과 빈 본문이 반환되어 클라이언트가 확인할 수 있는 구조화된 오류가 없었습니다. 5개 공급자 모두에서 공통으로 발생한 실패이므로 AIHubMix 게이트웨이 계층에 원인이 있을 가능성이 높으며, 별도 조사가 필요합니다. 사고 토큰 계량도 5개 공급자 모두에서 실패했지만, 이유는 달랐습니다. ByteDance와 Fireworks는 사고 모드가 꺼져 있어도 사고 토큰을 보고한 반면, 나머지 세 공급자는 사고 토큰 수를 반환하지 않았습니다.
다른 4개와 비교
P — 응답 속도: 37.77
각 요청에는 약 10,000개의 입력 토큰을 넣고 약 1,100개의 출력 토큰이 포함된 본문을 요청했습니다. 3개 윈도우에서 각각 단일 동시성 테스트 30회와 동시 요청 10건 테스트 30회를 실행해 총 180건의 요청을 전송했습니다.
| 지표 | 결과 |
|---|---|
| 첫 토큰 TTFA | 단일 동시성 중앙값 2.26 s(유효 요청 중앙값 2.05 s). 동시 요청 10건 테스트는 절반 이상이 유효하지 않아 집계 중앙값은 무한대로 처리됨(유효 요청 중앙값 1.86 s) |
| 생성 속도 TPOT | 단일 동시성 3.48 ms/token. 동시 요청 10건 50.00 ms/token(절반 이상이 유효하지 않아 페널티 값 적용) |
| 굿풋(유효 처리량) | 동시 요청 10건에서 1,329.2 token/s |
| 유효 요청 | 단일 동시성 78/90(첫 번째 윈도우 18/30). 동시 요청 10건 40/90(첫 번째 윈도우 0/30, 세 번째 윈도우 10/30) |
| 무효 사유 | 테스트 62회에서 400 no_available_channel 반환 |
| 구성 요소 점수 | TTFA 0.00, TPOT 0.00, 처리량 100.00. 응답 점수 30.00 |
| P 구성 | 응답 점수 30.00의 비중 80%, 캐시 K 68.85의 비중 20%, 총점 37.77 |
TPOT는 하드웨어에서 토큰별로 측정한 값이 아니라 스트리밍 청크를 바탕으로 추정합니다. 굿풋은 동시 요청 10건 부하에서 생성한 유효 출력 토큰 수를 배치의 벽시계 시간으로 나눈 값입니다.
동시 요청 10건 테스트에서는 90회 중 50회에서 no_available_channel이 반환됐습니다. 절반이 넘는 테스트가 유효하지 않아 첫 토큰 시간의 중앙값을 무한대로 처리하고, TTFA와 TPOT에 페널티 값을 적용했습니다. 단일 동시성 테스트는 90회 중 78회가 유효했습니다.
5개 공급자 모두 동일한 기기, 네트워크, 계정을 사용했습니다. 세 개의 윈도우는 공급자별로 일정을 잡아 실행했으므로 수집 기간이 완전히 겹치지는 않습니다. 작은 차이를 과도하게 해석하지 마세요.
K — 캐시: 68.85
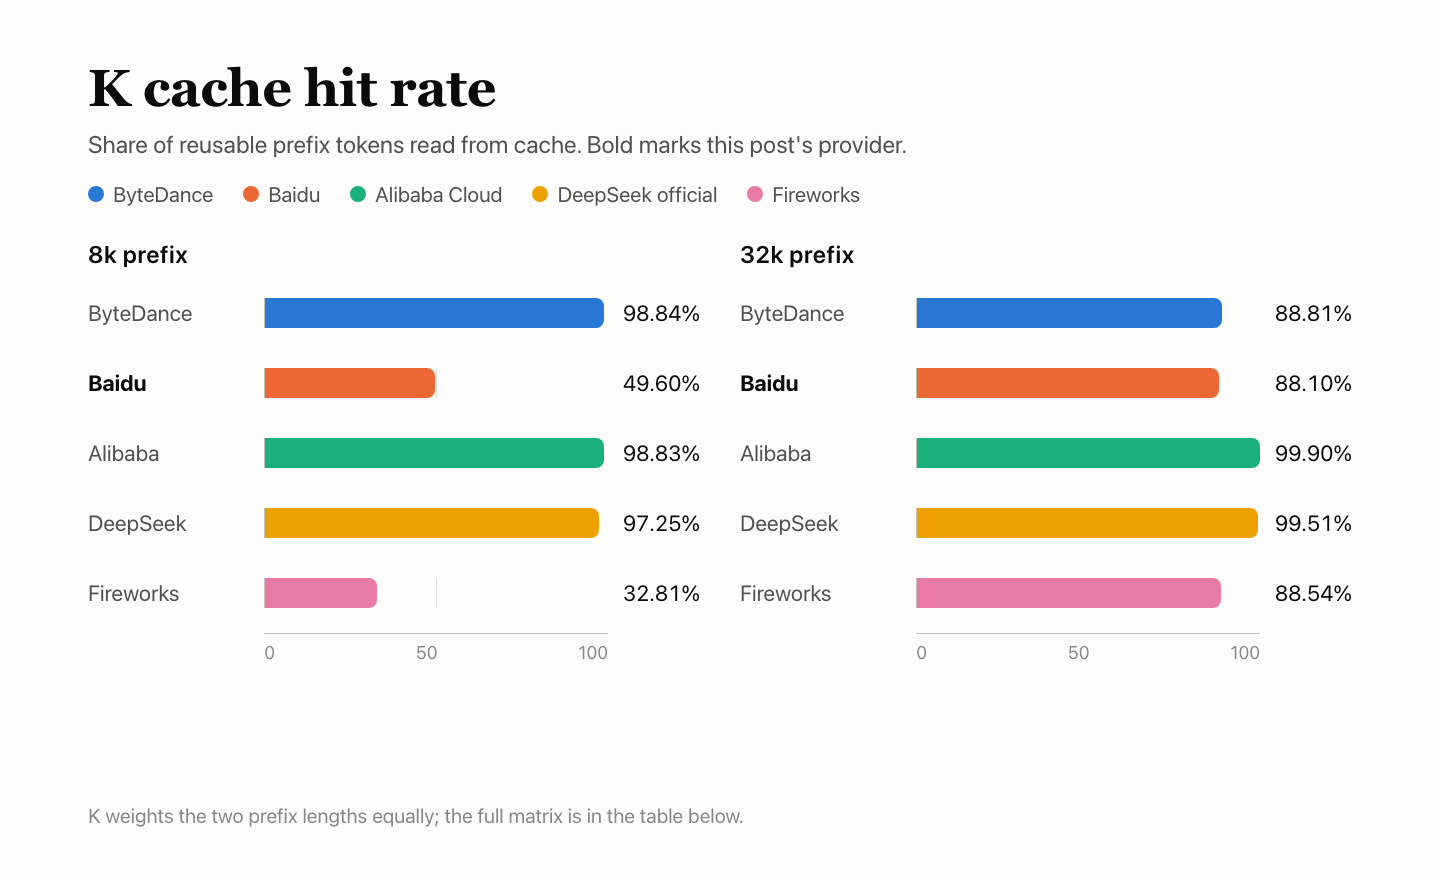
각 그룹에서는 요청 5건을 전송합니다. 첫 번째 요청에는 약 8k 또는 32k 토큰의 고정 프리픽스가 포함되어 캐시를 준비합니다. 요청 2~4에서는 프리픽스를 유지하고 끝의 질문만 바꾸며, 요청 간격은 5 s, 30 s, 120 s입니다. 다섯 번째 요청에는 새로운 프리픽스를 사용해 콜드 대조군으로 삼습니다. 윈도우 3개에 길이 2종류를 조합해 총 30건을 요청합니다. K는 핫 요청에서 읽은 캐시 토큰을 규칙상 재사용할 수 있는 토큰 수로 나눈 값이며, 각 길이의 가중치는 절반씩입니다. K는 P의 20%를 차지합니다.
표에는 서버가 보고한 캐시 읽기 토큰 수가 나와 있습니다. "반환되지 않음"은 응답에 해당 필드가 없었다는 뜻입니다.
| 프리픽스 | 윈도우 | 시드 | +5 s | +30 s | +120 s | 콜드 대조군 |
|---|---|---|---|---|---|---|
| 8k | 1 | 실패 | 실패 | 실패 | 반환되지 않음 | 반환되지 않음 |
| 8k | 2 | 반환되지 않음 | 7,168 | 7,168 | 실패 | 실패 |
| 8k | 3 | 반환되지 않음 | 7,168 | 7,168 | 7,168 | 반환되지 않음 |
| 32k | 1 | 반환되지 않음 | 반환되지 않음 | 31,744 | 31,744 | 반환되지 않음 |
| 32k | 2 | 반환되지 않음 | 31,744 | 31,744 | 31,744 | 반환되지 않음 |
| 32k | 3 | 반환되지 않음 | 31,744 | 31,744 | 31,744 | 반환되지 않음 |
8k 접두부는 핫 요청 9건 중 5건에서 캐시 적중해, 재사용 가능해야 했던 토큰 72,252개 중 35,840개를 읽어 49.60점을 기록했다. 32k 접두부는 9건 중 8건에서 적중해 288,261개 중 253,952개를 읽어 88.10점을 기록했다. 두 길이의 가중치를 동일하게 적용한 K는 68.85다. 8k 요청 5건은 전체적으로 실패했다. 윈도우 1의 시드 요청, 5초 및 30초 요청과 윈도우 2의 120초 및 콜드 제어 요청이 모두 no_available_channel을 반환했다. 따라서 8k 티어에서 핫 요청 3건이 실패했다.
캐시 적중 시 보고된 읽기량은 1,024토큰 블록으로 계산된다. 8k 접두부는 7,168토큰, 32k 접두부는 31,744토큰이다. 캐시 미스 시에는 사용량 블록에 prompt_tokens_details가 포함되지 않는다. 표에는 "반환되지 않음"으로 기록하고 값은 0으로 계산한다.
나머지 네 곳과 비교
R — 서비스 안정성: 100
300건의 요청은 짧은 텍스트, 긴 입력, 도구 호출, 멀티턴 기록의 네 가지 유형으로 나뉜다. 세 개의 윈도우에서 동시성 1로 요청을 보냈다. 첫 응답이 유효하고 완전했는지만 확인하며, 답변의 품질은 평가하지 않고 재시도도 하지 않는다. 답변 및 속도 측정 중의 실패는 R에 다시 포함하지 않고 Q와 P에 반영한다.
| 요청 유형 | 첫 시도 성공률 |
|---|---|
| 짧은 텍스트 | 120/120 |
| 10k 긴 입력 | 90/90 |
| 도구 호출 | 60/60 |
| 멀티턴 기록 | 30/30 |
| 전체 | 300/300, 95% 신뢰구간 98.78%–100% |
요청 300건 모두 첫 시도에서 유효하고 완전한 응답을 반환했다. R 100은 이 전용 요청 300건에만 해당하며, 전체 경로에서 실패가 없었다는 뜻은 아니다. 300건 중 300건이 성공했으므로 95% 구간의 하한은 98.78%이며, 실패율은 1.22% 미만일 가능성이 높다.
나머지 네 곳과 비교
R은 이 전용 요청 300건에만 해당한다. 답변 및 속도 측정 중의 실패는 R에 다시 포함하지 않고 Q와 P에 기록한다.
| 공급자 | 첫 시도 성공률 | 95% 신뢰구간 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek 공식 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
종합 점수는 무엇을 의미하나요?
신뢰구간이 없는 요약 지표이며 인증 점수는 아닙니다. 이 글에서는 Q, F, P, K, R을 보고하며 특정 공급자를 추천하지 않습니다.
동시 요청 10건을 보낸 측정에서 절반이 실패한 이유는 무엇인가요?
응답 90건 중 50건이 no_available_channel을 반환했습니다. 유효하지 않은 응답이 절반을 넘었으므로 첫 토큰 시간의 중앙값은 무한대로 간주하고 TTFA와 TPOT에는 페널티 점수를 적용합니다.
R 100은 채널 오류가 없었다는 뜻인가요?
아닙니다. R은 전용 요청 300건을 대상으로 하며, 모두 첫 시도에 성공했습니다. 속도 측정에서 발생한 no_available_channel 응답 62건과 답변 측정 중 발생한 실패는 P와 Q에 반영합니다.
32k 접두부가 9건 중 8건에서 적중했는데 K가 68.85인 이유는 무엇인가요?
두 길이의 가중치를 동일하게 적용합니다. 8k 접두부는 핫 요청 9건 중 5건에서 적중해 49.60점을 기록했고, 32k 접두부는 9건 중 8건에서 적중해 88.10점을 기록했습니다. 평균은 68.85입니다.
Baidu의 답변 품질은 공식 채널과 구별할 수 있나요?
예. Q를 합산한 차이는 −4.46%포인트이며, 95% 신뢰구간은 −5.78에서 −3.16으로 0을 포함하지 않습니다. 신뢰구간이 0을 포함하지 않으면서 공식 채널보다 낮은 점수를 기록한 공급자는 이곳뿐입니다.
F에서 제외된 검사는 무엇인가요?
6개입니다. 앞 단계의 요청이 전송되지 않아 관찰할 수 없었던 스트리밍 중지 시퀀스 검사 3개와, 이 인터페이스에서 지원되지 않는다고 사전 등록된 명시적 cache_control 검사 3개입니다.
계속 읽기: DeepSeek V4.1 Flash 시리즈
- Baidu의 BFCL 정확도는 공식 채널과 비슷했습니다. 다음 ByteDance 글에서는 동일한 테스트 세트를 도구 호출 및 과금 측정 결과까지 살펴봅니다. ByteDance에서 DeepSeek V4.1 Flash 사용: 도구 호출은 일치하지만 과금은 다르다
- Baidu의 동시성 1 TTFA는 2.26초로, 1.34초를 기록한 실행과 대조됩니다. Alibaba Cloud에서 DeepSeek V4.1 Flash 사용: 첫 토큰 1.34초, 캐시 99.37
- Baidu의 F 88.39는 유효하지 않은 측정 15건을 포함한 기준 실행의 94.00과 비교할 수 있습니다. 공식 채널에서 DeepSeek V4.1 Flash 사용: F 94.00, 유효하지 않은 측정 15건
- Baidu의 8k 캐시 적중 5/9는 3/9 적중과 비어 있는 중지 응답을 보인 실행과 비교됩니다. Fireworks에서 DeepSeek V4.1 Flash 사용: 비어 있는 중지 응답, 캐시 적중 3/9


