

2026-11-03/04 APB Full 실행에서 Pareto의 점수는 Q 44.58, F 93.42, P 57.69, R 100이며, 종합 점수는 68.72입니다. 8k 핫 요청은 9건 중 2건, 32k 핫 요청은 9건 중 3건이 캐시에 적중했습니다.
2026-11-03/04에 DeepSeek V4.1 Flash 1017을 AIHubMix를 통해 여섯 공급자에서 테스트했습니다. 각 공급자에 동일한 질문, 매개변수, 요청 스크립트를 사용해 APB Full 제품군을 실행했습니다. 이 APB 프로필은 Pareto만 다룹니다. 각 항목에서 무엇을 측정했고 결과가 어땠는지 살펴봅니다.
아래 수치는 점수이지 순위나 공급자 추천이 아닙니다. 네 가지 점수 Q, F, P, R을 먼저 제시하고, 종합 점수는 요약 지표일 뿐 인증이 아니며 신뢰 구간도 없습니다. 채점 규칙은 AIHubMix Provider Benchmark Standard v2.0에 정의되어 있습니다.
여섯 공급자의 점수
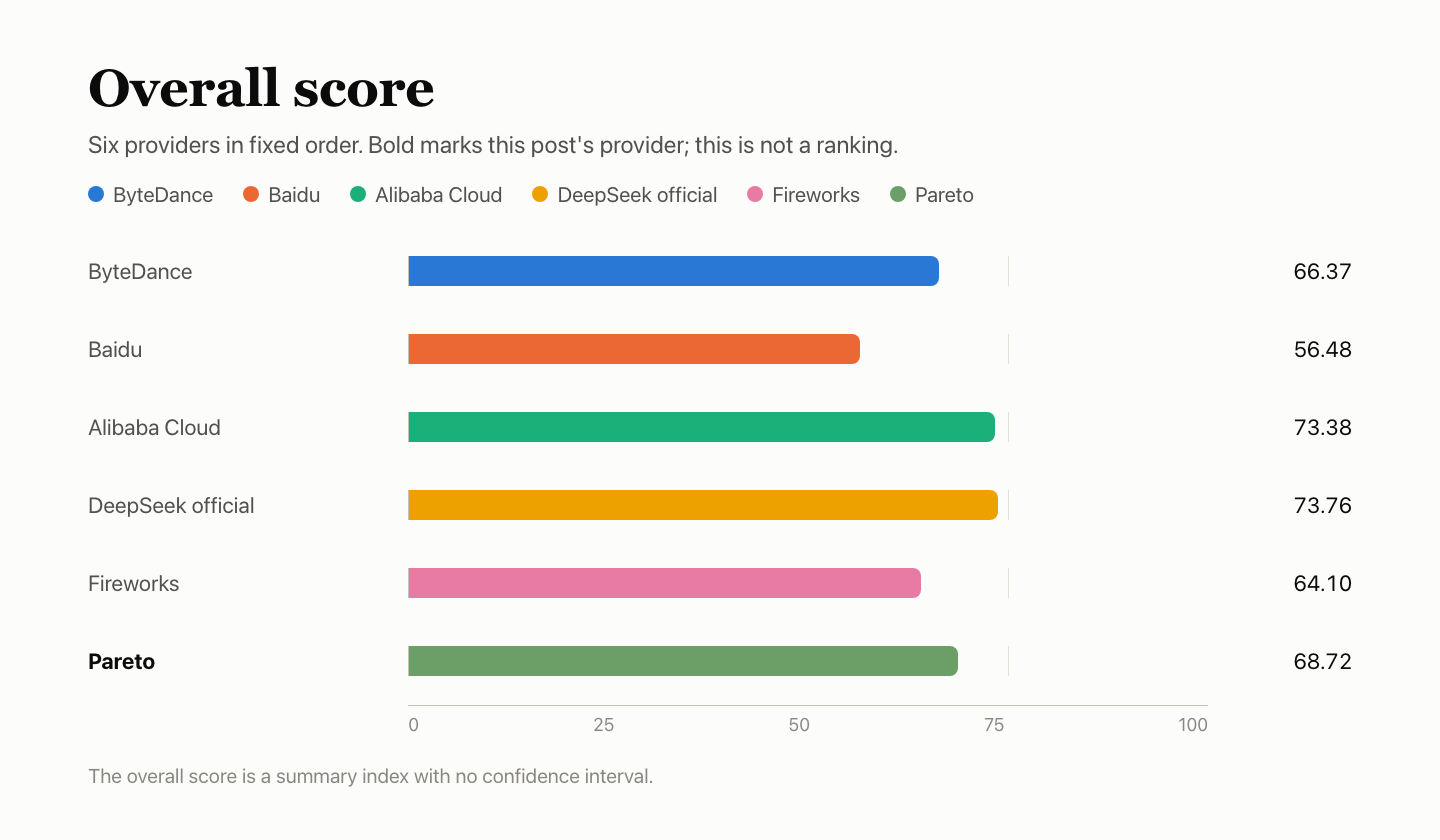
| 공급자 | Q 품질 | F 기능 | P 속도 | K 캐시 | R 안정성 | 종합 |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| DeepSeek 공식 채널 | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (이 글의 대상) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
공급자는 순위가 아니라 고정된 순서로 나열했습니다. K는 P의 하위 점수로, P의 20%를 차지하며 참고용으로 별도 표기했습니다. 종합 점수는 AIHubMix Provider Benchmark Standard의 구성 규칙에 따라 계산되며, 공식 채널과의 비교 및 근거 자료의 완전성도 반영합니다. 표에 있는 네 점수를 직접 가중 합산한 값이 아닙니다. 신뢰 구간이 없는 요약 지표입니다. DeepSeek 공식 채널과 Alibaba Cloud의 종합 점수 차이는 0.37에 불과해 구별할 수 있는 차이가 아닙니다.
한눈에 보기
- 답변 품질: Q 44.58, BFCL 85.27%, HLE 19.32%, AA-LCR 52.00%입니다. 공식 채널과의 차이는 +2.12%p이며, 95% 구간은 −0.02~+4.18입니다. 구별할 수 있는 차이가 아닙니다.
- 기능 지원: F 93.42이며, 원래 점수가 매겨진 검사 33건 중 29건을 통과했습니다. 도구 호출과 도구 결과 왕복, 병렬 및 이름 지정 호출, JSON 모드, 대화 기록에 대해 스트리밍 성공 기록이 추가로 확인됐으며 점수는 기존 값을 유지합니다.
- 응답 속도: P 57.69입니다. 단일 동시성에서 첫 본문 토큰까지 걸린 시간의 중앙값은 5.85초, 동시성 10에서는 6.13초이며 TPOT는 4.63ms입니다. 속도 요청 180건 중 110건이 유효했습니다.
- 캐시: K 27.58입니다. 8k 핫 요청은 9건 중 2건, 32k 핫 요청은 9건 중 3건이 캐시에 적중했습니다. 콜드 제어 요청에서는 캐시를 읽지 않았습니다.
- 서비스 안정성: R 100입니다. 안정성 전용 요청 300건이 모두 첫 시도에서 성공했습니다.
테스트 설정
| 항목 | 세부 정보 |
|---|---|
| 모델 | DeepSeek V4.1 Flash 1017 |
| 요청한 모델 ID | deepseek/deepseek-v4.1-flash |
| 반환된 모델 이름 | deepseek/deepseek-v4.1-flash |
| 접속 경로 | 공급자 계정에 직접 연결하지 않고, 공급자별 모델 ID를 사용해 AIHubMix를 통해 접속 |
| 매개변수 | 고정 APB v2 요청 프로필, temperature 1.0, max_tokens 16,384, 타임아웃 300초, 자동 재시도 없음 |
| 시간 | 2026-11-03 18:07 – 11-04 16:33; 캐시 요청은 11-05 19:31 – 11-06 10:35; 모두 UTC+8. 여섯 공급자는 동일한 Mac mini, 네트워크 하나, 계정 하나를 공유했습니다. |
| 샘플 수 | Q 4,250개 질문 인스턴스; F 180개 검사; P 180개 요청; R 300개; K 30개 |
요청은 공급자별 모델 ID를 사용해 AIHubMix 빠른 시작 경로로 전송했습니다. 다른 공급자의 ID는 모델 페이지에 나와 있습니다. 모델 자체의 매개변수는 DeepSeek의 API 문서에 설명되어 있습니다.
Q — 답변 품질: 44.58
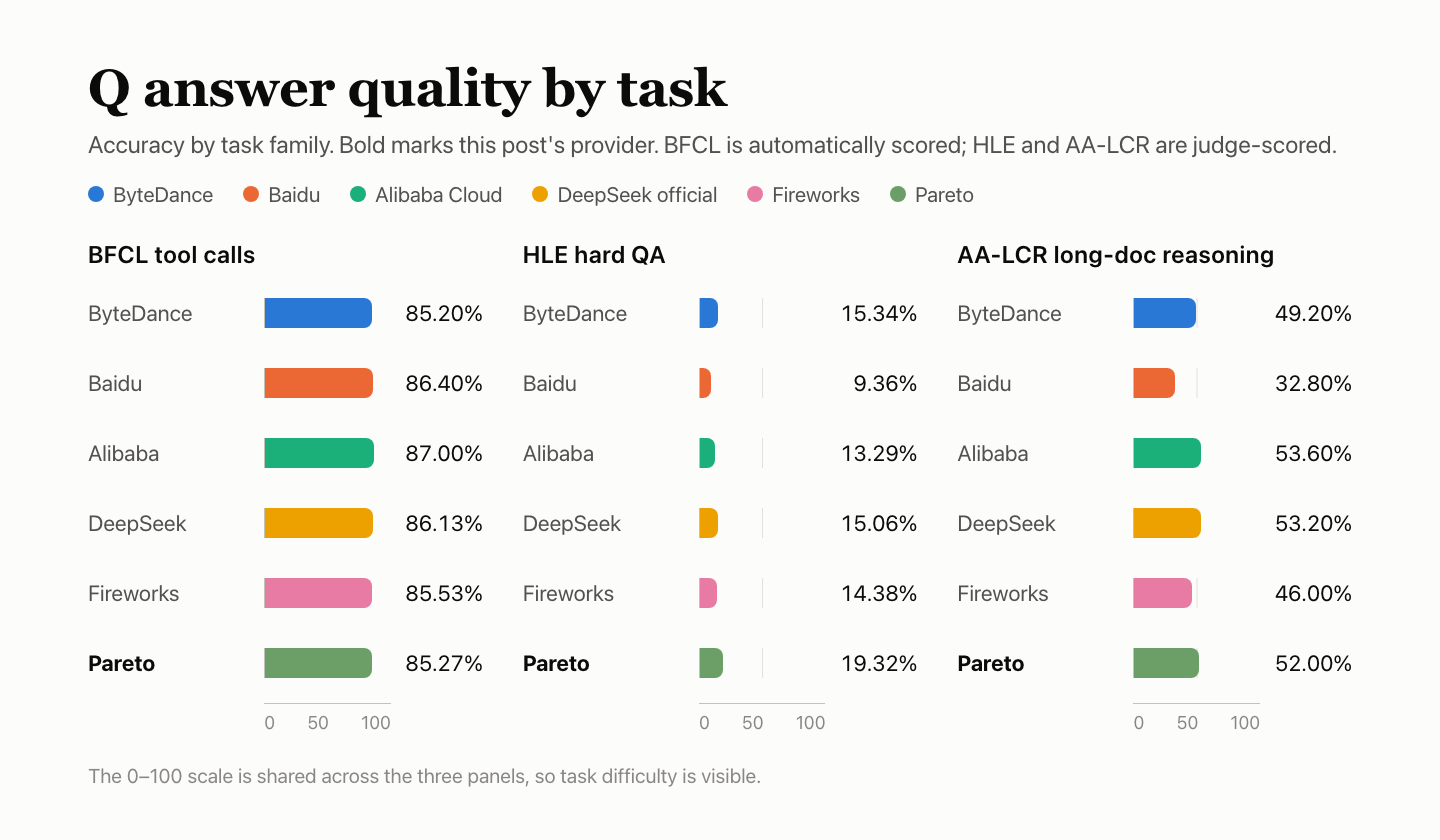
답변 품질은 세 가지 제품군으로 측정합니다. BFCL 질문 500개에 각각 3회, HLE 질문 250개에 각각 10회, AA-LCR 질문 25개에 각각 10회 답변했습니다. BFCL은 자동 규칙으로 채점하고, HLE와 AA-LCR은 심판 모델 deepseek-flash가 정답 또는 오답으로 판정합니다. 여섯 공급자에 동일한 질문을 제시했으며, 세 제품군을 합산해 하나의 정확도를 계산했습니다. 채점할 수 없는 질문으로 인해 답변 10개를 제외해, 채점된 질문 인스턴스는 4,240개입니다.
| 제품군 | 질문 수 × 라운드 수 | 정답 수 | 정확도 | 서비스 실패 |
|---|---|---|---|---|
| BFCL 도구 호출, 자동 채점 | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE 어려운 QA, 심판 채점 | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR 장문서 추론, 심판 채점 | 25 × 10 | 130/250 | 52.00% | 0 |
| 전체 · 95% 구간 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
모든 질문 인스턴스에 완전한 답변이 반환됐으며 서비스 실패는 없었습니다.
| BFCL 범주 | 통과 | 통과율 |
|---|---|---|
| simple_python: 함수 하나, 올바른 호출과 인수 | 333/360 | 92.50% |
| multiple: 여러 함수 중 올바른 함수 선택 | 269/300 | 89.67% |
| parallel: 함수 하나를 한 번에 여러 차례 호출 | 265/300 | 88.33% |
| parallel_multiple: 여러 함수를 한 번에 호출 | 203/240 | 84.58% |
| irrelevance: 관련 함수가 없어 호출하지 않음 | 109/150 | 72.67% |
| ahm_multi_turn: 3단계 도구 체인 | 100/150 | 66.67% |
각 BFCL 질문에 3회 답변했으며, 표에는 세 라운드의 합계를 표시했습니다.
다른 다섯 공급자와 비교
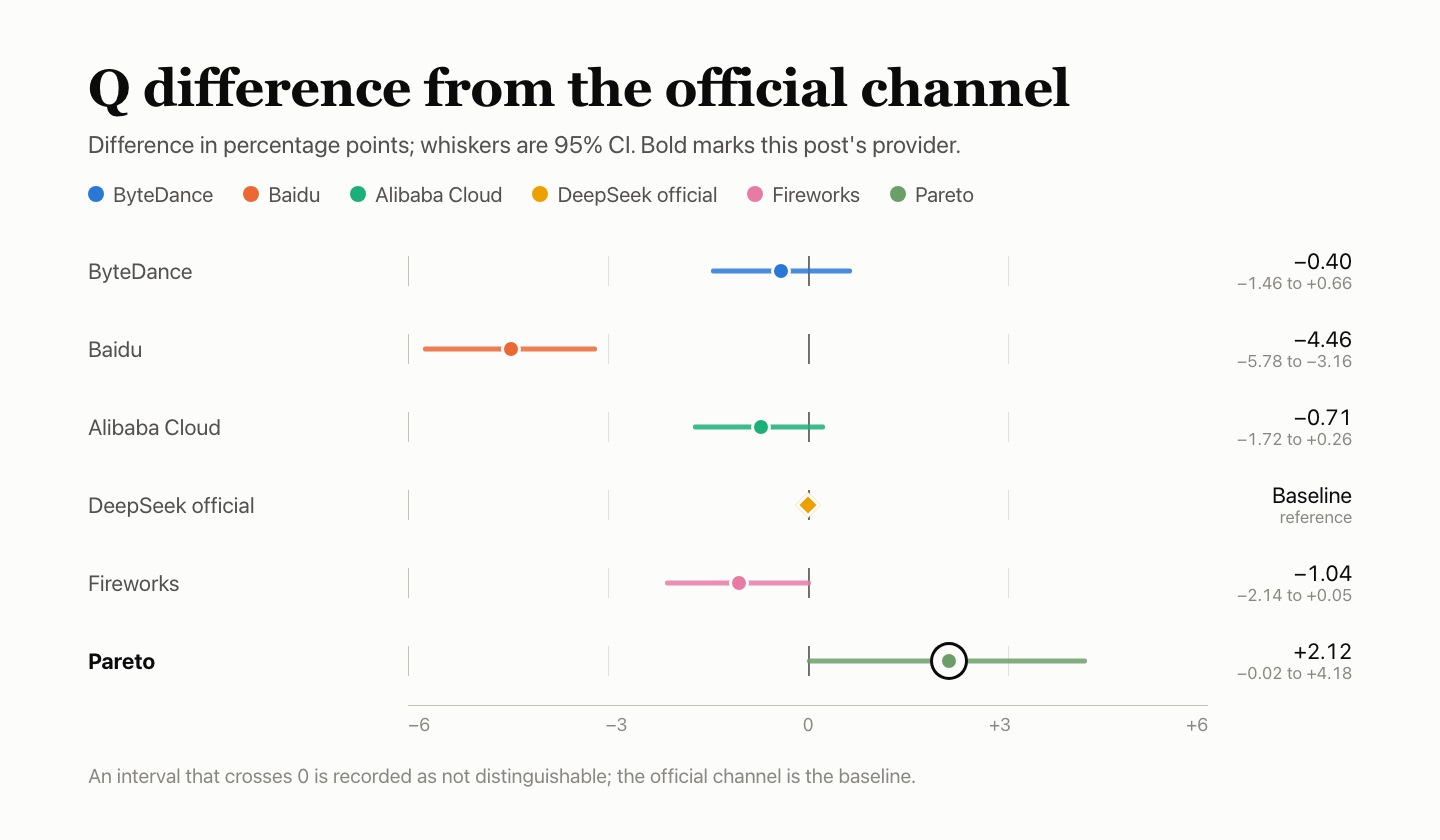
| 공급자 | BFCL | HLE | AA-LCR | 통합 | 공식 채널 대비 |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46~+0.66), 구별할 수 없음 |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78~−3.16), 공식 채널보다 낮음 |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72~+0.26), 구별할 수 없음 |
| DeepSeek 공식 채널 | 86.13% | 15.06% | 53.20% | 42.45% | 기준 |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14~+0.05), 구별할 수 없음 |
| Pareto (이 글의 대상) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02~+4.18), 구별할 수 없음 |
공식 채널 대비 값은 정확도 차이(%p)이며, 괄호 안은 95% 구간입니다. 구간이 0을 포함하면 구별할 수 없는 것으로 기록합니다. HLE와 AA-LCR의 심판인 deepseek-flash는 테스트 대상 모델과 같은 DeepSeek 계열에 속하며 보정되지 않았으므로, 판정이 관대할 수 있습니다.
F — 기능 지원: 93.42
기능 사례는 인터페이스 동작이 프로토콜과 일치하는지 확인합니다. F 93.42는 집계된 검사 33건 중 통과한 29건을 바탕으로, 관측된 그룹의 가중치를 재정규화해 계산했습니다. 기존 제품군에서 계획한 나머지 147개 검사 항목은 점수 계산에서 제외했습니다.
| 사례 그룹 | 가중치 | 통과 / 스트리밍 관측 | 제외 | 그룹 점수 |
|---|---|---|---|---|
| 스트리밍 및 메시지 프로토콜 | 20% | 23/27 | 3 | 85.19 |
| 도구 인터페이스 도구 호출, 도구 결과 왕복, 병렬 및 이름 지정 호출 | 20% | 스트리밍 통과 기록 확인* | 30 | — |
| 출력 제약 및 매개변수 JSON 모드 및 사고 비활성화 | 20% | 스트리밍 통과 기록 확인* | 30 | — |
| 컨텍스트 및 상태 대화 기록 및 시스템 지침 | 15% | 스트리밍 통과 기록 확인* | 30 | — |
| 오류 및 복구 | 15% | 3/3 | 27 | 100.00 |
| 사용량 측정 및 캐시 프로토콜 | 10% | 3/3 | 27 | 100.00 |
| 전체 · 가중 점수 | 29/33 | 147 | 93.42 | |
- 나열된 기능에는 스트리밍 성공 기록이 있지만, 그렇다고 해당 그룹 전체에 만점을 부여하는 것은 아닙니다. 채점에 검사를 추가하지 않았습니다. F 93.42와 종합 점수 68.72는 기존 값을 유지합니다.
| 실패한 사례 | 윈도 | 원인 |
|---|---|---|
| 스트리밍 중단 시퀀스 스트리밍 및 메시지 프로토콜 | 3/3 | 중단 시퀀스를 사용하면 본문이 비었으며, 중단 시퀀스가 없는 동일한 입력은 정상 작동 |
| 정확한 텍스트 출력 스트리밍 및 메시지 프로토콜 | 1/3 | 마지막에 마침표가 추가되어 정확한 텍스트 일치에 실패 |
“윈도”는 검사에 실패한 3개 윈도의 개수입니다.
잘못된 메시지 및 잘못된 스트림 옵션 사례는 여러 공급자에서 빈 응답 본문과 함께 400을 반환했습니다. 추론 토큰 사용량 측정 방식은 공급자마다 달랐습니다.
다른 다섯 공급자와 비교
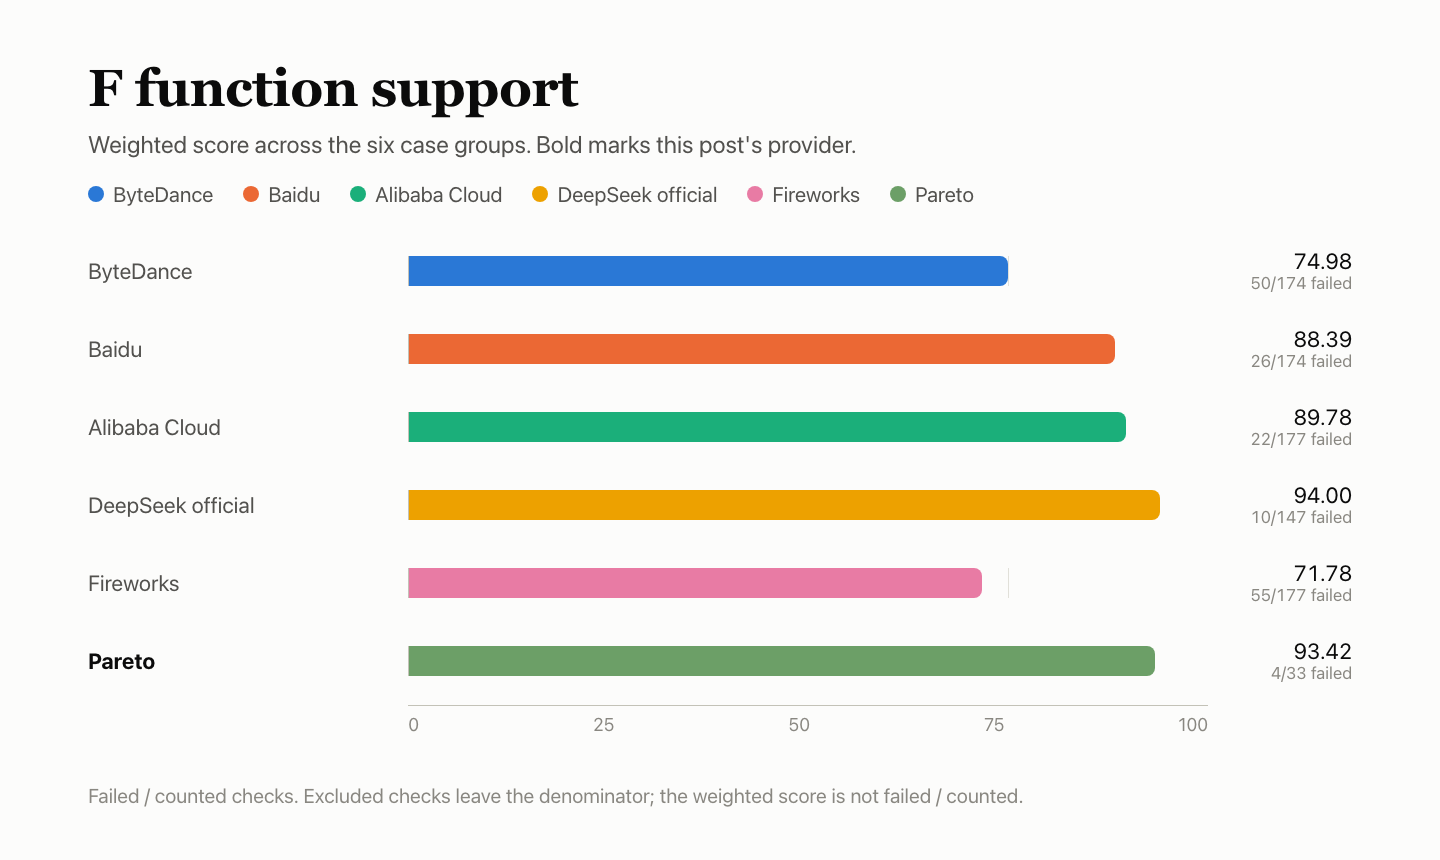
| 공급자 | 통과 | 실패 | 제외 | 가중 점수 |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| DeepSeek 공식 채널 | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (이 글의 대상) | 29 | 4 | 147 | 93.42 |
P — 응답 속도: 57.69
각 요청에는 입력 토큰 약 10,000개가 포함됐고, 본문 텍스트로 출력 토큰 약 1,100개를 생성하도록 했습니다. 세 윈도 각각에서 단일 동시성 요청 30건과 동시성 10 요청 30건을 실행해 총 180건을 처리했습니다.
| 항목 | 세부 정보 |
|---|---|
| 첫 본문 토큰(TTFA) | 중앙값: 단일 동시성 5.85초(유효 요청만 보면 3.08초), 동시성 10에서 6.13초(유효 요청만 보면 4.92초) |
| 생성 속도(TPOT) | 단일 동시성에서 4.42ms/토큰, 동시성 10에서 4.63ms/토큰 |
| 유효 처리량 | 동시성 10에서 519.4토큰/초 |
| 유효 요청 | 단일 동시성 53/90(윈도 1–3: 15/30, 18/30, 20/30), 동시성 10에서 57/90(23/30, 16/30, 18/30); 무효 요청: 70건이 None과 함께 200을 반환 |
| 하위 점수 | TTFA 24.59, TPOT 100.00, 처리량 72.05; TTFA와 TPOT에는 하위 등급을 적용하고, 가중치는 각각 35% / 35% / 30%입니다. 응답 점수는 65.22입니다. |
| P 점수 | 응답 점수 65.22 × 80% + 캐시 K 27.58 × 20% = 57.69 |
무효 요청은 무한대로 채점되므로 표의 중앙값이 유효 요청만의 중앙값보다 높을 수 있습니다. TPOT는 하드웨어에서 토큰별로 측정한 값이 아니라 스트리밍 청크를 바탕으로 추정했습니다. 처리량은 동시성 10에서 유효 출력 토큰 수를 배치의 실제 경과 시간으로 나눈 값입니다.
다른 다섯 공급자와 비교
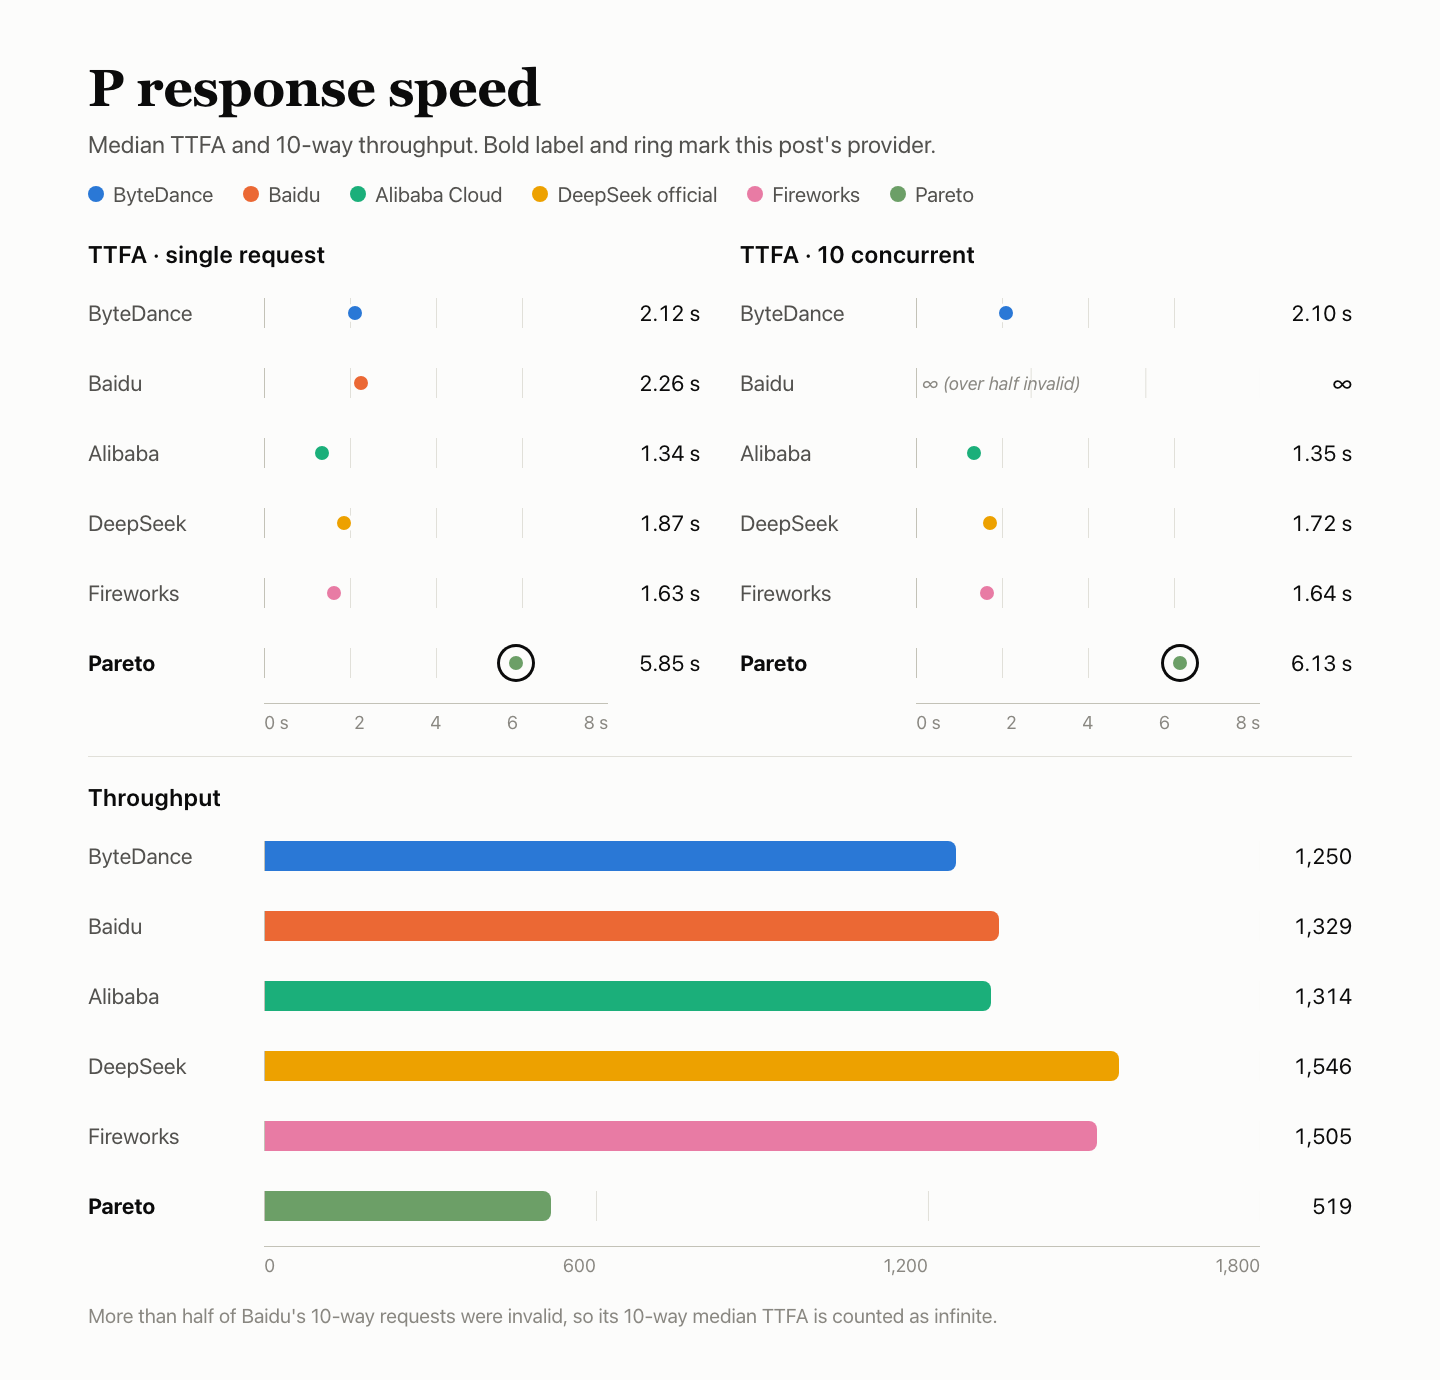
| 공급자 | 유효 요청 | 단일 동시성 TTFA | 동시성 10 TTFA | TPOT(느릴수록 높음) | 처리량 토큰/초 | 응답 |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| DeepSeek 공식 채널 | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto(이 글) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
여섯 공급자 모두 동일한 머신, 네트워크, 계정을 사용했습니다. 세 번의 측정은 공급자별로 일정을 잡아 진행했으므로 수집 기간이 완전히 겹치지는 않습니다. 작은 차이는 지나치게 의미를 부여하지 않아야 합니다. ∞는 요청의 절반 넘게 유효하지 않았다는 뜻이며, 따라서 중앙값은 무한대로 계산됩니다.
K — 캐시: 27.58
각 그룹은 요청을 5회 보냅니다. 첫 요청에는 약 8k 또는 32k 토큰의 고정 프리픽스가 포함되어 캐시를 채웁니다. 2~4번째 요청은 프리픽스를 유지하고 마지막 질문만 바꾸며, 요청 간격은 5 s, 30 s, 120 s입니다. 다섯 번째 요청은 콜드 상태를 대조하기 위해 새 프리픽스를 사용합니다. 측정 창 3개와 길이 2개를 조합해 총 30회 요청합니다. K는 핫 요청에서 읽은 캐시 토큰을 규칙상 재사용 가능해야 하는 토큰 수로 나눈 값이며, 두 길이에 동일한 가중치를 적용합니다. K는 P의 20%를 차지합니다.
| 측정 창 | 1 · 캐시 채우기 | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · 콜드 |
|---|---|---|---|---|---|
| 8k 프리픽스 · 핫 적중 2/9 · 재사용 가능 토큰 72,504개 중 15,872개 읽음 · 21.89 | — | — | — | — | — |
| 측정 창 1 | 0 | 0 | 7,936 | 0 | 0 |
| 측정 창 2 | 0 | 0 | 0 | 0 | 0 |
| 측정 창 3 | 0 | 0 | 7,936 | 0 | 0 |
| 32k 프리픽스 · 핫 적중 3/9 · 재사용 가능 토큰 288,513개 중 96,000개 읽음 · 33.27 | — | — | — | — | — |
| 측정 창 1 | 0 | 0 | 32,000 | 0 | 0 |
| 측정 창 2 | 0 | 0 | 0 | 0 | 0 |
| 측정 창 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k와 32k에 동일한 가중치 적용) | — | — | — | — | 27.58 |
서버가 보고한 캐시 읽기 토큰 값입니다. “반환되지 않음”은 응답에 해당 필드가 없었음을 뜻합니다.
8k 핫 요청은 9회 중 2회 캐시 적중했으며, 적중할 때마다 7,936개 토큰을 읽었습니다. 32k 핫 요청은 9회 중 3회 적중했으며, 적중할 때마다 32,000개 토큰을 읽었습니다. 콜드 요청은 캐시를 읽지 않았으므로 핫 요청과 콜드 요청이 명확히 구분됩니다.
다른 다섯 공급자와 비교
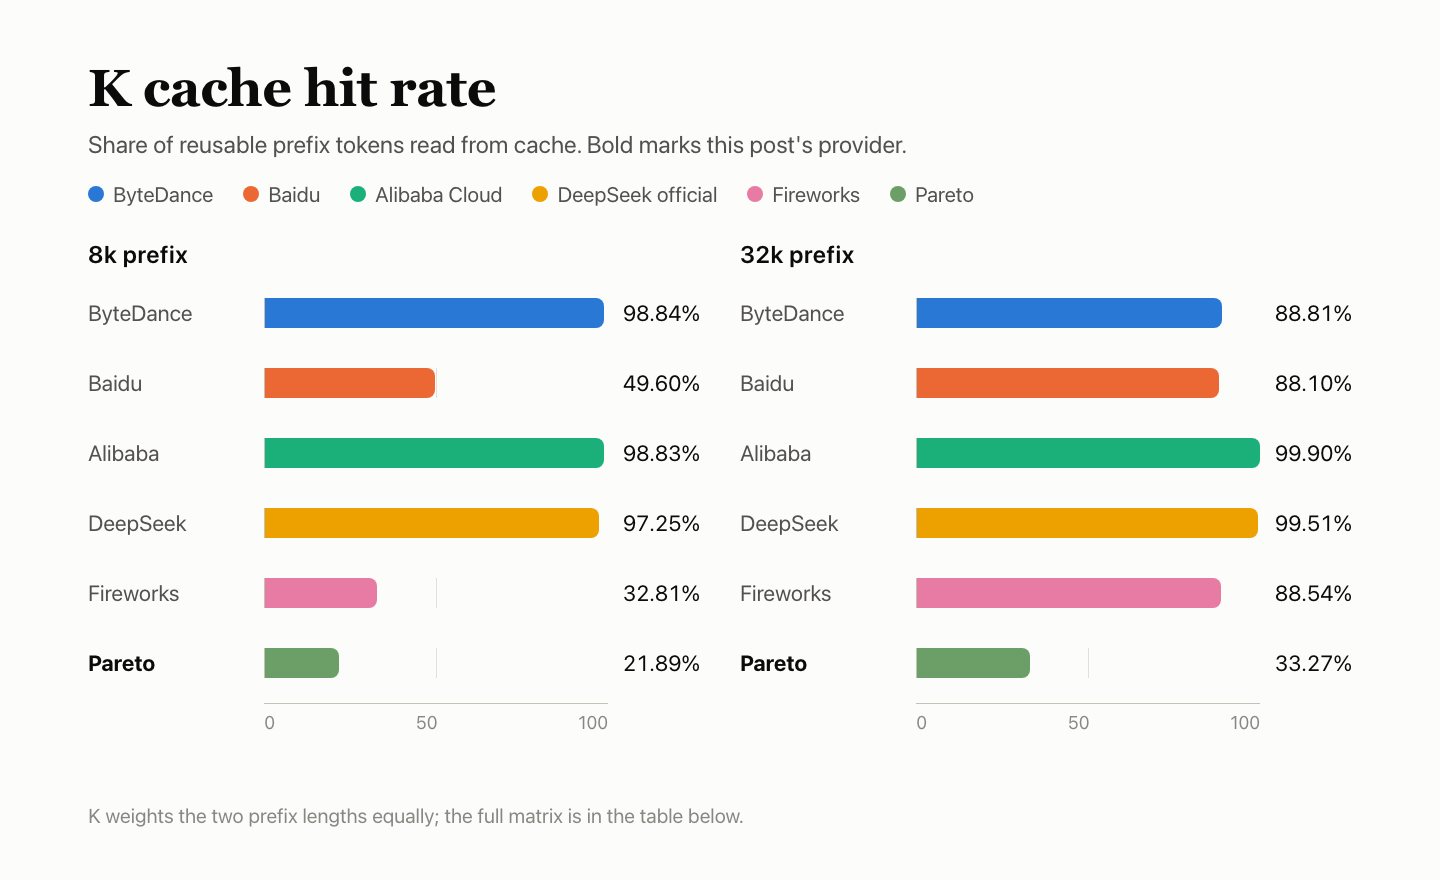
| 공급자 | 8k 적중 | 8k | 32k 적중 | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| DeepSeek 공식 채널 | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto(이 글) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — 서비스 안정성: 100
300회 요청은 짧은 텍스트, 긴 입력, 도구 호출, 멀티턴 대화 기록의 네 가지 유형으로 구성됩니다. 세 측정 창에서 동시 요청 수 1로 실행했습니다. 첫 시도에서 유효하고 완전한 응답을 반환했는지만 확인하며, 답변의 품질은 평가하지 않고 재시도도 하지 않습니다. 답변 품질 및 속도 섹션의 실패는 Q와 P에 반영되며, R에 다시 집계하지 않습니다.
| 요청 유형 | 첫 시도 성공률 |
|---|---|
| 짧은 텍스트 | 120/120 |
| 10k 긴 입력 | 90/90 |
| 도구 호출 | 60/60 |
| 멀티턴 대화 기록 | 30/30 |
| 전체 · 95% 신뢰 구간 98.78%–100% | 300/300 |
300회 요청 모두 첫 시도에서 유효하고 완전한 응답을 반환했습니다. R = 100은 이 300건의 전용 요청에만 해당하며, 전체 체인에 실패가 없었다는 뜻은 아닙니다. 95% 신뢰 구간의 하한은 98.78%입니다. 300회 요청에서 모두 성공했더라도 실패율이 1.22% 미만일 가능성이 높다고만 말할 수 있습니다.
다른 다섯 공급자와 비교
| 공급자 | 첫 시도 성공률 | 95% 신뢰 구간 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek 공식 채널 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto(이 글) | 300/300 | 98.78%–100% |
R은 이 300건의 전용 요청에만 적용됩니다. 답변 품질 및 속도 섹션의 실패는 Q와 P에 기록되며 R에는 다시 집계되지 않습니다.
자주 묻는 질문
검사 항목은 33개뿐인데 F가 93.42인 이유는 무엇인가요?
원래 검사 항목 중 33개 가운데 29개를 통과했으며, 관찰된 그룹의 가중치를 재정규화한 결과 F는 93.42가 되었습니다. 계획된 나머지 147개 검사 항목은 점수 계산에서 제외했습니다. 스트리밍 기록은 작동하는 특정 기능을 설명할 뿐, 점수가 매겨지는 검사 항목을 추가하지 않습니다. 표시된 종합 점수는 68.72입니다.
TPOT 점수가 100.00인데 P는 57.69인 이유는 무엇인가요?
속도 요청 180건 중 유효한 것은 110건뿐이었습니다. 나머지 70건은 200을 반환했지만 값은 None이었습니다. 유효하지 않은 요청은 무한대로 계산하므로 첫 응답 토큰의 중앙값은 단일 동시성에서 5.85 s, 동시 요청 10개에서 6.13 s입니다(유효 요청만 보면 각각 3.08 s와 4.92 s). TTFA 점수는 24.59, 처리량 점수는 72.05로, 응답 점수는 65.22입니다. 캐시 K 점수 27.58이 20% 반영되어 P는 57.69가 됩니다.
K가 27.58에 불과한 이유는 무엇인가요?
핫 요청은 8k에서 9회 중 2회(21.89), 32k에서 9회 중 3회(33.27) 캐시 적중했으며, 두 길이에 동일한 가중치를 적용합니다. 적중한 요청은 7,936개 또는 32,000개 토큰을 읽었고, 콜드 대조 요청은 캐시를 읽지 않았습니다.
Pareto의 답변 품질이 공식 채널보다 높다고 볼 수 있나요?
구별할 수 있을 정도는 아닙니다. 종합 정확도는 44.58% 대 42.45%로 2.12%포인트 차이가 나지만, 95% 신뢰 구간은 −0.02에서 +4.18까지이며 0을 포함합니다. HLE 및 AA-LCR 평가 모델인 deepseek-flash는 보정되지 않아 관대한 평가를 했을 수 있습니다.
F에서 실패한 항목은 무엇인가요?
두 가지입니다. 스트리밍 중단 시퀀스를 사용하면 세 측정 창 모두에서 빈 본문이 반환됐지만, 같은 입력에서 중단 시퀀스를 빼면 정상 작동했습니다. 정확한 텍스트 출력은 세 측정 창 중 한 번 마지막에 마침표가 추가됐습니다.
계속 읽기: DeepSeek V4.1 Flash 시리즈
- Pareto의 Q 격차 +2.12는 공식 채널을 기준으로 측정했습니다. 기준선의 자체 테스트 결과는 DeepSeek 공식 채널 DeepSeek V4.1 Flash 리뷰: 비교 기준선, 단일 동시성에서 유효하지 않은 요청 15건에서 확인할 수 있습니다.
- Fireworks도 중단 요청에 빈 본문을 반환했으며, 8k 요청은 9회 중 3회 캐시 적중했습니다. 자세한 내용은 Fireworks DeepSeek V4.1 Flash 리뷰: 중단 요청에 빈 본문 반환, 8k 핫 요청 9회 중 3회 캐시 적중을 참조하세요.
- Alibaba Cloud는 핫 요청 18회 중 18회 캐시 적중했으며, Pareto는 18회 중 5회였습니다. 자세한 내용은 Alibaba Cloud DeepSeek V4.1 Flash 리뷰: 첫 응답 토큰 1.34s, 핫 요청 18회 모두 캐시 적중, 공식 채널과 구별하기 어려운 답변을 참조하세요.
- ByteDance는 속도 요청이 모두 유효했으며, 첫 응답 토큰 시간은 2.12 s였습니다. 자세한 내용은 ByteDance DeepSeek V4.1 Flash 리뷰: 공식 채널과 구별하기 어려운 답변, 입력 개수가 일치하지 않음을 참조하세요.
- Baidu도 속도 요청을 다수 잃었으며, 원인은 no_available_channel이었습니다. 자세한 내용은 Baidu DeepSeek V4.1 Flash 리뷰: 공식 채널과 대등한 도구 호출, 잦은 no-available-channel로 답변 품질과 속도 저하를 참조하세요.
출처
- DeepSeek V4.1 Flash 1017 모델 페이지 (AIHubMix)
- AIHubMix Provider Benchmark Standard v2.0 (AIHubMix 문서)
- 빠른 시작 (AIHubMix 문서)
- 모델 (AIHubMix)
- DeepSeek API 문서 (DeepSeek)


