AIHubMixは、API トラフィック向けに自社構築のグローバルアクセラレーションネットワークを運用しています。サードパーティのアクセラレーションプロバイダーを評価したところ、本番環境のAIワークロードに対して遅延と安定性が不十分だったため、自社のエッジノード、監視システム、トラフィックスケジューリングを展開しました。本記事では、その測定結果と背後にあるアーキテクチャについて説明します。
測定結果
以下の数値は、スケジューリングアルゴリズムを反復改善した後に、本番環境で継続的に監視した結果です。
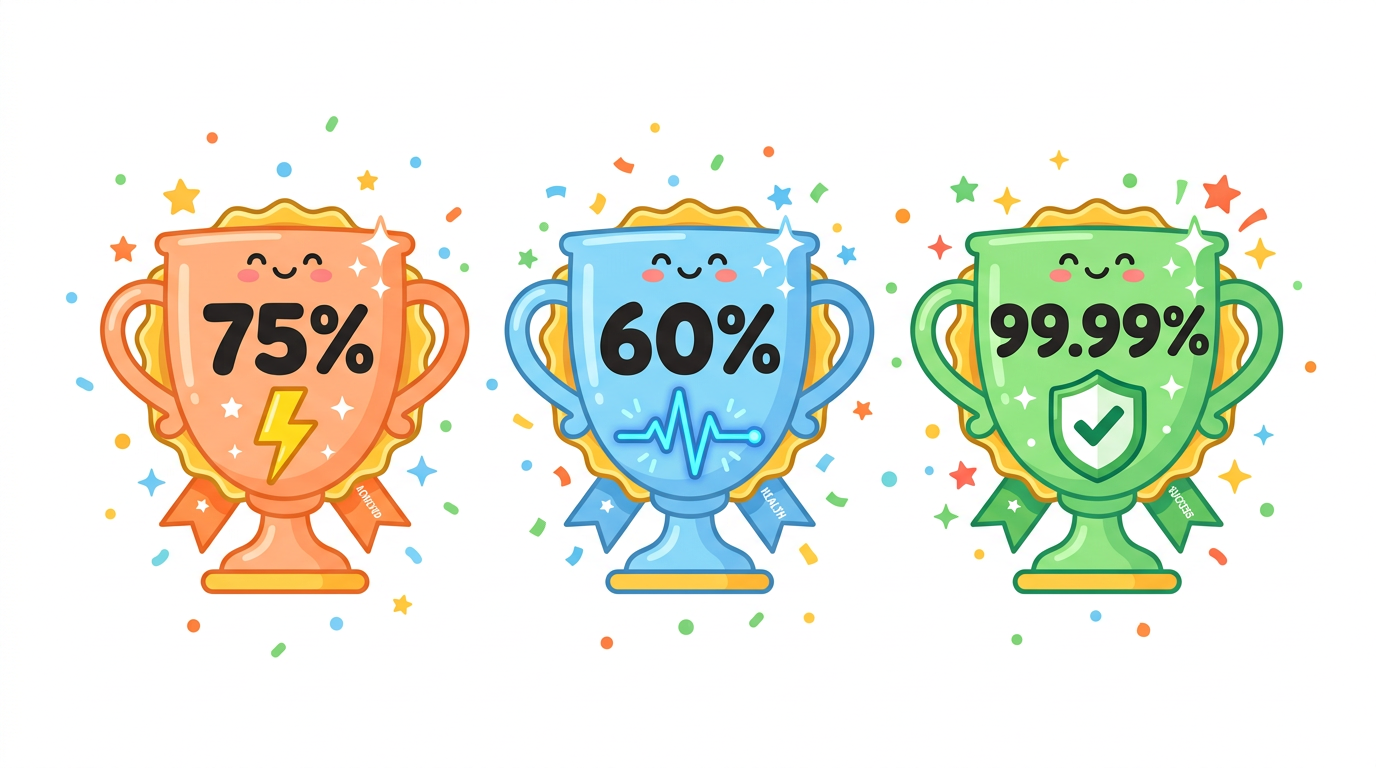
応答遅延を75%削減
エンドツーエンドのAPI遅延は平均で75%低下しました。ストリーミングのシナリオでは、主に最初のトークンまでの時間(TTFT)が改善されます。TTFTは、リクエストを送信してから最初の出力トークンを受信するまでの間隔であり、チャットアプリケーションの応答性の体感を左右します。
遅延の変動を60%削減
リクエストごとの遅延のばらつきは60%低下しました。本番アプリケーションにとって遅延の一貫性は重要です。ユーザーに表示される応答時間が予測可能になり、テールレイテンシによるタイムアウトも減ります。
サービス可用性99.99%
本番トラフィックで測定した可用性は99.99%に達しています。これは、週末や祝日を含むすべての時間帯を対象とした実測値です。
アーキテクチャ
自社構築のエッジノード
ネットワークは、複数のリージョンに配置された専用のアクセラレーションノード上で稼働しており、特定の回線やクラウドベンダーに依存しません。各ノードは本番投入前に、遅延、パケットロス、ピーク負荷のベンチマークに合格する必要があります。基準を満たさないノードはプールから除外されます。ルーティングでは、API呼び出しごとに利用可能な最速の経路を選択します。
分単位のプローブによるヘルスモニタリング
複数のリージョンに分散したプローブが、1分ごとにすべてのノードでエンドツーエンドのヘルスチェックを実行します。チェックの対象は、遅延、成功率、安定性の3つの観点です。ネットワーク全体を60秒ごとにスキャンするため、ノードの異常は1回のプローブ周期内で検出されます。
自動フェイルオーバーを備えたトラフィックスケジューリング
スケジューリングシステムは、1分、5分、15分、1時間という4つのスライディングウィンドウのプローブデータに基づき、すべてのノードのヘルススコアを1分ごとに再計算します。トラフィックは現時点で最もスコアの高いノードにルーティングされます。ノードが劣化した場合、正常なノードへのフェイルオーバーは人手を介さずにミリ秒単位で完了します。
運用の自動化
ノード管理、ルート最適化、設定のデプロイ、証明書のローテーション、障害復旧はすべて自動化されています。インシデント対応は当番の応答時間に依存しません。プローブが異常を検出するとすぐに、スケジューリングシステムが劣化したノードをローテーションから外します。
お客様のアプリケーションへの影響
- ストリーミングレスポンスにおけるTTFTが低くなり、ばらつきも小さくなります。
- 負荷がかかった状態でも、タイムアウトエラーやテールレイテンシの急増が減少します。
- 連携の変更は不要です。アクセラレーションは標準のAPIエンドポイントに自動的に適用されます。
よくある質問
アクセラレーションネットワークの恩恵を受けるために、連携方法を変更する必要はありますか?
いいえ。アクセラレーションはプラットフォームの入口レイヤーで適用されます。既存のAPIエンドポイント、キー、リクエスト形式はそのまま動作します。
ノードのヘルスチェックはどのくらいの頻度で行われますか?
分散プローブが60秒ごとにネットワーク内のすべてのノードをスキャンし、遅延、成功率、安定性をエンドツーエンドで測定します。
ノードが劣化するとどうなりますか?
スケジューリングシステムは、1分、5分、15分、1時間の4つのスライディングウィンドウからヘルススコアを毎分再計算し、トラフィックを正常なノードへ自動的に振り分けます。フェイルオーバーはミリ秒単位で完了します。
最終更新: 2026-06-01