Collegare un LLM basta per far generare testo a un'applicazione. Non basta per far completare a un agente AI un compito reale.
Se chiedi a un modello di riassumere un documento già presente nel suo contesto, il livello del modello è sufficiente. Se gli chiedi di confrontare i prezzi odierni dei concorrenti, arricchire la scheda di un'azienda, verificare un account social o scegliere la migliore API per un compito sconosciuto, diventa evidente la parte mancante: l'agente ha bisogno di un modo affidabile per raggiungere sistemi esterni.
Un agente in produzione prende quindi due decisioni distinte:
- Quale modello dovrebbe gestire questo passaggio?
- Quale strumento o API dovrebbe fornire i dati o l'azione?
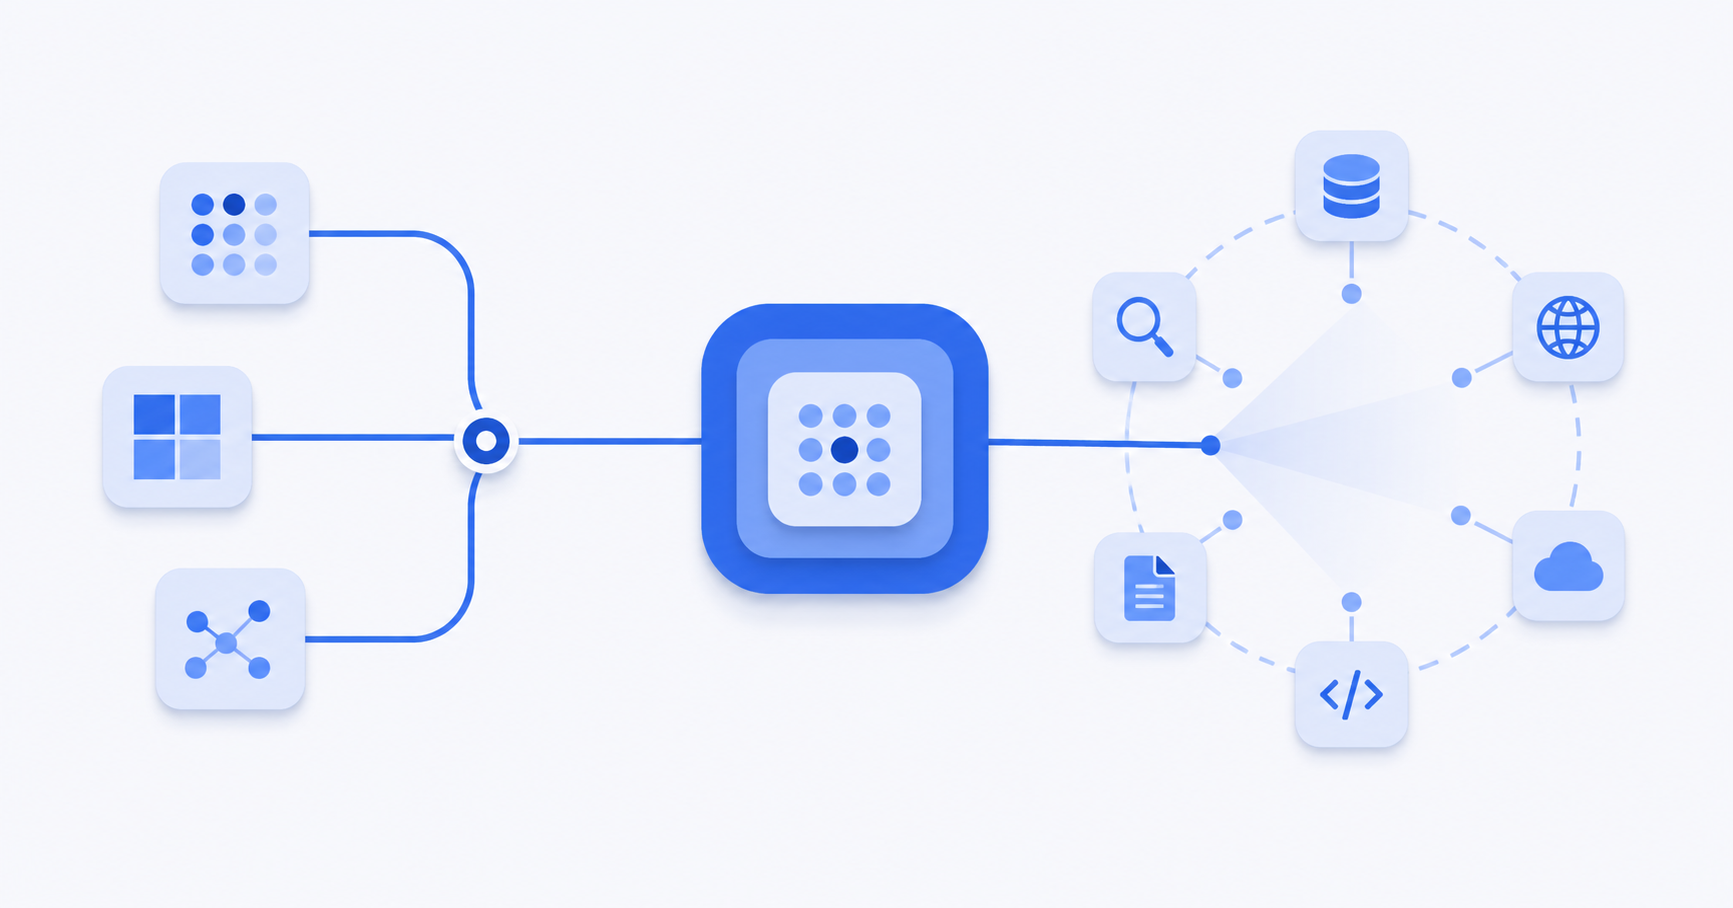
AIHubMix risolve la prima decisione con l'accesso unificato ai modelli e l'instradamento del modello al momento della richiesta. Monid risolve la seconda con la scoperta degli strumenti a runtime, l'ispezione dello schema e l'esecuzione a pagamento per chiamata. I prodotti si collocano su livelli diversi della stessa architettura.
Nota di trasparenza: questo articolo è stato realizzato nell'ambito di una collaborazione di contenuti con Monid. AIHubMix è la piattaforma di modelli trattata di seguito; Monid è la piattaforma di strumenti. Ciascuna può essere usata in modo indipendente.
I due problemi di instradamento all'interno di un agente AI
Un'esecuzione di un agente raramente è una singola chiamata omogenea a un modello. Un agente di ricerca può classificare una richiesta, cercare informazioni aggiornate, estrarre dati strutturati, confrontare i risultati e scrivere una risposta finale. Questi passaggi richiedono capacità diverse.
Lo stesso vale al di fuori del modello. Un'attività di ricerca aziendale può richiedere oggi un'API di ricerca, domani un endpoint di arricchimento aziendale e la settimana successiva uno strumento di automazione del browser. Se ogni modello e ogni strumento sono fissati in fase di build, ogni nuovo compito diventa un progetto di integrazione.
I due livelli sono paralleli:
| Livello del modello | Livello degli strumenti | |
|---|---|---|
| Decisione principale | Quale modello dovrebbe rispondere? | Quale API dovrebbe essere chiamata? |
| Momento della selezione | Per richiesta | Per attività, a runtime |
| Input | Prompt, modalità, esigenze di qualità e latenza | Obiettivo, dati o azione richiesti, schema e prezzo |
| Output | Un completamento del modello | Dati esterni o un'azione eseguita |
| Esempio | AIHubMix | Monid |
Questa separazione è importante. Un modello migliore non può creare accesso a dati in tempo reale, e un catalogo di strumenti più ampio non può ragionare sui dati che restituisce. L'agente ha bisogno di entrambe le capacità, con un contratto chiaro tra di esse.
Monid presenta la visione complementare dal lato degli strumenti in Why an AI Agent Needs Two Integrations. Dal lato del modello, la lezione architetturale è la stessa: mantenere indipendenti la selezione del modello e la selezione dello strumento, quindi ottimizzare ciascun livello per il proprio compito.
Perché un modello fisso diventa costoso in un ciclo di agente
Usare un solo modello per tutto sembra semplice. In pratica, costringe ogni passaggio ad accettare lo stesso compromesso tra capacità, latenza e prezzo.
Consideriamo un agente per la ricerca di mercato:
- La classificazione dell'intento è breve e meccanica.
- La selezione degli strumenti richiede un'affidabile aderenza alle istruzioni.
- Estrarre i campi dal JSON restituito è soprattutto una trasformazione.
- Il report finale può richiedere un ragionamento più solido e una scrittura migliore.
Inviare tutti e quattro i passaggi al modello più capace spreca denaro per il lavoro di routine. Inviarli tutti al modello più economico può ridurre la qualità dell'unico output che l'utente legge. Man mano che un ciclo dell'agente cresce, questo compromesso si ripete in ogni chiamata.
AIHubMix fornisce un endpoint compatibile con OpenAI su un ampio catalogo di modelli. Un'integrazione esistente con l'SDK di OpenAI può puntare ad AIHubMix cambiando la chiave API e base_url:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Impostando model su auto, la selezione del modello entra nel percorso della richiesta. Il router analizza l'attività e risolve la scelta con un modello adatto. Un suffisso di policy rende esplicito l'obiettivo di ottimizzazione:
| Valore del router | Priorità | Passaggio tipico dell'agente |
|---|---|---|
auto |
Prima il costo | Lavori in batch e trasformazioni di routine |
auto:balanced |
Capacità, costo e latenza | Lavoro generico dell'agente |
auto:quality_first |
Prima la capacità | Ragionamento complesso e risultati finali |
auto:latency_critical |
Prima la velocità | Cicli interattivi e pianificazione leggera |
L'instradamento non comporta una commissione separata. La richiesta viene fatturata al prezzo di listino del modello che l'ha effettivamente gestita. Il modello risolto e i dettagli dell'instradamento sono esposti nella risposta, incluso l'header X-Aihubmix-Router-Resolved-Model, in modo che la decisione resti osservabile e non diventi una scatola nera.
Il comportamento completo, gli endpoint supportati, le policy e i limiti attuali sono documentati nella guida AIHubMix LLM Router.
L'instradamento dei modelli non fornisce dati in tempo reale all'agente
Una volta configurato l'instradamento dei modelli, l'agente può scegliere un cervello migliore per ogni passaggio. Non può però sapere cosa è cambiato dopo i dati di addestramento del modello, accedere a un sistema aziendale privato o eseguire un'azione in un'altra applicazione, a meno che uno strumento non fornisca tale capacità.
È qui che molti progetti di agenti accumulano codice fragile. Un team collega un'API di ricerca, poi un'API di scraping, poi un'API di arricchimento. Ogni integrazione introduce un altro account, credenziali, formato delle richieste, modello degli errori e rapporto di fatturazione. Le descrizioni degli strumenti vengono spesso copiate in un system prompt e col tempo diventano obsolete.
La modalità di guasto è pericolosa perché può sembrare un successo. Un modello può produrre una chiamata plausibile contro uno schema obsoleto, ricevere una risposta incompleta e proseguire come se il compito fosse riuscito. L'ispezione dello schema a runtime è più sicura che chiedere al modello di ricordare un contratto API dall'addestramento o da un prompt vecchio.
Il livello degli strumenti dovrebbe quindi rispondere a tre domande prima dell'esecuzione:
- Quale strumento può soddisfare questo obiettivo?
- Quale schema e quale prezzo si applicano in questo momento?
- Quale risultato ha effettivamente restituito la chiamata?
La scoperta degli strumenti è il secondo livello di instradamento
Monid trasforma l'accesso agli strumenti in un flusso di lavoro scoperta-ispezione-esecuzione. Invece di richiedere che lo sviluppatore preveda ogni API di cui un agente potrebbe avere bisogno, l'agente può cercare in un catalogo in linguaggio naturale, ispezionare il contratto di un candidato ed eseguire l'endpoint selezionato.
Il flusso di base è il seguente:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
Scoperta e ispezione permettono all'agente di confrontare le opzioni prima di spendere qualsiasi cifra. L'esecuzione viene fatturata secondo il modello di prezzo dell'endpoint selezionato. Lo sviluppatore mantiene un'unica integrazione mentre l'agente ottiene accesso a strumenti di più fornitori.
Per i runtime di agenti in grado di leggere le istruzioni di configurazione, Monid pubblica anche una skill leggibile dalle macchine:
Set up https://monid.ai/SKILL.md
La documentazione del flusso di lavoro Monid spiega in dettaglio le fasi di catalogo, ispezione ed esecuzione.
Come lavorano insieme i due livelli
Il gateway dei modelli e il livello degli strumenti dovrebbero restare componenti separati, con un passaggio di consegne piccolo ed esplicito:
- L'agente riceve un obiettivo dall'utente.
- AIHubMix instrada una chiamata di pianificazione a un modello appropriato.
- Il piano individua le informazioni mancanti o un'azione esterna richiesta.
- Monid individua gli strumenti candidati e ne espone schemi e prezzi.
- L'agente seleziona ed esegue uno strumento entro i propri permessi e il proprio budget.
- Lo strumento restituisce dati o il risultato di un'azione.
- AIHubMix instrada la chiamata di sintesi in base alla qualità, al costo o alla latenza richiesti.
- L'agente restituisce una risposta basata sul risultato dello strumento.
In un Python semplificato, le chiamate lato modello possono restare invariate mentre il risultato dello strumento viene inserito come contesto:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
Il dettaglio importante non è il numero di righe. È che nessuna delle due scelte deve essere incorporata in modo permanente nella logica dell'applicazione. Il modello può cambiare quando cambia il prompt, e lo strumento può cambiare quando cambia l'attività.
I controlli sui costi appartengono a entrambi i livelli
Costi dei modelli e costi degli strumenti usano unità diverse, quindi vanno misurati separatamente.
Al livello del modello, il modello risolto determina il prezzo per token. AIHubMix rende tracciabile questa decisione e permette agli sviluppatori di scegliere una policy di instradamento o di limitare i modelli che una chiave API può usare. I passaggi di routine possono privilegiare costo o latenza, mentre gli output rivolti all'utente possono privilegiare la qualità.
Al livello degli strumenti, un endpoint può addebitare un costo per chiamata o per risultato. Monid espone i prezzi durante l'ispezione, prima dell'esecuzione. Un agente può rifiutare un endpoint che supera il suo budget, preferire un'opzione verificata o chiedere un'approvazione prima di un'operazione insolitamente costosa.
Tra i controlli utili in produzione figurano:
- Una allowlist di modelli o un limite di prezzo per ogni chiave API.
- Un budget massimo di chiamate agli strumenti per attività.
- Allowlist di fornitori o endpoint per i dati regolamentati.
- Log che collegano la decisione di instradamento del modello alla chiamata allo strumento e alla risposta finale.
- Conferma esplicita prima di azioni irreversibili o sensibili.
- Validazione dell'output, così che i dati degli strumenti siano trattati come input non attendibile e non come istruzioni.
Questa separazione facilita anche il debug dei costi. Se un'esecuzione diventa costosa, i log dei token mostrano se l'agente ha ragionato troppo, mentre i log degli strumenti mostrano se ha recuperato troppi dati. Le correzioni sono diverse, e l'architettura dovrebbe preservare questa distinzione.
L'affidabilità richiede contratti aggiornati e decisioni visibili
Una selezione dinamica non dovrebbe significare un comportamento imprevedibile.
Lato modello, AIHubMix riporta il modello risolto e la policy di instradamento per ogni richiesta. La session stickiness può preservare la coerenza del modello e i vantaggi della prompt cache nei lavori su più turni, mentre il comportamento di fallback può spostarsi da un modello non funzionante quando necessario.
Lato strumenti, l'agente ispeziona lo schema corrente dell'endpoint prima di effettuare una chiamata a pagamento. I risultati della scoperta includono le informazioni necessarie per confrontare i candidati, e il risultato della chiamata effettiva diventa l'unica prova esterna passata al completamento finale.
Nel complesso, questi controlli creano una traccia di audit utile:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Questa traccia ha più valore del semplice accesso a molti modelli o a molte API. Spiega perché l'agente ha fatto ogni scelta e quali prove hanno sostenuto la sua risposta.
Quando non servono entrambi i livelli
Non ogni flusso di lavoro trae vantaggio dalla scelta a runtime.
Se un'applicazione invia un prompt stabile a un solo modello testato, specificare direttamente quel modello è più semplice e più deterministico dell'instradamento. Se una pipeline programmata chiama sempre una stessa API nota, integrare direttamente quell'API può essere più chiaro che aggiungere un livello di scoperta.
L'architettura a due livelli si giustifica quando la varietà fa parte del carico di lavoro:
- I prompt sono abbastanza diversi da far cambiare il modello migliore da un passaggio all'altro.
- Gli agenti effettuano più chiamate ai modelli e devono controllare il costo o la latenza cumulativi.
- Gli strumenti necessari non possono essere previsti completamente al momento della build.
- I dati esterni devono essere aggiornati e la loro fonte deve essere visibile.
- Il team vuole aggiungere funzionalità senza dover aggiungere una nuova integrazione con un fornitore per ciascuna.
Usa il livello dei modelli, il livello degli strumenti o entrambi, in base alle decisioni che la tua applicazione deve effettivamente prendere.
Costruisci l'agente attorno alle decisioni, non alle dipendenze
Un agente AI di produzione non si definisce in base a quanti modelli o API è in grado di raggiungere. Si definisce in base alla capacità di scegliere la capacità giusta per il passaggio corrente, di operare entro un budget e di spiegare cosa è successo.
AIHubMix offre all'agente un endpoint unificato per i modelli e un routing al momento della richiesta in base alle priorità di costo, qualità e latenza. Monid gli offre la scoperta degli strumenti a runtime, schemi aggiornati, prezzi visibili ed esecuzione presso fornitori esterni.
Un livello decide come l'agente ragiona. L'altro decide come l'agente trova informazioni e agisce. Mantenere separate queste decisioni produce un agente più semplice da estendere, osservare e controllare.
Inizia con la guida rapida di AIHubMix, poi collega il lato degli strumenti tramite Monid.
FAQ
Che cos'è il model routing per gli agenti AI?
Il model routing seleziona un modello per ogni richiesta in base a fattori come tipo di attività, capacità, costo e latenza. Con AIHubMix, impostare model su auto oppure su una policy come auto:quality_first abilita la selezione al momento della richiesta, mantenendo un'API compatibile con OpenAI.
Perché un agente AI ha bisogno di strumenti se l'LLM possiede già delle conoscenze?
Un LLM genera risposte in base al contesto che riceve e a ciò che ha appreso durante l'addestramento. Non può sapere in modo affidabile i prezzi attuali, interrogare un database privato o eseguire un'azione esterna senza uno strumento collegato. Gli strumenti forniscono dati in tempo reale ed esecuzione; il modello pianifica e interpreta il risultato.
Un model gateway è lo stesso di un server MCP o di una piattaforma di strumenti?
No. Un model gateway instrada le richieste di inferenza verso i modelli. I server MCP e le piattaforme di strumenti espongono funzionalità esterne a un agente. Risolvono problemi di integrazione complementari e possono essere usati insieme.
AIHubMix e Monid possono essere usati indipendentemente?
Sì. AIHubMix può instradare le chiamate ai modelli per applicazioni che non hanno requisiti dinamici sugli strumenti. Monid può fornire la scoperta degli strumenti agli agenti che usano un altro fornitore di modelli o un altro gateway. Usarli entrambi è utile quando un agente ha bisogno di una scelta a runtime su entrambi i livelli.
Come posso mantenere il routing automatico verificabile?
Registra per ogni attività il modello risolto, la policy di routing, lo strumento candidato, il prezzo verificato, l'endpoint selezionato e il risultato restituito. AIHubMix espone i dettagli del model routing nella risposta, mentre Monid separa la scoperta e l'ispezione dall'esecuzione, così la decisione sullo strumento può essere registrata prima della chiamata a pagamento.